Rendimiento

Reduce el tiempo de tus BACKUPS a la mitad o más

La semana pasada publiqué un post sobre las configuraciones avanzadas de backups BLOCKSIZE, MAXTRANSFERSIZE y BUFFERCOUNT y cómo impactan en el rendimiento de nuestras copias de seguridad. A raíz de este artículo, muchos comentasteis una optimización mucho más sencilla y que mejora sustancialmente los tiempos de backup, separar las copias en varios ficheros. Y es cierto, incluso cuando no estás escribiendo estos múltiples ficheros en discos separados puedes ganar tiempo con esta configuración. Pero, ¿por qué? Veámoslo en profundidad. Además veremos otro truco que nos puede ahorrar gran cantidad de tiempo en estos procesos.

¿Por qué optimizar los backups?

A menudo no pensamos en que la optimización de rendimiento sea algo que afecte a las copias de seguridad y sin embargo es un campo donde podemos ganar mucho. 

A ver, un momento, si trabajas con una base de datos pequeña o mediana (hasta 300Gb aprox) y tu empresa solo tiene necesidad de acceso a la base de datos en horas de oficina esto no es un problema, no te compliques más. Seguramente tengas tiempo durante la noche y los fines de semana para hacer todas las tareas de mantenimiento completas sin mucho más miramiento. Pero, a medida que los datos crecen o crecen la demanda de los datos acercándose al tan temido 24×7 te va a tocar hacer malabares con los tiempos de los planes de mantenimiento y ajustarlo todo de manera que impacte lo menos posible en el resto de actividad. 

Vale, en estos casos lo mejor sería una aplicación externa de backup por snapshot para reducir el tiempo a casi 0 pero no seamos tan extremos, veamos qué podemos hacer con herramientas nativas.

Separar los backups en varios ficheros

Incluso cuando escribimos los distintos ficheros de copias de seguridad en el mismo disco duro físico o por la misma interfaz de red suele ser más rápido separar las copias de seguridad en varios ficheros. Esto pasa porque SQL Server tiene “cuellos de botella internos” (limitaciones) en la escritura a ficheros de copias de seguridad y al generar varios vamos a poder salvar en gran medida esas limitaciones. 

Es cierto que a cambio vamos a tener que complicar un poco tanto el script de recuperación de la copia de seguridad como el de la restauración pero, ¿de verdad eso es importante? ¿Sigues escribiendo a mano los scripts de backup y restore en 2025? Amigo para eso existen soluciones como los script de Ola Hallengren o el maravilloso sp_DatabaseRestore de Brent Ozar.

Demostración práctica BACKUPS

Veamos cómo impacta en los tiempos el hecho de dividir las copias de seguridad. Para la prueba estoy usando la base de datos StackOverflow2013 de demo de 52 Gb que tiene 4 ficheros de datos y uno de log. Sobre el hardware de mi máquina de pruebas es una máquina con 8 cores (16 vCores), 32Gb de RAM y un disco SSD M2.Tanto los ficheros de datos como el de log y el backup están en la misma unidad, no es lo ideal pero es lo que tengo para esto.

En un primer intento he hecho un backup full sencillo, a un solo fichero y ha tardado 1:52 minutos, la misma prueba de backup pero con 2 ficheros ha tardado 0:49 minutos y sin embargo, en cuanto he puesto 4 ficheros la prueba se ha ido a 3:42 minutos. ¿Por qué estos resultados? En teoría os había dicho que SQL Server limita la cantidad de datos que escribe a un único fichero por lo que podríamos entender que a más ficheros menos tiempo y sin embargo aunque con 2 ficheros hemos bajado los tiempos con 4 se han disparado.

Esto es porque también tenemos que tener en cuenta las limitaciones de velocidad del disco, en mi caso donde además todos los ficheros de datos y log están en la misma unidad esto cobra más sentido. Durante la prueba con un fichero el uso de disco ha rondado el 30%, durante la segunda prueba entre el 65 y 70% y, en la prueba con 4 ficheros el consumo ha sido del 100% del disco. Por tanto, con 4 ficheros mi hardware ha sobrepasado su límite generando tiempos de espera por cuellos de botella en la E/S de disco.

Demostración práctica RESTORE

Ahora os comparto los resultados que he tenido en la restauración de estas copias que acabo de hacer. Para esta prueba todos los backups siguen en la misma unidad que los datos y los logs y la base de datos existente va a ser sobrescrita, es decir no hay que generar de nuevo los ficheros. ¿Qué pasará?

Aquí los tiempos se disparan, la restauración de la copia con un solo fichero ha tardado 7:18 minutos. La restauración de la copia con dos ficheros, por su parte, ha demorado 11:07. Por último la copia de 4 ficheros ha tomado 10:19 minutos para restaurarse.

Cabe destacar que todas las pruebas de restauración han tenido el uso de disco al 100% en todo momento por lo que no puedo dar por 100% fiables los datos al haber encontrado tán pronto el límite del hardware. Ya os había dicho que la configuración de todo en el mismo disco no es una buena idea.

Bonus extra: Verificar los backups

Otra de las cosas que seguro que estás haciendo es verificar los backups a la hora de hacerlos. Verificar los backups no es que sea una buena práctica es que es imprescindible si queremos estar seguros y cumplir con la normativa vigente para muchas empresas. Como se suele decir, un backup sin probar no es un backup, es como el gato de Schrödinger (claro que he tenido que buscar en google como se escribe). 

Sin embargo, que tengamos que comprobar nuestras copias de seguridad no significa que debamos hacerlo al momento de hacer la copia, ni siquiera significa que debamos hacerlo en el mismo servidor. 

Si nuestros backups están en una unidad de red vamos a poder probarlas de manera independiente y en una máquina distinta al servidor de producción (por ejemplo el servidor de DR o el de pruebas) vamos a poder ganar un 30% o más del total de tiempo de la tarea de copias de seguridad. Incluso, podemos hacer uso del procedimiento sp_DatabaseRestore que he mencionado antes y hacer un CheckDB a la base de datos en este proceso separado de verificación. ¿Te das cuenta de lo que te estoy diciendo, verdad? Más seguridad y mejor rendimiento sin apenas complicarte.

Conclusión

Optimizar los procesos de backups no es solo cuestión de ahorrar tiempo, sino también de garantizar que nuestro entorno sea resiliente, eficiente y cumpla con los estándares de seguridad. A través de ajustes relativamente simples, como dividir los backups en múltiples ficheros o separar la verificación en un proceso independiente, podemos obtener grandes beneficios sin necesidad de recurrir a herramientas externas costosas.

Sin embargo, como hemos visto en las pruebas, no existe una configuración única que funcione para todos los escenarios. Cada entorno tiene sus propias limitaciones, ya sea por el hardware, la arquitectura de los datos o los requisitos operativos. Por eso, es fundamental medir, analizar y ajustar las configuraciones basándonos en pruebas reales. La clave está en encontrar el equilibrio entre el rendimiento y la fiabilidad, adaptando las estrategias a las características de nuestros sistemas.

En resumen, la optimización no siempre implica complejidad, y pequeños cambios pueden marcar una gran diferencia. Ahora te toca a ti: ¿qué ajustes has probado en tus backups? ¿Qué resultados has obtenido? Como siempre, la mejor forma de aprender es compartiendo experiencias.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

FILESTREAM en SQL Server

Aunque aquí somos de bases de datos relacionales y de datos estructurados, en ocasiones vamos a tener que lidiar con el manejo de datos no estructurados, como imágenes, videos y documentos. Desde el punto de vista relacional esto representa un desafío significativo en nuestras bases de datos. SQL Server aborda este problema con FILESTREAM, una característica que permite almacenar grandes objetos binarios (BLOBs) en el sistema de archivos NTFS mientras se mantienen gestionados a través de la base de datos. FILESTREAM combina la eficiencia del acceso directo al sistema de archivos con las capacidades transaccionales y de gestión de datos de SQL Server, proporcionando una solución perfecta (teóricamente) para escenarios que involucran datos no estructurados.

Arquitectura de FILESTREAM

Como os decía en la introducción, FILESTREAM integra el almacenamiento de datos binarios con la gestión relacional de SQL Server. Para conseguir esto, en lugar de guardar los datos binarios directamente en las páginas de datos de la base de datos, estos se almacenan en archivos físicos dentro de un directorio gestionado por SQL Server. Cada fila en la tabla que contiene datos FILESTREAM tiene un puntero que referencia el archivo correspondiente en el sistema de archivos. Este diseño garantiza que los datos binarios y relacionales estén sincronizados, respetando las propiedades ACID de las transacciones.

Internamente, el almacenamiento de FILESTREAM se organiza mediante filegroups especiales que se configuran para contener datos FILESTREAM. Estos filegroups actúan como un vínculo lógico entre la base de datos y el sistema de archivos, permitiendo a SQL Server gestionar la ubicación física de los datos binarios de forma transparente para el usuario.

Configuración de FILESTREAM

Habilitar FILESTREAM requiere configuraciones específicas tanto en el sistema como en SQL Server. En primer lugar, FILESTREAM debe activarse a nivel de instancia mediante SQL Server Configuration Manager. Para ello iremos a SQLServer Configuration Manager, abriremos las oropiedades de la instancia y en la pestaña FILESTREAM marcaremos el check “Activar FILESTREAM”. En esta configuración, es necesario habilitar el acceso desde Transact-SQL y, opcionalmente, el acceso de entrada/salida directa mediante la API de Win32 para escenarios que requieran un rendimiento optimizado.

Tras habilitar FILESTREAM en la instancia, se debe configurar un filegroup en la base de datos para almacenar los datos binarios. Este filegroup se asocia a un directorio del sistema de archivos que actuará como el almacenamiento físico de los archivos. Por ejemplo, mediante T-SQL se puede crear un filegroup FILESTREAM y asignarle una ruta específica:

Con el filegroup configurado, se pueden definir tablas con soporte FILESTREAM. Las tablas deben incluir una columna VARBINARY(MAX) declarada con el atributo FILESTREAM, lo que habilita el almacenamiento de datos binarios en el sistema de archivos. Un ejemplo de definición de tabla es el siguiente:

Acceso y Manipulación de Datos

SQL Server proporciona dos métodos principales para acceder y manipular datos FILESTREAM. El primero utiliza Transact-SQL, lo que permite realizar operaciones de inserción, actualización y recuperación de datos binarios como se haría con cualquier columna relacional. Por ejemplo, para insertar un archivo en una tabla FILESTREAM, se puede utilizar el siguiente comando:

Para recuperar el archivo, se emplea una consulta estándar:

El segundo método de acceso emplea la API de Win32 que he mencionado antes. Esta API está diseñada para acceder directamente a los archivos almacenados en el sistema de archivos. Esta forma de trabajar es más compleja pero, particularmente útil en escenarios de alto rendimiento, ya que permite operaciones de lectura y escritura secuenciales más eficientes. Para usar este método, SQL Server proporciona la función GET_FILESTREAM_TRANSACTION_CONTEXT(), que genera un identificador de contexto transaccional necesario para acceder a los archivos.

Ventajas de FILESTREAM

Ya hemos visto la principal ventaja y es que FILESTREAM combina el rendimiento del sistema de archivos con la gestión transaccional de SQL Server. Al mover los datos binarios al sistema de archivos, reducimos la presión sobre el almacenamiento de páginas de datos y mejoramos la escalabilidad. Además, se mantiene la integridad transaccional, lo que garantiza que las operaciones de datos relacionales y binarios sean consistentes. Otro beneficio clave es la compatibilidad de FILESTREAM con las herramientas de copias de seguridad y recuperación de SQL Server, lo que simplifica la protección de datos en soluciones empresariales.

Limitaciones de FILESTREAM

A pesar de sus ventajas, FILESTREAM tiene limitaciones que deben considerarse antes de su implementación. Una de las principales restricciones es su dependencia del sistema de archivos NTFS, lo que limita su uso en otros sistemas operativos o configuraciones de almacenamiento. Es decir, olvídate de usarlo en SQL Server en linux o en docker. Además, no es compatible con todas las características avanzadas de SQL Server, como la replicación transaccional. Con Always On si que es compatible pero, requiere un cuidado especial y, en mi experiencia, es fuente de problemas de integridad de las bases de datos. Si lo activas, asegúrate de tener chequeos frecuentes de la base de datos y prepárate para reparar errores a menudo. La administración de permisos y seguridad también es más compleja, ya que los archivos están físicamente accesibles desde el sistema operativo.

Por último, la integración de FILESTREAM con las estrategias de copias de seguridad puede requerir configuraciones adicionales, ya que los datos relacionales y binarios deben mantenerse sincronizados. Esto puede aumentar la complejidad operativa, especialmente en entornos con grandes volúmenes de datos binarios.

Conclusión

FILESTREAM es una solución técnica avanzada para gestionar datos no estructurados en SQL Server. Su capacidad para combinar la eficiencia del acceso directo al sistema de archivos con la integridad transaccional lo convierte en una herramienta valiosa en escenarios donde el rendimiento y la consistencia son críticos. Sin embargo, su implementación requiere un conocimiento técnico sólido y una planificación cuidadosa para maximizar sus beneficios y evitar problemas operativos. Con una configuración adecuada y un enfoque técnico riguroso, FILESTREAM puede ser una solución escalable y robusta para aplicaciones que manejan grandes volúmenes de datos binarios.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 2 comentarios

Optimización avanzada de Backups: BLOCKSIZE, MAXTRANSFERSIZE y BUFFERCOUNT

Cuando diseñamos nuestra estrategia de copias de seguridad en SQL Server, es esencial considerar no solo la integridad de los datos, sino también la eficiencia de los procesos. Quiero decir, además de la retención de los backups y factores como RPO y RTO que siempre tenemos en cuenta tenemos que pensar también en el rendimiento. En este sentido, ya hicimos un video sobre cómo afectaba la compresión de los backups a los tiempos de copia y restauración, ¿lo recuerdas? Lo tienes aquí por si quieres revisarlo.

Hoy, sin embargo, vamos a ir un paso más allá con esto del rendimiento de las copias de seguridad y vamos a ver tres opciones avanzadas que pueden marcar la diferencia en los tiempos y la utilización de recursos; estoy hablando de BLOCKSIZE, MAXTRANSFERSIZE y BUFFERCOUNT. Vamos a ver cómo funcionan y cómo optimizarlas.

Introducción al funcionamiento de las opciones de backups

Para entender estos complejos conceptos lo más simple posible tenemos que empezar pensando en el proceso de backup en SQL Server como en la transferencia de datos desde la base de datos hacia un destino de almacenamiento. Durante este flujo, como en cualquier transferencia de información informática, el tamaño del bloque, la cantidad de buffers y la cantidad de datos transferidos por operación son factores clave que pueden afectar considerablemente el rendimiento.

Entonces, tenemos por un lado el parámetro BLOCKSIZE que define el tamaño del bloque de datos utilizado en la operación de backup, MAXTRANSFERSIZE que determina el tamaño máximo de los datos que se transfieren en una única operación de I/O y BUFFERCOUNT que especifica cuántos buffers se asignan para la operación.

BLOCKSIZE

Como acabamos de comentar el parámetro BLOCKSIZE define el tamaño, en bytes, de los bloques que se utilizan para escribir datos en el medio de almacenamiento durante el backup. 

De manera predeterminada, y si no modificamos nada tendrá un tamaño de 64 KB. Sin embargo, podemos modificarlo, admitiendo valores que pueden oscilar entre 512 bytes y un máximo de 4 MB.

Un BLOCKSIZE mayor puede resultar en un uso más eficiente del disco, especialmente en sistemas con discos de alta velocidad y controladores optimizados.

Sin embargo, no todos los dispositivos admiten tamaños de bloque personalizados. Es vital verificar la compatibilidad con el hardware subyacente.

Ejemplo de uso:

MAXTRANSFERSIZE

Este parámetro controla la cantidad máxima de datos transferidos entre SQL Server y el medio de almacenamiento en una sola operación de I/O. Tiene un rango de valores posibles desde el mínimo 64 KB hasta un máximo de 4 MB (desde SQL Server 2012).

Un MAXTRANSFERSIZE mayor puede reducir la cantidad de operaciones de I/O, mejorando la velocidad del backup. Aumentar este valor puede ser beneficioso sobre todo en dispositivos con alto rendimiento de escritura secuencial como los actuales discos SSD. Pero cuidado, configurar valores altos puede requerir más memoria en el servidor, lo que podría ser contraproducente en sistemas con recursos limitados.

Ejemplo de uso:

BUFFERCOUNT

Acabamos de hablar de la memoria y para optimizar este recurso y no tener problemas tenemos este último parámetro. BUFFERCOUNT define el número de buffers de memoria que se utilizarán durante la operación de backup. Es importante definirlo correctamente, sobre todo si hemos modificado los parámetros anteriores. 

Una mala configuración de BUFFERCOUNT nos puede dar muchos dolores de cabeza, por ejemplo valores bajos nos pueden provocar cuellos de botella si el flujo de datos excede la capacidad de los buffers disponibles y, sin embargo, unos valores altos aunque aprovechan al máximo la memoria disponible, deben equilibrarse con otros procesos en ejecución o usurparán sus recursos. Por suerte, tenemos una fórmula básica para calcular BUFFERCOUNT:

BUFFERCOUNT = (MAXTRANSFERSIZE / BLOCKSIZE) * número de hilos.

Ejemplo de uso:

Cómo optimizar tu backups

Ahora que ya hemos visto las tres configuraciones por sepradao vamos a ver como aplicarlas juntas. Esta es la clave ya que el rendimiento de los backups depende de cómo se ajustan estas tres opciones en conjunto. 

Lo primero que debemos hacer es analizar nuestro hardware.Si el sistema tiene discos rápidos y suficiente memoria, aumentar BLOCKSIZE y MAXTRANSFERSIZE puede sernos ventajoso. En sistemas con I/O limitado, priorizar un BUFFERCOUNT ajustado puede equilibrar la carga y ayudarnos a no impactar en otras operaciones.

En cualquier caso, es fundamental probar diferentes combinaciones en un entorno de prueba, lo más parecido al real posible, para determinar qué configuración ofrece el mejor rendimiento.

Lo cierto es que aunque SQL Server utiliza valores predeterminados razonables, ajustar estas opciones para nuestro escenario concreto puede ser crucial, sobre todo en bases de datos grandes o sistemas críticos.

Ejemplo completo:

En este ejemplo el BLOCKSIZE de 64 KB se combina con el MAXTRANSFERSIZE de 1 MB. 

El BLOCKSIZE de 64 KB es el adecuado si hacemos nuestros backups en un disco de los formateados según las buenas prácticas de SQL Server. Recordad que en estos discos definimos un tamaño de bloque de 64 KB que es justo lo que ocupa un EXTEND, es decir un bloque de 8 páginas cada una de 8 KB. El  MAXTRANSFERSIZE se ajusta a 1 MB para permitir que cada operación de I/O mueva datos en bloques razonablemente grandes, optimizando las escrituras en disco.

Ahora, si para estas operaciones de backup queremos aplicar 2 hilos, es decir dos núcleos virtuales del procesador, aplicamos la fórmula que hemos visto antes y nos da ese resultado.

32 = ( 1048576 /  65536 ) * 2

Conclusión

Las opciones BLOCKSIZE, MAXTRANSFERSIZE y BUFFERCOUNT nos ofrecen un control detallado sobre el rendimiento de las operaciones de backup en SQL Server. Aprovecharlas de manera efectiva requiere un análisis cuidadoso del entorno y pruebas específicas hasta dar con la mejor combinación. Pero merece la pena, en bases de datos críticas y de gran tamaño, estos ajustes pueden marcar una diferencia significativa, reduciendo los tiempos de los backups y optimizando el uso de recursos. 

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 3 comentarios

Compresión en índices columnares: COLUMNSTORE_ARCHIVE

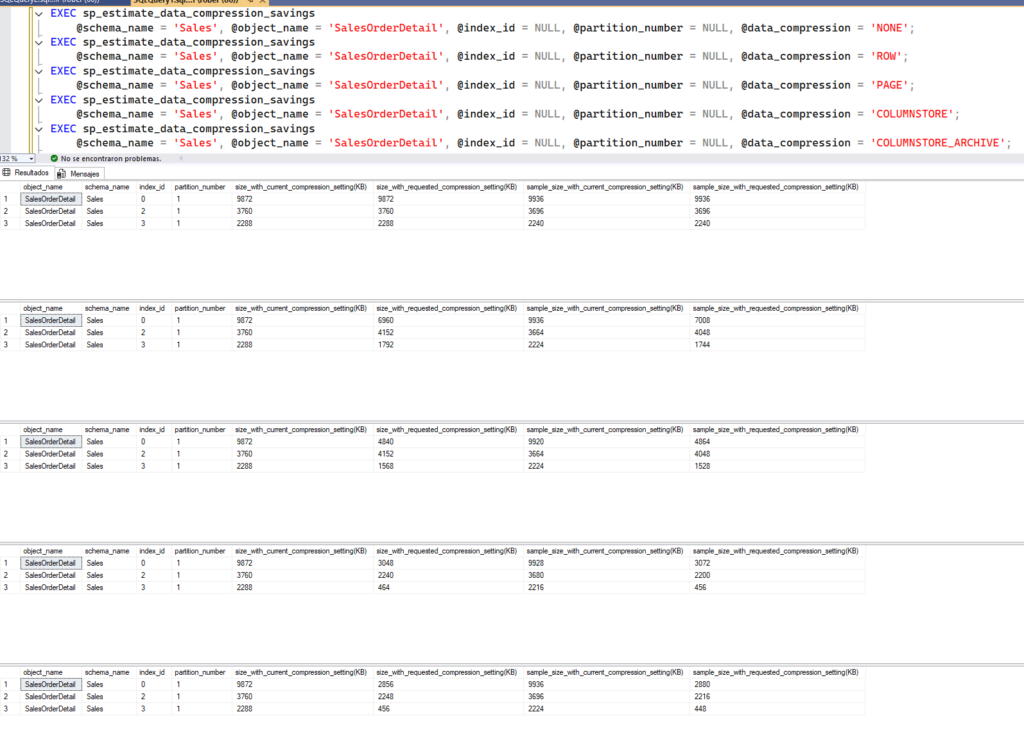
Llevamos un par de artículos ya hablando sobre compresión de datos y ya hemos visto cómo esta afecta tanto a las tablas como a los índices tanto en SQL Server como en Azure SQL. Sin embargo, hay un tipo de índice que no se ve afectado por la compresión y son los índices columnares. Lo cierto es que este tipo de índices ya tienen un nivel altísimo de compresión de datos al ser columnares pero, aún podemos comprimirlos más si es lo que queremos. Estoy hablando de una opción no tan conocida y usada que es el COLUMNSTORE_ARCHIVE.

Índices Columnares y su naturaleza comprimida

Como he comentado ya en la introducción, la propia naturaleza columnar de los índices columnstore ya de por si facilita la compresión. En concreto, por defecto y por definición se aplican técnicas de compresión avanzadas. A diferencia de los índices tradicionales basados en filas, los índices Columnstore almacenan los datos en formato columnar, lo que permite aplicar técnicas de compresión más avanzadas.

Cuando creamos un índice Columnstore, SQL Server automáticamente aplica compresión de diccionario, codificación por lotes y compresión de bits, lo que reduce significativamente el tamaño del almacenamiento y mejora la eficiencia en la lectura de datos.

La compresión de diccionario reduce el tamaño del almacenamiento eliminando valores repetitivos dentro de cada segmento de datos. Por su parte, la codificación por lotes (Run-Length Encoding) optimiza la compresión al almacenar secuencias de valores repetidos como una sola entrada. Por último, la compresión de bits (Bit-Packing) reduce el tamaño del almacenamiento al optimizar el número de bits utilizados para representar los valores almacenados.

¿Qué es Columnstore_Archive?

El índice Columnstore_Archive es una extensión del índice Columnstore comprimido estándar, diseñado para proporcionar una comprensión aún mayor aplicando algoritmos de compresión adicionales. Mientras que un índice Columnstore ya aplica técnicas avanzadas de reducción de datos como codificación de diccionario, codificación por lotes y compresión de bits, Columnstore_Archive utiliza una compresión más agresiva basada en el algoritmo Xpress Compression Algorithm (XCA)​.

Diferencias clave entre Columnstore y Columnstore_Archive

CaracterísticaÍndice Columnstore NormalColumnstore Archive
Compresión aplicadaCodificación de diccionario, run-length, bit-packingTodo lo anterior + compresión LZ77+Huffman
Impacto en almacenamientoReducción del 50-70%Reducción del 70-90%
Impacto en CPUBajoAlto (más procesamiento en consultas)
Velocidad de lecturaAltaReducida por el proceso de descompresión
Casos de uso idealesDatos transaccionales y de consulta frecuenteDatos históricos, auditoría y repositorios de solo lectura

Cómo funciona la compresión en Columnstore_Archive

Como he comentado, el modo Columnstore_Archive añade una capa extra de compresión sobre los segmentos Columnstore existentes. Esto se logra mediante una combinación de técnicas de compresión basadas en LZ77 y Huffman, utilizadas en el algoritmo Xpress Compression Algorithm (XCA)​.

Fases del proceso de compresión de Columstore_Archive

  1. Compresión LZ77: Reemplaza secuencias repetidas de bytes con referencias a posiciones anteriores en el flujo de datos. Esto reduce el tamaño al eliminar redundancias en los segmentos Columnstore.
  2. Codificación Huffman: Utiliza un esquema de codificación basado en la frecuencia de los datos para minimizar aún más el tamaño. Los valores más comunes se almacenan con menos bits, mejorando la eficiencia de almacenamiento.

Cómo maneja SQL Server los datos comprimidos en Columstore_Archive

Cuando se escribe un índice Columnstore_Archive, SQL Server aplica la compresión LZ77 + Huffman a los segmentos Columnstore ya existentes. Al leer datos de un índice Columnstore Archive, SQL Server debe descomprimir estos segmentos antes de ejecutar la consulta, lo que implica un uso de CPU significativamente mayor.

Implementar Columstore_Archive

Si queremos habilitar Columnstore_Archive en una tabla o índice usaremos el comando ALTER TABLE o ALTER INDEX de la siguiente manera:

1. Habilitar Columnstore_Archive en una partición

    2. Habilitar Columnstore_Archive en todas las particiones

    3. Habilitar Columnstore en todas las particiones y Columnstore_Archive en alguna

    3b. Otra forma de habilitar Columnstore en todas las particiones y Columnstore_Archive en alguna:

    Impacto en el rendimiento de Columnstore_Archive

    Columnstore_Archive permite una reducción extrema del tamaño de almacenamiento, lo que lo hace ideal para entornos donde el espacio en disco o las copias de seguridad representan un coste significativo. Al disminuir el tamaño de los datos almacenados, se reducen los costes operativos y se optimiza el uso del almacenamiento, especialmente en bases de datos alojadas en la nube.

    Sin embargo, esta ventaja viene acompañada de un mayor consumo de CPU en las consultas, ya que los datos deben ser descomprimidos en tiempo de ejecución. En escenarios donde las consultas analíticas son frecuentes y de gran volumen, este aumento en el uso de CPU puede impactar el rendimiento general del sistema, por lo que es fundamental evaluar su aplicación caso por caso.

    Casos de uso ideales para Columnstore_Archive

    El uso de Columnstore_Archive está especialmente indicado en escenarios donde los datos almacenados son mayormente de solo lectura o tienen un acceso esporádico. Tablas con registros históricos, auditorías o grandes volúmenes de datos que rara vez se consultan pueden beneficiarse enormemente de la reducción de almacenamiento sin que el impacto en la CPU sea un problema. En entornos de Data Warehouse donde la retención de datos es fundamental, Columnstore_Archive puede ser clave para reducir los costes de almacenamiento sin comprometer la integridad de los datos.

    También es una opción interesante en Azure SQL Managed Instance y otras bases de datos en la nube, donde los costes de almacenamiento suelen ser elevados. Reducir el tamaño de la base de datos mediante Columnstore_Archive puede generar ahorros significativos, especialmente en cargas de trabajo que dependen de replicaciones geográficas y copias de seguridad, donde el tamaño de los datos afecta directamente los costes de operación.

    Buenas prácticas con Columnstore_Archive

    Para aprovechar al máximo Columnstore_Archive, es fundamental evaluar cuidadosamente qué tablas o índices pueden beneficiarse de esta compresión. No es recomendable aplicarlo en datos de acceso frecuente, ya que el proceso de descompresión puede generar una sobrecarga en la CPU que afecte el rendimiento de las consultas. Monitorizar el impacto en el rendimiento con herramientas como Query Store y ejecutar pruebas antes de aplicar la compresión en entornos de producción son pasos esenciales para garantizar que los beneficios en almacenamiento no se vean opacados por problemas de latencia.

    Conclusión

    Columnstore_Archive es una solución avanzada para la compresión extrema de datos en SQL Server, útil en escenarios donde el almacenamiento es la principal preocupación. Sin embargo, su mayor consumo de CPU puede ser un factor limitante en bases de datos con consultas frecuentes. Si el objetivo es maximizar la eficiencia del almacenamiento sin comprometer demasiado el rendimiento, Columnstore Archive es una opción poderosa que debe aplicarse estratégicamente en los casos adecuados. Una planificación cuidadosa y una evaluación continua del impacto en rendimiento permitirán sacar el máximo provecho de esta tecnología sin afectar la operativa de la base de datos.


    Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 0 comentarios

    Compresión en Azure SQL Managed Instance

    Azure SQL Managed Instance (MI) es una plataforma para la gestión de bases de datos en la nube con un equilibrio perfecto entre la administración manual y delegada en el proveedor, pero es esencial comprender sus características y limitaciones para optimizar su rendimiento. Hoy vamos a hablar de la compresión de datos, de la que ya hablamos detenidamente en otro artículo, como estrategia para mitigar limitaciones relacionadas con los recursos de IO, RAM y CPU. En este artículo, exploraremos cómo la compresión de datos puede ayudar a superar estas limitaciones, proporcionando datos objetivos sobre las especificaciones de Azure MI y los precios (en la región de España Central a modo de ejemplo).

    Características y limitaciones de Azure SQL Managed Instance

    Lo primero que tenemos que tener claro es el terreno de juego en el que estamos, la nube es teóricamente escalable sin límite, sin embargo, tanto los proveedores como, sobre todo, nuestro bolsillo va a ser el principal limitante. Veamos qué es lo que nos ofrece Azure para el caso de las Managed Instance.

    Niveles de servicio y recursos asignados:

    Azure MI ofrece principalmente dos niveles de servicio el de uso general y el crítico. Además, dentro de estos niveles de servicio vamos a poder elegir tres tipos de hardware diferente. Parece un poco lioso, y realmente lo es, así que vamos a tratar de hacerlo fácil.

    Lo primero que tenemos que conocer son los niveles de servicio que son:

    • De uso general (General Purpose): Diseñado para cargas de trabajo empresariales comunes con requisitos de rendimiento moderados y alta disponibilidad.
    • Crítico para la empresa (Business Critical): Orientado a aplicaciones de misión crítica que requieren alta velocidad de transacciones y baja latencia.

    Estos niveles de servicio van a marcar los límites de recursos que podemos asignar a nuestra instancia, pero además de estos tenemos que tener en cuenta el tipo de hardware. Por ejemplo en el nivel de uso general el límite de CPUs que podemos asignar es de 80 cores para el hardware estándar y el serie premium pero solo hasta 64 cores en el hardware optimizado para memoria. Es el nivel crítico para la empresa el hardware estándar tendrá un máximo de 80 cores mientras que el hardware premium y el optimizado para memoria podrá tener hasta 128.

    Compresión para salvar los límites de RAM para Azure MI

    Una de las cosas curiosas de Azure SQL MI es que la asignación de recursos de memoria RAM no es seleccionable y depende directamente de la cantidad de núcleos virtuales que tengamos.

    • Hardware de la serie estándar: 5,1 GB de RAM por vCore con un máximo de 480 Gb. Por ejemplo, 16 vCore = 81,6 GB de RAM.
    • Hardware de la serie Premium: 7 GB de RAM por vCore con un máximo de 560 Gb. Por ejemplo, 16 vCore = 112 GB de RAM.
    • Hardware optimizado para memoria: 13,6 GB de RAM por vCore con un máximo de 870,4 Gb. Por ejemplo, 16 vCore=217 GB de RAM.

    Como podéis ver, la cantidad máxima de RAM es muy limitada y más cuando no nos dejamos el presupuesto de toda la empresa en núcleos de Azure MI. Por esta razón es fundamental habilitar la compresión en todas las tablas e índices de nuestras bases de datos. Cuantos más datos podamos cachear mejor, recordad que para que SQL tenga un rendimiento decente tiene que ser capaz de tener en memoria la información a la que se accede frecuentemente además de espacio suficiente para cachear planes de ejecución y demás operaciones que se hacen en memoria.

    Almacenamiento en Azure MI

    Ahora vamos con una de las cosas que menos me gustan de este modelo de dimensionamiento que tiene Azure MI y es que la capacidad de almacenamiento está limitada por la cantidad de núcleos adquirida. De esta manera, en el nivel de uso general con menos de 8 núcleos no puedes tener más de 2 Tb de datos, con menos de 16 núcleos no puedes tener más de 8 Tb de datos y para llegar hasta el máximo de 16 Tb de datos vas a necesitar 16 núcleos o más. Veamos esto en precios con el hardware estándar para que nos duela menos al ver los costes.

    Propósito general:

    • ¿Necesitas menos de 2 TB? Puedes dimensionar 4 núcleos, 1.013,99 € mensuales.
    • ¿Necesitas más de 2 TB? Necesitas mínimo de 8 núcleos, 2.569,88 € mensuales.
    • ¿Necesitas más de 8 TB? Necesitas mínimo de 16 núcleos, 5.143,85 € mensuales.
    • ¿Necesitas más de 16 TB? Lo siento, no puedes tener esa cantidad. (Puedes tener más núcleos pagando más, pero esta lista se basa en los tamaños de disco).

    Veamos también cómo va el almacenamiento en el nivel crítico para la empresa (esta vez en hardware premium que es más flexible):

    • ¿Necesitas menos de 1 TB? Puedes dimensionar 4 núcleos virtuales, 2.614,23 € mensuales.
    • ¿Necesitas más de 1 TB? Mínimo de 8 núcleos, 5.237,48 € mensuales.
    • ¿Necesitas más de 2 TB? Mínimo de 16 núcleos, 10.483,97 € mensuales.
    • ¿Necesitas más de 4 TB? Mínimo de 24 núcleos, 15.584,32 € mensuales.
    • ¿Necesitas más de 5,5 TB? En España no se puede.

    Os dejo ahora una imagen extraída de la documentación oficial sobre las limitaciones de espacio. Para el cálculo de precios podéis usar la calculadora oficial.

    Velocidad de los discos

    Si todo esto que hemos visto no es un problema para vosotros esperad porque ahora viene lo realmente “problemático” en Azure MI. La velocidad de estos discos, medida en IOPS (E/S por segundo), es realmente baja y, aunque va aumentando con el tamaño de los archivos, no llega a ser comparable a sistemas tradicionales On-Prem. Además de que escalar los ficheros nos va a implicar necesidades extra de tamaño y por tanto de cores y, si lo habéis adivinado, de más dinero todos los meses. Veamos esta otra imagen de la misma documentación que comentábamos antes: 

    Ahora os voy a dejar otra imagen de Kingston sobre las velocidades de sus discos actuales

    Como veis, en el mejor de los casos, un archivo de Azure MI de más de 4 Tb tendría una velocidad de 250 Mib/s (Mebibits por segundo) o lo que es lo mismo 32,7 MB/s (Megabytes por segundo). Un SSD M2 NVME actual de cuatro canales nos está dando 8000. 

    Recuerda que para tener 4Tb (32,7 MB/s) en una instancia de nivel crítico para la empresa estamos hablando de más de 15.000 € al mes, eso sin contar con dimensionar también el fichero de log que, en este nivel de servicio y en España, ni podríamos llevarlo a este tamaño. En el nivel propósito general si podemos pero, estamos hablando de 5.100 € al mes para tener 8 Tb (4 para datos y 4 para log). 

    Nada más que decir.

    Conclusión: Compresión para reducir las lecturas

    Lo que os quería hacer ver con todo este texto que os he puesto hasta ahora es que en Azure MI las reglas del juego cambian y reducir las lecturas en disco y maximizar el tiempo que los datos permanecen en caché es clave para el rendimiento. Por este motivo necesitarás una buena política de indexación, comprimir los datos y, si es posible, eliminar todos los datos que ya no sean necesarios. 

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

    ¿Por qué usar una red aislada para la comunicación de Always On (heartbeat network)?

    La implementación de una arquitectura de alta disponibilidad en SQL Server Always On es un elemento clave para garantizar la continuidad del negocio y la disponibilidad de los datos. Mucho hemos hablado ya de este tema en el blog pero, si queremos ir un paso más allá, uno de los aspectos fundamentales en esta configuración es la red de comunicación entre los nodos de un grupo de disponibilidad o una instancia de clúster de conmutación por error. En este contexto, el uso de una red aislada para la comunicación de Always On, conocida como heartbeat network, juega un papel esencial en la estabilidad y rendimiento de la solución.

    En este artículo, veremos por qué es recomendable utilizar una red dedicada para la comunicación de Always On, sus beneficios, y las mejores prácticas para su implementación.

    Importancia de la comunicación en Always On

    Always On en SQL Server nos permite la creación de entornos de alta disponibilidad y recuperación ante desastres mediante grupos de disponibilidad o clústeres de conmutación por error. Cuando lo configuramos, los nodos intercambian información de estado para determinar si uno de los servidores está en funcionamiento o si ha fallado y es necesario realizar una conmutación por error (failover).

    Este intercambio de información se realiza a través de un mecanismo denominado heartbeat, que envía señales de estado periódicas entre los nodos del clúster. Si un nodo deja de responder en un tiempo determinado, el sistema automáticamente asume que ha fallado y puede desencadenar una conmutación automática al nodo secundario si así lo hemos configurado.

    Además de la señal de heartbeat, en un Grupo de Disponibilidad Always On, esta misma red puede utilizarse para la sincronización de datos entre réplicas. Esto es especialmente crítico en entornos con replicación síncrona, donde la latencia y la estabilidad de la red influyen directamente en el rendimiento del sistema.

    ¿Por qué usar una red aislada para el heartbeat en Always On?

    Como acabamos de ver, el tráfico de comunicación de Always On es crítico para mantener la estabilidad del clúster. Sin una red dedicada, esta comunicación puede verse afectada por la congestión de la red principal, lo que podría provocar falsos positivos en la detección de fallos y generar conmutaciones innecesarias. Además el rendimiento de SQL podría verse afectado sobre todo en replicaciones síncronas donde todos los nodos tienen que confirmar la escritura del dato antes de aplicarse. A continuación, analizamos las razones principales por las que una red aislada es recomendada.

    1. Optimización del rendimiento en la replicación de datos

    En configuraciones de Grupos de Disponibilidad Always On, los datos pueden replicarse de forma síncrona o asíncrona entre los nodos.En la replicación asíncrona, el rendimiento no se ve tan afectado por la latencia de la red, ya que el nodo primario no espera confirmación antes de continuar procesando transacciones. Sin embargo, en la replicación síncrona, cada transacción debe confirmarse en todas las réplicas antes de considerarse completada. Si la red es lenta o está congestionada, la latencia de confirmación aumentará, ralentizando drásticamente el rendimiento de las aplicaciones que dependen de la base de datos.

    Utilizar una red dedicada para la sincronización de Always On reduce la latencia y garantiza tiempos de respuesta óptimos, evitando que la red de producción interfiera en la replicación de datos.

    2. Evita congestión en la red de producción

    Si la red de Always On comparte infraestructura con la red utilizada por los clientes y aplicaciones, el tráfico de consultas, backups y cargas de datos puede afectar negativamente la comunicación entre los nodos. Una red separada para heartbeat y sincronización de datos garantiza que las señales críticas del clúster no se pierdan ni se retrasen debido a otras cargas de trabajo.

    3. Reduce los falsos positivos en la detección de fallos

    Si los paquetes de heartbeat se retrasan o se pierden por congestión en la red, el clúster podría interpretar que un nodo ha fallado y desencadenar una conmutación innecesaria. Esto no solo interrumpe el servicio, sino que también puede generar pérdida de rendimiento o afectar transacciones en curso. Con una red dedicada, el tráfico de heartbeat permanece estable, minimizando estos riesgos.

    4. Mayor estabilidad en entornos de “misión crítica”

    En sectores críticos como finanzas, salud o comercio electrónico, donde SQL Server gestiona transacciones en tiempo real, cualquier interrupción puede tener un impacto severo. Una red dedicada para la sincronización y el heartbeat de Always On ayuda a mantener la estabilidad operativa, asegurando que la replicación de datos no se vea afectada por otros procesos.

    5. Mejor eficiencia en la recuperación ante desastres

    En escenarios donde Always On se extiende a un sitio de recuperación ante desastres (DR), la replicación de datos entre ubicaciones puede beneficiarse de una red dedicada para evitar problemas de latencia y pérdida de paquetes. Al separar el tráfico de sincronización, se mejora la eficiencia de la conmutación a los servidores de respaldo, reduciendo el tiempo de recuperación en caso de fallos.

    6. Mayor seguridad en la comunicación entre nodos

    Al utilizar una red aislada, los paquetes de comunicación de Always On quedan protegidos de posibles ataques de red o interferencias de otras aplicaciones. Esto es especialmente importante en entornos donde se manejan datos sensibles o regulados. 

    Buenas prácticas para implementar una red de heartbeat en Always On

    Para aprovechar al máximo los beneficios de una red dedicada en Always On, es recomendable seguir algunas buenas prácticas:

    Utilizar interfaces de red dedicadas para la red heartbeat 

    Cada nodo del clúster debe contar con al menos dos interfaces de red, una para la red de producción y otra exclusivamente para la comunicación de Always On (heartbeat + sincronización de datos). Esto permite segmentar el tráfico y garantizar que los paquetes críticos siempre tengan prioridad.

    Configurar métricas de latencia adecuadas

    Ajustar los valores de timeout y umbrales de latencia en el clúster es clave para evitar falsos positivos en la detección de fallos. Dependiendo de la infraestructura, puede ser necesario aumentar los valores predeterminados para optimizar la replicación.

    Implementar calidad de servicio (QoS)

    Si la red dedicada no es una opción viable, se pueden aplicar reglas de Quality of Service (QoS) para priorizar el tráfico de Always On sobre otros tipos de tráfico en la red de producción.

    Monitorizar constantemente la red heartbeat de Always On

    La monitorización activa de la red de comunicación y replicación de Always On es crucial para detectar anomalías antes de que afecten la estabilidad del clúster. Herramientas como SQL Server Management Studio (SSMS) y System Center Operations Manager (SCOM) pueden ayudar en esta tarea.

    Usar VLANs y segmentación de red para heartbeat 

    Si no es posible contar con una red física dedicada, una alternativa viable es configurar una VLAN (Virtual LAN) para separar lógicamente el tráfico de Always On del resto del tráfico de la red.

    Configurar múltiples rutas de comunicación

    Para entornos de alta disponibilidad extrema, es recomendable configurar múltiples rutas de comunicación entre los nodos utilizando distintas interfaces de red y switches redundantes. Esto permite continuar la comunicación en caso de fallos en una de las rutas.

    Conclusión

    El uso de una red aislada para la comunicación de Always On no solo garantiza una mayor estabilidad en la detección de fallos, sino que también optimiza el rendimiento en la replicación de datos, especialmente en configuraciones síncronas. Al reducir la latencia y evitar interferencias con el tráfico de producción, se mejora significativamente la eficiencia del clúster y se minimiza el riesgo de interrupciones.

    Para cualquier organización que dependa de SQL Server Always On, implementar una red dedicada para heartbeat y sincronización es una estrategia clave para mantener un rendimiento óptimo y asegurar la continuidad del servicio en entornos críticos.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Alta Disponibilidad, Rendimiento, SQL Server, 0 comentarios

    ID autoincrementales, GUID y secuencias: ¿cuál elegir?

    ID incrementales o GUID ¿cuál elegir?, esta es la pregunta que me hizo uno de vosotros hace unos días. Y yo también añadiría a la pregunta las secuencias. Vamos a tratar de responder esta duda. 

    Cuando diseñamos un modelo de datos en SQL Server o cualquier otro sistema de bases de datos relacional, una de las decisiones más importantes es la elección del tipo de identificador principal para nuestras tablas. ID autoincrementales, GUID y secuencias son opciones comunes, cada una con sus ventajas y limitaciones. En este artículo veremos las características de cada enfoque, sus diferencias y cómo afectan al rendimiento y a la fragmentación de índices para tratar de llegar a la respuesta ideal para cada escenario. Porque sí, como pasa siempre con las soluciones de bases de datos, vais a ver que no existe una respuesta única para todos los escenarios.

    IDs autoincrementales

    Los ID autoincrementales, conocidos como IDENTITY, son probablemente la solución más utilizada. Se generan de manera automática con cada inserción en la tabla, siguiendo un orden secuencial. Este tipo de identificador es ideal para sistemas centralizados donde no se necesita garantizar unicidad global. Su principal ventaja radica en el consumo reducido de espacio y el bajo impacto en la fragmentación de índices clustered, ya que las inserciones se producen siempre al final del índice.

    Lo normal para este tipo de IDs es usar valores numéricos del tipo INT (desde -2.147.483.648 hasta 2.147.483.647) o BIGINT (desde – 9.223.372.036.854.775.808 a 9.223.372.036.854.775.807). Porque sí, los valores negativos también existen y son utilizables.

    Sin embargo, los ID autoincrementales no están exentos de problemas. Por ejemplo, en sistemas distribuidos o replicados, la generación secuencial puede llevar a conflictos si diferentes nodos intentan generar los mismos valores. Además, al ser fácilmente predecibles, pueden ser problemáticos desde una perspectiva de seguridad.

    GUID: ID con unicidad global 

    Los GUID o identificadores únicos globales son valores generados al azar que garantizan unicidad, incluso entre sistemas distribuidos. Esta característica los hace indispensables en escenarios de replicación o cuando los datos se integran desde múltiples orígenes.

    El problema de los GUID radica en su tamaño: 16 bytes por registro frente a los 4 u 8 bytes de un INT o BIGINT respectivamente. Esto aumenta significativamente el tamaño de las tablas y los índices y, en consecuencia, el coste de las consultas. Además, su naturaleza aleatoria introduce fragmentación en índices, afectando negativamente al rendimiento en sistemas con altas tasas de inserción.

    Para mitigar estos problemas, SQL Server ofrece la función NEWSEQUENTIALID(), que genera GUID en orden secuencial, reduciendo la fragmentación pero sin eliminarla completamente.

    Secuencias: ID compartidos

    Las secuencias son una alternativa poderosa introducida en SQL Server 2012. Se definen como objetos independientes a las tablas que generan números únicos bajo demanda, ofreciendo un control total sobre cómo se producen los valores. A diferencia de los ID autoincrementales, las secuencias no están ligadas a una tabla específica, lo que las hace reutilizables en múltiples tablas o contextos. Una de sus ventajas clave es la posibilidad de configurarlas para satisfacer requisitos específicos, como usar valores iniciales personalizados o incrementos distintos de uno. Además, permiten generar identificadores únicos en sistemas distribuidos mediante estrategias como prefijos por nodo.

    Sin embargo, las secuencias también presentan limitaciones, como la posibilidad de generar brechas en caso de transacciones fallidas y una configuración inicial más compleja que los ID autoincrementales.

    Comparativa: ID autoincrementales, GUID y secuencias

    A continuación, os muestro una tabla resumen con una comparación detallada de las tres opciones:


    CriterioAutoincrementalesGUIDsSecuencias
    Tamaño4-8 bytes (INT, BIGINT)16 bytes (uniqueidentifier)4-8 bytes (INT, BIGINT)
    FragmentaciónBajaAlta (aleatoria)Baja si se utiliza con cuidado
    Unicidad globalNoSíSí (configurable)
    FlexibilidadBajaAltaMuy alta
    DesempeñoAltoMedio-bajoAlto
    Compatibilidad distribuidaLimitadaAltaMedia-alta


    Fragmentación de índices y su impacto

    La fragmentación es un factor crucial en el rendimiento de una base de datos. En índices clustered, los valores secuenciales de ID autoincrementales o secuencias generan inserciones ordenadas, minimizando la fragmentación. Por el contrario, los GUID, debido a su naturaleza aleatoria, obligan a reordenamientos constantes en las páginas del índice, aumentando tanto la fragmentación como el coste de mantenimiento.

    Para mitigar este problema con GUID, se recomienda usar índices no clustered (no exentos de fragmentación pero con menor impacto) o estrategias como NEWSEQUENTIALID() cuando sea posible. En el caso de secuencias, su comportamiento depende de cómo se configuren, los valores secuenciales preservan el orden, mientras que configuraciones más complejas pueden introducir fragmentación.


    Conclusión

    No hay una única solución ideal; la elección depende del contexto y los requisitos del sistema. Si el rendimiento y el espacio son prioritarios, los ID autoincrementales son la mejor opción en sistemas centralizados. Para entornos distribuidos donde la unicidad global es crucial, los GUID son indispensables, aunque con un coste en rendimiento y espacio. Finalmente, las secuencias ofrecen una alternativa flexible y controlada que puede adaptarse a múltiples escenarios, especialmente cuando se necesita compatibilidad entre tablas o nodos. En última instancia, el éxito radica en comprender las ventajas y limitaciones de cada enfoque, optimizando su uso según las necesidades específicas del proyecto.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios