Power BI

Data Saturday Madrid 2026: tres días de formación en SQL Server que no deberías perderte

Hay oportunidades de formación que merece la pena aprovechar, especialmente cuando podemos aprender directamente de profesionales que llevan años trabajando con los problemas que nosotros nos encontramos cada día. Y si además podemos hacerlo presencialmente, compartir experiencias con otros compañeros y acceder a esa formación por un precio casi simbólico, tenemos pocos motivos para dejarla pasar.

Los próximos 5, 6 y 7 de noviembre de 2026, Madrid volverá a convertirse en uno de los principales puntos de encuentro de la comunidad de datos con una nueva edición de Data Saturday Madrid.

Este año tendremos tres días dedicados a la formación, con talleres especializados el jueves y el viernes y una jornada completa de sesiones gratuitas el sábado. Hablaremos de SQL Server, Microsoft Fabric, Power BI, inteligencia artificial y muchas otras tecnologías relacionadas con los datos.

Pero hoy queremos detenernos especialmente en una oportunidad que nos parece extraordinaria: tres talleres de SQL Server, para distintos niveles de experiencia, impartidos por profesionales de referencia internacional.

Y sí, uno de ellos lo impartiré yo.

Formación en SQL Server para todos los niveles en Data Saturday Madrid

Uno de los grandes atractivos de esta edición es que no tendremos que elegir entre formación de iniciación y contenidos avanzados. La organización ha preparado talleres para perfiles muy diferentes, desde quienes todavía no saben escribir una consulta SQL hasta administradores experimentados que quieren profundizar en el funcionamiento interno del motor.
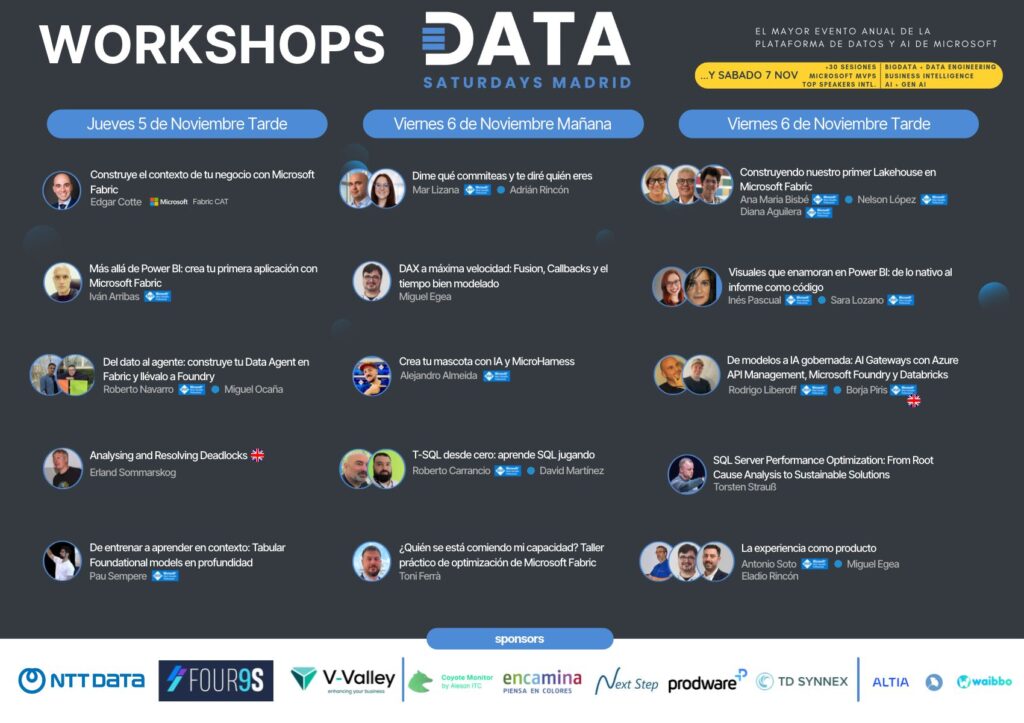
En nuestro caso, tenemos tres propuestas que encajan perfectamente en un itinerario de formación en SQL Server: aprender a consultar datos, comprender y resolver problemas de concurrencia y mejorar el rendimiento de nuestras bases de datos.

Además, los talleres tienen un precio especialmente reducido: 25 € más tasas para las sesiones de dos horas del jueves y 50 € más tasas para las sesiones de cuatro horas del viernes.

Hablamos de formación presencial impartida por especialistas de primer nivel. Por ese importe, resulta complicado encontrar alternativas comparables en el mercado de formación profesional.

T-SQL desde cero: aprende SQL jugando

Viernes 6 de noviembre, de 10:00 a 14:00 | Roberto Carrancio y David Martínez de Frutos | 50 € + tasas
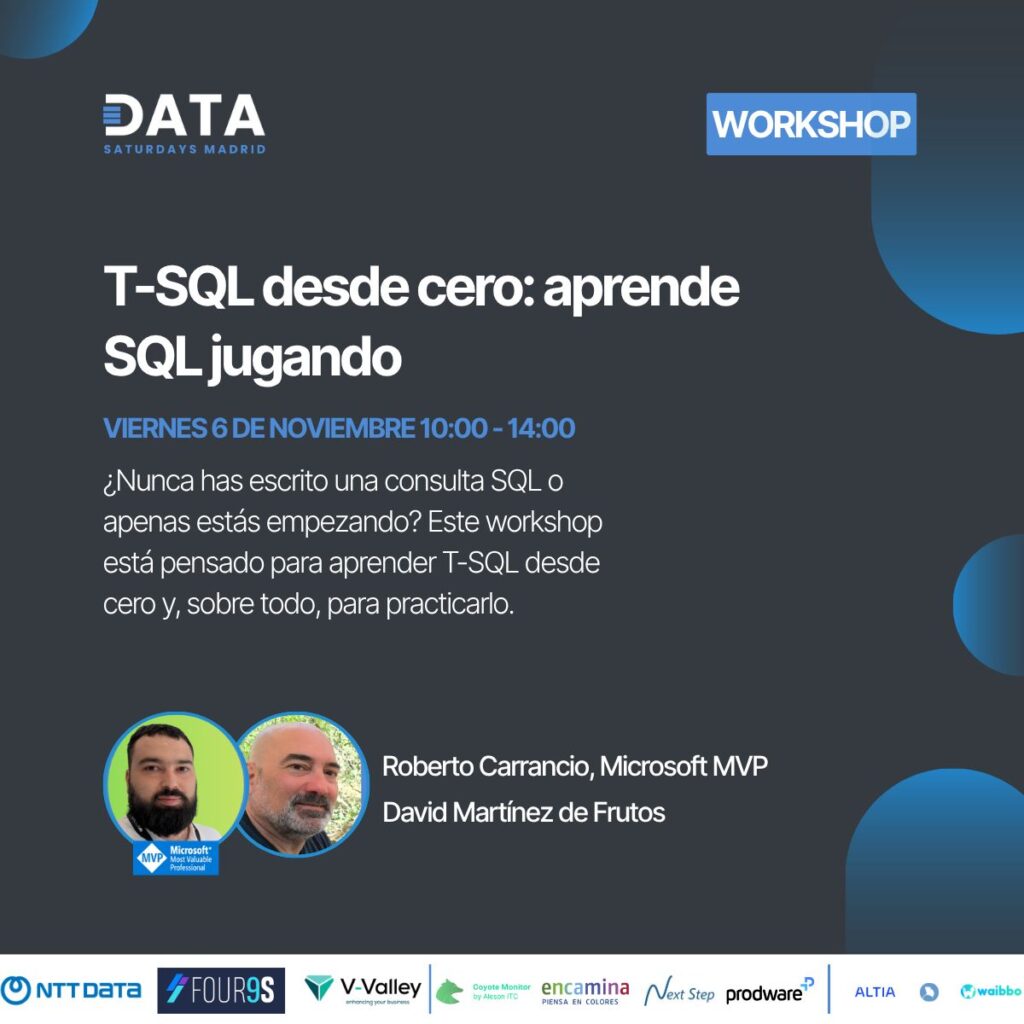
Empezamos por nuestro taller, que impartiré junto a David Martínez de Frutos y que hemos preparado pensando en quienes quieren aprender SQL desde cero, pero también en quienes llevan tiempo trabajando con datos y todavía dependen de otras herramientas para consultarlos.

Actualmente podemos desarrollar aplicaciones, elaborar informes o construir soluciones analíticas sin escribir prácticamente ninguna consulta SQL. Las herramientas cada vez abstraen más operaciones y eso facilita muchísimo nuestro trabajo.

Sin embargo, cuando necesitamos investigar un problema, analizar datos directamente, optimizar una consulta o comprender qué está haciendo realmente una aplicación contra la base de datos, esos conocimientos siguen siendo fundamentales.

Por eso este taller está especialmente orientado a desarrolladores, analistas, arquitectos y científicos de datos. También a administradores de bases de datos junior, o profesionales que quieren comenzar su carrera como DBA.

Porque administrar SQL Server no consiste únicamente en conocer la infraestructura, configurar copias de seguridad o gestionar la alta disponibilidad. Necesitamos entender las consultas que ejecutan nuestras aplicaciones y cómo trabajan con los datos.

Durante las primeras horas aprenderemos mediante ejemplos y ejercicios prácticos. Partiremos de las consultas más sencillas e iremos incorporando filtros, ordenaciones, agrupaciones, combinaciones de tablas y otros recursos de T-SQL que utilizamos habitualmente.

No queremos que los participantes se limiten a ver cómo escribimos consultas. Queremos que las escriban ellos mismos, se equivoquen, corrijan y comprendan por qué funcionan.

Y después del descanso llegará la parte más divertida.

¡Jugaremos al CluedoSQL!

Hemos preparado una actividad de investigación en la que los participantes tendrán que utilizar las consultas SQL para encontrar pistas, relacionar información y resolver un misterio.

De esta manera, terminaremos el taller aplicando todo lo aprendido a un problema práctico, con un objetivo que va mucho más allá de ejecutar consultas siguiendo unas instrucciones.

Nuestra intención es que quienes lleguen sin conocimientos de SQL salgan con una base sólida para continuar aprendiendo y, sobre todo, con confianza para empezar a trabajar directamente con los datos.

Analysing and Resolving Deadlocks, con Erland Sommarskog

Jueves 5 de noviembre, de 17:30 a 19:30 | Erland Sommarskog | Inglés | 25 € + tasas
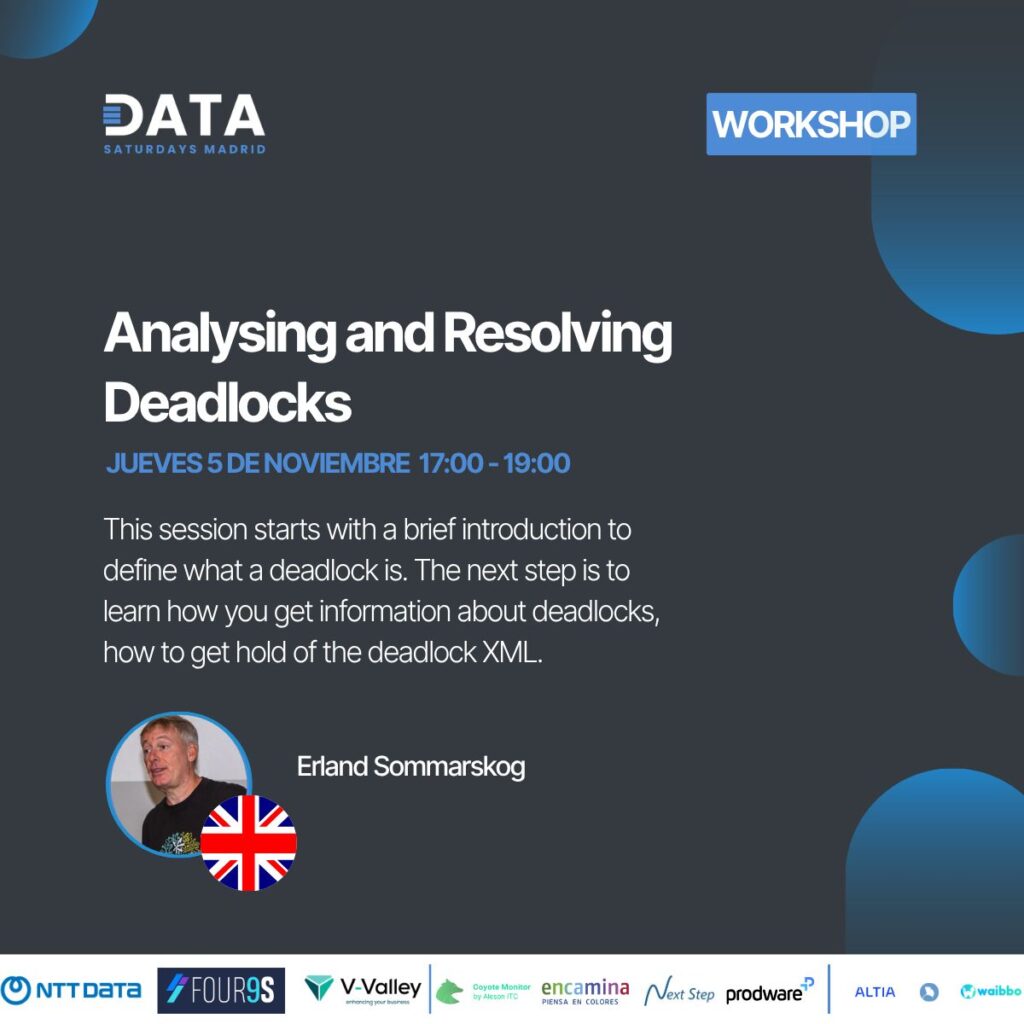
Subimos considerablemente el nivel con un taller impartido por Erland Sommarskog, uno de los profesionales más reconocidos de la comunidad internacional de SQL Server.

Si llevamos un tiempo administrando bases de datos o desarrollando aplicaciones con cierta concurrencia, seguramente nos habremos encontrado con algún deadlock.

Son situaciones en las que varias sesiones terminan bloqueándose mutuamente y SQL Server necesita intervenir para romper el ciclo, seleccionando una de ellas como víctima.

Hasta aquí, la teoría parece sencilla. El problema aparece cuando tenemos que averiguar qué ha ocurrido realmente y, especialmente, cómo evitar que vuelva a suceder.

Podemos consultar el deadlock XML y visualizar el gráfico correspondiente, pero interpretar correctamente los procesos implicados, los recursos, las operaciones y las condiciones que han provocado el conflicto requiere conocimientos más profundos.

En este taller aprenderemos a obtener las evidencias necesarias para investigar estos problemas y a interpretar la información que proporciona SQL Server.

Es una formación especialmente interesante para DBAs con experiencia, responsables de rendimiento y desarrolladores que trabajan con aplicaciones transaccionales.

Y aprenderlo directamente de Erland Sommarskog es una oportunidad difícil de repetir. Quienes llevamos años trabajando con SQL Server conocemos el valor de sus publicaciones y de sus aportaciones técnicas a la comunidad.

SQL Server Performance Optimization, con Torsten Strauß

Viernes 6 de noviembre, de 15:30 a 19:30 | Torsten Strauß | Inglés | 50 € + tasas
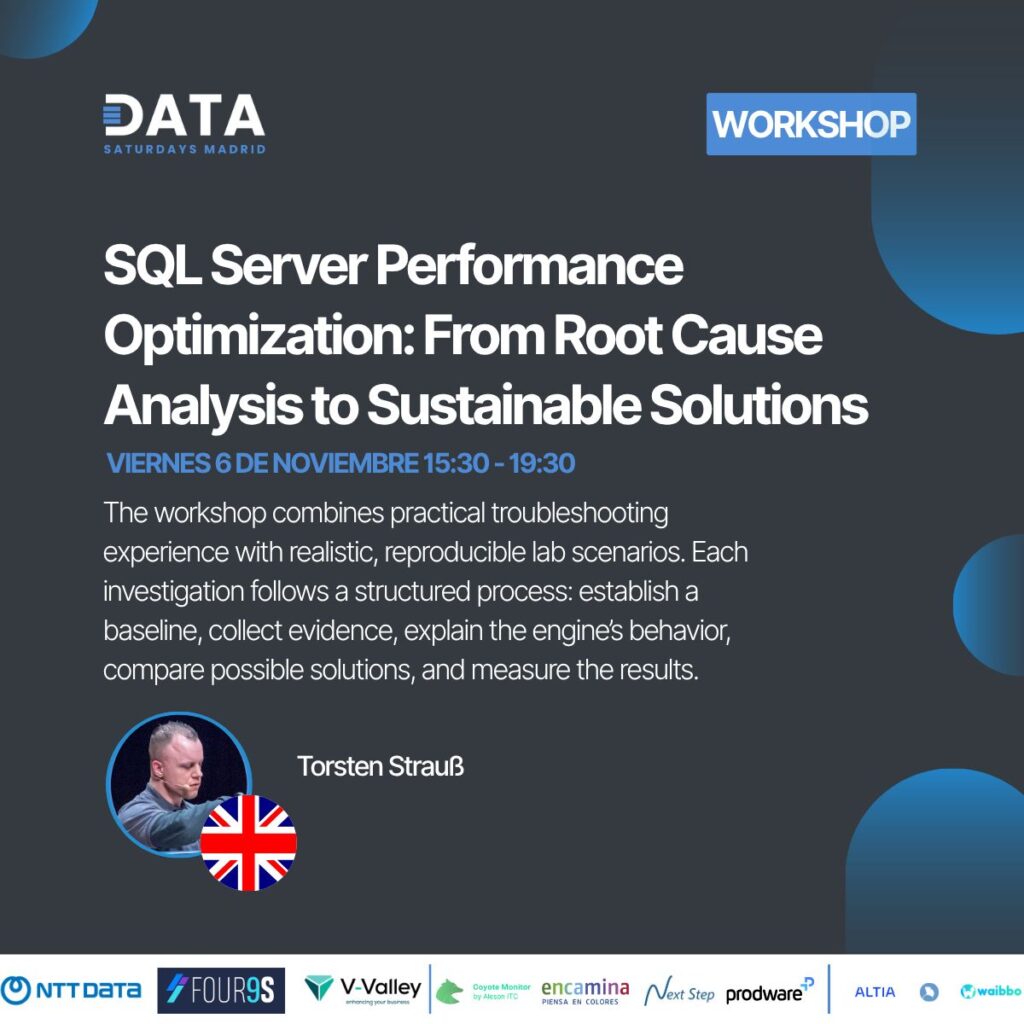
El tercer taller dedicado a SQL Server nos llevará a uno de los terrenos que más nos gustan: el análisis y la optimización del rendimiento.

SQL Server Performance Optimization: From Root Cause Analysis to Sustainable Solutions, impartido por Torsten Strauß, propone un enfoque que consideramos fundamental cuando trabajamos con problemas de rendimiento: dejar de aplicar soluciones por intuición y empezar a investigar con evidencias.

Todos hemos visto situaciones en las que alguien identifica una consulta lenta y propone inmediatamente crear un índice, aumentar la memoria del servidor o modificar alguna configuración.

A veces funciona. Otras veces simplemente trasladamos el problema a otro lugar.

La optimización del rendimiento requiere comprender qué está sucediendo, establecer una referencia inicial, recopilar información y encontrar la causa real del problema antes de decidir qué cambiar.

Durante cuatro horas, Torsten trabajará con escenarios prácticos y reproducibles que permitirán recorrer ese proceso completo: desde la investigación inicial hasta la comparación de posibles soluciones y la medición de los resultados.

Este planteamiento resulta especialmente interesante para DBAs de nivel medio y senior, profesionales especializados en rendimiento y arquitectos que necesitan diagnosticar problemas complejos.

Porque conseguir que una consulta tarde menos después de modificar algo está bien, pero comprender por qué mejora y garantizar que nuestra solución no introduce nuevos problemas es bastante más importante.

¿Cómo convencer a mi jefe para que me deje ir?

Seguramente más de uno habrá llegado hasta aquí pensando que los talleres le interesan, pero que se celebran en horario laboral y tendrá que pedir permiso en su empresa.

Y aquí tenemos un argumento bastante sencillo: la formación no es únicamente un beneficio para el profesional que asiste, también puede aportar un valor directo a la organización.

Una mejor comprensión de T-SQL nos ayuda a desarrollar consultas más eficientes, reducir errores y resolver problemas sin depender constantemente de otros equipos.

Aprender a investigar deadlocks permite identificar problemas de concurrencia que pueden afectar al funcionamiento de aplicaciones críticas. Y mejorar nuestra capacidad de diagnóstico del rendimiento puede evitar intervenciones innecesarias y reducir el tiempo dedicado a resolver incidencias.

Si añadimos que hablamos de talleres especializados de dos o cuatro horas, con precios de 25 € o 50 € más tasas, el coste de la formación resulta muy reducido.

Eso sí, tendremos que contar también con el tiempo de asistencia y, cuando corresponda, los desplazamientos. Pero incluso considerando esos aspectos, la propuesta resulta atractiva.

Para facilitar la gestión, os dejo un correo que podéis adaptar y enviar a vuestro responsable:

Asunto: Solicitud de asistencia a formación técnica en Data Saturday Madrid 2026

Hola, [nombre]:

Los próximos 5 y 6 de noviembre se celebrarán en Madrid varios talleres técnicos organizados dentro de Data Saturday Madrid 2026.

Me gustaría solicitar autorización para asistir al taller [nombre del taller], centrado en [temática], que considero especialmente interesante para mejorar mis conocimientos y aplicarlos directamente a nuestro trabajo.

La formación la impartirán profesionales de reconocido prestigio internacional en tecnologías Microsoft y SQL Server, con un enfoque práctico orientado a resolver problemas reales.

Considero que estos conocimientos pueden aportar beneficios directos a nuestro equipo, especialmente en aspectos como la calidad del código SQL, el diagnóstico de incidencias, la optimización del rendimiento y la reducción de problemas de concurrencia, según el contenido del taller.

Además, la organización ofrece estos talleres a un precio muy reducido:

  • Taller de dos horas: 25 € más tasas.
  • Taller de cuatro horas: 50 € más tasas.

Se trata de una oportunidad de acceder a formación especializada de alto nivel con una inversión económica muy inferior a la habitual en cursos profesionales de estas características.

Por mi parte, me comprometo a compartir con el equipo los conocimientos adquiridos y a identificar posibles mejoras que podamos aplicar en nuestros proyectos.

También aprovecharía la celebración de Data Saturday Madrid el sábado 7 de noviembre, con sesiones técnicas gratuitas sobre SQL Server, Azure, Microsoft Fabric e inteligencia artificial.

¿Podemos valorar mi asistencia a esta formación?

Muchas gracias.

Un saludo.

El correo es solo un punto de partida. Cuanto más consigas relacionar el contenido del taller con las necesidades reales de tu empresa, más fácil resultará justificar la inversión.

Y no olvidemos algo importante: una formación que nos ayuda a evitar una incidencia o a diagnosticar un problema crítico con mayor rapidez puede compensar sobradamente su coste.

El sábado 7 de noviembre tendremos Data Saturday Madrid completamente gratis

Los talleres son solamente el aperitivo. El sábado 7 de noviembre llegará la jornada principal de Data Saturday Madrid 2026, con un programa de sesiones técnicas impartidas por profesionales nacionales e internacionales.
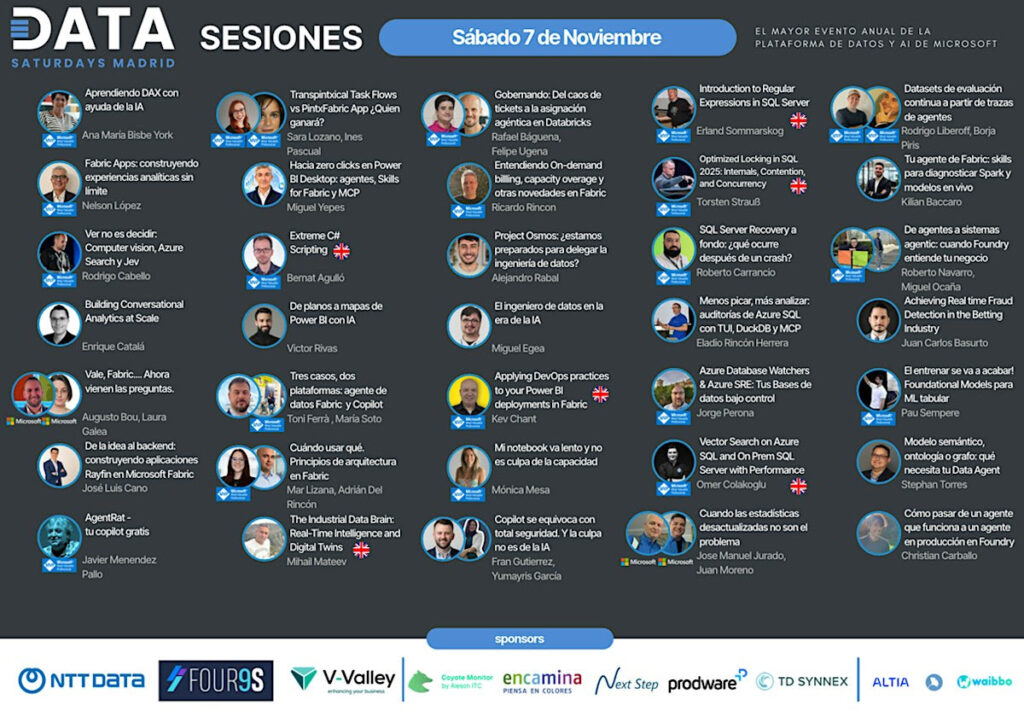
La entrada es gratuita, con una aportación solidaria de 1 € destinada a una ONG, y requiere inscripción previa.

La jornada tendrá lugar en la Escuela Politécnica Superior de la Universidad CEU San Pablo, en el campus de Montepríncipe, Alcorcón, mientras que los talleres del jueves y el viernes se celebrarán en las instalaciones de NTT DATA University, en Madrid.

Durante el sábado podremos asistir a sesiones sobre SQL Server, Azure SQL, Microsoft Fabric, Power BI, inteligencia artificial, ingeniería de datos y otras tecnologías.

Para quienes estamos especialmente interesados en SQL Server, el programa incluye varias propuestas muy interesantes.

Erland Sommarskog hablará sobre expresiones regulares en SQL Server, mientras que Torsten Strauß profundizará en los bloqueos optimizados de SQL Server 2025 y su impacto en la concurrencia.

También tendremos sesiones dedicadas a auditorías de Azure SQL, Azure Database Watcher, búsqueda vectorial y rendimiento, y al papel de las estadísticas en el comportamiento del optimizador de consultas.

Y por mi parte, volveremos a meternos en las tripas del motor con «SQL Server Recovery a fondo: ¿qué ocurre después de un crash?».

Será una sesión de nivel avanzado, especialmente pensada para administradores que quieren comprender qué sucede internamente cuando SQL Server necesita recuperar una base de datos después de una interrupción inesperada.

Hablaremos de recuperación transaccional y de las fases que permiten devolver una base de datos a un estado consistente. Una de esas cuestiones que normalmente damos por resueltas hasta que necesitamos comprender por qué una base de datos tarda tanto en volver a estar disponible.

Pero Data Saturday no es solamente SQL Server. Tendremos sesiones sobre agentes de inteligencia artificial, arquitecturas de datos, DAX, Copilot, desarrollo sobre Fabric y muchas otras materias.

Además, una parte fundamental de estos eventos ocurre fuera de las salas. Poder intercambiar experiencias con otros profesionales, reencontrarnos con compañeros de la comunidad y conversar directamente con los ponentes aporta un valor que difícilmente conseguimos con la formación grabada.

Cómo inscribirse en los talleres y en Data Saturday Madrid 2026

La organización gestiona las inscripciones a los talleres y a la jornada del sábado por separado, así que conviene tenerlo en cuenta al planificar la asistencia.

Los talleres tienen plazas limitadas y podemos inscribirnos en uno o varios, siempre que sus horarios sean compatibles. Se celebrarán en NTT DATA University, Camino de la Fuente de la Mora, 1, Madrid.

Inscripción a los talleres del 5 y 6 de noviembre: https://www.eventbrite.es/e/registro-workshops-pre-data-saturday-madrid-2026-sqlsaturdaymadrid-2003135148151

El sábado se celebrará en el campus de Montepríncipe del CEU San Pablo, en Alcorcón. Aunque la jornada sea gratuita, necesitamos conseguir una entrada. La organización también contempla una asignación de plazas del sábado para inscritos en los talleres, hasta completar el cupo correspondiente.

Inscripción a las sesiones del sábado 7 de noviembre: https://www.eventbrite.es/e/registro-data-saturday-madrid-2026-sqlsaturdaymadrid-2002195163632

Con algo de planificación podemos disfrutar de dos o incluso tres días de formación, combinando un taller especializado con sesiones técnicas y tiempo para compartir experiencias con la comunidad.

Conclusión: una oportunidad para aprender SQL Server de los mejores

No todos los días tenemos en Madrid a referentes internacionales como Erland Sommarskog y Torsten Strauß impartiendo talleres presenciales a precios de comunidad.

Tampoco es habitual poder combinar formación especializada para DBAs experimentados con talleres de iniciación y una jornada completa de conferencias gratuitas.

Si estás empezando con SQL, esperamos verte el viernes por la mañana aprendiendo T-SQL con nosotros y resolviendo el misterio de CluedoSQL. Si ya tienes experiencia, los talleres avanzados y las sesiones del sábado ofrecen una oportunidad excelente para profundizar en aspectos que tienen un impacto directo en nuestro trabajo.

Del 5 al 7 de noviembre tenemos una cita con SQL Server y la comunidad de datos en Madrid. Nos vemos allí.

Publicado por Roberto Carrancio en Cloud, Power BI, Rendimiento, SQL Server, 0 comentarios

Final de año de comunidad: eventos, charlas y oportunidades

Se acerca el final del año y, como suele pasar, nos entra la prisa por encajar en el calendario todo lo que no hicimos en primavera. Resultado, el último trimestre está cargado de eventos, meetups, conferencias y saraos varios. Y no me quejo, al contrario. Es ahora cuando se ve quién está realmente comprometido con la comunidad técnica y quién solo se apunta cuando hay camisetas gratis.

Este artículo no va de SQL Server (aunque aparecerá, no os preocupéis). Va de comunidad. De compartir conocimiento, de subirse al escenario a contar lo que uno ha aprendido a base de picar piedra. Y, sobre todo, va de animar a más gente a participar. Así que si eres de los que siempre dicen “me gustaría dar una charla algún día” o simplemente nunca antes te has animado a venir de público a un evento… este trimestre tienes varios “algún día” a tiro.

Vamos al lío. Os dejo el calendario de eventos clave para lo que queda de año, algunos de los cuales tengo el placer de participar directamente.

Power BI & Fabric Days (Barcelona, 17 y 18 de octubre)

Este viernes y sábado se celebra en Barcelona una de las citas clave para los que trabajamos con tecnologías de datos de Microsoft.

En mi caso, estaré dando una charla sobre Power BI Report Server (PBIRS), ese gran olvidado que sigue teniendo hueco (y sentido) en muchos entornos corporativos. Pero no vengo solo, hay un montón de sesiones, talleres prácticos y espacio para hacer networking del bueno. Ya sabes ese networking que empieza con “¿y tú qué haces en tu curro?” y acaba en “te paso el script que usamos para eso”.

El evento es gratuito, con registro previo y plazas limitadas. Si estás en Barcelona o puedes desplazarte, no hay excusa. Consigue aquí tu entrada para los talleres o para las charlas.

Optimización de SQL para Power Platform (Online, 30 de octubre)

El jueves 30 de octubre tengo sesión online para la comunidad de Power Platform Madrid. Vamos a hablar de SQL, claro, pero desde la óptica que cada vez más nos piden: ¿cómo optimizar lo que hay detrás de nuestros reportes en Power BI y Fabric?

Spoiler: Muchas veces, lo que falla no está en la nube, sino en ese SELECT * que alguien pensó que era inocente.

Eventos Online PPM

Será una sesión práctica, sin más PowerPoints del imprescindible, pensada para quienes están sufriendo con conectores lentos, tablas compartidas con medio planeta y consultas que tardan más que una reunión de status. Regístrate aquí para no perdértelo.

NetCoreConf Madrid (14 de noviembre)

Evento veterano donde los haya, NetCoreConf vuelve a Madrid con una edición presencial que promete. Aunque el call for speakers aún está abierto, ya se sabe que este evento es terreno fértil para desarrolladores de nivel, sesiones técnicas de verdad y, cómo no, muchas charlas sobre datos, arquitectura y rendimiento.

Yo pienso estar allí, veremos si como ponente o no. Porque aunque vayas solo de oyente, siempre se aprende algo. O al menos descubres cómo están resolviendo otros lo que tú estás parcheando como puedes.

Si estás pensando enviar sesión, aún llegas. Y si no, al menos resérvate el día en el calendario.

Data Saturday Madrid (27 al 29 de noviembre)

Este es el evento. Así, sin más.

Data Saturday Madrid es la cita principal de la comunidad de datos en España. Y este año viene con tres días completos: dos días de talleres intensivos y un día de conferencias con ponentes de primera línea, tanto nacionales como internacionales.

La agenda aún no está publicada (a fecha de escribir esto), pero no hace falta verla para saber que el nivel será alto. Si vienes, tráete libreta y preguntas. Y si no vienes… bueno, luego no digas que no te enteras de las tendencias del sector.

Estaré por allí seguro. Y si te cruzas conmigo, saluda. Siempre es buen momento para desvirtualizar a gente que lleva años sufriendo los mismos deadlocks que tú.

Corre y consigue aquí tu entrada antes de que se acaben (el año pasado mucha gente se quedó fuera por Sold Out)

Non-Profit Community Day Spain (Madrid, 4 de diciembre)

Este es un evento distinto, y eso es lo que lo hace especial. El Non-Profit Community Day Spain se celebra en las oficinas de Microsoft en Madrid y está centrado en ONGs, fundaciones y proyectos sin ánimo de lucro.

Habrá charlas técnicas, casos de uso reales y mucho foco en cómo la tecnología puede aportar valor social. No hay agenda todavía cerrada porque el Call for Speakers sigue abierto, pero si tienes una historia que contar (y todos tenemos alguna), aquí tienes un escenario ideal.

Tecnología con propósito. Y en un entorno que suele estar infrarrepresentado en nuestros circuitos habituales.

Christmas Power Platform (12 y 13 de diciembre, online)

Seguimos con las causas solidarias. 

La segunda edición de este evento benéfico tiene todos los ingredientes que deberían movernos a participar: es online, es para una buena causa (recaudación para una ONG que trabaja con niños hospitalizados) y está abierto a todos.

Las charlas son de 20 minutos, formato ligero, y cubren cualquier tema relacionado con datos, Power Platform, IA, automatización o BI. Si alguna vez has dicho “yo no tengo nivel para hablar en público”, este es el sitio perfecto para empezar. Nadie te va a juzgar, y todos vamos a aprender algo. Animate y presenta tu sesión aquí.

Y si no te animas a presentar sesión, al menos conéctate y aporta con tu presencia, con una donación o simplemente dando difusión. A veces, ser comunidad también es esto, estar cuando no hay regalos ni sorteos, pero sí mucho corazón.

Comunidad SQL Server Español (14/10 y cada segundo martes del mes)

No podía cerrar esta agenda sin mencionar los eventos online de la comunidad SQL Server Español, que organizo junto a Cristina y que cada mes reúnen a decenas de profesionales con algo en común: siguen trabajando con SQL Server y quieren hacerlo mejor.

Este martes 14 de octubre (sí, mañana si estás leyendo esto el lunes), contaremos con Jorge Perona, que nos hablará de cómo administrar entornos on-prem desde la nube usando Azure Arc. Una charla muy oportuna, especialmente para quienes andan en entornos híbridos donde lo único constante es el caos de licencias, políticas y versiones mezcladas. Consigue tu entrada totalmente gratis aquí.

Y como cada mes, nos volveremos a ver el segundo martes de noviembre y el segundo martes de diciembre. Aún no puedo adelantaros las ponencias que serán, pero como siempre, serán sesiones técnicas de verdad. Nada de postureo. Aquí venimos a hablar de índices, de rendimiento, de administración real.

Si trabajas con SQL Server, hablas español y aún no te has pasado por uno de estos eventos, no sé a qué esperas.

Conclusión

El calendario está lleno. Hay eventos en todas las modalidades: presenciales, online, técnicos, sociales, de comunidad pura y de divulgación. No todos te interesarán, y no pasa nada. Pero si te interesa mejorar como profesional, hacer contactos más allá de LinkedIn y aprender de gente que ya ha pasado por lo mismo que tú… no hay mejor inversión de tiempo.

Además, si llevas tiempo pensando en dar una charla, enviar un paper o simplemente aparecer por un evento y escuchar, este último tramo del año es tu oportunidad. Entre sesiones mensuales, eventos solidarios y conferencias de alto nivel, el menú no puede ser más completo.

Y ya sabes: quien no se mueve, no sale en la foto. Nos vemos en los eventos.

PD: Si quieres hacerte con uno de mis libros o ya lo tienes y quieres una dedicatoria vente a uno de estos eventos y avísame.

Publicado por Roberto Carrancio en Otros, 0 comentarios

¿Está SQL Server realmente muerto como dicen algunos?

Cada pocos años alguien anuncia la muerte de SQL Server con la misma convicción con la que se predice el fin del mundo. Y, como suele pasar, seguimos aquí, con instancias vivas, bases de datos respirando y DBAs quejándose de los mismos problemas de siempre… y de unos nuevos. El auge de las bases de datos analíticas, la popularidad de entornos cloud como Snowflake o Microsoft Fabric, el ruido de las soluciones NoSQL y la omnipresencia de alternativas relacionales como MySQL o PostgreSQL han creado un escenario donde cualquiera podría pensar que el reinado de SQL Server se tambalea. Sin embargo, las novedades anunciadas para SQL Server 2025 apuntan a todo lo contrario: el producto sigue mutando para seguir siendo relevante, incluso si eso implica acercarse peligrosamente al mundo de la ciencia de datos. Y todo esto sin soltar la bandera que le hizo grande: el motor transaccional.

El entorno actual: cada uno en su liga

No es ningún secreto que las bases de datos analíticas están en su momento. Snowflake, BigQuery o Azure Synapse se han convertido en la herramienta preferida para quienes necesitan triturar terabytes de datos con más rapidez que un analista quemando su último café. Microsoft, por su parte, ha apostado fuerte con Fabric, un entorno que quiere ser la navaja suiza del dato: integración, ingeniería, análisis, IA… y todo en la nube, sin que te preocupes por el hardware (o eso dicen, hasta que llega la factura).

En paralelo, el ecosistema NoSQL sigue vivo, aunque su hype inicial ya no llena auditorios. MongoDB, Cassandra y compañía encontraron su nicho: estructuras flexibles, escalabilidad horizontal y consultas rápidas para ciertos patrones de uso. Pero conviene recordar que no es la primera vez que la industria promete que “lo nuevo” es la panacea. Antes fue XML en bases de datos, luego el OLAP embebido en todo, más tarde los lagos de datos que acabarían con los almacenes tradicionales… y ahí siguen las bases relacionales, 50 años después, ejecutando transacciones sin descanso. “Sin esquema” no significa “sin problemas”, y muchos que lo ignoraron pagaron el precio en migraciones forzadas y dolores de cabeza técnicos.

Mientras tanto, las bases de datos relacionales de código abierto siguen creciendo. PostgreSQL ha dejado de ser el “hermano alternativo” para convertirse en la opción principal de muchos nuevos proyectos. MySQL, que sobrevive gracias a su inercia y al ecosistema que lo rodea, sigue presente en millones de aplicaciones. Y hasta SQLite, ese motor minimalista, tiene más implantación de la que muchos sospechan, realmente es la base de datos relacional más utilizada, gracias en parte a que está embebido en aplicaciones móviles, navegadores y dispositivos IoT.

SQL Server en 2025: más que un SGBD relacional

Si echamos un vistazo a las novedades anunciadas para SQL Server 2025, el mensaje es claro: Microsoft no quiere que SQL Server se perciba solo como “la base de datos transaccional de siempre” y a la vez sí. La integración nativa con capacidades de ciencia de datos, el soporte extendido para Python y R, y la mejora de conectores con entornos como Fabric o Azure Machine Learning junto con las optimizaciones y mejoras del motor transaccional lo colocan como una plataforma híbrida, capaz de manejar tanto cargas OLTP como escenarios analíticos complejos.

Esto no es nuevo. Llevamos años viendo cómo SQL Server incluye características que antes parecían fuera de lugar: PolyBase para consultar datos externos, Graph Database para modelar relaciones no relacionales, o el soporte para formatos como Parquet y ORC a través de EXTERNAL TABLE. Pero en 2025 la apuesta es más decidida: acercar al científico de datos a la misma herramienta donde ya vive el dato empresarial. Porque mover datos sigue siendo caro y lento, aunque lo disfracemos de “pipelines”.

El motor OLTP: la base que no se toca

Entre tanta novedad es fácil olvidar lo obvio: SQL Server sigue siendo, ante todo, un motor OLTP sólido, fiable y maduro. Es el tipo de sistema que lleva años procesando millones de transacciones diarias sin que nadie lo ponga en duda. No será el más rápido del mundo en benchmarks aislados, pero tampoco se estrella en ninguna disciplina. Es ese jugador de equipo que no siempre marca goles espectaculares, pero nunca falla un pase. En entornos de misión crítica, eso vale más que el hype de la semana.

Aplicaciones financieras, sistemas de reservas, ERPs, CRMs… todos siguen necesitando un motor transaccional robusto, y SQL Server continúa cumpliendo sin dramas. Es cierto que el mercado está más fragmentado, pero en el terreno de las operaciones diarias, la consistencia y la integridad de datos no pasan de moda. Y ahí, el producto sigue ofreciendo un equilibrio que otros todavía no alcanzan.

Azure SQL: el motor en modo nube

En paralelo, Microsoft ha sabido llevar el ADN de SQL Server a la nube con Azure SQL Database y Azure SQL Managed Instance. Ambos ofrecen el mismo motor relacional, pero con las ventajas del cloud: elasticidad, alta disponibilidad automática y actualizaciones gestionadas. Azure SQL Database brilla para cargas modernas, escalables y distribuidas, mientras que Managed Instance resulta un salvavidas para migraciones lift-and-shift desde entornos on-premises, evitando reescribir medio catálogo de procedimientos almacenados.

Pero no todo es perfecto. La nube te da elasticidad, sí, pero también facturas que crecen más rápido que una tabla de log que no mantienes. Y ciertas configuraciones avanzadas siguen teniendo limitaciones frente al on-premises clásico. Aun así, en la pelea contra RDS for SQL Server, Cloud SQL o Aurora, Azure SQL compite muy decentemente, sobre todo cuando se integra con el resto del ecosistema Microsoft.

Competencia y convivencia: ahora con Oracle en la foto

Intencionadamente no había hablado de Oracle en este artículo aun. Esto es porque merecía su apartado dedicado. Ignorar a Oracle sería como hablar de fútbol sin mencionar a Messi o Cristiano. Oracle sigue siendo el otro gran titán del mundo relacional empresarial. Su estrategia ha ido en dos direcciones claras: reforzar su motor transaccional con mejoras de rendimiento y disponibilidad (la famosa RAC sigue siendo un argumento fuerte) y empujar con fuerza su base de datos autónoma en la nube, que promete optimización automática, parches sin downtime y escalabilidad elástica. En papel suena a ciencia ficción; en la realidad, sigue siendo un producto potente, aunque con el mismo talón de Aquiles que siempre: licenciamiento complejo y costes elevados.

Oracle mantiene una cuota sólida en sectores donde el riesgo no se negocia, como banca o telecomunicaciones, pero su imagen de “producto premium” lo aleja de entornos más ágiles o con presupuestos ajustados. En ese hueco es donde SQL Server ha sabido jugar sus cartas: más versátil en despliegues, más sencillo de administrar y con una curva de entrada menos intimidante.

La mayoría de grandes organizaciones que usan Oracle no prescinden de SQL Server; al contrario, los combinan. Oracle se queda con lo que justifica su precio (OLTP ultra crítico, escenarios de HA extrema) y SQL Server cubre aplicaciones empresariales, integraciones y cargas mixtas donde la flexibilidad pesa más que la pureza del rendimiento.

Oracle en entornos analíticos

En el frente analítico, Oracle ha optado por un enfoque doble. Por un lado, ha ido incorporando capacidades analíticas directamente en su motor transaccional, con funciones in-database, modelos estadísticos y procesamiento in-memory columnar para ejecutar cargas masivas sin mover los datos. Por otro, ha desarrollado Oracle Autonomous Data Warehouse, su servicio cloud gestionado para analítica, con escalabilidad automática y optimización asistida, pensado para competir con Snowflake o BigQuery. La diferencia es que Oracle sigue apostando por la especialización y la potencia de su propio ecosistema, mientras que Microsoft, con Fabric, ha preferido unificar integración, ingeniería y consumo en un solo marco. Solo el tiempo nos dirá quien ha optado por la solución correcta.

¿Un viraje o una extensión natural?

Visto lo que hay, los puristas dirán que SQL Server se está “contaminando” con funciones que no le corresponden. Los pragmáticos vemos otra cosa: un intento lógico de mantenerse en un mercado donde ya no basta con ser bueno en lo tuyo, sino que hay que ser útil en lo que otros necesitan. Si el científico de datos puede trabajar sobre el mismo entorno donde el ERP graba transacciones, se ahorran latencias, ETLs y errores humanos. Y si encima puedes exponer los resultados a Power BI o Fabric sin montar un festival de integraciones, más puntos a favor.

Esto no significa que SQL Server vaya a sustituir a Snowflake o a un motor columnar puro en un data warehouse masivo. Significa que cada vez será más común ver entornos mixtos, donde el dato crudo se procese en un sistema especializado y SQL Server actúe como nodo central para servir datos curados, combinados y gobernados.

El veredicto: no, no está muerto

Si algo nos enseña la historia de la tecnología es que las modas pasan y las bases sólidas permanecen. El hype del NoSQL, los lagos de datos milagrosos o las bases “autónomas” con inteligencia artificial han tenido su momento, y en muchos casos han acabado como piezas útiles pero de uso específico. Las bases de datos relacionales llevan medio siglo alimentando aplicaciones críticas y, lejos de extinguirse, siguen adaptándose.

SQL Server no se está apagando, se está transformando. Lo que vemos en 2025 es un motor más abierto, más conectado y con capacidades que hace diez años habrían hecho reír a cualquier DBA clásico. Pero, sobre todo, sigue siendo un motor transaccional de referencia, capaz de mover operaciones críticas día tras día sin pestañear. No será el mejor en todo, pero tampoco es malo en nada, y esa consistencia es la que mantiene viva su posición.

Y además tiene su versión en la nube bien armada, con Azure SQL plantando cara a las alternativas cloud sin complejos. El futuro del producto no es blanco o negro; es híbrido. Y, por ahora, SQL Server sigue siendo muy bueno en eso.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios
SSRS dice adiós: PBIRS toma el relevo en SQL Server 2025

SSRS dice adiós: PBIRS toma el relevo en SQL Server 2025

La semana pasada, en el SQL Bits, Bob Ward nos daba la noticia con la sonrisa de quien cree que ha tenido una gran idea y espera que todos aplaudamos: a partir de SQL Server 2025, SSRS se queda sin futuro. No habrá nuevas versiones, ni promesas de mejoras, ni siquiera ese Service Pack que llegaba tarde y mal. En su lugar, Microsoft ha decidido que todo lo relacionado con reporting on-premises se haga con Power BI Report Server. PBIRS entra en todas las ediciones de pago de SQL Server y SSRS, después de dos décadas de leales servicios, se queda en mantenimiento hasta 2033. Merece la pena parar un momento, repasar esta historia y ver por qué este cambio tiene sentido, aunque duela.

El ascenso y estancamiento de SSRS

SSRS lleva en nuestras vidas desde antes que alguno de vosotros. Concretamente desde 2004, cuando se presentó como una extensión gratuita para SQL Server 2000. Su propuesta era clara: permitir la creación de informes paginados usando RDL (Report Definition Language), con control pixel-perfect y exportaciones a Excel que acababan en los escritorios de medio planeta. Fue una revolución en su momento, sustituyendo soluciones propietarias más caras y difíciles de mantener (Crystal Reports, te estamos mirando a ti). A partir de SQL Server 2005, SSRS ya venía integrado, y poco a poco se convirtió en la herramienta por defecto para reporting operativo en entornos on-prem. Muchos aún lo siguen usando a diario: por robusto, por fiable y porque funciona.

Pero también es cierto que lleva años estancado. Las mejoras en las últimas versiones han sido mínimas, casi anecdóticas. La interfaz de desarrollo, ya sea en Visual Studio o en Report Builder, parece sacada de una cápsula del tiempo. Y mientras tanto, Power BI ha crecido, se ha convertido en la niña mimada del equipo de producto y ha absorbido toda la inversión. No había que ser visionario para intuir que a SSRS le quedaban pocos cartuchos.

PBIRS entra en escena con todo el respaldo

PBIRS, por su parte, se presentó como una solución híbrida. Construido sobre la base de SSRS permite ejecutar tanto informes paginados como informes interactivos en formato PBIX, lo cual lo convierte en un candidato ideal para ser ese puente entre lo tradicional y lo moderno. Además, añade características importantes como el soporte de seguridad a nivel de fila, visuales personalizados y actualizaciones con una frecuencia más propia de los productos cloud que del viejo stack on-prem. 

Hasta ahora, PBIRS era un extra al que solo podían acceder los clientes de SQL con licencia Enterprise y Software Assurance o clientes de Fabric con licencias F64 o superior, lo que limitaba mucho su adopción. Por suerte, esos tiempos oscuros se van a acabar: a partir de SQL Server 2025, cualquier edición de pago de SQL incluye derecho a instalar PBIRS, usando la misma clave del servidor. Más fácil, más directo, más lógico, como era con SSRS.

La lógica detrás del cambio de SSRS a PBIRS

La justificación oficial es que SSRS no es más que un subconjunto de lo que ofrece PBIRS. Y es cierto: todo lo que hacía SSRS, lo hace PBIRS. Pero también hace más cosas. Si estás en un entorno donde ya conviven informes RDL con Power BI, la unificación es natural. Si vienes solo de SSRS, puede que el salto te parezca innecesario, pero la dirección está clara. Microsoft quiere que el reporting on-prem hable el lenguaje de Power BI, aunque aún no estemos listos para irnos a la nube.

Lo que ganamos con PBIRS (y lo que perdemos)

Ahora bien, no todo es ganancia. En la transición se pierden cosas. Algunas funcionalidades específicas, como los informes vinculados, no tienen una traducción directa en PBIRS. Las integraciones con sistemas antiguos o personalizados, especialmente aquellas que dependían de extensiones específicas o APIs internas de SSRS, pueden requerir adaptación. Y aunque la migración de RDLs está soportada y bien documentada, eso no significa que sea trivial. Hay que revisar fuentes de datos, suscripciones, permisos, configuraciones de caché y otras complicaciones que todos sabemos que pueden existir en informes que tienen más de 20 años y duermen tranquilas hasta que una migración las despierta.

Migrar a PBIRS: lo bueno, lo malo y lo inevitable

El proceso de migración, en sí mismo, está bastante claro. Microsoft ha publicado guías detalladas y herramientas para mover informes y catálogos desde SSRS a PBIRS. Incluso puedes probar PBIRS en modo Developer o Evaluation antes de tomar decisiones definitivas. Pero, como siempre, todo depende del grado de personalización de tu entorno y de cuánto te hayas alejado del camino en los últimos diez años. Porque sí, todos decimos que usamos SSRS “como viene”, pero luego llegan los informes con código embebido, las fuentes de datos compartidas con autenticación personalizada y ese servidor que nadie quiere tocar porque “funciona y no se ha caído en años”.

Soporte hasta 2033: más calma que consuelo

Lo curioso es que la noticia, pese a ser una especie de epitafio para SSRS, viene acompañada de la típica promesa tranquilizadora: SSRS 2022 seguirá recibiendo actualizaciones de seguridad (en soporte extendido) hasta enero de 2033. Eso quiere decir que puedes seguir usándolo si no quieres o no puedes migrar todavía. Puedes incluso seguir instalando SSRS 2022 con versiones más nuevas del motor de SQL Server, aunque no recibirás nuevas funcionalidades. Básicamente, queda en modo mantenimiento. Como cuando apagas el monitor pero dejas el servidor encendido: sigue ahí, pero ya no espera nada de la vida.

SSRS y PBIRS: Una consolidación inevitable

Hay que reconocer que este cambio tiene sentido. No es una jugada improvisada. Es parte del movimiento más amplio hacia Fabric, hacia unificar las herramientas de BI bajo el paraguas de Power BI, y hacia simplificar el stack on-prem. En lugar de mantener dos productos con solapamientos, Microsoft apuesta por uno solo, más potente, más alineado con su estrategia cloud y más fácil de justificar a nivel de roadmap. Tiembla SSIS.

Aun así, para quienes hemos vivido el mundo SSRS puro y duro, este cambio tiene algo de nostalgia. Nos ha acompañado en muchas guerras, nos ha dado informes que imprimen correctamente en la primera pasada, nos ha dejado programar suscripciones y controlar exportaciones como si estuviésemos montando una fábrica de PDFs. Pero el futuro no es eso. El futuro tiene interactividad, exploración de datos, visuales dinámicos y conectividad con servicios cloud. Y todo eso, por mucho que nos pese, no lo va a ofrecer nunca SSRS.

Conclusión

Así que, no lo veamos como una pérdida. Veámoslo como lo que es: una consolidación que estaba cantada. PBIRS hereda todo lo bueno de SSRS y añade lo que le faltaba. Que el proceso de migración tenga sus complejidades no debería sorprendernos. Es parte del juego (y a los consultores y técnicos nos dará dinerito). Lo importante es que ahora tenemos un camino claro, una herramienta mejor y tiempo suficiente para adaptarnos. Porque sí, SSRS fue grande. Pero PBIRS es el que se queda. Y conviene conocerlo bien, porque es lo que nos espera en los próximos años.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, SQL Server, 0 comentarios

¿Por qué usar SSAS o Azure Analysis Services (AAS) en 2025?

Estamos viviendo la época dorada de los datos, la toma de decisiones basada en datos se ha convertido en un pilar fundamental para las organizaciones que buscan competitividad y eficiencia, por no hablar de la inteligencia artificial y el machine learning no serían nada sin datos. Esto ha llevado a una necesidad cada vez más creciente de datos, pero no datos de cualquier manera, la necesidad de herramientas que permitan el modelado y análisis avanzados es más crítica que nunca. En este sentido, SQL Server Analysis Services (SSAS) y Azure Analysis Services (AAS) continúan siendo soluciones clave para transformar datos en información estratégica.

En este artículo, quiero intentar responder a la pregunta ¿por qué SSAS y AAS siguen siendo relevantes en 2025? Para ello vamos a hablar de sus beneficios, y cuándo optar por una solución on-premises o en la nube.

La evolución del análisis de datos y la relevancia de SSAS/AAS

Con el crecimiento de plataformas de datos como Microsoft Fabric, Power BI y Synapse Analytics, es normal preguntarse si SSAS o AAS siguen siendo relevantes. La respuesta corta es sí, y la larga es que su uso ha evolucionado para adaptarse a nuevos escenarios.

SSAS y AAS siguen siendo las mejores soluciones para modelos de datos semánticos con alta reutilización y complejidad. Los modelos analíticos requieren rendimiento, escalabilidad, seguridad y gobernanza de primer nivel, y estas tecnologías lo ofrecen mejor que muchas alternativas.

Tendencias que refuerzan la importancia de SSAS y AAS:

La demanda de análisis de datos en tiempo real ha crecido significativamente, impulsando el uso de modelos híbridos que combinan almacenamiento en memoria con consultas en vivo a bases de datos. Al mismo tiempo, la necesidad de modelos escalables que puedan soportar miles de usuarios simultáneamente hace que soluciones como SSAS y AAS sean fundamentales para empresas de gran tamaño. Además, estas herramientas siguen desempeñando un papel clave en la integración con otras plataformas de Microsoft como Power BI, SQL Server, Synapse Analytics y Azure Data Lake, lo que refuerza su importancia en arquitecturas modernas de inteligencia empresarial.

Beneficios de SSAS y AAS

Uno de los principales motivos por los que SSAS y AAS siguen siendo relevantes es su capacidad para ofrecer un rendimiento excepcional en el análisis de datos. Gracias a la tecnología VertiPaq, los modelos tabulares permiten consultas rápidas mediante compresión y almacenamiento en memoria. Esto es crucial en un contexto donde los usuarios esperan tiempos de respuesta inmediatos en sus informes y dashboards.

Otro aspecto fundamental es la capacidad de manejar grandes volúmenes de información de manera eficiente. Los modelos en SSAS y AAS pueden procesar billones de filas sin comprometer el rendimiento, algo que sigue siendo una ventaja en comparación con otras soluciones. Aunque Power BI Premium y Fabric han mejorado en este aspecto, SSAS y AAS continúan siendo superiores para centralizar y administrar modelos de datos complejos que requieren alto rendimiento y reutilización en múltiples reportes.

La seguridad es otro factor determinante. Este 2025, la protección de datos debería ser una prioridad para todas las organizaciones. Tanto SSAS como AAS permiten la implementación de mecanismos avanzados de seguridad, como Row-Level Security (RLS) y Object-Level Security (OLS), lo que garantiza que cada usuario acceda únicamente a la información que le corresponde. Esta capacidad es especialmente valiosa en entornos empresariales donde la confidencialidad de los datos es crítica.

Por último, la integración con otras herramientas sigue siendo una de sus grandes ventajas. SSAS y AAS se conectan de manera nativa con Power BI, SQL Server, Azure Synapse Analytics y Data Factory, facilitando la creación de soluciones analíticas robustas y escalables. La posibilidad de definir modelos semánticos reutilizables permite a las empresas garantizar la consistencia de los datos en toda la organización, evitando la duplicación de esfuerzos y asegurando que todos los usuarios trabajen con la misma información consolidada.

¿SSAS o AAS? ¿On-premises o en la nube?

La elección entre SSAS (on-premises) y AAS (Azure) depende del contexto de cada empresa. Los factores clave siguen siendo coste, escalabilidad, mantenimiento y requisitos de seguridad.

¿Cuándo elegir SSAS?

Es cierto que la nube se está imponiendo como solución pero aún quedan casos donde puede ser recomendable una solución local como SSAS. Si la empresa sigue operando mayormente on-premises y no ha migrado a la nube o si tenemos licenciamiento de SQL Server con SSAS ya incluido SSAS puede ser mejor solución que AAS. Además, con esta solución tendremos el máximo control sobre la infraestructura y cumpliremos con los requisitos de esos escenarios con estrictos requisitos de seguridad que impiden almacenar datos en la nube ya sea por legislación o políticas de empresa. En este último caso podremos combinar SSAS con PBIRS todo el local.

¿Cuándo elegir AAS?

Por el contrario, si la empresa ya usa Azure y otros servicios en la nube o si necesitamos escalabilidad dinámica sin administrar servidores AAS es una solución que puede reducir costes en mantenimiento y licencias on-premises. Si usamos Power BI o Fabric en la nube también podremos aprovechar la integración nativa con AAS.

¿Y Microsoft Fabric? ¿Sustituye a AAS?

Microsoft Fabric ha introducido un nuevo paradigma con Power BI Semantic Models, que combina capacidades de SSAS/AAS con Power BI Premium. Sin embargo, AAS sigue siendo la mejor opción en entornos donde se requiere máxima flexibilidad y control sobre modelos semánticos.

Conclusión

A pesar de la evolución de las plataformas de datos en la nube, SSAS y AAS siguen siendo fundamentales en arquitecturas de BI modernas. Su capacidad para ofrecer modelos de datos centralizados, rendimiento óptimo y seguridad avanzada los mantiene como una opción relevante para empresas que buscan eficiencia en el análisis de datos.

Si la empresa opera on-premises, SSAS sigue siendo una opción válida. Por el contrario, si la estrategia es cloud-first, AAS ofrece flexibilidad y escalabilidad sin preocuparse por infraestructura. Si se usa Power BI, Microsoft Fabric puede ser una alternativa para simplificar la arquitectura, aunque AAS sigue siendo preferible en entornos empresariales grandes.

En resumen, SSAS y AAS continúan siendo pilares del análisis de datos en 2025, y su relevancia dependerá del contexto y la estrategia de cada organización. La clave está en aprovechar su potencia para construir soluciones analíticas de alto rendimiento, integradas con las últimas tecnologías de Microsoft.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Power BI, 0 comentarios

SQL Server Analysis Services (SSAS)

SQL Server Analysis Services (SSAS) es una de las tecnologías más robustas y flexibles para el análisis de datos en el ecosistema Microsoft. Desde su introducción en 1998 como OLAP Services (parte de SQL Server 7), ha evolucionado hasta convertirse en un pilar fundamental para la inteligencia empresarial (BI), proporcionando capacidades avanzadas para el modelado y la explotación de datos. En este artículo, os quiero introducir SSAS como herramienta, sus modelos, arquitectura y buenas prácticas para su implementación.

Introducción a SSAS

SSAS es una solución de Microsoft para la creación de modelos analíticos que permiten consultas optimizadas sobre grandes volúmenes de datos. Se integra con el ecosistema de SQL Server y herramientas como Power BI, Excel y otros clientes de BI. Su propósito es ofrecer un rendimiento excepcional en la consulta de datos y permitir cálculos complejos con una estructura optimizada.

Existen dos modos principales en los que SSAS puede operar el multidimensional y el tabular.

Modelos de SSAS: Multidimensional vs. Tabular

La elección entre los modelos multidimensional y tabular depende de diversos factores como el volumen de datos, la complejidad del análisis y la facilidad de uso.

Modelo Multidimensional (OLAP)

El clásico modelo analítico utiliza cubos y dimensiones para organizar la información de manera jerárquica. Se basa en la idea de organizar los datos en cubos OLAP (Online Analytical Processing), donde cada cubo representa un conjunto de datos preprocesados y optimizados para consultas analíticas rápidas. Estos cubos contienen medidas numéricas (como ventas o ingresos) y dimensiones (como tiempo, ubicación o producto), que permiten a los usuarios explorar la información desde múltiples perspectivas. Estos cubos pueden almacenarse como MOLAP (Multidimensional OLAP), ROLAP (Relational OLAP) o HOLAP (Hybrid OLAP). Gracias a esta arquitectura, las consultas se ejecutan con una latencia mínima, permitiendo análisis complejos como agregaciones, drill-downs y cálculos avanzados sin afectar el rendimiento de la base de datos transaccional. Por cierto, estas consultas son expresiones MDX (Multidimensional Expressions), que es el lenguaje de consulta optimizado para OLAP. 

Como ventajas del Modelo Multidimensional podemos destacar su alto rendimiento en consultas agregadas preprocesadas y el soporte avanzado para modelado complejo de datos lo que lo hacen ideal para escenarios con jerarquías bien definidas.

Como desventajas del Modelo Multidimensional tenemos una curva de aprendizaje elevada debido a la necesidad de conocer MDX y una mayor complejidad en la administración y diseño de modelos que con otras alternativas.

Modelo Tabular (In-Memory)

Un modelo tabular en SQL Server Analysis Services (SSAS) es un enfoque más moderno para el análisis de datos que utiliza una arquitectura en memoria basada en el motor VertiPaq (si, igual que Power BI), optimizado para consultas de alto rendimiento. A diferencia del modelo multidimensional, el modelo tabular almacena los datos en formato columnar en lugar de estructuras de cubo preprocesadas, lo que permite una mayor comprensión y rapidez en las consultas. Se basa en tablas y relaciones, similar a un modelo relacional, y emplea el lenguaje DAX (Data Analysis Expressions) para la creación de cálculos y medidas. Su flexibilidad y facilidad de desarrollo lo han convertido en una alternativa popular al modelo multidimensional, ya que permite una integración más sencilla con herramientas de BI como Power BI y Excel, facilitando el análisis de datos sin la complejidad de los cubos OLAP tradicionales.

Como ventajas del Modelo Tabular destacaría su mayor facilidad de desarrollo en comparación con el modelo multidimensional (DAX es más sencillo que MDX), sus excelentes tiempos de respuesta debido a su estructura en memoria y su mejor integración con herramientas modernas como Power BI.

Por el contrario, las desventajas principales del Modelo Tabular son el consumo de memoria más elevado en modelos de gran tamaño y las limitaciones en la gestión de relaciones complejas en comparación con OLAP.

Arquitectura de SSAS

SSAS opera bajo una arquitectura de servidor que permite múltiples conexiones concurrentes de usuarios y herramientas de BI. La arquitectura básica que tenemos que tener clara antes de empezar incluye la o las fuentes de datos, es decir el origen de los datos (que puede ser de SQL Server, Azure SQL Database, Oracle, Teradata, entre otros) y el modelo de datos. Obviamente estos datos se van a introducir en un modelo de datos de SSAS mediante un cubo OLAP o un modelo tabular (en estrella a poder ser 🙂).

Una vez con esto definido llega la parte del modelado. En SSAS la información se procesa y se almacena en SSAS en formatos optimizados. En este punto igual hay que hacer algunas consultas a través de MDX (para OLAP) o DAX (para modelos tabulares) para terminar de pulir detalles antes de conectar nuestros clientes BI que serán herramientas como Power BI, Excel, Reporting Services y aplicaciones personalizadas consumen los modelos de SSAS.

Prácticas recomendadas en la implementación de SSAS

Al diseñar una solución con SSAS, es importante seguir ciertas recomendaciones para garantizar rendimiento y escalabilidad. Tenemos que tener en cuenta que estas aplicaciones analíticas van a almacenar y operar con gran cantidad de datos y por tanto definir un buen modelo de datos es fundamental. Tendremos que prestar especial atención para evitar redundancias y asegurar integridad referencial. En modelos tabulares, minimizar el uso de columnas de texto para optimizar la compresión.

A la hora de optimizar el rendimiento en OLAP utilizaremos agregaciones para reducir el tiempo de consulta mientras que en modelos tabulares, buscaremos reducir la cardinalidad de las columnas para mejorar la compresión. También podemos implementar particionamiento en modelos grandes para mejorar el procesamiento.

En cuanto a seguridad, podremos configurar roles y permisos en SSAS para restringir el acceso a datos sensibles. Si queremos ir más allá tenemos también Row-Level Security en modelos tabulares para aplicar filtros por usuario.

Y para cerrar este apartado, como no podía ser de otra manera, tenemos que hablar de la monitorización del uso de memoria y CPU sobre todo en entornos productivos.

SSAS en la Nube: Azure Analysis Services

Como ha pasado con otros servicios, Microsoft también ha llevado SSAS a la nube de Azure con Azure Analysis Services (AAS), ofreciendo las mismas capacidades de modelado de datos pero con las ventajas adicionales propias de Azure. Estas son la escalabilidad dinámica según la demanda de consultas, la integración con servicios de Azure como Azure SQL Database y Azure Synapse Analytics y el modelo de pago por uso sin necesidad de administrar infraestructura.

Para organizaciones que buscan reducir costes de mantenimiento y beneficiarse de la flexibilidad de la nube, Azure Analysis Services es una excelente opción.

Conclusión

SSAS sigue siendo una herramienta clave para arquitecturas de BI en empresas de todos los tamaños. Su capacidad para manejar grandes volúmenes de datos y realizar análisis avanzados lo convierte en una opción robusta tanto en entornos on-premises como en la nube. La elección entre modelo tabular o multidimensional dependerá de los requisitos del negocio y la facilidad de integración con otras herramientas.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Power BI, 1 comentario

¿Cuándo y por qué usar un servidor SSAS intermedio entre SQL Server y Power BI?

Una de las decisiones clave a la hora de diseñar arquitecturas BI robustas es determinar cómo gestionar y procesar de manera eficiente la ingente cantidad datos que vamos a manejar. Aquí es donde la pregunta de si incluir un servidor SQL Server Analysis Services (SSAS) como capa intermedia entre SQL Server y Power BI cobra especial relevancia, sobre todo cuando buscamos soluciones escalables, de alto rendimiento y con un control centralizado. Aunque Power BI, al igual que SSAS, utiliza el motor VertiPaq, los objetivos y capacidades de cada herramienta pueden llegar a justificar el coste extra (recursos y tiempo) de la integración de SSAS en no pocas situaciones.

A lo largo de este artículo trataré de explicar los casos en los que SSAS aporta valor añadido a las arquitecturas BI y analizaremos su utilidad tanto en combinación con Power BI como, en escenarios mucho más específicos como Power BI Report Server (PBIRS). Además, abordaremos cómo estas soluciones contribuyen a la consistencia de los datos, el rendimiento de las consultas y la gobernanza empresarial.

¿Qué es SQL Server Analysis Services (SSAS)?

Empecemos por el principio, ¿qué es SSAS? SQL Server Analysis Services (SSAS) es un componente de Microsoft SQL Server diseñado para proporcionar capacidades analíticas avanzadas mediante la creación de modelos de datos optimizados. SSAS es esencialmente un motor analítico que permite construir modelos tabulares o multidimensionales que los usuarios pueden consultar para obtener insights clave de negocio.

Existen dos variantes principales de SSAS: modelos tabulares y modelos multidimensionales. Aunque ambos ofrecen capacidades de análisis, aunque, los modelos tabulares, introducidos en 2012, se han impuesto como la opción preferida por la mayoría de las organizaciones debido a su simplicidad y rendimiento. Los modelos tabulares utilizan el motor VertiPaq, que permite almacenar datos en memoria de forma comprimida y procesarlos rápidamente. Esto lo hace ideal para escenarios que requieren análisis en tiempo real o procesamiento rápido de grandes volúmenes de datos.

Además de ser un motor analítico, SSAS actúa como un servidor centralizado donde los modelos de datos pueden ser compartidos y consumidos por múltiples herramientas, como Power BI, Excel o cualquier cliente que soporte DAX o MDX. Esta capacidad de centralizar la lógica analítica y permitir el acceso desde diferentes aplicaciones lo convierte en una pieza clave en la gobernanza de datos empresariales.

En términos de seguridad, SSAS permite implementar configuraciones avanzadas como Row-Level Security (RLS), que garantiza que los usuarios solo accedan a la información que les corresponde según sus roles. Esto, junto con su capacidad para manejar grandes volúmenes de datos y consultas complejas, posiciona a SSAS como una solución ideal para arquitecturas de BI empresariales.

SSAS y Power BI: una combinación estratégica para el análisis de datos

Ya hemos visto que el motor VertiPaq es núcleo de las capacidades de análisis en memoria tanto de Power BI como de SSAS Tabular. Este motor está diseñado para gestionar grandes volúmenes de datos y optimizar consultas analíticas complejas. Aunque tanto SSAS como PowerBI comparten esta tecnología, las diferencias entre Power BI y SSAS Tabular son notables. Mientras que Power BI está orientado a usuarios finales que necesitan autonomía en la creación de modelos y reportes, SSAS está diseñado para ser un motor analítico centralizado, ideal para entornos empresariales con necesidades avanzadas de escalabilidad, rendimiento y control.

Esta diferencia de enfoques posiciona a SSAS como un intermediario estratégico en arquitecturas BI. Al encargarse del procesamiento analítico, SSAS permite que Power BI se concentre en la visualización e interacción con los datos, podríamos decir que lo libera de la carga computacional asociada a cálculos pesados y transformaciones complejas.

Beneficios de incluir SSAS en la arquitectura BI

Lo sé, aún no te he dicho que ventajas tiene montar SSAS. Pues bien, cuando integras SSAS, el impacto en términos de rendimiento, centralización y escalabilidad es significativo. Su capacidad para manejar grandes volúmenes de datos, centralizar la lógica analítica y gestionar la seguridad de forma avanzada lo convierte en una solución potente para escenarios empresariales complejos.

Uno de los principales beneficios de SSAS es su capacidad para optimizar consultas analíticas a través del motor VertiPaq, que procesa los datos en memoria de manera comprimida. Esto se traduce en tiempos de respuesta significativamente más rápidos en consultas que involucran relaciones complejas, medidas calculadas o grandes cantidades de datos. Este enfoque mejora la experiencia del usuario final y alivia la carga sobre el servidor SQL subyacente frente a por ejemplo unas consultas direct query pero tampoco es ninguna ventaja frente a un Power BI en modo import, en el fondo es lo mismo.

Entonces, lo que sí es una ventaja de SSAS es que permite centralizar los modelos analíticos, asegurando que todas las herramientas y usuarios consuman el mismo conjunto de datos y cálculos. Esta centralización elimina inconsistencias entre departamentos y garantiza que los análisis se basen en las mismas definiciones métricas, lo que es esencial en entornos empresariales con múltiples equipos trabajando en paralelo. Con esta configuración, Power BI actúa como un consumidor de estos modelos, lo que simplifica la gobernanza de los datos y la gestión de los cambios.

Otro aspecto clave es la seguridad. SSAS ofrece un control robusto a través de la seguridad a nivel de fila (Row-Level Security, RLS), que permite definir permisos detallados para los datos. Esto asegura que cada usuario solo tenga acceso a los datos relevantes para su función, garantizando el cumplimiento de las políticas de privacidad y seguridad de la organización.

Casos prácticos de uso de SSAS con Power BI

La integración de SSAS con Power BI se justifica especialmente en entornos donde se manejan grandes volúmenes de datos, múltiples usuarios concurrentes o modelos analíticos complejos. En estos escenarios, SSAS actúa como un motor analítico dedicado que libera a Power BI de la carga computacional, permitiendo que esta última herramienta se concentre en la presentación de los datos.

Por ejemplo, en organizaciones donde los reportes son consultados por decenas o cientos de usuarios simultáneamente, SSAS distribuye eficientemente el procesamiento de las consultas. Esto no solo mejora los tiempos de respuesta, sino que también evita la saturación del servidor SQL transaccional, que puede centrarse en otras tareas críticas del negocio.

Asimismo, en escenarios donde los modelos de datos contienen cálculos avanzados, relaciones de muchos a muchos (no hagáis eso) o jerarquías complejas, SSAS es la herramienta ideal. Su capacidad para procesar y almacenar en memoria estos modelos garantiza que las consultas sean rápidas y precisas, incluso cuando los volúmenes de datos son masivos.

La utilidad de SSAS con Power BI Report Server (PBIRS)

Hay otro caso especial donde SSAS cobra especial relevancia y es en esas organizaciones que necesitan soluciones on-premises. En estos escenarios, SSAS se convierte en un complemento esencial para Power BI Report Server (PBIRS). PBIRS está diseñado para gestionar y publicar reportes de forma local, pero no permite que varios informes accedan al mismo modelo por lo que un SSAS común como fuente de datos se hace imprescindible.

Además, cuando SSAS se combina con PBIRS, se crea una arquitectura en la que el procesamiento analítico es gestionado por SSAS, mientras que PBIRS se encarga de la presentación y administración de los reportes. Esto asegura tiempos de respuesta rápidos incluso en escenarios con alta concurrencia, ya que las consultas complejas se resuelven en el servidor SSAS antes de ser entregadas al usuario.

Por último, el uso de SSAS con PBIRS permite aprovechar sus capacidades de seguridad centralizada. Los permisos configurados en el modelo de SSAS se aplican automáticamente a los reportes alojados en PBIRS, simplificando la administración de la seguridad y asegurando que los datos sensibles estén protegidos.

Azure Analysis Services: la evolución hacia la nube

Y ahora que hemos hablado de entornos 100% on-premises no podemos no hablar de los 100% cloud. Esos entornos donde la escalabilidad y flexibilidad son prioritaria. Para estos casos Microsoft tiene una herramienta llamada Azure Analysis Services (AAS) y no es más que una evolución natural de SSAS a la nube de Azure. AAS ofrece las mismas capacidades avanzadas que SSAS Tabular, pero con las ventajas de estar alojado en la infraestructura de Azure. Esto permite a las organizaciones implementar modelos analíticos centralizados sin preocuparse por la gestión del hardware o el mantenimiento de los servidores.

Azure Analysis Services resulta especialmente útil en arquitecturas híbridas, donde los datos se encuentran tanto en la nube como on-premises. Su integración con servicios cloud como Azure Synapse Analytics además de con servicios locales como SQL Server, facilita la construcción de soluciones escalables que pueden crecer dinámicamente según las necesidades del negocio. Además, AAS hereda la seguridad y gobernanza avanzadas de SSAS, lo que garantiza que las organizaciones puedan mantener el control sobre sus datos mientras aprovechan la elasticidad de la nube.

La elección entre SSAS on-premises y AAS dependerá de los requisitos específicos de cada organización. Sin embargo, AAS ofrece una opción atractiva para aquellas que buscan combinar la potencia analítica de SSAS con la flexibilidad y capacidad de expansión de Azure.

Conclusión

El uso de un servidor SSAS como capa intermedia entre SQL Server y Power BI aporta múltiples beneficios en términos de rendimiento, escalabilidad y gobernanza. Su capacidad para procesar grandes volúmenes de datos, centralizar modelos analíticos y gestionar la seguridad lo convierte en una pieza clave en arquitecturas empresariales complejas. Aunque Power BI puede manejar muchos casos de forma autónoma, la inclusión de SSAS garantiza un nivel de eficiencia y control que es difícil de igualar.

Cuando se utiliza con Power BI Report Server (PBIRS), SSAS se convierte en un motor analítico esencial, capaz de manejar consultas complejas y soportar escenarios de alta concurrencia en entornos on-premises. Esto asegura una solución integral para organizaciones que buscan combinar el poder del análisis en memoria con la flexibilidad y seguridad de un entorno local.

En definitiva, la combinación de SSAS, Power BI y PBIRS representa una solución robusta para cualquier organización que busque maximizar el valor de sus datos. 

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, 0 comentarios