Teoría BBDD

SQL Server recovery tras un reinicio: Analysis, Redo y Undo al detalle

Cuando SQL Server arranca después de una caída, arranca una fase de recuperación o recovery. Pero no es que se ponga a “comprobar tablas” como quien revisa una hoja de Excel después de un apagón. Tampoco compara alegremente el MDF con el LDF buscando diferencias a ojo. Lo que hace es mucho más serio, ejecuta un proceso de recuperación basado en el transaction log, en los LSN y en unas reglas bastante estrictas que permiten devolver cada base de datos a un estado transaccionalmente consistente.

Aquí, la explicación habitual de las tres fases (Analysis, Redo y Undo) sirve para una introducción, pero si nos quedamos ahí, estamos mirando solo la superficie e ignorando lo interesante. Y, como suele pasar en SQL Server, lo interesante vive en el barro: páginas, log records, checkpoints, cadenas de transacciones, dirty pages, pageLSN, Compensation Log Records y decisiones internas que explican por qué una base puede tardar segundos en recuperarse o dejarte mirando el error log sin poder hacer nada mientras sientes la presión de tener al jefe mirándote a ti (a todos nos ha pasado).

Antes de entender el recovery hay que entender una verdad incómoda, SQL Server puede tener datos confirmados que aún no están en los data files, y puede tener datos no confirmados que ya están en los data files. Si esta frase te asusta, mejor sigue leyendo.

El modelo real: steal/no-force y por qué necesitamos Redo y Undo

SQL Server usa un modelo de escritura que, simplificando mucho pero sin deformarlo, se puede describir como steal/no-force.

No-force significa que cuando una transacción hace COMMIT, SQL Server no está obligado a escribir inmediatamente en el MDF o NDF todas las páginas de datos modificadas por esa transacción. Lo que debe quedar persistido es el log necesario para garantizar la durabilidad. La página de datos puede seguir en memoria como dirty page y escribirse más tarde, cuando el checkpoint, el lazy writer u otro mecanismo decida que toca sacarla del buffer pool.

Esto, que tanto optimiza el rendimiento, explica también por qué existe el Redo. Si una transacción hizo commit, su log record de commit llegó a disco, pero las páginas modificadas no se habían vaciado todavía al data file, después de una caída SQL Server debe rehacer esos cambios. No porque le apetezca repetir trabajo, sino porque el log promete que esa transacción sobrevivió.

Steal significa que SQL Server puede escribir a disco una página modificada por una transacción que aún no ha hecho commit. Esto ocurre en casos de presión de memoria porque el buffer pool no es infinito. Si una página sucia necesita salir de memoria, puede escribirse al data file siempre que se cumpla la regla de Write-Ahead Logging.

Esto explica por qué existe el Undo. Si una transacción estaba abierta cuando el servidor cayó, algunas de sus modificaciones podrían estar ya en los data files. Como esa transacción no se confirmó, esos cambios deben desaparecer durante la recuperación.

Aquí está la clave que muchos resúmenes no cuentan: Redo existe por no-force; Undo existe por steal. Sin esas dos ideas, Analysis, Redo y Undo son solo tres palabras bonitas que memorizas para presumir en una entrevista técnica.

Write-Ahead Logging: el log manda, el data file obedece

La regla básica de Write-Ahead Logging es sencilla: antes de que una página de datos modificada pueda escribirse en disco, los log records que describen esos cambios deben haberse “endurecido” (persistido, escrito) en el transaction log. Primero el log, luego la página de datos. Siempre. El motor puede retrasar la escritura del data file, pero no puede escribir una página con cambios cuyo log correspondiente no haya llegado antes a disco.

Esto permite que el recovery sea posible. Si después de una caída SQL Server encuentra una página en disco que no tiene ciertos cambios, puede rehacerlos desde el log. Si encuentra una página en disco que sí tiene cambios de una transacción incompleta (no está el commit en el log), puede deshacerlos también usando el log. El LDF no es un fichero auxiliar sin importancia; es la fuente de verdad de la recuperación. El MDF contiene páginas. El LDF contiene la historia necesaria para saber qué hacer con ellas.

Log Sequence Number: Un identificado con mucho significado

Cada log record tiene un LSN (Log Sequence Number) que identifica una posición lógica dentro del transaction log. En herramientas internas o no documentadas podemos verlo en formato de tres partes, algo parecido a 0000002a:000001f0:0001. No hace falta enamorarse del formato, pero sí entender el concepto, los LSN ordenan la historia de la base de datos.

Las páginas de datos también guardan un LSN en su cabecera, conocido como pageLSN. Ese valor indica el último log record aplicado a esa página. Durante Redo, esta comparación es fundamental. Si el log record tiene un LSN mayor que el pageLSN, probablemente esa modificación no está en la página y debe aplicarse. Si el pageLSN ya es igual o superior, SQL Server puede saltarse ese redo para esa página.

Ese detalle es clave para la velocidad de recuperación. Redo no es “aplicar todo a lo bruto”. Redo es idempotente. Puede recorrer log records y decidir si una página necesita o no necesita esa operación. Esto evita aplicar dos veces el mismo cambio y convertir la recuperación en una trituradora de consistencia. SQL Server no repite una modificación porque sí, compara la historia del log con la historia que la página dice tener.

¿Qué hay realmente en el transaction log?

El transaction log no guarda simplemente “sentencias SQL”. No esperes encontrar un bonito UPDATE Clientes SET Saldo = Saldo – 100 WHERE Id = 7 esperando a que alguien lo vuelva a ejecutar. Sería mucho más sencillo de entender pero no, el log trabaja a un nivel mucho más físico y orientado al motor (por suerte).

Podemos encontrar registros de inicio de transacción, commit, abort, modificaciones de filas, cambios en páginas, asignaciones de extents, cambios en estructuras de índices, formateos de páginas, operaciones sobre metadatos y muchas otras entradas. Algunas son más físicas, otras más lógicas, y algunas dependen del tipo de operación. El motor registra lo que necesita para poder rehacer y deshacer de forma fiable que al final es el objetivo, no que nosotros lo entendamos de un vistazo.

Una transacción no aparece como un bloque bonito y compacto. Sus log records se enlazan mediante una cadena. Cada log record de una transacción conoce, de una forma u otra, cuál fue el log record anterior de esa misma transacción. Ese enlace permite recorrer hacia atrás la actividad de una transacción cuando toca hacer Undo.

Esto es importante porque Undo no recorre el log entero hacia atrás como quien rebobina una cinta VHS desde el final hasta el principio (si entendiste la referencia una pregunta, ¿tu también haces ruiditos al levantarte?). Undo trabaja sobre las transacciones perdedoras, las que estaban activas en el momento de la caída, y sigue sus cadenas de log records para deshacer lo que haya que deshacer.

Si alguna vez has mirado fn_dblog (esa función no documentada que todos decimos usar “solo en laboratorio”), habrás visto columnas como Current LSN, Previous LSN, Transaction ID, Operation, Context, Page ID, Begin Time, End Time o Transaction Name. No es una interfaz soportada para montar procesos, pero ayuda mucho a entender que el log es una secuencia estructurada de hechos, no una transcripción amable del SQL original.

Consultando el log

Un ejemplo típico de investigación en laboratorio sería algo así:

No recomiendo basar una operativa de producción en esto. Pero como herramienta para aprender cómo respira el motor, tiene mucho valor.

Checkpoint: no es un backup ni un commit

El checkpoint es otro concepto maltratado con una constancia admirable. Y vamos a dejarlo claro desde el principio. Un checkpoint no confirma transacciones. No garantiza que “todo esté guardado”. No sustituye a un backup. Un checkpoint ayuda a reducir el trabajo que tendría que hacer SQL Server durante recovery escribiendo dirty pages al disco y registrando en el log un punto útil desde el que iniciar el análisis.

Cuando se ejecuta un checkpoint, SQL Server intenta vaciar a disco páginas sucias de la memora. También escribe registros de checkpoint en el log. En un modelo tipo ARIES (Algorithms for Recovery and Isolation Exploiting Semantics), el checkpoint es “fuzzy”, porque no detiene el mundo mientras todo queda perfectamente quieto. La actividad puede continuar mientras el checkpoint se produce. Esto implica que el checkpoint no representa una fotografía congelada e impecable de la base de datos, sino un punto de referencia operativo.

Aquí conviene ser muy preciso. Decir “SQL Server empieza desde el último checkpoint” es una simplificación aceptable para una conversación de pasillo, pero incompleta. La fase de Analysis usa la información del checkpoint para reconstruir qué transacciones estaban activas y qué páginas estaban sucias. A partir de ahí, Redo puede necesitar empezar en el recLSN más antiguo de las páginas sucias, que puede ser anterior al propio final del checkpoint.

Por eso no basta con pensar “checkpoint reciente igual recovery trivial”. Ayuda, claro. Pero si hay páginas sucias antiguas, transacciones largas o mucho log activo, el recovery puede tener más trabajo del que uno esperaría mirando solo la hora del último checkpoint.

Tipos de checkpoints

También hay que distinguir entre checkpoints automáticos, manuales e indirect checkpoints. Hablamos de este tema aquí. Con indirect checkpoints, SQL Server intenta cumplir un objetivo de tiempo de recuperación por base de datos, marcado mediante TARGET_RECOVERY_TIME. Esto no significa que garantice por contrato divino que toda recuperación durará ese tiempo. Significa que el motor regula la escritura de páginas sucias para intentar limitar el volumen de Redo. Undo es otra historia, especialmente si hay transacciones largas. Sí, se puede configurar un objetivo precioso y luego estrellarse contra una transacción monstruosa. SQL Server no negocia con tu optimismo.

Arranca la instancia: ¿qué ocurre antes de que veas la base ONLINE?

Ahora si, llegamos a lo que estabas esperando, cuando el servicio de SQL Server arranca después de una caída, primero debe recuperar lo necesario para que la instancia pueda funcionar. Las bases de sistema tienen prioridad obvia. La base de datos master debe estar operativa la primera porque ahí vive la información fundamental de la instancia. Por su lado, model importa porque se usa para crear tempdb. Y tempdb, por su parte, no se recupera como una base normal, se recrea en cada arranque. Nadie debería diseñar nada persistente en tempdb, aunque hay quien lo ha intentado, estos ojos lo han visto.

Después llega la recuperación de las bases de usuario. Cada base tiene su propio transaction log, su propio estado y su propio proceso de recovery. Una base puede estar en RECOVERING, otra ya en ONLINE, otra en RECOVERY_PENDING porque no puede acceder a algún fichero, y otra en SUSPECT si la recuperación falla por problemas graves. No hay una única película para toda la instancia, hay una película por base de datos.

Podemos ver estados básicos desde master:

Durante una recuperación en curso, también puede aparecer actividad en sys.dm_exec_requests con comandos relacionados con startup o recovery. Pero ojo, no siempre veremos lo que queremos, no siempre durante mucho tiempo, y no siempre con el detalle que nos gustaría. Bienvenido al mundo real, donde los DMVs ayudan pero no hacen milagros.

El error log sigue siendo una fuente básica. SQL Server suele informar del progreso de recovery con mensajes en el error log del tipo “Recovery of database X is Y% complete”. Cuando una base tarda, el error log es el primer sitio donde mirar antes de convocar una reunión de emergencia con gente opinando fuerte.

No es elegante, pero es útil. Y en operaciones, lo útil gana a lo elegante casi siempre.

Analysis: reconstruir el campo de batalla

Pero, volvamos un momento al principio. Ya sabemos todo lo que pasa, pero esto no sale de la nada. Hay una primera fase en la que SQL Server analiza la situación y decide que es lo que necesita para recuperarse. Esta fase se conoce como Analysis. 

En la fase de Analysis el motor recorre el transaction log desde el último checkpoint relevante y reconstruye dos estructuras internas fundamentales: la Dirty Page Table y la Active Transaction Table.

La Dirty Page Table, o DPT, contiene páginas que estaban sucias en el momento del fallo. Para cada página interesa especialmente el recLSN, es decir, el LSN más antiguo que pudo haber ensuciado esa página y que todavía puede requerir Redo. Ese recLSN marca desde dónde podría ser necesario rehacer cambios para esa página.

La Active Transaction Table, o ATT, contiene las transacciones que estaban activas cuando se produjo la caída. Esas transacciones son candidatas a Undo, salvo que durante el análisis se encuentre que terminaron correctamente. En terminología clásica, las transacciones confirmadas antes del fallo son winners. Las transacciones activas en el momento del fallo son losers. El motor no se emociona con los nombres, pero la clasificación es bastante clara: unas sobreviven y otras se deshacen.

Subfases de Analysis

Durante Analysis, SQL Server procesa log records para entender qué transacciones empezaron, cuáles hicieron commit, cuáles hicieron rollback, qué páginas se modificaron y qué trabajo quedó en el aire. No está aplicando cambios a páginas todavía. Está reconstruyendo la situación exacta necesaria para decidir después.

Esta fase también identifica el punto desde el que Redo debe empezar. Y este matiz es importante, Redo no tiene por qué empezar exactamente en el último registro de checkpoint. Empieza en el menor recLSN de la DPT. Si una página lleva sucia desde antes del checkpoint y todavía no ha llegado a disco en el estado esperado, el log necesario puede arrancar antes de lo que una explicación superficial sugeriría.

Aquí se ve por qué el tamaño del log activo y la antigüedad de ciertas páginas sucias importan. No hablamos solo de “cuánto pesa el LDF”. Un LDF enorme lleno de VLFs inactivos puede ser menos problemático que una porción activa relativamente menor pero llena de historia que el motor necesita analizar. El tamaño impresiona, el LSN manda.

Para inspeccionar información útil del log moderno, tenemos sys.dm_db_log_stats, que aporta una foto bastante mejor que jugar a adivinar mirando el tamaño del fichero:

No hace falta obsesionarse con cada columna, pero sí entender la idea, el motor no recupera “un fichero”. Recupera una secuencia de log records relevante para llevar la base a consistencia. Los VLFs, el log activo y los LSN son parte de esa conversación.

Dirty Page Table: no todas las páginas sucias son iguales

Una dirty page es una página modificada en memoria que aún no se ha escrito al data file con esos cambios. Esa definición parece simple, pero tenerlo claor evita muchos disparates.

Una dirty page puede contener cambios de una transacción ya confirmada. Si cae el servidor antes de que esa página llegue a disco, Redo deberá rehacer esos cambios desde el log.

También una dirty page puede contener cambios de una transacción no confirmada. Si esa página llegó a disco antes del fallo, Undo tendrá que deshacer esos cambios. Si no llegó a disco, quizá Redo los repita primero para reconstruir la historia y luego Undo los quite. Esto suena raro la primera vez: ¿para qué rehacer algo que luego vas a deshacer? Porque el algoritmo de recuperación repite la historia hasta el punto del fallo y después revierte los losers. Es más robusto y permite que el proceso sea reiniciable.

Una dirty page puede contener mezcla de cambios de varias transacciones, unas confirmadas y otras no. SQL Server no puede tratar la página como una unidad transaccional simple. Tiene que mirar log records, LSNs, estado de transacciones y aplicar o deshacer lo que corresponda. Quien diga “esa página estaba sucia, luego era dato sin commit” está mezclando churras con merinas.

La DPT no existe para decorar la fase de Analysis. Existe para que Redo no tenga que revisar el universo entero. Si una página no estaba sucia en el momento crítico o su pageLSN demuestra que ya contiene un cambio, el motor puede evitar trabajo innecesario. El recovery eficiente depende mucho de no rehacer tonterías. Ya tenemos bastante con las que ejecutan algunas aplicaciones.

Active Transaction Table: el censo de los culpables

La ATT contiene transacciones activas durante la recuperación. Para cada transacción interesa saber su estado, su último LSN y la cadena de log records que permitirá deshacerla si hace falta.

Durante Analysis, una transacción puede aparecer como activa porque se ve un LOP_BEGIN_XACT. Si después aparece un commit endurecido en el log, esa transacción pasa a ser winner. Si no aparece commit ni abort completo antes del final del log disponible, será loser y entrará en Undo.

Aquí hay un detalle crítico, una transacción solo se considera confirmada de verdad si el commit está en el log persistido. Si la aplicación envió un COMMIT, pero el servidor cayó antes de endurecer el log y antes de confirmar al cliente, esa transacción no existe como confirmada a efectos de recovery. Si el cliente recibió confirmación de commit, SQL Server ya debía haber endurecido el log necesario. Esa es la promesa de durabilidad, la D de ACID.

Esto también explica algunas confusiones después de una caída. El usuario jura que “le dio a guardar”. La aplicación quizá envió algo. La red quizá hizo de las suyas. El servidor quizá no llegó a confirmar. Recovery no trabaja con sensaciones del usuario. Trabaja con log records persistidos. Bastante hace.

Redo: repetir la historia, incluso la parte que luego se va a borrar

Acabamos de explicar la fase de Redo cómo “reaplicar transacciones confirmadas”. Es una forma cómoda de contarlo, pero a bajo nivel es imprecisa. En un enfoque tipo ARIES, Redo repite la historia desde el punto necesario. Eso puede incluir cambios de transacciones que estaban sin confirmar en el momento del fallo. Luego Undo se encargará de revertirlas.

¿Por qué hacer eso? Porque así el motor reconstruye el estado de las páginas tal y como podía estar en el momento del crash, basándose en el log. Después aplica la lógica transaccional para eliminar los efectos de las transacciones perdedoras. Este enfoque es idempotente, es decir facilita que la recuperación sea correcta aunque se interrumpa y tenga que reiniciarse. Sí, recovery también puede fallar a medias si se vuelve a caer el servidor. El diseño contempla ese escenario porque, sorprendentemente, el hardware no lee nuestras ventanas de mantenimiento.

Durante Redo, SQL Server recorre log records desde el redoLSN determinado por Analysis. Para cada registro relevante sobre una página, puede comprobar si esa operación ya está reflejada en la página usando el pageLSN.

La lógica conceptual sería algo así:

Si logRecord.LSN > page.pageLSN:

  • aplicar operación de redo
  • actualizar page.pageLSN

Si logRecord.LSN <= page.pageLSN:

  • saltar, la página ya contiene ese cambio o uno posterior

Evidentemente, el motor real es bastante más complejo, porque no todos los log records son simples modificaciones de una fila en una página de datos. Hay allocation pages, metadatos, estructuras de índices, operaciones mínimamente registradas bajo ciertas condiciones, cambios en páginas IAM, PFS, GAM, SGAM, etc. Pero la idea del pageLSN como mecanismo de idempotencia es fundamental.

Undo: caminar hacia atrás por las transacciones loser

Undo trabaja sobre las transacciones que Analysis dejó marcadas como incompletas. Para cada una, SQL Server recorre su cadena de log records hacia atrás usando los enlaces internos del log. No deshace “sentencias”, deshace efectos registrados.

Si una transacción modificó diez páginas, generó muchos log records y quedó abierta, Undo tendrá que revertir lo necesario en orden inverso. Esto puede implicar borrar filas insertadas, restaurar valores anteriores, revertir asignaciones o deshacer cambios de estructuras internas. Depende de lo que la transacción hubiera hecho.

Aquí entran los Compensation Log Records, o CLRs (si otra vez Microsoft reutilizando las mismas siglas en el mismo producto para dos cosas distintas). Cuando SQL Server deshace una operación, registra en el log que ha hecho esa compensación. Esto puede sonar extraño: “¿también loguea el rollback?”. Sí. Y menos mal.

Los CLRs hacen que Undo sea reiniciable. Si el servidor vuelve a caerse en mitad del Undo, al arrancar de nuevo SQL Server no empieza desde cero como si nada hubiera pasado. Puede ver los CLRs y saber qué partes del undo ya se realizaron. Además, los CLRs suelen incluir información como el siguiente LSN que debe deshacerse, el famoso undoNextLSN en la literatura de ARIES.

Un CLR se rehace durante Redo si hace falta, pero no se deshace otra vez durante Undo. Esto evita bucles absurdos donde el motor deshace el deshacer del deshacer hasta que alguien apaga el CPD para que deje de sufrir.

Esta parte explica por qué matar una sesión que está haciendo rollback no te salva. Si una transacción enorme empieza a revertir, SQL Server tiene que dejar la base consistente. Puedes reiniciar la instancia con la esperanza de “cancelar el rollback”, claro. Pero no servirá de nada, al volver, SQL Server retomará el trabajo necesario, porque el log conserva la obligación de terminarlo.

Ejemplos concretos

Pongamos un caso simple. Una transacción inserta una fila y hace commit. El log de la inserción y el commit están en disco. La página de datos modificada sigue en memoria. Cae el servidor. Al arrancar, Analysis detecta lo necesario, Redo encuentra el log record de la inserción, lee la página desde el data file, comprueba que su pageLSN es anterior y reaplica la inserción. La transacción era winner, así que Undo no la toca. Resultado: la fila queda.

Ahora otro caso. Una transacción inserta una fila, no hace commit, pero la página se escribe al data file antes de la caída. Al arrancar, Redo puede no necesitar aplicar esa inserción porque la página ya la contiene. Pero Analysis detecta que la transacción era loser. Undo seguirá la cadena de log records de esa transacción y eliminará la fila. Resultado: la fila desaparece.

Tercer caso. Una transacción inserta una fila, no hace commit y la página no llegó a disco. Redo puede reaplicar la inserción para repetir la historia. Luego Undo la elimina. Resultado final: la fila desaparece igualmente. Parece absurdo hasta que entiendes que el algoritmo prioriza una recuperación reiniciable y consistente sobre una intuición humana de “no hagas lo que vas a deshacer”. El motor no está intentando parecer eficiente en una pizarra, está intentando ser correcto en escenarios complejos.

Otro ejemplo práctico

Vamos a ver un ejemplo completo de manera práctica. Imaginemos una base con una tabla Ventas. Tenemos estas operaciones:

Mientras esa transacción sigue abierta, SQL Server genera log records para el inicio de transacción, el update y el insert. Las páginas afectadas quedan sucias en memoria. Puede ocurrir que una de esas páginas se escriba a disco antes del commit. No pasa nada mientras el log correspondiente se haya escrito antes, cumpliendo WAL.

Ahora cae el servidor.

Durante Analysis, SQL Server ve que esa transacción empezó, ve sus operaciones y no encuentra commit. La mete en la lista de losers.

Durante Redo, SQL Server revisa los log records relevantes. Si la página del update no tiene aplicado el cambio según su pageLSN, lo rehace. Si la página del insert ya lo tenía, lo salta. Al final de Redo, la base puede parecerse al estado físico del momento de la caída, incluyendo cambios no confirmados.

Durante Undo, SQL Server recorre hacia atrás la transacción loser. Primero deshace el insert de VentaId = 99. Después revierte el update de VentaId = 10. Por cada compensación escribe CLRs. Al terminar, la transacción queda abortada de forma consistente.

Resultado: ningún cambio de esa transacción queda visible como confirmado. Pero durante el camino, el motor quizá rehizo cosas que luego deshizo. Y eso está bien. El objetivo no es que el algoritmo coincida con nuestra intuición simplificada; el objetivo es que sobreviva al desastre.

¿Por qué una base puede tardar tanto en recuperarse?

Cuando una base tarda en recovery, normalmente hay que pensar en tres grandes fases de trabajo: Analysis, Redo y Undo. Cada una puede doler por motivos distintos.

Analysis puede tardar si hay mucho log que recorrer, muchos VLFs activos, un checkpoint lejano o una estructura de log poco saludable. No es solo tamaño en GB. Un log con miles y miles de VLFs puede penalizar operaciones de gestión y recuperación. Desde hace años SQL Server ha mejorado la creación de VLFs, pero los entornos viejos, los crecimientos pequeños y frecuentes, y los logs mal dimensionados siguen existiendo. La mala configuración nunca muere, solo cambia de servidor.

Redo puede tardar si hay muchas modificaciones confirmadas pendientes de llegar a los data files, si el almacenamiento es lento, si hay mucha actividad que reconstruir o si el motor debe leer y escribir muchas páginas. Aquí el cuello puede estar en I/O, CPU, lectura de log, escritura de data files o una combinación antipática.

Undo, por su parte, puede tardar si había transacciones largas abiertas. Esta es una de las causas más desesperantes porque muchas veces el negocio solo ve “SQL Server no arranca la base de datos” cuando en realidad el motor está pagando la factura de una transacción enorme que alguien dejó a medias. Procesos batch gigantes, cargas masivas dentro de una única transacción, mantenimientos mal planteados, despliegues que mezclan DDL y DML como si no hubiera mañana… Luego recovery tarda y la culpa, por supuesto, es de la base de datos. Faltaría más.

Un punto fundamental, los checkpoints ayudan sobre todo a limitar Redo, pero no eliminan Undo. Si tienes una transacción abierta durante tres horas y cae el servidor, el checkpoint puede haber ido escribiendo páginas, pero esa transacción sigue siendo loser si no hizo commit. Y si sus cambios llegaron al data file, habrá que deshacerlos. El checkpoint no convierte una transacción abierta en confirmada. Esto parece obvio hasta que uno escucha ciertas teorías en producción.

Recovery y paralelismo: el log es secuencial, aunque SQL Server intente hacer trampas

Hay una pregunta muy natural cuando vemos una base recuperando durante minutos: “¿por qué no usa todos los cores y acaba antes?”. La respuesta corta es que no todo en recovery se puede paralelizar, porque el transaction log es una secuencia ordenada de hechos. Y cuando tu fuente de verdad es una cadena de LSNs, no puedes partirla alegremente como si fuera una tabla heap en un SELECT COUNT(*). 

La fase de Analysis es, por naturaleza, muy secuencial. SQL Server tiene que recorrer el log hacia delante desde el punto de partida relevante, interpretar los log records en orden, reconstruir la Dirty Page Table y la Active Transaction Table, detectar transacciones que empiezan, transacciones que terminan, páginas que se ensucian y estados que cambian. El orden importa. Si lees primero el COMMIT y luego el BEGIN TRAN no serviría de nada..

Por eso Analysis no suele ser una fase que escale felizmente con más CPU. Puede estar limitada por lectura del log, por número de VLFs, por latencia de almacenamiento, por CPU interpretando registros o por una mezcla de todo. Pero no esperes ver dieciséis cores al cien por cien solo porque la instancia tenga muchos procesadores disponibles.

Paralelismo en Redo

En Redo la cosa es más interesante. Conceptualmente, Redo también recorre el log hacia delante desde el redoLSN, pero aplicar los cambios sobre páginas puede paralelizarse en ciertos escenarios. SQL Server puede tener un worker coordinador que lee, clasifica o distribuye trabajo, y workers de redo que aplican cambios sobre páginas diferentes. Ahora bien, esto no significa paralelismo infinito. Hay dependencias, hay latches, hay páginas calientes, hay orden lógico que respetar y hay I/O real contra data files..

En SQL Server 2016 se introdujo parallel redo para bases de datos secundarias en Availability Groups. Microsoft documenta que incluso en versiones con arquitectura de parallel recovery puede haber redo single-threaded, y que en determinados escenarios la instancia asigna threads de redo hasta ciertos límites. En SQL Server 2019 y anteriores había un límite de 100 threads disponibles para redo en ese contexto, y si se agotaban, algunas bases de datos podían quedarse con un único thread de redo.

SQL Server 2022 mejora este punto con ParallelRedoThreadPool, un pool de threads a nivel de instancia compartido por bases de datos con trabajo de redo. La documentación de Microsoft indica explícitamente que este pool permite que varios threads procesen log records de una misma base en paralelo, y que ParallelRedoBatchRedo mejora recovery, catch-up redo y crash recovery redo. 

Pero cuidado, parallel redo no convierte el transaction log en una estructura desordenada. El log sigue siendo secuencial. Lo que se paraleliza es parte del trabajo de aplicación de cambios sobre páginas, no la semántica completa de la recuperación. Hay un orden que interpretar y dependencias que respetar. Por eso el escalado no es lineal. Pasar de uno a ocho workers no significa dividir el tiempo entre ocho, igual que subir MAXDOP no convierte una consulta mal escrita en un formula uno, solo hace que moleste en más schedulers.

Paralelismo en Undo

En Undo, el paralelismo también tiene límites claros. Undo no consiste en leer el log hacia atrás de forma global y repartirlo como cromos. SQL Server deshace transacciones loser siguiendo sus cadenas de log records, normalmente desde el último LSN de cada transacción hacia atrás. Esa cadena tiene orden. Para una transacción concreta, el motor no puede deshacer alegremente el paso 3 antes de entender el paso 4 si hay dependencias entre operaciones. Puede haber trabajo concurrente cuando existen varias transacciones que deshacer, pero una transacción monstruosa sigue siendo una transacción monstruosa. Y si esa transacción concentra el trabajo, el paralelismo tiene poco donde rascar.

VLFs: el log físico también importa

El transaction log está dividido internamente en Virtual Log Files, VLFs. SQL Server escribe log de forma secuencial, pero gestiona reutilización y truncado a nivel de VLFs. Un número razonable de VLFs facilita la vida. Un número disparatado puede empeorar tiempos de arranque, recovery, backups de log, restores y otras operaciones.

El problema clásico aparece cuando un log crece muchas veces en incrementos pequeños. Cada crecimiento crea VLFs nuevos. Repite eso durante años y terminas con una colección absurda de VLFs. Luego llega un failover o un reinicio y todo el mundo descubre que el LDF tenía historia clínica.

Podemos revisar los VLFs con:

No se trata de perseguir un número mágico universal. Se trata de evitar extremos ridículos. Un log de cientos de GB con pocos VLFs enormes puede no ser ideal. Un log con decenas de miles de VLFs pequeños suele ser una invitación al sufrimiento. La solución pasa por dimensionar bien el log, configurar crecimientos sensatos y, si ya está destrozado, planificar una corrección reduciendo y creciendo de forma controlada. Y no, hacer un shrink diario no cuenta como mantenimiento. 

Para profundizar sobre este tema pasate por este otro artículo que escribí hace un tiempo.

El papel del pageLSN: la pieza que evita el caos

Cada página de datos de SQL Server tiene una cabecera con metadatos. Entre ellos está el LSN de la última modificación aplicada. Ese pageLSN permite al motor saber hasta qué punto del log está actualizada esa página.

Durante Redo, SQL Server no puede limitarse a aplicar cada log record ciegamente. Imagina que una página ya fue escrita al data file antes de la caída con ciertos cambios. Si Redo aplicase otra vez esos cambios sin comprobar nada, duplicaría inserciones, repetiría modificaciones o rompería estructuras internas. 

La comparación entre el LSN del log record y el pageLSN permite decidir. Si la página ya refleja ese cambio o uno posterior, se salta. Si no, se aplica. Esta propiedad hace que Redo sea seguro aunque el estado físico de las páginas sea heterogéneo: unas estaban actualizadas en disco, otras no, unas contenían cambios confirmados, otras cambios sin confirmar.

Podemos inspeccionar páginas con DBCC PAGE, aunque esto es un procedimiento no documentado y entra ya en terreno de laboratorio y con cuidado. Primero habría que activar la salida al cliente:

El tercer parámetro sería el número de página. No es algo para ejecutar alegremente en producción porque “lo he visto en un blog”. Pero entender que las páginas tienen cabecera, identificadores, tipo, m_lsn y metadatos internos ayuda a dejar de ver la base como un conjunto abstracto de tablas flotando en el éter.

Allocation pages también participan en la fiesta

Cuando hablamos de recovery solemos pensar en filas de usuario, pero SQL Server también debe recuperar estructuras de asignación. Páginas PFS, GAM, SGAM, IAM y otras páginas internas registran qué extents y páginas están asignados, qué páginas tienen espacio libre, qué objetos poseen qué estructuras y demás información imprescindible. Hablamos de estas páginas de asignación en este artículo.

Si una transacción asignó páginas para insertar datos y luego cayó sin commit, Undo puede tener que revertir no solo la fila, sino también efectos de asignación si procede. Si una operación confirmó asignaciones pero las páginas de asignación no llegaron a disco, Redo tendrá que reconstruirlas. El recovery no consiste en “poner filas bien”; consiste en dejar toda la base internamente coherente.

Esto importa especialmente en operaciones intensivas como cargas masivas, creación o reconstrucción de índices, operaciones mínimamente registradas, cambios de esquema, particionado, movimientos de datos. Muchas de estas operaciones generan patrones de log distintos a un update trivial de una fila. Si una caída ocurre en mitad de una operación de mantenimiento grande, el recovery puede tener bastante trabajo aunque el usuario solo vea “estaba reconstruyendo un índice”.

Aún hay quien lanza mantenimientos masivos en una única ventana sin mirar log, VLFs, almacenamiento, HA ni plan de vuelta atrás. Luego aparece una recuperación larga y se sorprende. La sorpresa es humana, la causa, bastante menos misteriosa.

Minimally logged no significa “sin log”

Otro malentendido habitual, las operaciones mínimamente registradas. En ciertos modos de recuperación y bajo ciertas condiciones, SQL Server puede registrar menos información para operaciones como bulk load, SELECT INTO, creación de índices o algunas operaciones masivas. Pero “mínimamente registrado” no significa “no registrado”.

El motor sigue necesitando información suficiente para garantizar consistencia y recuperación. Puede no registrar cada fila del mismo modo que en una operación completamente registrada, pero registra asignaciones, cambios estructurales y lo necesario para rehacer o revertir según corresponda. Si no pudiera recuperarlo, no sería una optimización, sería una ruleta rusa.

Esto tiene impacto en backups, restores y recovery. En modo bulk-logged, por ejemplo, ciertas operaciones pueden afectar a la recuperación a un punto en el tiempo si hay operaciones mínimamente registradas implicadas. No es el foco de este artículo, pero conviene recordar que el log siempre está en la conversación..

Fast Recovery: online no siempre significa recovery terminado

En determinados escenarios y solo en SQL Server Enterprise, SQL Server puede poner una base online después de completar Redo, mientras Undo continúa en segundo plano. Esto se conoce como Fast Recovery. La idea es permitir acceso a la base antes de que termine todo el rollback de transacciones loser.

Pero cuidado con la interpretación. Que la base esté online no significa que todo sea gratis. Las transacciones que siguen en Undo pueden mantener bloqueos o generar comportamientos que hay que entender. El motor protege la consistencia, no concede un pase VIP a datos que deberían deshacerse.

Este matiz es importante porque a veces se interpreta ONLINE como “ya está todo hecho”. En recovery, ONLINE puede significar “ya puedes entrar, pero todavía estoy limpiando el desastre de alguien”. Es como abrir la tienda mientras aún están fregando el pasillo donde alguien tiró aceite. Puedes pasar, pero no conviene hacer piruetas.

ADR: cuando Undo deja de ser el monstruo de siempre

Accelerated Database Recovery cambia bastante la conversación. Introducido en SQL Server 2019, ADR rediseña la forma en la que SQL Server aborda rollback y recovery para que el tiempo de recuperación sea mucho menos dependiente del tamaño de la transacción más larga.

ADR se apoya en varios componentes, pero los dos que más nos interesan aquí son el Persistent Version Store y el logical revert. En lugar de depender exclusivamente de deshacer físicamente una cadena enorme de cambios durante Undo, ADR mantiene versiones persistentes dentro de la propia base de datos. Esto permite que el rollback lógico sea mucho más rápido desde el punto de vista de disponibilidad.

Con ADR, una transacción larga cancelada puede revertirse de forma casi instantánea para el usuario, aunque internamente luego haya limpieza asíncrona. Durante recovery, el impacto de transacciones largas se reduce de manera drástica. Esto no elimina Analysis ni Redo, pero cambia el peso relativo de Undo y evita muchas situaciones históricas donde una transacción monstruosa dejaba la base atrapada durante demasiado tiempo.

ADR también introduce el concepto de sLog, un stream secundario usado para acelerar la recuperación registrando operaciones no versionadas necesarias. Durante recovery, SQL Server puede usar ese sLog para rehacer la parte crítica con menos coste. No es simplemente “Undo más rápido”; es un cambio de arquitectura en cómo se conserva y usa la información necesaria para volver a consistencia.

Eso sí, ADR no es magia gratuita. Almacenar versiones persistentes tiene coste. Hay limpieza del PVS. Hay efectos sobre espacio, log y determinadas cargas de trabajo. Como casi todo en SQL Server, arregla problemas reales a cambio de introducir cosas que hay que monitorizar.

Activar ADR

Lo primero sería saber si tenemos ADR habilitado o no. Esto en Azure SQL es fácil, viene activado y no lo podemos quitar así que lo tendremos activado. En SQL Server On-Premise podemos ver si ADR está activado en una base con:

Podemos activarlo (cuando proceda y después de probarlo como adultos responsables) con:

No lo conviertas en una receta universal sin medir. En Azure SQL Database, ADR forma parte del comportamiento moderno del servicio. En SQL Server on-premises, hay que entender versión, edición, carga y consecuencias. Nada sustituye a probar con una carga representativa. Sí, representativa de verdad, no tres inserts en una tabla de juguete.

Además, controla el crecimiento del PVS o puedes estar activando una bomba lógica y no una optimización.

Recovery tras restore no es exactamente lo mismo que crash recovery

Conviene separar conceptos. Cuando restauramos una base, también hablamos de recovery. Pero no todo recovery viene de un crash. En un restore con NORECOVERY, SQL Server deja la base preparada para recibir más backups de log o diferenciales. Con RECOVERY, ejecuta la fase final que deja la base consistente y online.

En un crash recovery, SQL Server parte de los archivos existentes de una base que sufrió una parada no limpia. Por su parte, un restore, parte de una secuencia de backups que se aplican en orden. En ambos casos el log es esencial, pero el contexto operativo cambia.

Durante restore, Redo aplica cambios de backups de log para avanzar la base hasta un punto concreto. Undo revierte transacciones incompletas en ese punto final, salvo que dejemos la base en NORECOVERY para seguir aplicando más logs. Por eso una base en NORECOVERY no está disponible: todavía no se ha ejecutado la recuperación final completa que resolvería las transacciones abiertas en el punto restaurado.

Esto explica también el modo STANDBY, donde SQL Server permite acceso de solo lectura entre restores usando un undo file para poder revertir temporalmente transacciones no confirmadas y luego rehacerlas al aplicar más logs. Es una mecánica diferente, pero refuerza la misma idea, Redo y Undo son operaciones reales sobre la historia transaccional.

Recovery Pending y Suspect: cuando ni siquiera podemos empezar bien

No todas las recuperaciones terminan bien y ahí es cuando el DBA empieza a sudar. Pero tranquilo, antes de alarmarnos vamos a entender que es lo que está pasando.

Lo primero es que no todas las recuperaciones fallidas significan corrupción lógica. A veces SQL Server no puede iniciar recovery porque falta un fichero, no tiene permisos, el disco no está disponible o el log no se puede abrir. En esos casos podemos ver RECOVERY_PENDING. La base necesita recuperación, pero el motor no puede comenzarla.

SUSPECT es peor. Indica que SQL Server intentó recuperar la base y falló. Puede deberse a corrupción, problemas de I/O, inconsistencias graves o imposibilidad de completar el proceso. Aquí hay que respirar antes de hacer barbaridades. Poner la base en emergency mode y ejecutar DBCC CHECKDB pero con cabeza. REPAIR_ALLOW_DATA_LOSS no es un plan, es una última bala cuando no hay backup válido y ya hemos aceptado pérdida de datos. El propio nombre lo dice bastante claro, aunque parece que algunos leen solo hasta REPAIR.

El camino serio ante una base suspect empieza por revisar error log, visor de eventos, almacenamiento, disponibilidad de ficheros, backups, última restauración válida y DBCC CHECKDB. Si hay backup bueno, restaurar suele ser más profesional que improvisar.

Qué mirar cuando una base está recuperando

Cuando una base tarda en volver, yo empezaría por el error log. Ahí suele aparecer el avance de recovery y mensajes específicos de cada fase. Después miraría el estado de la base, si el proceso aparece en sys.dm_exec_requests, waits relevantes y métricas del log.

Un primer bloque sencillo sería:

Luego intentaría ver actividad asociada:

Y si la base permite consultar estadísticas de log:

No siempre tendrás toda la información disponible mientras la base está recuperando. Tampoco siempre tendrás permisos. Y lo peor, no siempre la DMV te dará una respuesta con la claridad que deseas. Pero este enfoque es infinitamente mejor que reiniciar el servicio “a ver si espabila”. Reiniciar un recovery largo sin entender qué está haciendo puede devolverte al mismo punto, solo que con más presión y menos tiempo o volver a empezar, lo que es peor.

El papel de las transacciones largas: el enemigo de siempre

Las transacciones largas son veneno para muchas cosas: bloqueos, version store, crecimiento del log, truncado del log, replicación, disponibilidad y recovery. En este contexto, son especialmente desagradables porque aumentan el trabajo de Undo y pueden mantener activa una parte antigua del log.

Una transacción abierta impide truncar log más allá de su LSN de inicio o de lo que necesite el motor para mantener consistencia. Si además modifica muchas páginas, genera una cadena larga de log records que habrá que deshacer si no llega a commit. Da igual que el servidor tenga discos rápidos y mucha memoria, Undo seguirá teniendo que respetar la historia.

Podemos detectar transacciones activas en una base en funcionamiento con DMVs como:

En un sistema sano, esta consulta no debería mostrar transacciones de horas salvo que haya una razón muy justificada. Y aviso: “el proceso siempre ha funcionado así” no es una razón justificada.

Recovery y alta disponibilidad: failover no significa gratis

En Always On Availability Groups, mirroring o escenarios similares, recovery también aparece en distintos momentos. Una réplica secundaria aplica log constantemente para mantenerse sincronizada. En un failover, la base debe quedar en un estado consistente para aceptar trabajo como primaria. Dependiendo del modo, del retraso, de la cola de redo y de la carga, esto puede tener impacto.

En Availability Groups hablamos mucho de send queue y redo queue. La cola de redo indica log recibido pero aún no aplicado en la réplica secundaria. Si esa cola es grande, el failover puede no ser tan inmediato como algunos prometen. Alta disponibilidad no significa que la física se haya rendido. Significa que has diseñado mecanismos para reducir indisponibilidad, siempre que el sistema pueda procesar el trabajo pendiente.

Este punto conecta directamente con lo anterior. Si generas log a una velocidad que las réplicas no pueden rehacer, acumulas deuda. Las operaciones masivas sin mirar redo queue, acumulan deuda. Si tienes almacenamiento lento en secundarias, acumulas deuda. Luego llega el failover y alguien pregunta por qué tarda. La respuesta suele estar en las métricas que nadie miró antes.

Qué prácticas reducen el dolor del recovery

La primera práctica es diseñar transacciones razonables. No metas millones de cambios en una única transacción si puedes trocear de forma segura. Tampoco dejes transacciones abiertas esperando interacción humana. Y mucho menos, envuelvas procesos batch enormes en una transacción global porque “así si falla se revierte todo”. Esa frase ha causado más logs inflamados que muchas malas configuraciones.

La segunda es dimensionar bien el transaction log. Un log debe tener tamaño suficiente para la carga normal y los picos previstos. Debe crecer en incrementos razonables, no en migajas de 1 MB para una base que mueve cientos de GB. Debe tener backups de log frecuentes si está en full recovery. Y debe vigilarse como un componente crítico, no como ese fichero incómodo que ocupa disco.

La tercera es controlar los checkpoints. En bases modernas, indirect checkpoints con TARGET_RECOVERY_TIME ayudan a regular el volumen de Redo esperado. Pero hay que entender su coste, escribir dirty pages de forma más agresiva puede incrementar I/O de fondo. No se configura mirando solo recovery, se configura mirando carga, almacenamiento y objetivos reales.

Podemos revisar el objetivo de recuperación por base con:

Y cambiarlo, si procede, así:

La cuarta es evaluar ADR donde tenga sentido. En sistemas con transacciones largas, rollbacks dolorosos o requisitos estrictos de disponibilidad tras failover, ADR puede ser una mejora enorme. Pero hay que medir espacio, PVS, carga de escritura y comportamiento global. Nada de activar cosas porque suenan modernas. 

La quinta es probar restores y escenarios de recuperación. No basta con tener backups. Hay que restaurarlos, medir tiempos, validar consistencia y entender cuánto tardan Redo y Undo en situaciones reales. Un backup que nunca se ha restaurado es una promesa. Y en producción, las promesas pesan poco cuando el CFO pregunta por la aplicación caída.

Conclusión

SQL Server recovery no es un proceso místico. Es una consecuencia directa de cómo el motor escribe cambios (primero log, después páginas), commit sin forzar data pages, páginas no confirmadas que pueden llegar a disco, recuperación basada en LSN, DPT, ATT, pageLSN y cadenas de log records.

Analysis reconstruye el mapa, define qué páginas podían estar sucias y qué transacciones estaban vivas. Redo repite la historia necesaria para que los data files alcancen un estado coherente con el log. Undo recorre hacia atrás las transacciones perdedoras y compensa sus efectos, registrando CLRs para que incluso el propio rollback sea recuperable.

Cuando entiendes esto, dejas de decir cosas como “Redo aplica solo commits” o “dirty page significa dato sin confirmar”. También dejas de creer que un checkpoint es una varita mágica o que reiniciar una instancia bloqueada en recovery es una estrategia. El motor sabe lo que tiene que hacer. La pregunta es si nosotros hemos diseñado el sistema para que ese trabajo sea razonable.
 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Señales de que una consulta va a tener un mal rendimiento en SQL Server

Abrimos un procedimiento almacenado de varios cientos de líneas y encontramos cursores, funciones en el WHERE, cinco tablas temporales, varios DISTINCT y una colección de joins que parece haber crecido mediante sedimentación geológica. Todavía no hemos ejecutado nada, pero ya sospechamos que la consulta va a tener un mal rendimiento.

Esa sospecha puede estar justificada. 

Voy a dedicar este post a resumir las distintas señales que provocan esa misma reacción entre profesionales de SQL Server: bucles, funciones escalares, conversiones implícitas, joins innecesarios, filtros aplicados demasiado tarde, comodines iniciales o consultas que nadie quiere volver a leer.

Ahora viene la parte importante, ninguno de esos elementos demuestra por sí solo que una consulta sea lenta. Son olores de código. Nos indican dónde debemos mirar, pero el rendimiento depende del volumen, la distribución de los datos, los índices, las estimaciones de cardinalidad, el plan elegido y la concurrencia. Una consulta fea puede ejecutarse en dos milisegundos porque procesa veinte filas. Otra impecablemente formateada puede leer media base de datos para devolver tres registros.

Una señal no es todavía un problema de rendimiento

Cuando revisamos una consulta sin ejecutarla, buscamos construcciones que puedan obligar al motor a realizar más trabajo del necesario. Ese trabajo suele aparecer en alguna de estas formas:

  • Procesar filas repetidamente en lugar de hacerlo como un conjunto.
  • Leer más páginas de las necesarias.
  • Ordenar, agregar o unir grandes volúmenes.
  • Reservar demasiada memoria o derramar datos a TempDB.
  • Compilar un espacio de alternativas excesivamente complejo.
  • Impedir que el optimizador estime correctamente cuántas filas circularán.
  • Mantener bloqueos o consumir workers durante más tiempo.

Por tanto, el problema no está en que una consulta contenga una palabra determinada. El problema aparece cuando esa construcción modifica el plan físico, aumenta el volumen intermedio o reduce las opciones disponibles para el optimizador.

Un CURSOR sobre diez filas no va a derribar el servidor. Un SELECT aparentemente sencillo que se ejecuta quince mil veces por minuto sí puede hacerlo.

Tenemos que valorar el coste por ejecución y multiplicarlo por la frecuencia y la concurrencia. Los datos y la concurrencia de usuarios suelen encargarse de esa multiplicación.

Cursores, bucles y el coste de trabajar fila a fila

Los cursores y los bucles WHILE son probablemente la señal más reconocible. Su mala reputación procede del patrón RBAR (row by agonizing row), obtener una fila, ejecutar una operación, avanzar a la siguiente y repetir.

SQL Server está diseñado para trabajar con conjuntos. Una operación declarativa permite que el optimizador elija el orden de acceso, combine operadores, use paralelismo y reduzca pasos intermedios. Un bucle traslada parte de esa lógica al código procedural y obliga al motor a ejecutar muchas operaciones pequeñas.

El coste puede aparecer en CPU por la repetición, en lecturas acumuladas, en escrituras al log si modificamos datos y en una transacción más larga que conserva bloqueos durante más tiempo. Además, una consulta rápida ejecutada cien mil veces deja de ser rápida cuando medimos el conjunto.

Eso no convierte cualquier cursor en un error. Puede tener sentido cuando cada elemento requiere una operación realmente independiente, cuando interactuamos con recursos externos o cuando el volumen está estrictamente limitado. Lo sospechoso es encontrarlo procesando cientos de miles de filas que podrían actualizarse con una única operación basada en conjuntos.

La pregunta no es “¿hay un cursor?”, sino “¿cuántas veces ejecutamos su cuerpo y qué trabajo repetimos en cada iteración?”.

Las funciones escalares pueden esconder mucho más que una fórmula

Una función escalar dentro de un SELECT, un JOIN o un filtro parece una forma limpia de reutilizar lógica. El código principal queda más corto, pero el coste no desaparece. Solo lo hemos guardado en otro sitio.

Tradicionalmente, SQL Server ejecutaba las funciones escalares T-SQL sentencia a sentencia, sin optimización conjunta con la consulta que las invocaba y sin paralelismo intraconsulta. SQL Server 2019 introdujo el scalar UDF inlining, que puede transformar funciones compatibles en expresiones relacionales para que el optimizador las integre en el plan. Sin embargo, la función tiene que cumplir los requisitos de inlining. no debemos asumir que el motor siempre aplicará la transformación.

Por eso, encontrar una UDF escalar sigue siendo una señal válida. Tenemos que comprobar si se ha incluido físicamente en el plan o si continúa ejecutándose de forma independiente.

También debemos revisar cuántas filas reciben la función. Una operación insignificante aplicada a cinco millones de filas deja de ser insignificante. SQL Server no ofrece descuentos por volumen en CPU.

Las funciones y conversiones en los filtros dificultan localizar las filas

Veamos una construcción habitual:

La intención lógica resulta clara, queremos los pedidos de un día. Físicamente, sin embargo, hemos aplicado una función sobre la columna. El motor puede verse obligado a calcular el resultado para muchas filas antes de comprobar cuáles cumplen el filtro.

Podemos expresar la misma condición como un intervalo:

Esta forma permite que un índice adecuado sobre FechaPedido pueda utilizar sus valores ordenados para localizar el rango. Importante, no garantiza un Index Seek, el optimizador podría preferir un Scan si el intervalo devuelve buena parte de la tabla, si el índice no cubre la consulta o si el coste de los lookups supera al de leerla secuencialmente.

Ese matiz lo cambia todo. El objetivo no consiste en conseguir un icono concreto (el de index seek) en el plan, sino en reducir el trabajo global.

Las conversiones implícitas plantean un problema parecido. Cuando comparamos datos de tipos distintos, SQL Server convierte el tipo de menor precedencia al de mayor precedencia. Dependiendo de qué lado reciba la conversión, el motor puede perder capacidad para aprovechar el orden del índice y también puede empeorar la estimación de cardinalidad.

Conviene revisar especialmente parámetros nvarchar comparados con columnas varchar, números almacenados como texto y joins entre columnas que representan el mismo dato con tipos diferentes. La consulta nunca va a ser óptima si el modelo subyacente no es correcto. Dicho de otro modo, no podemos arreglar con una consulta un mal diseño de la base de datos.

DISTINCT puede estar ocultando un problema de cardinalidad

DISTINCT no es malo. Si necesitamos valores distintos, expresa correctamente el resultado que queremos.

La señal de alerta aparece cuando encontramos DISTINCT después de varios joins y no queda claro por qué existen duplicados. En muchos casos, la consulta ha multiplicado filas debido a una relación uno a varios, un join incompleto o una tabla añadida únicamente para comprobar que existe un registro relacionado. Después se utiliza DISTINCT para eliminar el resultado de esa multiplicación.

Lógicamente obtenemos las filas esperadas. Físicamente, SQL Server puede haber leído, unido y transportado un volumen mucho mayor para descartarlo al final.

Eliminar duplicados suele requerir un Sort o una agregación. Esos operadores necesitan un memory grant calculado a partir de las filas estimadas. Si la reserva resulta insuficiente, el operador puede realizar un spill y escribir datos intermedios en TempDB. SQL Server también utiliza TempDB para resultados intermedios de determinadas operaciones GROUP BY, ORDER BY y UNION.

Con poca carga, ese coste puede pasar desapercibido. Con varias consultas concurrentes solicitando memoria y escribiendo en TempDB, el problema deja de pertenecer a una consulta concreta y empieza a afectar a todo el servidor.

Cuando veamos DISTINCT, debemos comprobar cuántas filas llegan al operador y cuántas sobreviven. Si entran diez millones y salen mil, no tenemos un problema de duplicados. Tenemos un problema anterior disfrazado de limpieza.

Muchos joins amplían el volumen y complican la optimización

Una consulta con muchos joins no tiene por qué ser lenta. El modelo de datos puede exigirlos y el optimizador sabe evaluar diferentes órdenes y algoritmos de unión.

La señal aparece cuando los joins producen grandes volúmenes intermedios, cuando faltan predicados, cuando las columnas relacionadas tienen tipos distintos o cuando la consulta mezcla numerosas relaciones opcionales sin controlar su cardinalidad.

Un CROSS JOIN merece una revisión inmediata porque genera el producto cartesiano de ambos conjuntos. También debemos desconfiar de cadenas de LEFT JOIN seguidas de filtros sobre la tabla derecha que terminan convirtiendo lógicamente la operación en un INNER JOIN. Puede funcionar, pero suele indicar que la intención del código no está bien expresada.

La longitud y complejidad también afectan a la fase de compilación. El optimizador no puede explorar indefinidamente todas las combinaciones posibles. En consultas complejas puede finalizar la búsqueda antes de evaluar alternativas mejores y dejar constancia de un StatementOptmEarlyAbortReason como TimeOut. Un timeout del optimizador no significa que la compilación haya durado el timeout configurado por la aplicación, significa que alcanzó su presupuesto interno de exploración.

Dividir una consulta mediante tablas temporales puede reducir esa complejidad y proporcionar estadísticas sobre resultados intermedios. Pero también introduce escrituras, lecturas, mantenimiento de objetos temporales y posibles problemas de TempDB.

Una cosa es separar fases con una razón técnica. Otra es construir un procedimiento como si cada bloque anterior hubiera dejado una nota diciendo “que lo arregle el siguiente”.

Filtrar al final obliga a transportar datos que no necesitábamos

Otra señal clara aparece cuando la consulta obtiene grandes conjuntos, los almacena o los une y solo aplica los filtros selectivos en la última fase.

Cuanto antes podamos eliminar filas sin cambiar el resultado lógico, menos trabajo tendrán que realizar los operadores posteriores. Reduciremos lecturas, CPU, memoria, tráfico entre hilos y, en arquitecturas distribuidas, movimiento de datos por la red.

Eso no significa que debamos reescribir obsesivamente el orden textual de cada condición. SQL Server puede empujar predicados y reorganizar operaciones durante la optimización. Lo importante es no impedirlo mediante funciones, dependencias complejas, conversiones o materializaciones innecesarias.

Debemos observar el plan real y comparar Actual Number of Rows con las filas leídas y con las que llegan a cada operador. Un filtro que devuelve cien filas después de procesar diez millones merece más atención que un Scan sobre una tabla de quinientas filas.

Los hints suelen revelar una solución que ha envejecido

Encontrar hints como FORCESEEK, INDEX, LOOP JOIN, HASH JOIN o MAXDOP no demuestra que el autor se equivocara. Puede existir una razón válida y medible.

La señal consiste en que estamos limitando deliberadamente las decisiones del optimizador. Esa elección se tomó para un volumen, una distribución de datos, unos índices y una versión concreta. Cuando cualquiera de esos elementos cambia, el hint permanece.

Un hint puede solucionar hoy una mala estimación y convertirse mañana en el motivo por el que el motor no puede elegir un plan mejor. Por eso necesita contexto, comentarios y una prueba de regresión. “Funcionaba más rápido cuando lo pusimos” no es documentación técnica.

Antes de eliminarlo, debemos comparar planes y cargas representativas. Antes de mantenerlo, tenemos que poder explicar qué alternativa evita y por qué sigue siendo perjudicial.

La señal más importante puede no aparecer en el código

Podemos revisar una consulta perfectamente razonable y no encontrar nada sospechoso. Aun así, puede rendir mal por estadísticas desactualizadas, distribución desigual, un plan reutilizado para parámetros poco representativos, bloqueos o presión de recursos.

El optimizador utiliza estadísticas para estimar cuántas filas producirá cada operación. Esas estimaciones condicionan el orden de joins, los algoritmos elegidos, el acceso a índices y la memoria reservada.

Además, SQL Server almacena y reutiliza planes de ejecución. Durante la compilación puede utilizar los valores de los parámetros para generar un plan, y ese plan puede no encajar con ejecuciones posteriores que devuelvan volúmenes muy diferentes.

Por tanto, no basta con leer el código. Tenemos que comprobar:

  • Plan real y diferencias entre filas estimadas y reales.
  • Lecturas lógicas, CPU y duración.
  • Filas leídas frente a filas devueltas.
  • Memory grant solicitado, utilizado y posibles spills.
  • Esperas, bloqueos y consumo bajo concurrencia.
  • Frecuencia de ejecución y coste acumulado.
  • Planes diferentes para distintos parámetros o periodos.

Query Store resulta especialmente útil para estudiar el comportamiento histórico, comparar planes y detectar cuándo una consulta pasó a utilizar una alternativa peor. También permite forzar un plan conocido, aunque el plan forcing debe tratarse como una medida controlada y no como sustituto del diagnóstico.

Conclusión

Las señales de que una consulta va a tener un mal rendimiento nos ayudan a decidir dónde empezar: procesamiento fila a fila, funciones escalares, conversiones implícitas, DISTINCT correctivos, joins que multiplican filas, filtros tardíos, complejidad excesiva o hints sin contexto.

Pero ninguna palabra reservada sustituye a una medición.

Tenemos que relacionar cada señal con su consecuencia física: más filas procesadas, más lecturas, peor estimación, mayor memory grant, spills en TempDB, menor paralelismo, compilaciones complejas o bloqueos más largos. Después debemos validar ese efecto con el plan real, Query Store y una carga representativa.

El error no consiste en utilizar un cursor, una tabla temporal o un DISTINCT. El error consiste en utilizarlos sin saber qué trabajo obligamos a realizar al motor y confiar en que producción será comprensiva.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 1 comentario

Respuestas del sorteo de la European FabCon + SQLCon 2026 Barcelona

Hace unos días lanzamos en nuestra comunidad un sorteo muy especial. La organización de la European FabCon + SQLCon 2026 Barcelona nos regaló una entrada de tres días para sortear entre vosotros y decidimos que, ya que nos juntamos para hablar de datos, la entrada no iba a decidirse simplemente sacando un nombre de una urna virtual.

Había que responder correctamente cinco preguntas técnicas. Quienes acertaron las cinco entraron en el sorteo y ya tenemos ganadora: enhorabuena, Inés. Esperamos que disfrutes de los tres días de conferencia y, sobre todo, que vuelvas con unas cuantas ideas nuevas que poner a prueba.

También queremos agradecer a la organización de la European FabCon + SQLCon 2026 Barcelona que haya contado con nuestra comunidad y, por supuesto, a todos los que habéis participado. Las cinco preguntas tocaban búsqueda híbrida y RAG, SQL Database Projects y schema drift, Data API Builder con GraphQL, indexación de JSON y algo de manipulación de cadenas con T-SQL.

Ahora que el sorteo ha terminado podemos hacer la parte interesante, explicar las respuestas. Para ello voy a tirar de IA, es fin de semana y no me apetece trabajar más, lo siento. Pero, os prometo que la respuesta está validada y es correcta.

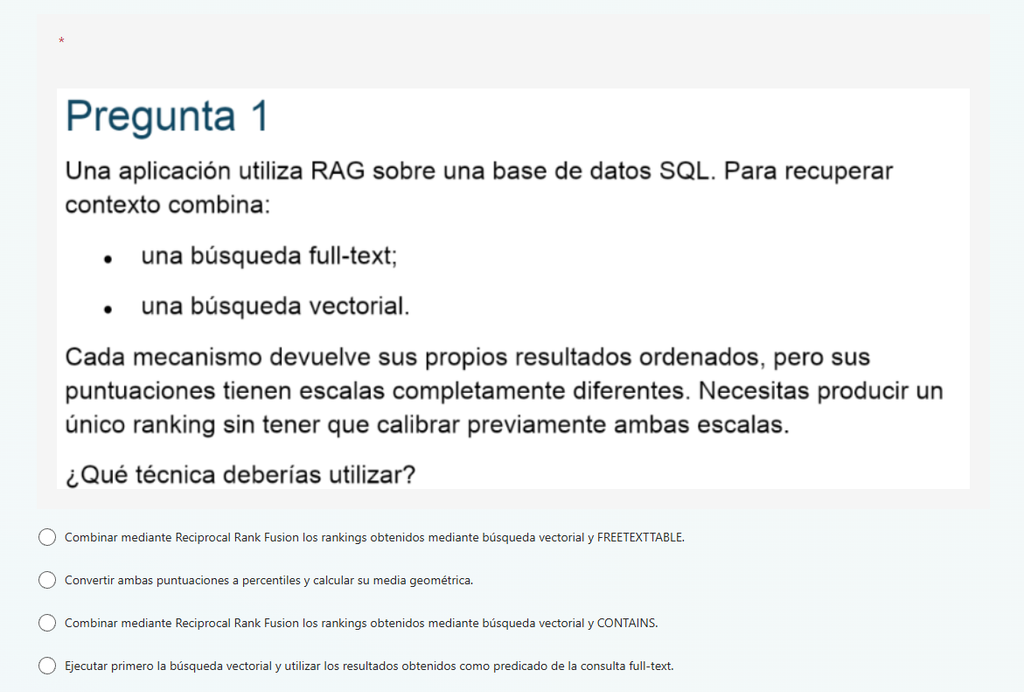
Pregunta 1: cómo combinar búsqueda vectorial y full-text sin mezclar puntuaciones incompatibles

La primera pregunta planteaba una aplicación RAG que recuperaba contexto mediante dos mecanismos: búsqueda full-text y búsqueda vectorial. Ambos devolvían resultados ordenados, pero sus puntuaciones utilizaban escalas completamente diferentes.

La respuesta correcta era A: combinar mediante Reciprocal Rank Fusion los rankings obtenidos mediante búsqueda vectorial y FREETEXTTABLE.

El detalle importante está en que Reciprocal Rank Fusion, o RRF, no necesita comparar directamente las puntuaciones originales. Trabaja con la posición que ocupa cada documento dentro de cada ranking.

Simplificando, cada posición aporta un valor parecido a:

Después sumamos las contribuciones de las distintas listas. Un documento situado muy arriba en la búsqueda vectorial y también bien colocado en full-text acumulará más puntuación que otro que solo destaque en una de ellas.

Eso resuelve precisamente el problema que planteábamos. Una distancia coseno, una similitud vectorial y el RANK producido por full-text no tienen por qué compartir significado ni distribución. Intentar sumar directamente esos valores sería comparar unidades que no representan lo mismo. RRF evita ese problema porque utiliza el orden relativo y no las puntuaciones en bruto. Microsoft describe precisamente RRF como un método score-free apropiado para fusionar búsquedas con distribuciones distintas, como BM25 y similitud vectorial.

¿Por qué FREETEXTTABLE y no CONTAINS? Porque FREETEXTTABLE devuelve KEY y RANK. En cambio, CONTAINS es un predicado: responde si una fila cumple o no la condición, pero no devuelve un ranking. CONTAINSTABLE sí lo haría, pero no era lo que decía la opción C.

La opción B, basada en percentiles y una media geométrica, podría formar parte de un sistema de scoring diseñado expresamente para un workload determinado, pero ya obliga a introducir una transformación y unas decisiones sobre las escalas. Justo lo que queríamos evitar.

La opción D tampoco fusiona realmente ambos rankings. Primero reduce el conjunto mediante vector search y después deja que full-text trabaje únicamente sobre esos candidatos. Un documento excelente léxicamente que haya quedado fuera del primer corte vectorial ya no tiene ninguna posibilidad de aparecer.

La clave era reconocer que teníamos dos rankings válidos, no dos puntuaciones directamente comparables.

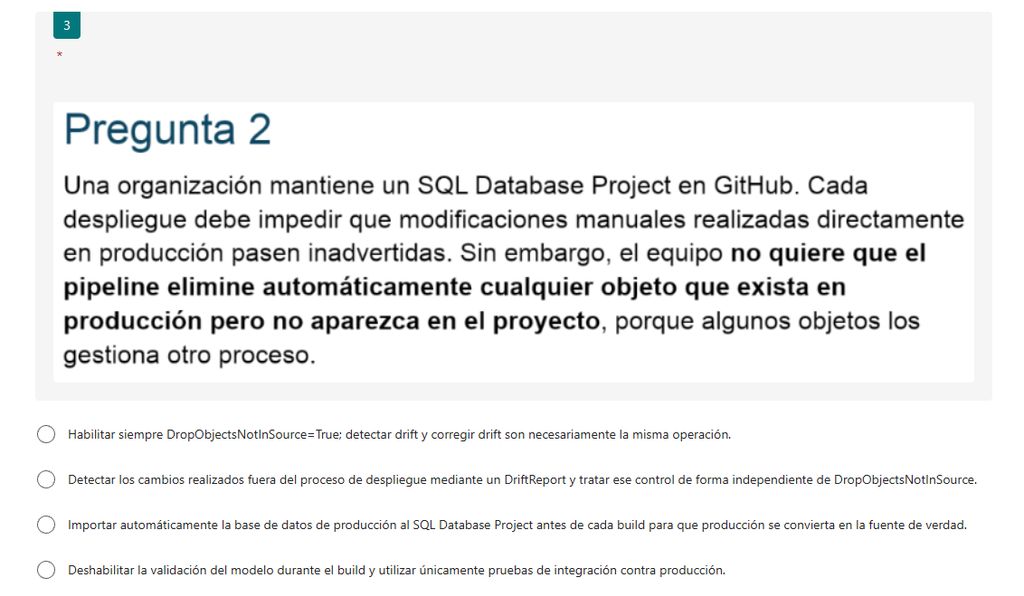
Pregunta 2: detectar schema drift no significa borrar todo lo que no esté en el proyecto

La segunda pregunta trataba un problema bastante más operativo. Tenemos un SQL Database Project almacenado en GitHub y queremos detectar modificaciones realizadas directamente sobre producción. Sin embargo, hay objetos de producción gestionados por otros procesos y no queremos que cada despliegue los elimine alegremente.

La respuesta correcta era B: utilizar un DriftReport para detectar los cambios realizados fuera del proceso de despliegue y tratar ese control independientemente de DropObjectsNotInSource.

Aquí había que distinguir dos conceptos que se mezclan con demasiada facilidad: detectar diferencias y decidir qué hacer con ellas.

DriftReport informa de los cambios realizados en una base de datos registrada desde la última vez que se registró su estado. Es decir, nos proporciona un mecanismo para comprobar que aquello que creemos haber desplegado sigue correspondiéndose con la realidad de la base de datos. SqlPackage dispone además de BlockWhenDriftDetected, que permite impedir una actualización cuando detecta ese desfase.

DropObjectsNotInSource responde a otra pregunta. Indica si, durante la publicación, deben eliminarse del destino los objetos que no existen en el .dacpac. Microsoft lo documenta explícitamente como una propiedad de la operación de despliegue.

Por tanto, detectar drift no obliga a corregirlo automáticamente borrando objetos.

Ese era el problema de la opción A. Activar siempre DropObjectsNotInSource=True puede ser precisamente lo contrario de lo que necesitamos cuando existen objetos administrados fuera del proyecto. Una cosa es que el pipeline nos diga «producción ya no coincide con el estado registrado» y otra muy distinta responder «pues borremos todo lo que sobra». Automatizar una decisión equivocada solo consigue equivocarnos más deprisa.

La opción C también rompe el modelo. Si importamos producción antes de cada build y la convertimos automáticamente en nuestra fuente de verdad, los cambios manuales dejan de ser drift: acabamos incorporándolos al modelo. Git deja de definir el estado deseado y pasa a documentar lo que alguien haya decidido hacer en producción.

Y desactivar la validación del modelo, como proponía D, no soluciona absolutamente nada relacionado con el drift.

La lección es sencilla: observación y remediación deben ser decisiones separadas.

Pregunta 3: una FOREIGN KEY no define por sí sola el contrato GraphQL de Data API Builder

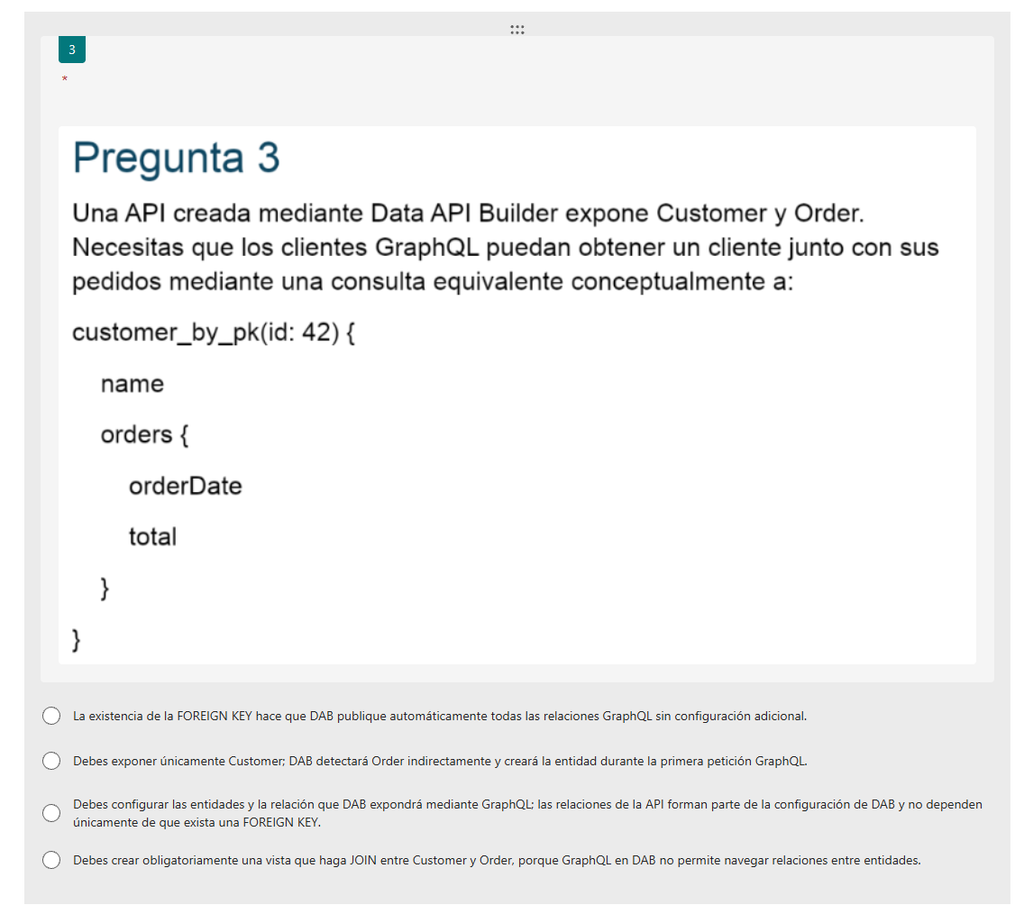
La tercera pregunta planteaba dos entidades, Customer y Order, expuestas mediante Data API Builder. Queríamos poder consultar un cliente y navegar desde GraphQL hasta sus pedidos.

La respuesta correcta era C: configurar las entidades y la relación que DAB va a exponer mediante GraphQL.

Aquí la trampa estaba en confundir el modelo relacional de la base de datos con el contrato de la API.

Una FOREIGN KEY describe una relación e impone integridad referencial en SQL. Data API Builder puede aprovechar esa información y, una vez que hemos definido una relación, incluso puede inferir los campos implicados cuando existe una clave foránea adecuada. Pero eso no significa que DAB publique automáticamente todas las relaciones que encuentre en la base de datos.

La documentación actual es bastante explícita: para poder navegar entre entidades hay que indicar a DAB cómo se relacionan mediante la sección relationships. La configuración establece, entre otras cosas, la entidad destino y la cardinalidad.

Ese matiz descarta la opción A. La FOREIGN KEY ayuda a implementar la relación, pero no sustituye su definición en la API.

La B falla por un motivo parecido. Exponer Customer no provoca que DAB descubra Order, la convierta mágicamente en otra entidad pública y modifique el esquema GraphQL durante la primera petición. Las entidades que DAB expone forman parte de su configuración.

La opción D se va al extremo contrario. No necesitamos crear obligatoriamente una vista con un JOIN. GraphQL en DAB permite modelar relaciones entre entidades y navegar por ellas, que era precisamente lo que pretendíamos hacer.

Esto además tiene una consecuencia arquitectónica importante. El esquema físico de la base de datos y la superficie que queremos publicar no son la misma cosa. No todas las relaciones existentes en SQL deberían convertirse automáticamente en navegación disponible para cualquier consumidor de una API. La configuración también forma parte de nuestra frontera de seguridad y de nuestro contrato externo.

La base de datos conoce las relaciones. La API decide cuáles expone.

Pregunta 4: cómo indexar una propiedad JSON en SQL Server 2022

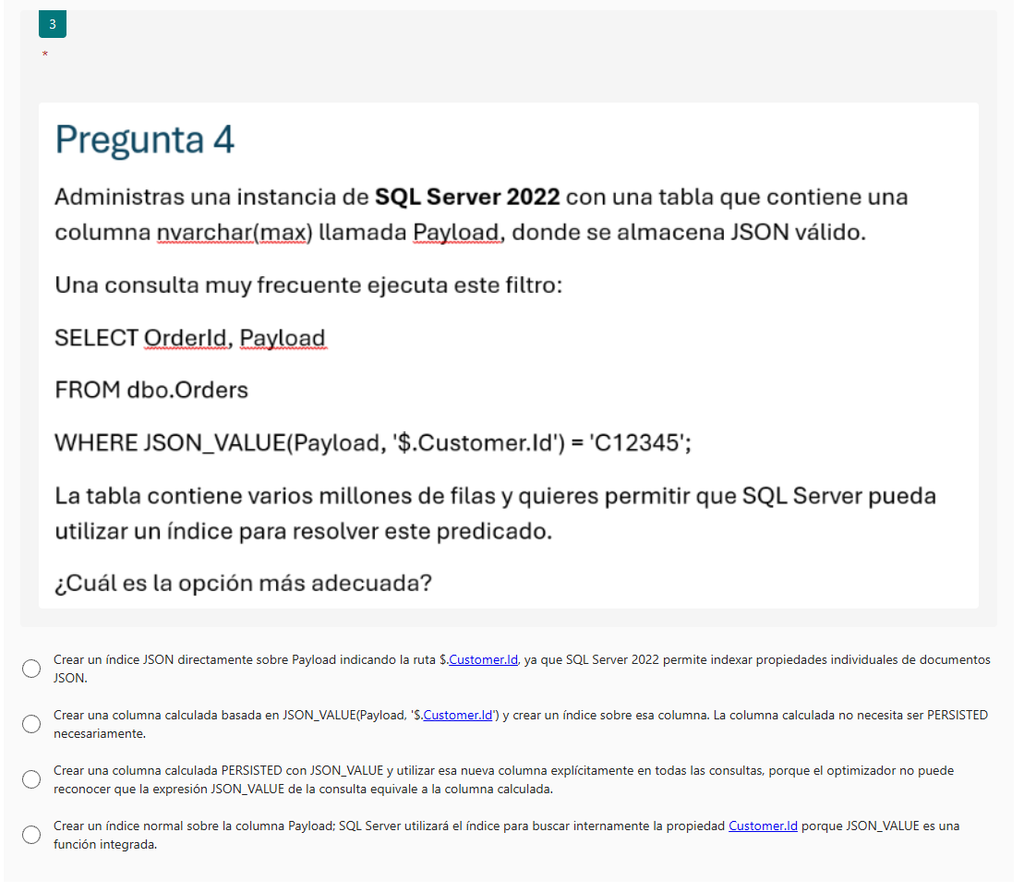
La cuarta pregunta nos llevaba a SQL Server 2022. Una tabla contiene varios millones de filas y almacena JSON dentro de una columna nvarchar(max). La consulta filtra así:

Queremos que el motor pueda utilizar un índice.

La respuesta correcta era B: crear una columna calculada basada en JSON_VALUE y crear un índice sobre esa columna; no necesita ser PERSISTED necesariamente.

En SQL Server 2022 no podemos crear un índice directamente sobre una propiedad interna del documento JSON como hacemos en SQL Server 2025. La técnica documentada consiste en exponer esa propiedad mediante una columna calculada y construir sobre ella un índice convencional.

Por ejemplo, conceptualmente podríamos hacer:

Ahora viene uno de los detalles importantes de la pregunta: la columna calculada no tiene que ser PERSISTED para poder utilizar esta técnica. Microsoft muestra precisamente el ejemplo con una columna calculada no persistida. Además, si mantenemos en la consulta la misma expresión JSON_VALUE, el optimizador puede reconocer la equivalencia con la columna calculada y considerar su índice. No necesitamos obligatoriamente reescribir todas las consultas para hacer referencia al nombre de la nueva columna.

Eso descarta la C.

La A tampoco puede ser correcta porque estamos específicamente en SQL Server 2022. CREATE JSON INDEX pertenece a SQL Server 2025.

La D supone que un índice normal sobre Payload permite localizar una propiedad interna del JSON. No funciona así. Para un nvarchar(max), el índice no construye una estructura secundaria que conozca cada ruta JSON que guardamos dentro del texto.

Hay además un matiz de producción que el test no necesitaba para responder, pero sí deberíamos recordar. JSON_VALUE puede devolver nvarchar(4000), por lo que conviene estudiar el tipo y la longitud reales de la propiedad que vamos a indexar. Microsoft recomienda convertirla al tipo más pequeño apropiado cuando sea posible, porque una clave de índice innecesariamente grande tiene consecuencias de almacenamiento y puede llegar a provocar problemas en operaciones DML.

Y, como siempre, tener un índice disponible no significa que vaya a ser utilizado en todas las consultas. La selectividad, las columnas solicitadas y el coste de los posibles key lookups siguen formando parte de la decisión del optimizador.

El índice no deja de ser un índice porque haya JSON de por medio. Afortunadamente, tampoco adquiere poderes mágicos.

Pregunta 5: SUBSTRING, CHARINDEX y una pequeña trampa con las posiciones

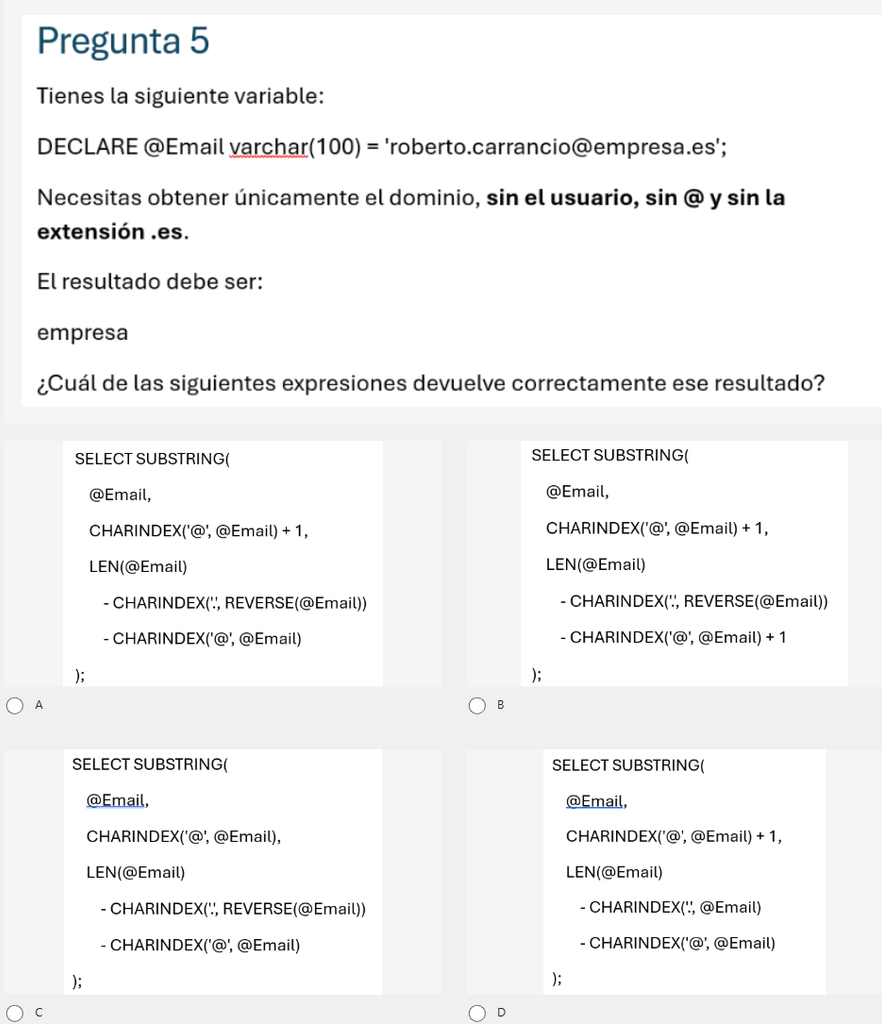
La última pregunta parecía bastante más inocente:

Queríamos obtener:

La respuesta correcta era A.

Vamos a calcularlo porque aquí la diferencia entre las opciones era literalmente de un carácter.

LEN(@Email) devuelve 28. El carácter @ ocupa la posición 18, por lo que el dominio comienza en la posición 19.

Después necesitamos localizar el último punto. Una forma cómoda consiste en invertir la cadena:

En es.aserpme@..., el primer punto aparece en la posición 3. Por tanto, la longitud que queremos extraer es:

Empezamos en la posición 19 y extraemos siete caracteres:

Eso es exactamente lo que hace la opción A.

La opción B suma uno a la longitud y devuelve ocho caracteres, por lo que también captura el punto final: empresa..

La opción C comienza en la posición del propio @, no después de él. Ya hemos desplazado mal la extracción antes de empezar a discutir la longitud.

La D utiliza CHARINDEX('.', @Email) sobre la cadena original. El primer punto no es el que precede a es, sino el que aparece en roberto.carrancio. Por tanto, está utilizando una posición que pertenece al nombre de usuario para calcular dónde termina el dominio.

Esta pregunta tenía además una pequeña segunda lectura. La expresión resuelve el requisito concreto planteado, pero no deberíamos confundir este ejercicio de manipulación de cadenas con un parser universal de nombres de dominio. Direcciones con subdominios o sufijos como .co.uk requieren definir primero qué entendemos exactamente por «dominio» y «extensión».

Con cadenas también conviene acordar el requisito antes de perfeccionar el SUBSTRING. SQL Server todavía no adivina lo que queríamos decir.

Cinco respuestas y una misma idea: entender el comportamiento importa más que recordar la sintaxis

Las respuestas del sorteo de la European FabCon + SQLCon 2026 Barcelona eran, por tanto, A, B, C, B y A.

Pero ese resultado es la parte menos importante. Las cinco preguntas compartían una idea, muchas respuestas incorrectas eran técnicamente verosímiles si nos quedábamos solo con el nombre de una característica.

RRF no sirve porque «mezcle búsquedas», sino porque evita comparar scores incompatibles. DriftReport no es lo mismo que eliminar objetos no declarados. Una FOREIGN KEY no constituye automáticamente un contrato GraphQL. SQL Server 2022 puede indexar una expresión sobre JSON sin disponer todavía de CREATE JSON INDEX. Y una expresión con SUBSTRING funciona porque cuadran exactamente las posiciones, no porque tenga suficientes CHARINDEX como para intimidar al problema.

De nuevo, gracias a la organización de la European FabCon + SQLCon 2026 Barcelona por cedernos la entrada, gracias a todos los que habéis participado y enhorabuena a Ines por ganar el sorteo.

Nos quedamos con algo mejor que cinco letras correctas, el razonamiento que permite volver a responder cuando cambien la versión, el escenario o el enunciado. Y eso, a diferencia de memorizar un test, sí suele sobrevivir al siguiente cambio de producto.

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Búsqueda híbrida en SQL Server: Combinando FULLTEXT y Vectores

Llevamos años viendo aplicaciones que convierten la busqueda de textos en una trituradora de CPU. El usuario escribe tres palabras, la capa de aplicación las trocea como puede, el ORM genera una consulta digna de un informe forense y SQL Server acaba haciendo lo que siempre hace, intentar salvarnos de nuestras propias decisiones. A veces lo consigue. A veces no. Y cuando no lo consigue, alguien abre una incidencia diciendo que “la base de datos va lenta”, como si el motor hubiera decidido por iniciativa propia montar un festival de LIKE ‘%texto%’.

La búsqueda de texto completo ha sido durante mucho tiempo nuestra herramienta principal para resolver este tipo de problemas. Los índices full-text permiten buscar términos dentro de columnas extensas, ordenar por relevancia y evitar que cada búsqueda acabe en un escaneo indecente. Ya hablé de esto con más detalle en el artículo sobre índices de texto completo o full-text indexes, porque siguen siendo una herramienta muy válida cuando necesitamos precisión léxica.

Pero ahora tenemos otro actor en escena: la búsqueda vectorial. SQL Server 2025, Azure SQL Database y SQL Database en Fabric incorporan capacidades nativas para trabajar con vectores, calcular distancias y ejecutar búsquedas aproximadas de vecinos más cercanos mediante VECTOR_SEARCH. En SQL Server 2025 estas capacidades están en vista previa y requieren habilitar PREVIEW_FEATURES. Además, Microsoft documenta que la versión más reciente de los índices vectoriales está disponible actualmente en Azure SQL Database y SQL Database en Microsoft Fabric.

La tentación evidente consiste en pensar que la búsqueda vectorial sustituye al full-text. Es una conclusión cómoda y moderna, pero equivocada. Es muy de presentación ejecutiva, lo que debería hacernos sospechar inmediatamente. La realidad es bastante más interesante, full-text y vectores resuelven problemas distintos, y la búsqueda híbrida aparece precisamente cuando dejamos de tratarlos como enemigos.

Antes de lanzarnos a escribir T-SQL como si no hubiera mañana, conviene dejar claro el problema de fondo.

La búsqueda híbrida no es IA pegada con cinta americana

La búsqueda híbrida combina una búsqueda léxica tradicional con una búsqueda semántica vectorial y fusiona después ambos conjuntos de resultados mediante una técnica de reordenación. La idea parece sencilla, una rama encuentra coincidencias de palabras con full-text indexes, la otra encuentra documentos semánticamente cercanos mediante comparación de embeddings, y una fase final decide qué documentos merecen aparecer arriba.

La clave está en esa última frase. No basta con ejecutar dos consultas y hacer un UNION. Eso no es búsqueda híbrida. Tampoco basta con sumar una puntuación full-text y una distancia vectorial, porque ambas magnitudes viven en universos matemáticos diferentes. SQL Server no va a convertir una escala relativa de relevancia textual y una distancia de coseno en una verdad universal solo porque usemos alias bonitos.

El full-text devuelve señales de relevancia asociadas a coincidencias lingüísticas. CONTAINSTABLE y FREETEXTTABLE devuelven una columna RANK con valores ordinales entre 0 y 1000, pero esos valores indican orden relativo dentro del conjunto devuelto. Microsoft advierte que el valor real no debe tratarse como una puntuación absoluta y puede variar entre ejecuciones.

La búsqueda vectorial, en cambio, devuelve una distancia. Si usamos coseno, valores más bajos indican mayor cercanía cuando trabajamos con VECTOR_DISTANCE o con la columna distance generada por VECTOR_SEARCH. Esa distancia expresa proximidad geométrica entre embeddings, no coincidencia literal de términos. Comparar directamente ambas señales es como comparar páginas leídas con cuanto agua está lloviendo fuera. Puedes hacerlo, pero no significa nada útil.

Por eso la búsqueda híbrida necesita una fase de fusión por rango. No fusionamos puntuaciones brutas, fusionamos posiciones. Y ahí entra Reciprocal Rank Fusion, más conocido como RRF.

Para entender por qué esto importa tanto, primero hay que asumir que full-text sigue siendo necesario.

Full-text: precisión léxica, no comprensión semántica

Un índice full-text sigue siendo una pieza excelente cuando necesitamos encontrar términos, variantes lingüísticas, prefijos, expresiones ponderadas o documentos donde aparecen palabras concretas. No es una tecnología vieja por no llevar “AI” en el nombre. De hecho, suele ser mucho más útil que una demo de embeddings cuando el usuario busca un código, una referencia contractual, un identificador de error o una cláusula exacta.

Imaginemos una base de conocimiento de soporte. Si el usuario busca OOM-802, lo normal es que quiera documentos que contengan OOM-802. No quiere artículos “conceptualmente relacionados con problemas de memoria”. Quiere ese código. Exactamente ese. Si le devolvemos un documento sobre “optimización general de memoria en servidores de aplicaciones” porque está cerca en el espacio vectorial, hemos hecho una búsqueda muy sofisticada y muy inútil. Todo muy moderno, todo muy mal.

Búsqueda de texto completo

Aquí full-text brilla. CONTAINSTABLE permite buscar en una columna indexada y obtener una lista ordenada por relevancia. Además, podemos limitar el volumen con el parámetro top_n_by_rank, algo especialmente importante cuando la condición puede devolver decenas o cientos de miles de filas. La documentación de Microsoft indica que limitar resultados con top_n_by_rank puede mejorar drásticamente el rendimiento, porque SQL Server ordena las coincidencias por rango y devuelve solo las primeras.

Esto no significa que full-text entienda el significado. Si buscamos “vehículo económico”, no podemos asumir que devuelva “coche barato”. Puede haber cierta ayuda lingüística según idioma, tesauro y configuración, pero no estamos ante comprensión semántica general. Full-text trabaja con términos, proximidad, formas lingüísticas y ranking textual. Los embeddings trabajan con representación numérica del significado. Mezclarlos sin entender esta diferencia es una forma estupenda de construir una solución que falle justo cuando el usuario la necesite.

En artículos anteriores del blog ya traté los índices de texto completo desde la perspectiva del DBA. Esa base sigue siendo necesaria. La búsqueda híbrida no elimina el conocimiento de full-text, lo potencia. Si alguien quiere saltar directamente a vectores sin entender CONTAINS, FREETEXT, CONTAINSTABLE, catálogos full-text, stopwords y ranking, adelante. Pero luego no vale llorar.

La otra mitad del problema está en la búsqueda semántica.

Vectores: significado aproximado, no magia contractual

Un embedding representa un texto como un vector numérico. La idea práctica es que textos con significado parecido generen vectores cercanos. A partir de ahí, podemos medir distancias mediante coseno, producto escalar o distancia euclídea, y recuperar los documentos más cercanos al vector de consulta. SQL Server permite realizar búsquedas exactas con VECTOR_DISTANCE, calculando la distancia entre el vector de búsqueda y los vectores almacenados. Microsoft describe este enfoque exacto como un cálculo exhaustivo que garantiza recuperar los vecinos más cercanos, aunque puede resultar costoso en conjuntos grandes.

La búsqueda exacta tiene una ventaja fundamental, no aproxima. Calcula. Si filtramos primero por cliente, estado, idioma, producto o fecha, y después aplicamos VECTOR_DISTANCE sobre un conjunto pequeño, podemos obtener resultados muy buenos sin necesidad de crear un índice vectorial. Esta estrategia suele ser más sensata de lo que parece, sobre todo en tablas medianas o en escenarios donde los filtros relacionales reducen mucho el número de candidatos.

La búsqueda aproximada, por su parte, usa estructuras especializadas para evitar comparar contra todos los vectores. En SQL Server y Azure SQL hablamos de VECTOR_SEARCH, que busca vectores similares mediante un algoritmo aproximado de vecinos más cercanos. Con la versión más reciente de los índices vectoriales, la sintaxis recomendada usa SELECT TOP (N) WITH APPROXIMATE y deja atrás el antiguo parámetro TOP_N, que Microsoft marca como obsoleto para índices recientes.

Índices vectoriales: grafos de embeddings

Aquí aparece DiskANN. Un índice vectorial de tipo DiskANN acelera la recuperación aproximada navegando una estructura de grafo pensada para localizar vecinos cercanos sin recorrer todo el conjunto. Eso tiene un coste. Hay mantenimiento, requisitos, restricciones y decisiones de diseño. No creamos un índice vectorial porque la palabra “vector” aparezca en una reunión. Lo creamos cuando el volumen, la latencia esperada y el patrón de consulta lo justifican.

En el artículo sobre DiskANN y búsqueda vectorial en SQL Server 2025 ya expliqué por qué no conviene indexar vectores en cualquier tabla. Esta recomendación sigue siendo válida. Si tienes 3.000 filas y filtros buenos, probablemente VECTOR_DISTANCE con búsqueda exacta te dé una solución más simple, más predecible y más fácil de razonar. La complejidad innecesaria siempre encuentra la forma de facturarse más tarde.

Como véis, la búsqueda semántica resuelve muy bien consultas ambiguas. “Portátil ligero para viajar”, “incidencia parecida a error de memoria”, “cliente molesto por retrasos recurrentes” o “documentación sobre migración sin parada” son ejemplos donde la coincidencia literal se queda corta. Pero esa misma flexibilidad puede volverse peligrosa cuando la consulta contiene un literal crítico.

Por eso necesitamos una arquitectura híbrida.

El patrón correcto: recuperar candidatos y fusionar rangos

La búsqueda híbrida no debería ejecutar una búsqueda vectorial contra toda la tabla y otra full-text sin límite para después cruzar todo alegremente. Eso solo consumiría recursos a lo loco. El patrón correcto consiste en recuperar un número razonable de candidatos por cada rama y fusionar después esos candidatos mediante un ranking controlado.

La rama léxica puede usar CONTAINSTABLE o FREETEXTTABLE, según queramos una búsqueda más precisa o más lingüística. Para códigos, identificadores, términos técnicos y mensajes de error, normalmente prefiero CONTAINSTABLE. Para búsquedas más naturales o descriptivas, FREETEXTTABLE puede encajar mejor. No son intercambiables, aunque en muchas aplicaciones se usen como si lo fueran. Luego nos extraña que el buscador parezca tener resaca.

La rama semántica puede usar VECTOR_DISTANCE o VECTOR_SEARCH. Si queremos una búsqueda exacta sobre pocos candidatos, VECTOR_DISTANCE es una buena opción. Si tenemos cientos de miles o millones de embeddings, baja tolerancia a latencia y un índice vectorial adecuado, VECTOR_SEARCH pasa a tener sentido. Microsoft también documenta que los índices vectoriales recientes aplican predicados de WHERE durante el proceso de búsqueda vectorial mediante filtrado iterativo, no simplemente después de recuperar vecinos, pero eso, de momento solo está en Azure.

Unir resultados 

La fase final no debe sumar RANK full-text con distancia vectorial. Debe convertir cada lista en posiciones ordinales y aplicar RRF. La fórmula general es sencilla:

score(d) = Σ 1 / (k + rank_i(d))

Donde rank_i(d) es la posición del documento d en la lista i, y k es una constante de suavizado. Si un documento no aparece en una rama, esa rama aporta cero. No aporta un rango inventado de diez mil, salvo que queramos aplicar una penalización heurística deliberada. RRF canónico suma contribuciones de listas donde el documento existe, lo demás ya es cocina propia.

El valor k = 60 aparece a menudo como constante práctica. No es una ley divina, ni una recomendación que debamos tatuarnos pero si podríamos decir que es un estándar del mercado. Un k más bajo da más peso a las primeras posiciones; un k más alto suaviza la diferencia entre posiciones. En buscadores internos suelo empezar con 60, medir, revisar consultas reales y ajustar. Sí, medir. Esa costumbre extravagante que a veces evita reuniones.

Vamos a bajarlo a código.

Modelo de datos para un escenario realista

Supongamos una tabla de tickets de soporte. Cada ticket tiene una descripción textual, metadatos relacionales y un embedding generado a partir del contenido que queremos buscar. No voy a centrarme aquí en la generación del embedding porque ya traté las búsquedas semánticas con IA en SQL Server 2025 en otro artículo, y además dejé ejemplos prácticos en YouTube para quien quiera ver el flujo completo con más calma.

La tabla podría tener esta forma simplificada:

El índice relacional no es decorativo. En una arquitectura híbrida seria, los filtros siguen importando. Si buscamos tickets de un cliente concreto, de un producto concreto o de un rango temporal, no queremos que la parte vectorial se comporte como un turista perdido recorriendo toda la ciudad. Queremos acotar el problema antes de calcular distancias.

El índice full-text iría sobre las columnas textuales relevantes. En producción hay que cuidar idioma, catálogos, stoplists y fragmentación del índice full-text, pero el esqueleto sería este:

El LANGUAGE 3082 corresponde al español. En entornos multidioma, este detalle se complica bastante. Un catálogo global con textos mezclados en cinco idiomas y una sola configuración lingüística no es internacionalización; es una ruleta. Si el negocio necesita búsquedas multidioma, hay que diseñar para ello, no rezar para que el motor “lo entienda”.

Para la parte vectorial, un índice DiskANN puede crearse así cuando el volumen lo justifique:

Los índices vectoriales recientes exigen al menos 100 filas con vectores no nulos antes de poder crearse, requieren una clave primaria clustered y tienen limitaciones actuales como ausencia de particionado, restricciones con TRUNCATE TABLE, no replicarse a suscriptores y problemas de despliegue directo con DacPac o BACPAC porque el índice se crea antes de cargar datos.

Esto ya nos da una pista importante: no hablamos de un índice cualquiera. No es un IX_Tabla_Campo que añadimos a las tres de la tarde para callar una alerta. Un índice vectorial afecta al ciclo de vida de la tabla, al despliegue, al mantenimiento y a los procesos de carga. Si el plan de despliegue de tu base de datos ignora esto, no tienes un plan; tienes un problema.

Ahora sí, veamos una búsqueda híbrida exacta.

Búsqueda híbrida exacta con VECTOR_DISTANCE

El primer patrón usa VECTOR_DISTANCE. Es el más fácil de razonar porque calcula distancias reales contra los candidatos considerados. Conviene usarlo cuando el conjunto final no es enorme, cuando los filtros relacionales son selectivos o cuando la precisión importa más que la latencia extrema.

El siguiente ejemplo recibe una consulta textual, genera su embedding y combina la rama semántica con la rama full-text. Limitamos ambas ramas para no fusionar medio millón de filas, es la forma de decirle a SQL “no hagas barbaridades”.

Hay varias decisiones intencionadas aquí. La rama semántica no calcula distancia contra toda la tabla, sino contra CandidatosFiltrados. Esto permite que el optimizador use índices relacionales antes de aplicar la parte matemática. Si el cliente tiene 4.000 tickets abiertos del producto, calcular 4.000 distancias puede ser razonable. Si tiene 40 millones, probablemente estamos diseñando otra cosa.

La rama léxica usa CONTAINSTABLE con top_n_by_rank. Ese cuarto parámetro limita el número de resultados full-text devueltos. No quiero traer todos los tickets que contengan “memoria” para después descubrir que el usuario solo verá 20 filas. Esa es la diferencia entre una consulta y un castigo.

La fusión usa FULL OUTER JOIN porque un documento puede aparecer solo en la rama semántica o solo en la rama léxica. Después, COALESCE(1.0 / (@rrf_k + rango), 0.0) suma cero cuando el documento no aparece en una rama. Esto es importante, no inventamos rangos artificiales. Si queremos penalizar más o menos los resultados huérfanos, podemos hacerlo, pero entonces debemos reconocer que estamos introduciendo una heurística adicional.

También ordeno por criterios secundarios. En producción, los empates ocurren. Si no defines desempates, el motor puede devolverte órdenes distintos entre ejecuciones. Y cuando el usuario dice “ayer salía primero”, a nadie le divierte explicar que una ordenación parcial no garantiza estabilidad. Bueno, a nadie normal, que yo estoy aquí preparando el artículo más largo de todos los que he escrito para explicaros eso.

Este patrón exacto es muy útil cuando trabajamos con filtros fuertes. Pero si el volumen semántico es grande y necesitamos latencia baja, toca pasar a búsqueda aproximada.

Búsqueda híbrida aproximada con VECTOR_SEARCH

VECTOR_SEARCH representa el patrón de búsqueda vectorial aproximada. Con índices vectoriales recientes, la sintaxis exige SELECT TOP (N) WITH APPROXIMATE y ordenación ascendente por la columna distance, que es la única clave de ordenación válida para los resultados aproximados. Si existe un índice ANN compatible con la misma métrica y columna, puede usarse, si no existe, el motor puede recurrir a kNN y emitir una advertencia.

Una versión híbrida aproximada puede quedar así:

Este ejemplo es parecido al anterior, pero cambia la rama semántica. Ahora usamos VECTOR_SEARCH, que devuelve la columna distance. La consulta solicita explícitamente resultados aproximados con WITH APPROXIMATE. Esto no es un adorno sintáctico, en índices recientes, Microsoft separa claramente la búsqueda aproximada de la exacta mediante esta sintaxis.

La presencia del WHERE dentro de la rama semántica también importa. En versiones recientes de índices vectoriales, Microsoft documenta filtrado iterativo, es decir, los predicados se aplican durante el proceso de búsqueda vectorial, no únicamente después. En versiones antiguas, los filtros podían aplicarse solo después de recuperar vecinos, lo que provocaba resultados vacíos o incompletos si los primeros vecinos no cumplían el filtro. Esta diferencia no es teórica, afecta directamente a la calidad del resultado.

Si trabajas con índices vectoriales antiguos, conviene migrarlos. Microsoft indica que los índices creados con estructuras anteriores se mantienen en la versión actual, pero quedarán retirados en una versión futura, y para obtener las capacidades recientes hay que eliminar y recrear el índice. La propia DMV sys.vector_indexes, junto con sys.indexes y sys.tables, permite consultar la versión registrada en los parámetros de construcción.

Esto introduce una responsabilidad nueva para el DBA. Ya no basta con saber si el índice existe. Hay que saber qué versión tiene, qué sintaxis admite, cómo se comporta con filtros y si soporta mantenimiento DML completo. El “tenemos índice vectorial” se parece demasiado al “tenemos backup”: la frase tranquiliza hasta que preguntas cuándo se ha probado.

RRF con pesos: cuando no todas las señales valen lo mismo

RRF básico da el mismo peso a cada rama. Eso suele ser un buen punto de partida, porque evita discusiones prematuras. Pero no todos los dominios tienen la misma necesidad de precisión literal y contexto semántico. En una base de conocimiento técnica, los códigos de error, nombres de procedimiento, versiones y referencias internas suelen pesar mucho. En un catálogo de productos o una búsqueda documental abierta, la semántica puede tener más protagonismo.

Podemos introducir pesos sin romper la estructura:

Esto ya no es RRF puro, sino RRF ponderado. No hay problema, siempre que seamos conscientes de ello. Lo peligroso no es ajustar el algoritmo, lo peligroso es hacerlo sin medir. Si damos demasiado peso a la rama semántica, un literal crítico puede quedar enterrado bajo documentos conceptualmente parecidos. Si damos demasiado peso a la rama léxica, perdemos recall semántico y volvemos al mundo de “no encuentro coche barato porque el documento dice vehículo económico”.

En entornos serios conviene registrar consultas reales, resultados seleccionados, clics, aperturas, tiempo hasta resolver la incidencia y feedback explícito si existe. Después podemos comparar configuraciones de pesos, tamaños de candidatos y valores de k. La relevancia no se calibra en una pizarra. Se calibra con datos y pruebas. Qué concepto tan revolucionario.

También podemos modificar pesos en función de la consulta. Si detectamos patrones de códigos, identificadores, GUIDs, números de versión o referencias internas, podemos favorecer full-text. Si la consulta es larga, descriptiva y sin literales críticos, podemos favorecer semántica. Este tipo de adaptación suele dar mejores resultados que una configuración fija para todos los casos.

La detección no tiene por qué ser perfecta. Basta con aplicar reglas prudentes. Una consulta con OOM-802, SQLSTATE 40001, KB500 o Procedure dbo.X probablemente necesita más precisión léxica. Una consulta como “el agente se queda bloqueado después de actualizar y consume mucha memoria” puede beneficiarse más del vector. El usuario no nos entrega una intención formal; nos entrega una frase. Nuestro trabajo consiste en no destrozarla.

El tamaño de los candidatos importa más de lo que parece

Uno de los errores más comunes en búsqueda híbrida consiste en recuperar pocos candidatos por rama. Si pedimos top 10 semántico y top 10 léxico para devolver top 10 final, apenas damos margen al algoritmo de fusión. RRF necesita espacio para encontrar documentos que quizá no sean número uno en ninguna rama, pero sí sean buenos en ambas.

Un documento que aparece en posición 12 en la rama semántica y posición 8 en la rama léxica puede ser mucho mejor resultado global que otro que aparece en posición 1 semántica y no aparece en léxica. Si solo recuperamos diez candidatos por rama, el primero puede sobrevivir y el segundo puede ni siquiera existir en la fusión. El algoritmo no puede ordenar documentos que nunca le hemos dado.

Por eso suelo trabajar con una ventana de candidatos bastante mayor que el resultado final. Si voy a mostrar 20 resultados, empezar con 100 o 200 por rama suele ser razonable. Luego hay que medir. No es lo mismo una tabla de tickets internos que una base documental de millones de artículos. Tampoco es lo mismo una búsqueda con filtros por cliente que un buscador global público.

El parámetro top_n_by_rank de full-text ayuda en la rama léxica. En la rama vectorial aproximada, TOP (N) WITH APPROXIMATE marca la ventana semántica. En la rama exacta con VECTOR_DISTANCE, TOP (N) limita el cálculo ordenado final, aunque el coste previo depende de cuántas filas sobrevivan a los filtros relacionales.

Aquí conviene vigilar planes de ejecución, memoria concedida, spills, paralelismo y lecturas lógicas. También hay que observar la distribución de distancias. Si todos los documentos tienen distancias muy parecidas, la señal semántica quizá no discrimina bien. Si el full-text devuelve rankings muy planos, la parte léxica quizá necesita mejorar sintaxis, tesauro, stopwords o normalización de contenido.

La búsqueda híbrida no elimina el tuning. Le añade dimensiones nuevas. Por si alguien echaba de menos complicarse la vida.

Exact search frente a ANN: elegir sin postureo

La búsqueda exacta con VECTOR_DISTANCE calcula distancias y ordena. Es simple, precisa y fácil de auditar. Si el conjunto candidato es pequeño, suele ser una gran elección. También es buena para validación, pruebas de calidad y comparación contra la búsqueda aproximada. En escenarios donde la exactitud es crítica, tener un modo exacto ayuda a detectar pérdida de recall introducida por ANN.

La búsqueda aproximada con VECTOR_SEARCH sacrifica exactitud teórica por velocidad. No tiene nada de malo. Muchos sistemas de búsqueda funcionan así porque el usuario necesita respuestas rápidas y suficientemente buenas. El problema aparece cuando alguien vende “aproximado” como si significara “igual pero más rápido”. No. Significa aproximado. La palabra está ahí, generosamente visible.

Microsoft documenta que VECTOR_SEARCH utiliza búsqueda aproximada de vecinos más cercanos, y que con índices recientes el optimizador puede decidir entre usar DiskANN o búsqueda kNN según las características de la consulta. También indica que, si no hay un índice ANN compatible con la métrica y la columna, se genera una advertencia y se usa kNN.

Esto tiene implicaciones operativas. Si una consulta esperada como aproximada cae a kNN por no tener índice compatible, puede cambiar radicalmente su coste. Si alguien crea el índice con métrica DOT y la consulta usa cosine, no esperes milagros. El motor no va a inventar un índice compatible porque el ticket esté marcado como urgente.

La métrica debe estar alineada con el modelo de embeddings y con la normalización aplicada. En muchos modelos textuales se usa coseno, pero no conviene asumirlo por costumbre. Hay que revisar cómo se generaron los embeddings, si están normalizados y qué distancia recomienda el proveedor o el patrón de uso. El DBA no tiene por qué entrenar el modelo, pero sí debe entender qué está almacenando y cómo se consulta.

Además, el índice vectorial no sustituye los índices relacionales. Microsoft recomienda combinar índices vectoriales con índices tradicionales en columnas usadas por filtros, especialmente cuando el filtrado iterativo puede aprovechar predicados selectivos.

Dicho de otra forma, seguimos necesitando buenos índices B-Tree. La IA no ha derogado la selectividad. Qué disgusto para algunos.

DML, versiones de índice y falsas verdades que caducan

Durante las primeras versiones, una de las limitaciones más agresivas de los índices vectoriales era que las tablas quedaban de solo lectura después de crear el índice. Para permitir DML había que aceptar índices obsoletos mediante configuración, con el riesgo de resultados no actualizados. Esa limitación existió y era importante.

Pero no conviene escribir arquitectura en piedra cuando la tecnología está en vista previa y cambia deprisa. Microsoft documenta que los índices vectoriales creados con la versión más reciente eliminan esa restricción: soportan INSERT, UPDATE, DELETE y MERGE, con mantenimiento automático y en tiempo real del índice. Los cambios son visibles para las búsquedas vectoriales después del commit.

Esto no significa que podamos olvidarnos del mantenimiento. Para reemplazos masivos de datos, por ejemplo al regenerar embeddings con otro modelo, Microsoft recomienda considerar eliminar y recrear el índice después de la carga para mantener calidad de búsqueda predecible. La estructura del índice se construyó con una distribución vectorial determinada; si cambiamos casi todos los embeddings, no deberíamos sorprendernos de que la calidad se resienta.

También siguen existiendo restricciones actuales. No hay soporte de particionado para índices vectoriales, la tabla necesita clave primaria clustered, TRUNCATE TABLE no puede ejecutarse directamente sobre tablas con índice vectorial y los despliegues con DacPac o BACPAC requieren cuidado porque el índice necesita datos no nulos existentes al crearse.

Esto cambia bastante el diseño de procesos ETL. Si regeneramos embeddings en bloque, quizá convenga cargar en una tabla staging, validar dimensiones, controlar nulos, medir duplicados y después hacer intercambio lógico. Si trabajamos en Azure SQL o Fabric con índices recientes, no tenemos que congelar la tabla para cada operación DML normal, pero sí debemos diseñar cargas masivas con cabeza.

También hay que monitorizar. La documentación menciona sys.dm_db_vector_indexes para observar salud del índice y tareas de mantenimiento. En sistemas donde el embedding cambia con frecuencia, esa DMV deja de ser curiosidad y pasa a ser parte del cuadro de mando operativo.

La conclusión práctica es sencilla, no repitas limitaciones antiguas sin mirar versión, pero tampoco vendas los índices vectoriales como índices normales. Ambas posturas son malas. Una por anticuada; la otra por ingenua.

Calidad de datos: embeddings duplicados y basura semántica

La búsqueda vectorial amplifica la calidad del contenido. Si generas embeddings sobre textos pobres, duplicados, genéricos o mal normalizados, el índice devolverá resultados pobres, duplicados, genéricos o mal normalizados. No hay misterio. El embedding no convierte documentación basura en conocimiento. Solo la representa numéricamente con mucha dignidad matemática.

Microsoft recomienda evitar conjuntos con alta proporción de embeddings duplicados, porque perjudican la calidad de resultados, desplazan vecinos más útiles y consumen recursos sin aportar valor.

Esto se ve mucho en bases de conocimiento donde múltiples artículos empiezan con la misma plantilla corporativa. “Estimado usuario, este documento describe el procedimiento para resolver incidencias relacionadas con…” Si generamos embeddings sobre todo el texto sin ponderar ni limpiar, la plantilla común puede contaminar la similitud. Después nos preguntamos por qué todos los documentos parecen iguales. Quizá porque hemos metido el mismo ruido en todos. Sorpresón.

Hay que decidir qué texto se embebe. No siempre interesa usar todo el documento. A veces conviene usar título, resumen, etiquetas, producto, síntomas y causa raíz. En otros casos interesa trocear documentos largos en fragmentos y buscar sobre chunks, no sobre documentos completos. Si un artículo de diez páginas contiene una sección relevante en la página ocho, el embedding global puede diluirla.

También hay que versionar el modelo de embeddings. Si hoy generamos vectores con un modelo y mañana con otro, no debemos mezclar ambos alegremente en la misma columna sin saber qué estamos haciendo. Las distancias entre vectores generados por modelos distintos pueden dejar de tener sentido. Como mínimo, guardaría ModeloEmbedding, FechaEmbedding, HashContenido y estado de generación.

Un diseño más serio podría separar documento y fragmentos:

Este modelo permite buscar fragmentos, no solo documentos. Después podemos agregar resultados por DocumentoID, aplicar RRF sobre fragmentos y mostrar el documento con el fragmento más relevante. Es más trabajo, claro. También es más útil. La alternativa es devolver documentos enormes y confiar en que el usuario encuentre el párrafo bueno. Eso no es buscador; es externalizar el problema.

Reordenación por documento cuando trabajamos con fragmentos

Cuando buscamos sobre fragmentos, aparece un problema adicional. Un documento largo puede tener muchos fragmentos y, por tanto, muchas oportunidades de aparecer. Si no controlamos esto, los documentos extensos dominan el ranking simplemente porque tienen más boletos. Es el mismo vicio de siempre, confundir cantidad con relevancia.

Una estrategia razonable consiste en fusionar primero a nivel de fragmento y después colapsar por documento, quedándonos con la mejor puntuación o aplicando una agregación controlada. Por ejemplo:

Aquí MAX(PuntuacionRRF) evita que un documento se dispare solo por tener muchos fragmentos moderadamente relevantes. El contador de fragmentos coincidentes puede servir como desempate suave, pero no debería dominar la ordenación. Si queremos algo más sofisticado, podemos usar una combinación entre mejor fragmento, número de fragmentos relevantes y diversidad de secciones.

En sistemas RAG, este patrón es especialmente útil. El buscador no solo decide qué documento mostrar; decide qué fragmento alimentar al modelo generativo. Si metemos fragmentos malos en el contexto, el modelo responderá con seguridad y poca vergüenza. La seguridad sin fundamento ya la conocemos de algunas reuniones de arquitectura, pero no hace falta automatizarla.

También podemos añadir filtros de seguridad y visibilidad antes de la búsqueda. Si un usuario no tiene permiso sobre un documento, ese documento no debe aparecer ni por semántica ni por full-text. Esto parece obvio hasta que alguien implementa el filtro después de generar el contexto para el modelo. 

Seguridad, permisos y fuga semántica

La búsqueda híbrida no solo afecta al rendimiento. También afecta a la seguridad. Un embedding puede codificar información sensible del texto original. No es una copia literal, pero tampoco deberíamos tratarlo como un dato inocente. Si generamos embeddings de documentos confidenciales y permitimos búsquedas semánticas sin aplicar permisos correctamente, podemos filtrar conocimiento aunque no devolvamos el texto completo.

La seguridad debe aplicarse antes de formar candidatos o durante el proceso de búsqueda, no al final de manera cosmética. En VECTOR_SEARCH, con índices recientes y filtrado iterativo, los predicados pueden aplicarse durante la búsqueda vectorial. Eso ayuda, pero no sustituye un diseño de seguridad correcto.

En SQL Server podemos resolver parte del problema con predicados relacionales, Row-Level Security o filtros explícitos por tenant, organización, rol o ámbito documental. Lo importante es que la rama léxica y la rama semántica usen exactamente la misma lógica de visibilidad. Si full-text filtra por permisos y vector no, la fusión RRF puede devolver identificadores que la rama textual jamás habría permitido. Y entonces empieza el baile.

También hay que controlar quién puede generar embeddings. Si usamos AI_GENERATE_EMBEDDINGS, debemos revisar modelo, permisos, configuración del servicio y trazabilidad. Si los generamos fuera y los cargamos en SQL Server, debemos validar dimensiones, formato, modelo, nulos y correspondencia con el texto original. Un embedding desalineado con su documento es una mentira muy rápida de consultar.

En entornos multi-tenant, yo evitaría búsquedas vectoriales globales salvo que el aislamiento esté muy claro. Filtrar por tenant no es opcional. Y si el volumen por tenant permite búsqueda exacta con VECTOR_DISTANCE, quizá esa sea la opción más controlable. No todo problema necesita ANN global. A veces la arquitectura sencilla gana porque tiene menos formas de fallar.

La seguridad no debe aparecer como epígrafe al final del proyecto. Si el buscador ya está construido y alguien pregunta “¿cómo filtramos por permisos?”, lo más probable es que la respuesta correcta sea “reescribiendo más de lo que te gustaría”.

Observabilidad: medir relevancia y medir coste

Una búsqueda híbrida tiene dos planos de observabilidad. El primero es técnico: duración, lecturas, CPU, memoria, spills, número de candidatos por rama, uso de índice vectorial, uso de índice full-text, plan elegido, cardinalidades estimadas y reales. El segundo es funcional: consultas reales, documentos mostrados, documentos abiertos, posición del clic, reformulaciones y satisfacción del usuario.

Si solo medimos rendimiento, podemos construir un buscador rapidísimo que devuelve basura. Si solo medimos relevancia, podemos construir un buscador magnífico que tumba producción cada vez que se usa. Ninguna de las dos cosas debería darnos orgullo profesional.

A nivel técnico, conviene registrar para cada búsqueda el texto normalizado, tamaño de candidatos léxico, tamaño de candidatos semántico, top_final, valor de k, pesos aplicados, duración total y duración por rama si separamos ejecución. También podemos guardar si la consulta se trató como “literal crítica” o “semántica dominante”. Esta trazabilidad permite ajustar sin adivinar.

A nivel funcional, el dato más valioso suele ser qué resultado acaba usando el usuario. En soporte, podemos vincular búsqueda con ticket resuelto o artículo seleccionado. Si es documentación interna, podemos medir apertura y permanencia. En buscadores de catálogo, conversión o selección. La relevancia real no siempre coincide con nuestra intuición, especialmente cuando los usuarios escriben cosas que harían llorar a un parser.

También hay que comparar full-text puro, vector puro e híbrido. No para hacer una gráfica bonita, sino para demostrar que la complejidad añadida aporta valor. Si la híbrida no mejora precisión, recall o tiempo de resolución, quizá estamos decorando arquitectura. Y la decoración en producción suele ser cara.

Un enfoque serio consiste en crear un conjunto de consultas de evaluación con resultados esperados. No tiene que ser perfecto. Basta con consultas representativas, incluyendo códigos exactos, frases ambiguas, sinónimos, errores ortográficos, consultas largas y consultas absurdamente cortas. Sobre ese conjunto podemos probar distintos pesos, tamaños de ventana y valores de k.

Sin evaluación, la búsqueda híbrida se convierte en “a mí me parece que va mejor”. Esa frase ha causado más daño que algunos NOLOCK.

Casos donde no usaría búsqueda híbrida

No todo buscador necesita híbrida. Si el usuario busca exclusivamente códigos, referencias exactas, identificadores legales o claves de producto, full-text o incluso índices relacionales bien diseñados pueden bastar. Meter embeddings ahí puede añadir ruido. Una búsqueda de Factura 2024-000834 no necesita poesía semántica.

Tampoco usaría híbrida como primera respuesta a un problema de contenido mal estructurado. Si los documentos no tienen títulos decentes, categorías, producto, idioma, fecha, permisos o estado, la búsqueda híbrida no arreglará el desastre. Solo lo hará más caro. Primero se ordena el contenido; después se mejora la recuperación.

En tablas pequeñas, evitaría crear índices vectoriales salvo que exista una razón clara. Microsoft indica que VECTOR_SEARCH puede funcionar sin índice mediante escaneo brute-force, aunque el rendimiento se degrada con datasets grandes. Para desarrollo, pruebas y conjuntos pequeños, esto puede ser suficiente.

También sería prudente con cargas masivas frecuentes. Si regeneramos embeddings continuamente, cambiamos modelos a menudo o reemplazamos gran parte del dataset, el coste de mantenimiento y reconstrucción puede pesar más que la ventaja de ANN. En esos casos hay que diseñar ventanas de carga, staging, versiones de índice y validaciones. No conviene descubrirlo durante una migración nocturna con tres personas mirando una barra de progreso.

Por último, no usaría híbrida sin una estrategia de seguridad clara. La búsqueda semántica puede recuperar contenido inesperado porque no depende de palabras exactas. Eso es precisamente lo que la hace potente. También es lo que la hace peligrosa si los permisos se aplican tarde o mal.

El mejor buscador no es el que usa más tecnologías. Es el que devuelve lo correcto, rápido, dentro de permisos y con un coste operativo razonable. Parece una obviedad, pero hay arquitecturas enteras construidas para demostrar lo contrario.

Buenas prácticas para llevarlo a producción

La primera buena práctica es separar claramente recuperación y reordenación. La rama full-text recupera candidatos léxicos. La rama vectorial recupera candidatos semánticos. RRF fusiona posiciones. Si mezclamos estas fases sin orden, acabaremos con consultas imposibles de depurar.

La segunda es limitar candidatos por rama. Ni full-text ni vector deberían devolver volúmenes masivos si el resultado final tendrá 20 filas. top_n_by_rank en CONTAINSTABLE y TOP (N) WITH APPROXIMATE en VECTOR_SEARCH son herramientas básicas para controlar el tamaño del problema.

La tercera es conservar filtros relacionales fuertes. Cliente, tenant, producto, estado, idioma, fecha y permisos deben formar parte del diseño. No todo debe resolverse por similitud. A veces una igualdad bien indexada vale más que un grafo vectorial entero. No queda tan bien en una presentación, pero ejecuta mejor.

La cuarta es versionar embeddings. Guarda modelo, fecha, hash del texto y estado de generación. Si cambias el texto, regenera el vector. Cuando cambies el modelo, no mezcles vectores sin control. Si falla la generación, no insertes basura silenciosa. La base de datos recordará tu negligencia con una precisión admirable.

La quinta es medir calidad, no solo latencia. Registra consultas reales y resultados usados. Ajusta pesos y ventanas con datos. RRF funciona muy bien como punto de partida, pero cada dominio tiene sus rarezas. En soporte técnico, los literales pesan mucho. Si es búsqueda documental, la semántica puede dominar. En comercio, atributos estructurados y disponibilidad pueden importar más que ambas.

La sexta es revisar versión y comportamiento de los índices vectoriales. Los índices antiguos tienen limitaciones distintas a los recientes. La sintaxis con TOP_N queda obsoleta para índices nuevos, mientras que SELECT TOP (N) WITH APPROXIMATE es el patrón actual documentado para la búsqueda aproximada con índices recientes.

La séptima es preparar despliegues y mantenimiento. Si usas DacPac, BACPAC, replicación, particionado o cargas masivas, revisa restricciones antes de comprometer la arquitectura. Los índices vectoriales no son invisibles para la operación diaria. El DBA va a convivir con ellos, y conviene que no sea en régimen de sorpresa permanente.

Todo esto suena menos emocionante que “hemos metido IA en el buscador”. También es bastante más probable que funcione.

Conclusión

La búsqueda híbrida no sustituye al full-text ni convierte la búsqueda vectorial en una solución universal. Lo interesante aparece precisamente al combinar ambas señales con criterio, full-text aporta precisión léxica, los vectores aportan contexto semántico y RRF permite fusionar resultados sin mezclar puntuaciones incompatibles.

El diseño correcto no consiste en lanzar dos consultas y rezar. Hay que limitar candidatos, aplicar filtros relacionales, elegir entre búsqueda exacta y aproximada, revisar versiones de índice, controlar permisos, medir relevancia y entender el coste operativo. La parte bonita de la demo dura diez minutos. La parte seria vive dia a dia en producción.

SQL Server está incorporando capacidades muy potentes para búsqueda semántica e híbrida, pero potencia no significa simplicidad. Un índice vectorial mal usado, una rama full-text sin límite o una fusión de puntuaciones mal planteada pueden convertir una gran idea en otra incidencia con prioridad alta.

La búsqueda híbrida merece sitio en arquitecturas modernas, especialmente en bases de conocimiento, soporte, documentación interna y sistemas RAG. Pero exige DBAs que entiendan el motor, no operadores que copien sintaxis de una demo. Como casi siempre, la diferencia entre una solución elegante y una chapuza cara está en los detalles. Y los detalles, por suerte o por desgracia, siguen sin indexarse solos.


Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

¿Por qué no deberías usar SELECT * en vistas de SQL Server?

Usar SELECT * en una vista de SQL Server no es una buena práctica. Esa frase la hemos escuchado muchas veces y, en términos generales, es correcta. El problema aparece cuando la explicación se queda en la superficie y deja una idea equivocada: que una vista definida con SELECT * se comporta como si el asterisco se resolviera dinámicamente cada vez que consultamos la vista.

No funciona así. Y precisamente por eso el tema es más interesante de lo que parece.

Cuando creamos una vista con SELECT *, SQL Server no guarda una especie de comodín vivo que siempre representa “todas las columnas actuales de la tabla”. Durante la creación de la vista, el motor resuelve ese *, determina qué columnas existen en ese momento y almacena metadatos asociados a la vista. Es decir, aunque el texto de la definición pueda seguir mostrando SELECT *, la vista ya tiene una lista de columnas asociada internamente.

Ese matiz es importante porque cambia por completo la forma en la que debemos entender el riesgo. El problema no es solo que SELECT * lea más columnas de las necesarias. En una vista, además, puede generar inconsistencias entre lo que creemos que hemos definido, lo que existe en la tabla base y lo que realmente devuelve la vista.

¿Qué ocurre al crear una vista con SELECT * en SQL Server?

Vamos a partir de un ejemplo sencillo pero suficiente para ver el problema de cerca. Supongamos que creamos una tabla y después una vista usando SELECT *.

A simple vista parece que la vista representa todas las columnas de dbo.Clientes. Y en este momento concreto, eso es cierto. Si consultamos la vista, veremos ClienteID, Nombre y Email.

Pero SQL Server no interpreta ese * como una promesa dinámica de futuro. En el momento de crear la vista, el motor resuelve qué columnas forman parte de ella y guarda esa información en sus metadatos. Podemos comprobarlo consultando sys.columns.

Ahí veremos las columnas que SQL Server tiene asociadas a la vista. No estamos viendo directamente las columnas actuales de la tabla base, sino la metadata de la vista como objeto.

Esto es lo que muchas explicaciones simplifican demasiado. El SELECT * no queda “vivo” en el sentido que muchos imaginan. La vista tiene una estructura persistida. Y cuando la tabla base cambia, esa estructura no se actualiza automáticamente solo porque nos parezca lógico. SQL Server no está aquí para cumplir nuestras expectativas emocionales, por suerte para él.

SELECT * en vistas de SQL Server al añadir columnas

El primer caso es el más habitual: añadimos una columna nueva a la tabla base.

Mucha gente esperaría ver ahora cuatro columnas: ClienteID, Nombre, Email y Telefono. Pero no será así. La vista seguirá devolviendo las columnas que tenía asociadas cuando se creó. La nueva columna existe en la tabla, pero no aparece en la vista.

Aquí el problema es que no suele haber un error al ejecutar la vista. La consulta funciona. Y precisamente por eso el problema es peligroso: no rompe nada de forma evidente. Simplemente tenemos una discrepancia entre lo que parece decir la definición y lo que realmente devuelve el objeto.

Si miramos el texto de la vista, podemos seguir viendo algo como esto:

Pero si miramos las columnas de la vista en sys.columns, veremos que Telefono no forma parte de la metadata de la vista. La definición textual y la estructura efectiva del objeto ya no transmiten la misma idea. Magnífico, otra fuente de confusión silenciosa, como si no tuviéramos suficientes.

Para actualizar la metadata de una vista no enlazada a esquema podemos usar sp_refreshview.

Después de refrescar la vista, SQL Server vuelve a resolver la definición y actualiza sus metadatos. En ese momento la nueva columna puede aparecer. Pero eso no convierte SELECT * en una buena idea. Solo demuestra que la vista necesitaba una actualización explícita para alinear su metadata con la tabla base.

SELECT * en vistas de SQL Server al eliminar columnas

El segundo caso es más agresivo: eliminamos una columna que formaba parte de la vista cuando se creó.

Aquí el resultado puede ser un error al consultar la vista, porque la metadata de la vista sigue esperando una columna que ya no existe en la tabla base. Hemos cambiado el objeto del que depende la vista, pero la vista mantiene una definición interna que ya no puede resolverse correctamente.

Este punto es importante porque desmonta otra idea muy extendida: que las vistas nos protegen automáticamente de los cambios en las tablas base. No. Una vista es un objeto dependiente. Si cambiamos la tabla que hay debajo, podemos romper la vista, igual que podemos romper un procedimiento almacenado, una función o una consulta de aplicación. Realmente sería el mismo problema que si hubiéramos definido las columnas en el SELECT. 

La diferencia es que con SELECT * el problema puede quedar más escondido. Cuando escribimos las columnas explícitamente, vemos con claridad qué dependencias existen. Si una vista usa Email, sabemos que borrar Email rompe esa vista. Con SELECT *, esa dependencia queda disfrazada detrás de un comodín aparentemente inocente.

Y, como casi todo lo que aparenta inocencia en bases de datos, tarde o temprano acaba en una incidencia.

¿Por qué las columnas explícitas son mejores en una vista?

Cuando escribimos una vista así, el contrato queda claro:

Aquí no hay interpretación creativa. La vista devuelve esas columnas porque esas son las columnas que hemos decidido exponer. Si añadimos Telefono a la tabla base, la vista no lo devuelve. Pero eso ya no es una inconsistencia, es el comportamiento esperado. La vista representa un contrato concreto, no una puerta abierta a todo lo que aparezca en la tabla.

Si eliminamos Email, la vista fallará igualmente, pero el motivo será evidente. La definición dice que necesita Email y la columna ya no existe. No hay un * ocultando la dependencia real. El código expresa la intención.

Ese es el verdadero valor de listar columnas explícitamente. No se trata solo de rendimiento, aunque también. Se trata de legibilidad, mantenimiento, seguridad y estabilidad del contrato.

Una vista no debería ser “todo lo que haya en esta tabla”. Una vista debería representar una proyección concreta de datos con un propósito concreto. Si no sabemos qué columnas queremos devolver, probablemente tampoco sabemos muy bien para qué estamos creando la vista. Y en SQL Server eso suele acabar en una colección de objetos heredados que nadie se atreve a tocar, ese museo del terror que todas las empresas llaman “modelo de datos”.

SELECT * en vistas de SQL Server y seguridad

También hay un ángulo de seguridad que suele ignorarse. Si usamos vistas para exponer solo parte de la información de una tabla, SELECT * es especialmente mala idea.

Imaginemos que una tabla de clientes no contiene inicialmente información sensible. Creamos una vista con SELECT * y damos permisos sobre esa vista. Más adelante, alguien añade una columna con información que no debería exponerse a todos los usuarios.

Si la vista no se refresca, quizá esa columna no aparezca inmediatamente. Pero si en algún momento se ejecuta sp_refreshview, se altera la vista o se recrea, esa nueva columna podría acabar expuesta sin que nadie haya revisado conscientemente el contrato de seguridad.

Con columnas explícitas, este riesgo baja muchísimo. Añadir una columna nueva a la tabla no la expone automáticamente en la vista si esta se refresca. Para incluirla, alguien tiene que modificar la definición y escribirla. Ese pequeño acto de intención es importante. En seguridad, los cambios implícitos son una receta estupenda para que un lunes cualquiera empiece con reuniones desagradables.

SCHEMABINDING: cuando queremos bloquear el contrato

Si queremos ir un paso más allá, podemos crear la vista con WITH SCHEMABINDING.

Con SCHEMABINDING, SQL Server impide cambios en las tablas base que afecten a la vista mientras esa dependencia exista. No podremos eliminar una columna usada por la vista sin modificar antes la vista. Tampoco podremos usar SELECT *. Hay que escribir las columnas de forma explícita y usar nombres de objetos cualificados con esquema.

Esto no significa que todas las vistas deban llevar SCHEMABINDING. Depende del caso. Pero cuando una vista actúa como contrato estable para aplicaciones, informes, integraciones o seguridad, merece la pena considerarlo.

Además, las vistas indexadas requieren SCHEMABINDING, precisamente porque SQL Server necesita garantías fuertes sobre la estabilidad de la definición. No puede materializar resultados de una consulta cuyo esquema se mueve alegremente como si estuviera en una reunión de requisitos sin cerrar.

El verdadero problema de SELECT * en vistas de SQL Server

La recomendación “no uses SELECT *” es correcta, pero se queda corta si no explicamos el mecanismo interno.

En consultas ad hoc, SELECT * ya tiene problemas conocidos: lee columnas innecesarias, aumenta tráfico de red, puede empeorar operaciones intermedias y acopla el código al esquema completo de la tabla. Pero en vistas añadimos otro problema: la metadata persistida de la vista puede quedar desalineada respecto a la tabla base.

Al añadir columnas, la vista puede no reflejar los cambios. Al eliminar columnas, puede fallar. Y en todos los casos el origen del problema es el mismo: estamos usando un comodín en un objeto que debería tener un contrato estable.

Por eso la buena práctica no debería formularse solo como “usa columnas explícitas porque es más mantenible”. Deberíamos decir algo más preciso: en una vista, SELECT * se resuelve en el momento de crear o refrescar el objeto, no cada vez que lo consultamos como muchos esperan. Esa diferencia explica los errores, las inconsistencias y los sustos.

Conclusión

SELECT * en una vista de SQL Server no es simplemente una mala costumbre estética. Es una forma de esconder dependencias, debilitar el contrato de la vista y crear una falsa sensación de dinamismo que no existe.

Cuando creamos una vista, SQL Server almacena metadata sobre sus columnas. Si después cambia la tabla base, esa metadata puede quedar desactualizada. Añadir columnas puede no reflejarse en la vista. Eliminar columnas puede romperla.

La solución razonable es escribir siempre las columnas explícitamente, entender la vista como un contrato y usar SCHEMABINDING cuando necesitemos proteger ese contrato frente a cambios accidentales. No se trata de obedecer una regla de buenas prácticas porque sí. Se trata de entender cómo SQL Server interpreta realmente nuestra definición.

Y ahí está la diferencia entre repetir “no uses SELECT *” como un mantra y saber explicar por qué, que casualmente es donde empiezan las buenas decisiones técnicas.


Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

¿Qué pasa cuando ejecutamos una consulta en SQL Server?

Para ojos inexpertos puede parecer trivial. Escribimos una SELECT, pulsamos Ejecutar y SQL Server nos devuelve filas, o al menos devuelve un error con una explicación bastante agresiva de por qué no puede ejecutar la consulta. Esa visión sirve para un usuario primerizo, pero se queda ridículamente corta en cuanto queremos entender rendimiento, bloqueos, estimaciones o por qué dos consultas casi idénticas terminan con comportamientos opuestos.

La realidad es menos mágica y mucho más de ingeniería de esa que nos gusta en este blog. Cuando ejecutamos una consulta, el motor no “lee tablas” sin más. Interpreta el lote, valida sintaxis y semántica, resuelve objetos y permisos, decide si reutiliza un plan o compila uno nuevo, estima cardinalidades, elige operadores físicos, reserva memoria, accede a páginas en memoria o disco, coordina concurrencia y devuelve resultados al cliente. Y todo eso ocurre en milisegundos cuando las cosas van bien. Cuando van mal, nos regala una tarde entera de entretenimiento buscando un problema que no vemos.

¿Parece complicado verdad? Pues espera que te lo explico con más detalle. Pero antes conviene fijar una idea: SQL es declarativo. Nosotros describimos el resultado que queremos, no la secuencia exacta de pasos para obtenerlo. Esa diferencia, que parece un detalle académico, es justo la que separa una explicación decente de un mito de pasillo.

El lote, la sesión y el contexto

Lo primero que recibe SQL Server no es una consulta aislada en una urna de cristal. Recibe un lote (batch) T-SQL enviado por una aplicación cliente, normalmente SSMS, un programa, un driver ODBC/OLE DB o cualquier otro consumidor que hable TDS. Ese lote viaja con un contexto de sesión que importa más de lo que muchos quisieran admitir. Incluye, entre otras cosas, la base de datos actual, el usuario, configuraciones regionales y de idioma, opciones SET, nivel de aislamiento, estado de la transacción y otros detalles que suelen parecer inocentes hasta que rompen la reutilización de planes.

Eso significa que el mismo texto no siempre equivale a la misma ejecución. Dos sesiones con distintas opciones SET pueden acabar con planes diferentes. Dos usuarios con permisos distintos pueden provocar resoluciones distintas. Incluso el contexto transaccional puede condicionar bloqueos, versionado y comportamiento del optimizador. Antes de tocar una sola página de datos, SQL Server ya está operando dentro de unas condiciones concretas. Esas condiciones cuentan luego cuando alguien jura que “la query es la misma” pero no va igual.

Antes de hablar de planes y operadores conviene pasar por la primera puerta del proceso. No porque sea la más compleja, sino porque mucha gente confunde “la consulta compila” con “la consulta está bien”. Son cosas muy distintas, por desgracia.

Parsear no es ejecutar

Una vez que tenemos el lote, la primera fase interna sería el parsing. El motor tokeniza el texto, valida la sintaxis y construye una representación inicial de la consulta. Aquí se detectan errores de sintaxis de esos que todos cometemos cuando estamos cansados: paréntesis mal cerrados, comas absurdas, palabras clave fuera de sitio o expresiones que no encajan en el lenguaje. Superar esta fase solo significa que escribimos algo comprensible para el parser. No significa que tenga sentido desde el punto de vista del motor ni, desde luego, que sea una buena idea.

Después entra el algebrizer, a veces llamado binder. Aquí SQL Server resuelve el significado real de lo que hemos escrito. Tiene que averiguar a qué tabla pertenece cada columna, expandir el *, validar alias, comprobar agregaciones, deducir tipos de datos, aplicar conversiones implícitas y verificar permisos. Es la fase en la que dejamos de pensar en cosas estéticas y empiezan los errores con sustancia: columnas inexistentes, referencias ambiguas, funciones mal usadas, objetos inaccesibles o expresiones incompatibles. También en este punto se van a comprobar los permisos del usuario sobre todos los objetos necesarios. 

Además, el motor construye una representación lógica de la consulta que ya no es puro texto, sino álgebra relacional. En otras palabras, transforma la sentencia en operaciones como proyección, selección, join o agregación. Todavía no ha decidido cómo ejecutar nada físicamente, pero ya sabe qué significa cada pieza y qué resultado lógico perseguimos. También aquí puede aparecer la parametrización automática, esa ayuda que a veces mejora la reutilización de planes y otras veces solo prepara el terreno para un precioso caso de parameter sniffing. La estabilidad nunca ha sido un valor central en la vida del DBA.

A partir de aquí llega una bifurcación clave. Si ya existe un plan reutilizable, SQL Server puede ahorrar mucho trabajo. Si no, toca compilar. Y ahí empieza la parte que realmente decide si una consulta va a tardar milisegundos o va a convertir TempDB en una zona de conflicto.

Caché de planes, optimización y estimaciones

Con la consulta ya entendida, SQL Server mira la caché de planes. Para esto, se usa un hash del texto de la consulta. Si encuentra un plan válido para ese hash y ese contexto, puede reutilizarlo. Esto es fundamental porque compilar cuesta CPU y tiempo. En cargas OLTP, donde una misma consulta se ejecuta miles de veces, la reutilización es parte del rendimiento.

Si no hay plan reutilizable, o si es necesaria una recompilación por cambios en estadísticas, metadatos o condiciones de ejecución, entra el optimizador. Aquí conviene matar un mito viejo: el optimizador no busca el plan perfecto, porque eso exigiría explorar demasiadas combinaciones. Busca un plan suficientemente bueno según su modelo de costes y dentro de un presupuesto finito de tiempo. Lo bastante listo para rendir, lo bastante práctico para no pasarse más tiempo pensando que ejecutando.

Para tomar decisiones usa estadísticas, histogramas, densidades, índices disponibles, restricciones, cardinalidades estimadas y reglas de transformación. Puede reordenar joins, empujar predicados, simplificar expresiones, eliminar operaciones redundantes y elegir entre Nested Loops, Hash Match o Merge Join, entre acceso por seek, scan o lookup, entre ejecución serie o paralela, y entre distintos tamaños de memory grant. Gran parte del rendimiento nace aquí, mucho antes de la primera lectura física.

El mito del orden lógico

Aquí encaja una distinción importante que suele explicarse mal. El famoso orden lógico de una consulta, ese FROM/JOIN, WHERE, GROUP BY, HAVING, SELECT, ORDER BY, sirve para entender el significado del lenguaje. Es útil para razonar sobre el resultado, no para describir el recorrido físico real. SQL Server no ejecuta la consulta siguiendo ese diagrama como quien monta un mueble sueco de esa famosa casa de muebles que estás pensando. El motor puede empujar filtros hacia abajo, reordenar joins y empezar por el conjunto más selectivo si las estimaciones y los índices lo hacen recomendable.

Eso significa que en una consulta entre Clientes y Pedidos, con un filtro muy selectivo sobre Clientes, el plan puede localizar primero esos pocos clientes con un Index Seek y solo después unir con Pedidos. Lógicamente seguimos teniendo un JOIN y un WHERE, pero físicamente el motor ha reorganizado el trabajo para reducir filas cuanto antes. No es una contradicción. Es exactamente lo que esperamos de un optimizador de consultas. Confundir orden lógico con plan físico es una de esas costumbres que sobreviven porque caben bien en una infografía simplona hecha con IA por un gurú de LinkedIn (no del trabajo real).

El problema, claro, es que el optimizador decide en función de estimaciones. Si estima bien, suele elegir razonablemente bien. Si estima mal, el plan puede ser impecable en apariencia y terrible en producción. Un Nested Loops sobre millones de filas, un memory grant insuficiente que termina en spill a TempDB o un paralelismo absurdo no suelen venir de la maldad del motor, sino de una mala predicción. Las estadísticas no son decoración. Son una de las pocas cosas que separan la ingeniería de la adivinación y las apuestas.

Una vez elegido el plan, empieza la ejecución de verdad. Y aquí también conviene aparcar otra simplificación: el plan no se ejecuta como solemos leer el dibujo en SSMS.

Del plan al motor de ejecución

Siempre te han dicho que los planes de ejecucion se leen de derecha a izquierda de abajo a arriba. Y es verdad hasta cierto punto. El motor de ejecución trabaja con un modelo de iteradores, normalmente en modo pull. Un operador superior pide una fila al operador inferior, que a su vez la pide al siguiente, y así sucesivamente. Ese “dame la siguiente fila” parece una trivialidad, pero explica muchas cosas. Explica por qué algunos operadores pueden empezar a devolver resultados casi de inmediato y otros bloquean hasta haber consumido buena parte de la entrada.

Un Top puede cortar el trabajo muy pronto. Un Sort necesita reunir todos los datos y ordenar antes de darle nada al siguiente operador. Un Hash Match puede requerir construir primero una tabla hash en memoria. Un agregado puede operar en streaming o bloquear, según el operador concreto y el plan. Y así con muchos operadores. Además, desde SQL Server 2012 en adelante y con más presencia en versiones modernas, algunas consultas pueden ejecutarse en modo batch, no fila a fila, con beneficios importantes en CPU y throughput. No todo circula del mismo modo por el plan, y esa diferencia se nota.

También aquí aparecen efectos derivados del memory grant. Si el optimizador concede memoria suficiente, un Sort o un Hash Match viven tranquilos. Si se queda corto, llegan los spills a TempDB y el plan empieza a pagar intereses. Y TempDB, como sabemos, siempre está encantada de recibir problemas ajenos en horario laboral.

Hasta ahora hemos hablado del motor relacional. Pero las filas no salen de una abstracción platónica. Alguien tiene que ir a buscarlas. Ahí entra el storage engine, que es donde las cosas pueden torcerse.

Buffer pool, páginas e I/O real

Cuando el plan necesita datos, el storage engine localiza las páginas necesarias. Si esas páginas ya están en memoria, dentro del buffer pool, puede trabajar con ellas inmediatamente. Si no lo están, debe solicitarlas al subsistema de almacenamiento para cargarlas en el buffer pool y, a partir de ahí, continuar la ejecución sobre esas páginas ya residentes en memoria. Esto es clave, el motor no va a pasar datos del disco duro a los resultados de tu consulta, siempre pasan por el buffer pool de la memoria RAM. Y ahí aparecen los costes reales de I/O, los tiempos de espera y toda la artillería interna que rara vez se explican bien, navegación por B-trees, páginas hoja, IAMs, read-ahead, latches y comprobaciones varias.

Un Index Seek no significa “esto será rápido” por definición. Significa que el motor puede navegar por la estructura del índice hasta un rango concreto. Si luego necesita hacer miles de lookups para recuperar columnas no cubiertas por el índice, el coste puede dispararse. Del mismo modo, un Scan no siempre es malo. A veces es la opción correcta si el volumen a leer es grande o si la selectividad no compensa una ruta aparentemente más elegante. El problema no es el nombre del operador, sino el contexto, las filas reales y el trabajo asociado.

La presencia o ausencia de datos en memoria también cambia por completo la película. Una consulta sobre páginas calientes puede correr como un tiro y la misma, minutos después, tener que pelear con lecturas físicas porque la caché cambió. Por eso las pruebas “me ha ido rápido una vez en mi portátil” tienen el valor técnico que suelen tener, muy poco.

Si la consulta solo leyera datos ya tendríamos bastante material, pero muchas veces también modifica. Y cuando modifica, el motor deja de ser solo lector y pasa a garantizar consistencia, aislamiento y durabilidad. Es decir, empieza la parte donde un UPDATE inocente se convierte en un pequeño proyecto de infraestructura.

Bloqueos, versionado y transaction log

Durante la ejecución, SQL Server coordina concurrencia. Adquiere bloqueos compartidos, exclusivos o de actualización, puede escalar bloqueos si la presión lo justifica y, si la base trabaja con READ_COMMITTED_SNAPSHOT o SNAPSHOT, puede recurrir al versionado de filas. Eso significa que una consulta puede tardar por lo que calcula, pero también por lo que espera. Esperas por locks, latches, I/O, memoria o CPU convierten muchas consultas lentas en consultas bloqueadas, contenidas o asfixiadas por el entorno.

Cuando hay escrituras, además, entra en juego el transaction log. Un INSERT, un UPDATE o un DELETE no consisten en cambiar valores y seguir adelante. Hay que registrar la operación, mantener índices, validar restricciones, comprobar claves externas, ejecutar triggers si existen y asegurar propiedades ACID. El COMMIT no es un adorno en estos casos. Es el momento en el que la durabilidad exige que el log esté donde tiene que estar. Si el subsistema de almacenamiento del log no acompaña, lo notaremos muy deprisa.

Por eso dos operaciones aparentemente modestas pueden tener costes muy distintos. Una actualización sobre una tabla con varios índices, triggers y claves foráneas puede mover bastante más trabajo interno del que sugiere una línea de T-SQL. Y no, “solo eran 500 filas” no impresiona a nadie cuando cada fila arrastra media docena de tablas referenciadas.

Todo esto nos lleva a la pregunta inevitable. Si la consulta es la misma, ¿por qué unas veces rinde bien y otras no? La respuesta, para fastidio de quienes esperan una causa única y limpia, es que la ejecución nunca depende solo del texto.

¿Por qué la misma query no siempre corre igual?

La misma consulta puede reutilizar un plan excelente o uno desastroso. Puede encontrar datos en memoria o tener que leerlos de disco, ejecutarse con poca concurrencia o dentro de una tormenta de bloqueos, recibir una estimación razonable o una completamente deformada por estadísticas antiguas, parámetros sesgados o distribuciones raras. También puede obtener un memory grant suficiente o terminar desbordando a TempDB desde el minuto uno.

Por eso el análisis serio siempre se apoya en evidencias: plan real, filas estimadas frente a reales, lecturas lógicas, tiempo de CPU, waits, uso de memoria, spills, recompilaciones y contexto de ejecución. Como ya hemos comentado otras veces al hablar de planes de ejecución, estadísticas o parameter sniffing, el texto T-SQL es solo una parte del problema. Importa, claro. Pero el comportamiento real nace de la combinación entre consulta, datos, estado del servidor y decisiones del optimizador.

Cuando entendemos ese recorrido dejamos de hablar de “consultas lentas” como si fueran criaturas con voluntad propia. Empezamos a hablar de ejecuciones concretas, planes concretos y cuellos de botella concretos. Y a partir de ahí ya se puede trabajar de verdad, que siempre resulta menos cómodo que opinar, pero da mejores resultados.

Conclusión

Cuando ejecutamos una consulta en SQL Server no ocurre magia. Ocurre una cadena compleja de análisis, resolución, optimización, acceso a datos, control de concurrencia y devolución de resultados. El motor no sigue el orden visual con el que leemos la sentencia, ni toma decisiones por estética, ni premia nuestras buenas intenciones. Hace estimaciones, aplica reglas, reutiliza lo que puede y ejecuta bajo las condiciones reales del sistema.

Entender ese proceso cambia por completo la forma de diagnosticar rendimiento. Dejamos de mirar solo la consulta y empezamos a mirar el plan, las estadísticas, la memoria, el log, los bloqueos y las esperas. Ahí es donde se separa la teoría útil de una infografía bonita. Y también donde empieza el trabajo del DBA de verdad.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios
DiskANN: búsqueda vectorial en SQL Server 2025

DiskANN: búsqueda vectorial en SQL Server 2025

SQL Server 2025 ya no mira los vectores desde la barrera. Tenemos tipo vector, búsqueda exacta con VECTOR_DISTANCE y búsqueda aproximada con CREATE VECTOR INDEX y VECTOR_SEARCH, todo ello sobre una implementación que Microsoft vincula de forma explícita con DiskANN. No es una curiosidad de laboratorio ni una feature ornamental para demos con palabras como “semántico” y “copilot” repetidas ocho veces por minuto. Es una apuesta técnica real, todavía con partes en preview, pero real.

Ahora bien, una cosa es que el motor ya hable vectores y otra muy distinta que haya dejado de ser SQL Server. Cuando mezclamos embeddings con filtros relacionales, claves, joins y diseño físico serio, aparecen las costuras. Y eso es precisamente lo interesante. Porque el problema no está en que exista DiskANN, sino en cómo aterriza dentro de un motor que no nació para resolver búsquedas de proximidad semántica sobre datos de negocio.

Antes de entrar en el índice, conviene situar el problema. No para repetir una introducción de manual sobre IA, sino para dejar claro por qué esta funcionalidad no se comporta como un índice relacional clásico con mejor prensa.

Vectores, embeddings y kNN: no buscamos igualdad, buscamos cercanía

Un vector es una secuencia ordenada de números. En SQL Server se almacena con el tipo vector, que internamente usa un formato binario optimizado, aunque se presente como array JSON por comodidad. Cada dimensión ocupa 4 bytes en float32 y SQL Server 2025 añade soporte preview para float16, lo que abre una vía interesante para reducir espacio cuando la precisión lo permita.

Un embedding es un caso particular de vector: una representación numérica que intenta capturar características relevantes de un texto, una imagen o cualquier otro objeto. La consecuencia práctica es que dejamos de preguntar “¿es igual?” o “¿está entre A y B?” y pasamos a preguntar “¿qué está cerca de esto?”. Ese cambio parece pequeño hasta que toca ejecutar consultas. Entonces deja de ser filosofía y pasa a ser coste.

Cuando resolvemos el problema de forma exacta, hacemos un kNN exacto: calculamos distancia contra todos los candidatos y nos quedamos con los más próximos. Microsoft lo describe así en su documentación y, además, deja una recomendación bastante útil: la búsqueda exacta sigue teniendo sentido cuando el conjunto efectivo a revisar es pequeño, con una orientación general de unas 50.000 filas o menos después de aplicar predicados. Ese matiz importa mucho, porque evita uno de los errores más comunes: asumir que lo aproximado siempre es mejor solo porque tiene nombre moderno.

Hasta aquí el problema. La siguiente pregunta es evidente: cuando el volumen crece, ¿cómo evitamos que cada consulta termine pareciendo una inspección completa del universo conocido?

DiskANN: el “cómo” de Microsoft para escalar búsqueda vectorial

La respuesta de Microsoft para búsqueda aproximada es DiskANN. Conviene decirlo bien para no arrastrar una imagen mental equivocada: DiskANN no ordena vectores como si fuera un B-tree extraño. Es una familia de algoritmos de ANNS basada en grafos, pensada para combinar precisión razonable, baja latencia y uso eficiente de memoria y SSD. Microsoft Research describe Project Akupara precisamente como una línea de trabajo orientada a escalar ANNS para búsqueda y recomendación a gran escala, y la publicación original de 2019 presenta DiskANN como un sistema capaz de indexar y buscar mil millones de puntos en una sola máquina usando 64 GB de RAM y SSD.

La gracia de ese enfoque no es solo académica. Microsoft ha ido consolidando DiskANN como base tecnológica en su ecosistema, y SQL Server 2025 lo expone directamente en CREATE VECTOR INDEX con TYPE = ‘DISKANN’. En otras palabras, no estamos ante una abstracción vaporosa; el motor te deja tocarla. Y eso siempre es más útil que una promesa de roadmap adornada con iconos de nube.

Pero aquí aparece el primer matiz importante para cualquiera que haya peleado con diseño físico de tablas. Que SQL Server pueda almacenar vectores no significa que debamos meterlos sin pensar en la tabla principal, como si una fila de negocio de 100 bytes y un embedding de 1.536 dimensiones fuesen vecinos naturales. No lo son.

La decisión de modelado que más sentido tiene

Mi recomendación sigue siendo separar los embeddings en una tabla satélite 1:1 respecto a la tabla relacional principal. No por postureo arquitectónico, sino porque el coste físico de mezclar ambas cosas en la misma fila es demasiado alto para fingir que no existe. Microsoft lo explica con un ejemplo muy claro en su FAQ: una página de datos admite hasta 8.060 bytes (8 Kb) y un vector de 1.024 dimensiones en float32 ocupa 4.104 bytes contando cabecera, lo que ya limita a un solo vector por página. Si subimos dimensiones, el efecto no mejora precisamente.

Eso no significa solo “más fragmentación”, que es la forma rápida de contarlo. Significa también menos densidad de página, más I/O, peor aprovechamiento de caché y más penalización para accesos relacionales que no necesitan tocar el embedding. La guía de diseño de índices de SQL Server insiste en mantener los índices, en especial el clustered, lo más estrechos posible. Y aquí conviene recordar algo bastante básico, si la tabla principal sirve para OLTP o para consultas relacionales normales, meter una columna vectorial enorme ahí dentro porque “ya la usamos en algunas búsquedas” es una forma muy creativa de castigar todo lo demás.

Hay además un segundo argumento, todavía más relevante porque los índices vectoriales aproximados y VECTOR_SEARCH siguen en preview dentro de SQL Server 2025. La tabla que tiene un vector index debe tener una PK clustered entera de una sola columna y, mientras el índice exista, esa tabla queda de solo lectura. En SQL Server 2025 no está disponible ALLOW_STALE_VECTOR_INDEX, así que si cambian los datos toca recrear el índice. Separar embeddings en una tabla 1:1 aísla esa rigidez donde corresponde y evita congelar la tabla relacional principal.

De hecho, el propio material de Microsoft ya deja entrever ese patrón. En los ejemplos de VECTOR_SEARCH aparece una tabla llamada wikipedia_articles_embeddings, lo que sugiere un diseño separado para los vectores frente al contenido relacional o documental. No es una norma escrita en piedra, pero tampoco parece casualidad.

Una vez aceptado ese modelo, la consulta cambia. Y ahí es donde aparece la parte realmente delicada: el JOIN mejora el diseño físico, pero no convierte mágicamente la búsqueda vectorial en algo filter-aware.

¿Qué cambia en la consulta cuando el embedding vive fuera?

Con un diseño 1:1, lo lógico es que VECTOR_SEARCH se ejecute sobre la tabla de embeddings y luego se haga JOIN con la tabla relacional para recuperar atributos de negocio y aplicar filtros. Ese patrón encaja perfectamente con el estado actual del producto, porque VECTOR_SEARCH solo admite tablas base; no puede apuntar a una vista ni a una tabla temporal intermedia ya filtrada. Además, si encuentra un índice ANN compatible en esa columna y con la misma métrica, lo usa; si no, vuelve a kNN.

La consulta natural sería algo así:

Esto está bien desde el punto de vista del modelo físico. La tabla principal sigue estrecha, el índice vectorial vive donde debe y el JOIN 1:1, sobre una clave entera, normalmente será barato. Lo que no cambia es el orden lógico de la operación ANN respecto a los predicados de negocio. Y ahí vuelve a entrar el jarro de agua fría.

El JOIN no arregla el post-filter: solo mueve la frontera

La documentación de VECTOR_SEARCH es bastante clara, la búsqueda vectorial ocurre antes de aplicar cualquier predicado, y los filtros adicionales se evalúan después de devolver los vecinos más similares. Microsoft lo llama post-filter only. Si pides TOP_N = 10 y luego filtras por TenantId o IsActive, puedes acabar con menos de 10 filas o incluso con ninguna. Eso vale igual si el filtro cae sobre la misma tabla que contiene el embedding o si llega desde una tabla relacionada mediante JOIN. El JOIN no cambia esa semántica.

Eso significa que separar embeddings sí mejora el diseño físico, pero no resuelve la principal limitación actual del ANN en SQL Server 2025. El trabajo más caro sigue siendo la navegación del índice DiskANN sobre el conjunto indexado. Si después un filtro de negocio es muy selectivo, la forma de compensarlo suele ser sobremuestrear, subiendo TOP_N para tener suficientes candidatos válidos tras el JOIN y el WHERE. Y cuanto más selectivo sea el filtro, más se erosiona la ventaja del índice aproximado.

Aquí conviene evitar una confusión habitual. El problema no es que el JOIN sea especialmente caro. En una relación 1:1 bien indexada, no suele serlo. El problema es que el filtro relacional llega tarde para ayudar a la fase ANN. Y eso no lo arregla un buen modelo lógico, porque es una consecuencia de cómo está implementado el acceso vectorial hoy en el motor.

La pregunta entonces ya no es si separar la tabla, que para mí sí, sino cuándo conviene dejar de insistir con ANN y volver, sin complejos, a la búsqueda exacta.

¿Por qué no puedes filtrar antes sin romper algo?

La base técnica está bien documentada en la investigación de Microsoft sobre Filtered-DiskANN. El problema de los filtros en ANNS no se resuelve bien tocando solo la fase de búsqueda. El paper critica precisamente el enfoque de postprocesado, porque para filtros de baja especificidad puede obligar a recuperar muchísimos candidatos antes de encontrar uno que cumpla el predicado. Pero también deja claro que la solución trivial de “un índice por filtro” no escala.

La razón de fondo es que un índice tipo DiskANN es un grafo global construido sobre todos los vectores. Durante la búsqueda, algunos nodos no son resultados finales interesantes, pero sí son cruciales como puentes para navegar hacia la zona correcta del espacio vectorial. Si yo aplico un filtro arbitrario antes de buscar y elimino parte de esos nodos, puedo romper la navegabilidad efectiva del grafo. Dicho de otra manera, el subconjunto filtrado no conserva necesariamente las propiedades del índice original. Y eso afecta al recall, al coste o a ambas cosas.

Por eso filtered ANN de verdad no consiste en “empujar el WHERE hacia abajo” y quedarse tan ancho. Requiere índices diseñados con consciencia de filtro, estrategias de construcción distintas o, al menos, estructuras auxiliares que permitan no destrozar el recorrido. Ahí es donde la investigación va por delante de la implementación actual del motor. Y sinceramente, mejor admitirlo que fingir que un predicado sobre TenantId va a integrarse solo por buena voluntad. También podríamos confiar en MERGE en producción, pero cada uno gestiona sus traumas como puede.

A partir de aquí, la pregunta útil deja de ser “siempre ANN o siempre exacto” y pasa a ser mucho más adulta: “¿cuándo me compensa cada enfoque en SQL Server 2025?”.

¿Cuándo DiskANN tiene sentido y cuándo es mejor volver a VECTOR_DISTANCE?

Si el corpus es grande y los filtros relacionales son débiles, VECTOR_SEARCH con DiskANN es la opción natural. Para eso existe, para reducir latencia y coste frente a un barrido completo. Pero si el patrón real de consulta siempre filtra fuerte por cliente, estado, región o cualquier dimensión de negocio que reduzca mucho el conjunto efectivo, entonces la recomendación oficial de Microsoft cobra todo el sentido del mundo: cuando acabas buscando sobre 50.000 vectores o menos, la búsqueda exacta con VECTOR_DISTANCE vuelve a ser una alternativa muy seria.

Y aquí, precisamente, la separación 1:1 juega a favor. Puedes filtrar primero en la tabla relacional, quedarte con el subconjunto de negocio que realmente importa, hacer el JOIN hacia la tabla de embeddings y calcular distancias solo sobre esos candidatos. Es una estrategia mucho más alineada con el optimizador relacional clásico y, además, evita pedirle a un índice ANN global que resuelva con elegancia algo para lo que no ha sido diseñado. Sí, podemos pedirle heroicidades a cualquier índice. También podemos confiar en que un SELECT * no acabará mal. Pero a cierta altura de la película conviene distinguir entre esperanza y diseño.

Conclusión

SQL Server 2025 ha dado un paso importante con búsqueda vectorial nativa y DiskANN como base técnica para ANN. Eso merece atención, pruebas serias y bastante menos folklore del habitual. Pero también conviene poner cada pieza en su sitio. El mejor diseño, en la práctica, pasa por separar embeddings en una tabla 1:1, mantener la tabla relacional principal estrecha y aislar ahí las restricciones operativas del vector index. Eso es buena ingeniería de datos, no una preferencia estética.

Ahora bien, ese diseño no convierte VECTOR_SEARCH en filtered ANN. Hoy seguimos teniendo ANN global más post-filter relacional, aunque el filtro llegue por JOIN. Esa diferencia condiciona rendimiento, recall y criterio de uso. Entenderla no es un detalle menor. Es la diferencia entre usar la novedad con cabeza o descubrir, demasiado tarde, que el motor no estaba haciendo exactamente lo que tú dabas por supuesto. Y en bases de datos, como sabemos todos, dar cosas por supuestas suele salir carísimo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 0 comentarios