cloud

SQL Server Analysis Services (SSAS)

SQL Server Analysis Services (SSAS) es una de las tecnologías más robustas y flexibles para el análisis de datos en el ecosistema Microsoft. Desde su introducción en 1998 como OLAP Services (parte de SQL Server 7), ha evolucionado hasta convertirse en un pilar fundamental para la inteligencia empresarial (BI), proporcionando capacidades avanzadas para el modelado y la explotación de datos. En este artículo, os quiero introducir SSAS como herramienta, sus modelos, arquitectura y buenas prácticas para su implementación.

Introducción a SSAS

SSAS es una solución de Microsoft para la creación de modelos analíticos que permiten consultas optimizadas sobre grandes volúmenes de datos. Se integra con el ecosistema de SQL Server y herramientas como Power BI, Excel y otros clientes de BI. Su propósito es ofrecer un rendimiento excepcional en la consulta de datos y permitir cálculos complejos con una estructura optimizada.

Existen dos modos principales en los que SSAS puede operar el multidimensional y el tabular.

Modelos de SSAS: Multidimensional vs. Tabular

La elección entre los modelos multidimensional y tabular depende de diversos factores como el volumen de datos, la complejidad del análisis y la facilidad de uso.

Modelo Multidimensional (OLAP)

El clásico modelo analítico utiliza cubos y dimensiones para organizar la información de manera jerárquica. Se basa en la idea de organizar los datos en cubos OLAP (Online Analytical Processing), donde cada cubo representa un conjunto de datos preprocesados y optimizados para consultas analíticas rápidas. Estos cubos contienen medidas numéricas (como ventas o ingresos) y dimensiones (como tiempo, ubicación o producto), que permiten a los usuarios explorar la información desde múltiples perspectivas. Estos cubos pueden almacenarse como MOLAP (Multidimensional OLAP), ROLAP (Relational OLAP) o HOLAP (Hybrid OLAP). Gracias a esta arquitectura, las consultas se ejecutan con una latencia mínima, permitiendo análisis complejos como agregaciones, drill-downs y cálculos avanzados sin afectar el rendimiento de la base de datos transaccional. Por cierto, estas consultas son expresiones MDX (Multidimensional Expressions), que es el lenguaje de consulta optimizado para OLAP. 

Como ventajas del Modelo Multidimensional podemos destacar su alto rendimiento en consultas agregadas preprocesadas y el soporte avanzado para modelado complejo de datos lo que lo hacen ideal para escenarios con jerarquías bien definidas.

Como desventajas del Modelo Multidimensional tenemos una curva de aprendizaje elevada debido a la necesidad de conocer MDX y una mayor complejidad en la administración y diseño de modelos que con otras alternativas.

Modelo Tabular (In-Memory)

Un modelo tabular en SQL Server Analysis Services (SSAS) es un enfoque más moderno para el análisis de datos que utiliza una arquitectura en memoria basada en el motor VertiPaq (si, igual que Power BI), optimizado para consultas de alto rendimiento. A diferencia del modelo multidimensional, el modelo tabular almacena los datos en formato columnar en lugar de estructuras de cubo preprocesadas, lo que permite una mayor comprensión y rapidez en las consultas. Se basa en tablas y relaciones, similar a un modelo relacional, y emplea el lenguaje DAX (Data Analysis Expressions) para la creación de cálculos y medidas. Su flexibilidad y facilidad de desarrollo lo han convertido en una alternativa popular al modelo multidimensional, ya que permite una integración más sencilla con herramientas de BI como Power BI y Excel, facilitando el análisis de datos sin la complejidad de los cubos OLAP tradicionales.

Como ventajas del Modelo Tabular destacaría su mayor facilidad de desarrollo en comparación con el modelo multidimensional (DAX es más sencillo que MDX), sus excelentes tiempos de respuesta debido a su estructura en memoria y su mejor integración con herramientas modernas como Power BI.

Por el contrario, las desventajas principales del Modelo Tabular son el consumo de memoria más elevado en modelos de gran tamaño y las limitaciones en la gestión de relaciones complejas en comparación con OLAP.

Arquitectura de SSAS

SSAS opera bajo una arquitectura de servidor que permite múltiples conexiones concurrentes de usuarios y herramientas de BI. La arquitectura básica que tenemos que tener clara antes de empezar incluye la o las fuentes de datos, es decir el origen de los datos (que puede ser de SQL Server, Azure SQL Database, Oracle, Teradata, entre otros) y el modelo de datos. Obviamente estos datos se van a introducir en un modelo de datos de SSAS mediante un cubo OLAP o un modelo tabular (en estrella a poder ser 🙂).

Una vez con esto definido llega la parte del modelado. En SSAS la información se procesa y se almacena en SSAS en formatos optimizados. En este punto igual hay que hacer algunas consultas a través de MDX (para OLAP) o DAX (para modelos tabulares) para terminar de pulir detalles antes de conectar nuestros clientes BI que serán herramientas como Power BI, Excel, Reporting Services y aplicaciones personalizadas consumen los modelos de SSAS.

Prácticas recomendadas en la implementación de SSAS

Al diseñar una solución con SSAS, es importante seguir ciertas recomendaciones para garantizar rendimiento y escalabilidad. Tenemos que tener en cuenta que estas aplicaciones analíticas van a almacenar y operar con gran cantidad de datos y por tanto definir un buen modelo de datos es fundamental. Tendremos que prestar especial atención para evitar redundancias y asegurar integridad referencial. En modelos tabulares, minimizar el uso de columnas de texto para optimizar la compresión.

A la hora de optimizar el rendimiento en OLAP utilizaremos agregaciones para reducir el tiempo de consulta mientras que en modelos tabulares, buscaremos reducir la cardinalidad de las columnas para mejorar la compresión. También podemos implementar particionamiento en modelos grandes para mejorar el procesamiento.

En cuanto a seguridad, podremos configurar roles y permisos en SSAS para restringir el acceso a datos sensibles. Si queremos ir más allá tenemos también Row-Level Security en modelos tabulares para aplicar filtros por usuario.

Y para cerrar este apartado, como no podía ser de otra manera, tenemos que hablar de la monitorización del uso de memoria y CPU sobre todo en entornos productivos.

SSAS en la Nube: Azure Analysis Services

Como ha pasado con otros servicios, Microsoft también ha llevado SSAS a la nube de Azure con Azure Analysis Services (AAS), ofreciendo las mismas capacidades de modelado de datos pero con las ventajas adicionales propias de Azure. Estas son la escalabilidad dinámica según la demanda de consultas, la integración con servicios de Azure como Azure SQL Database y Azure Synapse Analytics y el modelo de pago por uso sin necesidad de administrar infraestructura.

Para organizaciones que buscan reducir costes de mantenimiento y beneficiarse de la flexibilidad de la nube, Azure Analysis Services es una excelente opción.

Conclusión

SSAS sigue siendo una herramienta clave para arquitecturas de BI en empresas de todos los tamaños. Su capacidad para manejar grandes volúmenes de datos y realizar análisis avanzados lo convierte en una opción robusta tanto en entornos on-premises como en la nube. La elección entre modelo tabular o multidimensional dependerá de los requisitos del negocio y la facilidad de integración con otras herramientas.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Power BI, 1 comentario

Fin del soporte de SQL Server 2019: ¿Qué Significa?¿Qué Cambia?

El pasado viernes 28 de febrero de 2025 marcó un hito en la historia de SQL Server 2019: finalizó su soporte estándar. Aunque todavía queda el soporte extendido hasta el 8 de enero de 2030, este cambio tiene implicaciones significativas para las empresas que aún dependen de esta versión. Además, el jueves 27 de febrero se lanzó la última Cumulative Update (CU32) para SQL Server 2019, lo que significa que ya no habrá más actualizaciones regulares para esta versión.

En este artículo, quiero aprovechar esta noticia para explicar las diferencias entre el soporte estándar y extendido, y además veremos qué implica la última CU, y analizaremos las características que han desaparecido oficialmente con SQL Server 2019.

Diferencias entre el soporte estándar y el soporte extendido

Como norma general, Microsoft ofrece dos niveles de soporte para sus productos empresariales, el soporte estándar y el soporte extendido. Cada uno tiene un propósito diferente y afecta la forma en que las empresas deben gestionar sus sistemas.

Soporte estándar: Actualizaciones y asistencia completa

El soporte estándar, que terminó el 28 de febrero de 2025 para SQL Server 2019, es el más completo y proporciona actualizaciones completas, soporte y mejoras. 

Durante este período, Microsoft lanza regularmente actualizaciones de seguridad y funcionalidad que corrigen vulnerabilidades y mejoran el rendimiento del software.

En lo relativo al soporte técnico, se ofrece asistencia gratuita por parte de Microsoft a través de distintos canales, incluyendo documentación.

Además, se publican Service Packs y Cumulative Updates con mejoras significativas en compatibilidad y rendimiento.

En resumen, durante este tiempo de soporte estándar, cualquier incidencia puede ser reportada y Microsoft trabaja activamente en resolver errores críticos y mejorar el rendimiento.

Soporte extendido: Solo parches de seguridad

A partir de ahora, SQL Server 2019 entra en la fase de soporte extendido, que dura hasta el 8 de enero de 2030. Este periodo implica cambios importantes en las actualizaciones y soporte, aunque no desaparezcan del todo.

Por ejemplo, no habrá más mejoras de funcionalidad. Las únicas actualizaciones serán parches de seguridad críticos.

En relación con el soporte técnico, la asistencia por parte de Microsoft ya no es gratuita y requiere un contrato especial.

Además, a partir de este punto ya no se garantizarán ajustes para nuevas versiones de Windows Server o entornos en la nube, es decir, la compatibilidad pasa a ser limitada.

Para las empresas que aún dependen de SQL Server 2019, esto significa que deben considerar seriamente una migración a una versión más reciente, como SQL Server 2022 o Azure SQL, para garantizar la seguridad y estabilidad de sus bases de datos.

Última Cumulative Update para SQL Server 2019

Un dia antes del fin de soporte estándar, el jueves 27 de febrero de 2025, Microsoft lanzó la última Cumulative Update (CU32) para SQL Server 2019. Es un paquete de actualización que incluye correcciones de errores, optimizaciones de rendimiento y mejoras de seguridad. Sin embargo, ahora que el soporte estándar ha terminado, no habrá más CUs regulares para SQL Server 2019.

Las empresas deben asegurarse de aplicar esta última actualización lo antes posible para garantizar que su entorno SQL Server 2019 esté en la mejor condición posible antes de entrar en la fase de soporte extendido.

Características eliminadas en SQL Server 2022

Con la llegada de SQL Server 2022, Microsoft ha eliminado algunas funcionalidades que habían sido introducidas en versiones anteriores pero que no lograron una adopción significativa. La más notable es Big Data Cluster (BDC), una solución que permitía la integración de SQL Server con entornos de big data basados en Kubernetes.

Adiós a Big Data Cluster

5 años ha durado esta característica que introdujo SQL Server 2019. La idea era buena, una solución para ejecutar cargas de trabajo analíticas en clústeres de datos distribuidos con tecnologías como Spark y HDFS. Sin embargo, con SQL Server 2022, Microsoft ha descontinuado esta característica, lo que significa que ya no hay soporte oficial para BDC. No hace falta hacer muchas conjeturas, el enemigo estaba en casa con las soluciones en la nube que Microsoft comercializa con las mismas funciones que BCD.

Por tanto, las empresas que aún dependen de Big Data Cluster deben considerar alternativas como Azure Synapse Analytics que ofrece capacidades similares para análisis de grandes volúmenes de datos, Apache Spark en Azure Databricks para entornos que necesitan procesamiento distribuido y Data Lake en Azure como repositorio de datos escalable. O, la solución más sencilla, Microsoft Fabric, con todas esas funcionalidades integradas en un mismo sistema.

¿Qué deben hacer las empresas ahora?

Con el fin del soporte estándar de SQL Server 2019 y la eliminación de características clave en SQL Server 2022, las organizaciones deben tomar decisiones estratégicas para sus entornos de base de datos. 

En primer lugar hay que aplicar la última CU de SQL Server 2019. Mientras se plantean otras opciones es clave asegurarse de que el sistema esté en la versión más reciente antes de la fase de soporte extendido.

Una vez con SQL Server con la CU 32 es el momento de evaluar una actualización a SQL Server 2022 o migrar a Azure para continuar recibiendo soporte completo y acceder a nuevas funcionalidades. Si la infraestructura lo permite, mover cargas de trabajo a la nube puede ser una opción atractiva pero, si deseamos (o necesitamos) continuar en entornos locales SQL Server 2022 es la única opción posible.

Por último, si estás utilizando Big Data Cluster es momento de comparar las alternativas en las opciones que nos da Microsoft en Azure o Fabric.

Conclusión

El fin del soporte estándar de SQL Server 2019 marca un punto de inflexión para muchas empresas. Aunque todavía quedan casi cinco años de soporte extendido, la falta de actualizaciones de funcionalidad y el coste del soporte técnico pueden hacer que la actualización a SQL Server 2022 o la migración a Azure SQL sea la mejor opción. Además, la desaparición de Big Data Cluster confirma la tendencia de Microsoft de enfocarse en soluciones más modernas en la nube para el análisis de grandes volúmenes de datos.

Es el momento ideal para planificar una estrategia de actualización y asegurarse de que la infraestructura de bases de datos esté preparada para el futuro.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Tipos de datos de texto en SQL Server

El manejo de datos de texto en SQL Server es una tarea fundamental que influye en la eficiencia del almacenamiento y en el rendimiento de las consultas. Los textos son prácticamente el tipo de datos más común pero no por ello menos importante. Elegir el tipo de dato correcto no solo optimiza el uso del espacio y mejora la velocidad de acceso, sino que también evita problemas de conversión y compatibilidad. Para ponérselo difícil, SQL Server proporciona varios tipos de datos para almacenar texto, cada uno con características específicas que los hacen adecuados para distintos escenarios.

Tipos de datos de texto en SQL Server

SQL Server ofrece distintos tipos de datos para almacenar texto. Clasificándolos en grupos podríamos hablar de los tipos de longitud fija y los de longitud variable. Además según sus características podríamos también hablar de los tipos grandes y unos que no se deberían usar porque ya están deprecados y solo se mantienen por compatibilidad. 

Tipos de longitud fija y variable

Estos tipos de datos son los más comunes en bases de datos relacionales, ya que permiten definir el tamaño del almacenamiento y optimizar el uso del espacio.

CHAR y VARCHAR

Los tipos CHAR y VARCHAR almacenan texto en formato de un solo byte por carácter, utilizando una codificación específica como Latin1_General.

El tipo CHAR siempre ocupa el número de bytes definidos en su declaración, sin importar la cantidad real de caracteres almacenados. Si se define una columna como CHAR(50), cada fila ocupará exactamente 50 bytes, rellenando con espacios si el contenido es menor. Este comportamiento es eficiente en datos de longitud fija, como códigos de país o identificadores.

Por otro lado, VARCHAR permite almacenar texto de longitud variable, reservando sólo los bytes necesarios para cada valor más un pequeño encabezado que indica la longitud. Si una columna está definida como VARCHAR(50) pero el valor almacenado solo tiene 10 caracteres, SQL Server solo reservará esos 10 bytes más los metadatos, reduciendo el desperdicio de espacio.

NCHAR y NVARCHAR

A diferencia de CHAR y VARCHAR, los tipos NCHAR y NVARCHAR utilizan Unicode, lo que les permite almacenar caracteres de múltiples alfabetos en el mismo sistema. Para poder hacer esto, cada carácter en estos tipos ocupa dos bytes en lugar de uno.

NCHAR es un tipo de longitud fija, similar a CHAR, pero con soporte Unicode. NVARCHAR, en cambio, almacena sólo los caracteres necesarios y se recomienda para datos de texto multilingües de longitud variable. Si la base de datos necesita almacenar nombres internacionales, direcciones o cualquier otro dato que pueda incluir caracteres especiales, NVARCHAR es la opción más adecuada.

Tipos de datos de texto de gran tamaño

Para almacenar grandes volúmenes de texto, SQL Server proporciona variantes especializadas de VARCHAR y NVARCHAR, así como los tipos TEXT y NTEXT, que están en desuso.

VARCHAR(MAX) y NVARCHAR(MAX)

SQL Server introdujo VARCHAR(MAX) y NVARCHAR(MAX) para permitir el almacenamiento de texto de longitud variable sin las restricciones de VARCHAR(n). Estos tipos pueden contener hasta 2 GB de datos, lo que los hace ideales para almacenar grandes documentos, descripciones extensas o datos textuales sin una longitud definida.

El motor de SQL Server optimiza el almacenamiento de estos tipos dependiendo de su tamaño. Si el contenido es menor a 8 KB, se almacena directamente en la página de datos de la tabla, al igual que VARCHAR(n). Sin embargo, si el valor excede ese límite, SQL Server lo almacena en páginas separadas (páginas LOB) y guarda una referencia en la tabla principal, lo que puede afectar el rendimiento de ciertas consultas.

TEXT y NTEXT (deprecados)

En versiones anteriores de SQL Server (pero muy antiguas), los tipos TEXT y NTEXT se utilizaban para almacenar grandes volúmenes de texto. Sin embargo, estos tipos fueron declarados obsoletos a partir de SQL Server 2005 y ya no se recomiendan para nuevas implementaciones.

El problema principal con TEXT y NTEXT es que SQL Server los trata como objetos separados de la tabla principal, lo que hace que las consultas sobre estos datos sean menos eficientes. Además, su manipulación es más compleja, ya que muchas funciones de texto estándar como LEN() o SUBSTRING() no funcionan directamente sobre estos tipos sin una conversión previa. 

Dado que VARCHAR(MAX) y NVARCHAR(MAX) ofrecen una alternativa más flexible y optimizada, se recomienda migrar cualquier columna TEXT o NTEXT a estos nuevos tipos.

Impacto del almacenamiento y rendimiento según el tipo de datos

El almacenamiento eficiente de los datos de texto es clave para el rendimiento de SQL Server. Todos los datos en SQL Server se almacenan en páginas de 8 KB, lo que significa que la elección del tipo de dato afecta la cantidad de información que cabe en cada página y, por lo tanto, la velocidad de acceso y manipulación de los datos.

Los tipos de longitud fija, como CHAR y NCHAR, pueden desperdiciar espacio si los valores almacenados son más cortos de lo esperado. Sin embargo, su acceso es más rápido en ciertos escenarios, ya que SQL Server sabe exactamente dónde empieza cada registro sin necesidad de calcular su tamaño. Esto es útil en columnas con valores homogéneos en longitud.

Los tipos de longitud variable, como VARCHAR y NVARCHAR, optimizan el uso del espacio, pero pueden introducir fragmentación en el almacenamiento, especialmente si los valores cambian de tamaño con frecuencia. En bases de datos de alto rendimiento, esto puede afectar la eficiencia de las consultas.

Por último, el uso de VARCHAR(MAX) y NVARCHAR(MAX) debe ser solo para casos puntuales e imprescindibles, ya que, cuando los valores almacenados superan los 8 KB, SQL Server los mueve a páginas de datos separadas, lo que puede ralentizar las consultas. Si es posible, es preferible definir una longitud específica en VARCHAR(n) o NVARCHAR(n) para mantener el rendimiento. Además, estos tipos de datos de gran tamaño no se pueden indexar con índices “normales” y si necesitamos filtrar por ellos tendremos que recurrir a los Full-Text Index

Conversiones de tipos de datos

Una de las mejores y a la vez peores cosas que ponen a nuestra disposición las bases de datos es la conversión implícita entre tipos de datos de texto. Mejores porque nos simplifica mucho la vida pero cuidado porque es un arma de doble filo. Todo lo que ganas en simplicidad lo pierdes en rendimiento. Cuando SQL Server compara valores con diferentes tipos, realiza conversiones automáticas que pueden afectar el rendimiento.

Si una columna está definida como VARCHAR y se compara con un valor NVARCHAR, SQL Server convierte automáticamente la columna completa a Unicode antes de ejecutar la consulta. Este proceso puede forzar un escaneo completo de la tabla en lugar de permitir el uso de índices optimizados, ralentizando significativamente las búsquedas.

Para evitar este problema, es fundamental asegurarse de que las comparaciones se realicen con tipos de datos compatibles. Si una columna es VARCHAR, los valores en las consultas deben ser también VARCHAR, y si es NVARCHAR, deben llevar el prefijo N para indicar que son Unicode.

También es importante evitar concatenaciones que provoquen conversiones innecesarias. Si una operación de concatenación involucra un valor NVARCHAR, todo el resultado se convierte a Unicode, lo que puede aumentar el uso de memoria y afectar el rendimiento.

Conclusión

SQL Server ofrece varias opciones para almacenar datos de texto, cada una con ventajas y desventajas según el escenario de uso. CHAR y NCHAR son adecuados para datos de longitud fija, mientras que VARCHAR y NVARCHAR son más eficientes para texto variable. Para grandes volúmenes de datos, VARCHAR(MAX) y NVARCHAR(MAX) proporcionan flexibilidad sin las limitaciones de los tipos TEXT y NTEXT, que ya están obsoletos.

La correcta elección del tipo de dato de texto tiene un impacto directo en el almacenamiento, la velocidad de consulta y la eficiencia del sistema. Comprender las diferencias entre estos tipos y sus implicaciones en el rendimiento es clave para diseñar bases de datos eficientes y escalables.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Permisos en SQL con grupos de AD y roles de SQL Server

La gestión de permisos en SQL Server es un aspecto fundamental para garantizar la seguridad y el acceso controlado a los datos. En entornos empresariales, lo más eficiente es utilizar grupos de Active Directory (AD) junto con roles en SQL Server para simplificar la administración y reducir la carga de trabajo asociada a la asignación individual de permisos.

Además, con la evolución de la gestión de identidades en la nube, Microsoft Entra ID (antes Azure AD) nos da la posibilidad de utilizar grupos de seguridad automáticos, lo que facilita aún más la administración de accesos en SQL Server y Azure SQL Database. En este artículo, vamos a ver como cómo combinar estas tecnologías para una gestión eficiente y segura de los permisos en SQL Server.

Uso de grupos de Active Directory en SQL Server

Cuando gestionamos el acceso a una base de datos SQL en un entorno corporativo, es una mala práctica asignar permisos directamente a usuarios individuales. En su lugar, la mejor estrategia es utilizar grupos de seguridad de Active Directory.

¿Por qué? Porque la asignación de permisos a nivel usuario no solo es más costosa sino que también más propensa a errores. Una vez que has asignado y validado los permisos a un grupo ya solo deberás añadir o quitar usuarios a ese grupo. Esto facilita enormemente tanto el alta como la baja de usuarios y permite reutilizar los grupos por los distintos servidores SQL Server de la empresa.

Creación de grupos de AD

Para una gestión correcta se pueden crear diferentes grupos en Active Directory, como por ejemplo:

  • DB_Admins: Administradores de la base de datos.
  • DB_ReadOnly: Usuarios con solo lectura.
  • DB_Editors: Usuarios con permisos de modificación.
  • DB_Backups: Grupo con permisos para realizar copias de seguridad.

Estos grupos están muy simplificados y seguramente en tu entorno empresarial debas crear bastantes más. Aquí no hay una solución correcta para todas las empresas y dependerá de tus necesidades, hay quien crea los grupos por departamento, servicio, servidor o una combinación de estos factores. Sin embargo, una de las buenas prácticas que he aplicado en estos ejemplos es seguir una nomenclatura estandarizada. Si te fijas, querido lector, todos mis grupos empiezan por DB_ lo que hace más sencillo localizarlos en el directorio activo y, de un simple vistazo, saber su finalidad. Te recomiendo combinar una nomenclatura estándar con el uso de unidades organizativas de Active Directory.

Asignación de permisos a los grupos de AD en SQL Server

Una vez creados los grupos en AD, podemos agregarlos a SQL Server y asignarles roles adecuados.

De este modo, cualquier usuario añadido al grupo de AD DB_ReadOnly tendrá acceso de solo lectura a la base de datos sin necesidad de configurar permisos individualmente en SQL Server.

Mantenimiento de accesos

La ventaja de este enfoque es que los administradores pueden gestionar accesos desde Active Directory sin necesidad de tocar SQL Server. Por ejemplo, si un empleado cambia de departamento y ya no debe acceder a la base de datos, basta con eliminarlo del grupo de AD correspondiente y no hay que tocar nada en los servidores SQL Server. Además, estos grupos también pueden llevar asociados otros permisos a nivel recursos de red como directorios compartidos o acceso a equipos.

Gestión de permisos con roles de SQL Server

SQL Server proporciona roles que permiten agrupar permisos y facilitar la administración. Podríamos decir que es el equivalente a los grupos de AD pero dentro de SQL Server. La particularidad de estos roles es que pueden ser de dos tipos, a nivel de servidor o a nivel de base de datos. 

Los roles de servidor permiten asignar permisos globales dentro de SQL Server que afecten a tareas relacionadas con la instancia como sysadmin que da acceso total, securityadmin que permite gestionar accesos y permisos, dbcreator que permite crear y modificar bases de datos o public que es el rol básico asignado a todos los logins y permite la conexión a la instancia. Un ejemplo de asignación de un grupo de AD a un rol de servidor:

Los roles a nivel de base de datos, como su propio nombre indica, se crean dentro de cada base de datos. Podemos crear nuestros propios roles o usar los roles predefinidos. Estos roles predefinidos son los que trae ya la base de datos y gestionan los permisos básicos. Tenemos db_owner para otorgar control total sobre la base de datos, db_datareader que permite leer los datos, db_datawriter que permite insertar, actualizar y eliminar datos y db_ddladmin que otorga la capacidad de modificar esquemas y objetos. 

Ejemplo de asignación de un grupo de AD a un rol de base de datos:

Además de los roles predefinidos, podemos crear roles personalizados para necesidades específicas. Es muy común, por ejemplo, necesitar los accesos solo para determinados esquemas y no toda la base de datos y, en ese caso ya no podremos usar roles predefinidos. Para crear un rol personalizado, asignar permisos y añadir miembros usaremos:

Grupos de seguridad automáticos en Entra ID

No quería cerrar este artículo sin hablar de los grupos de Entra ID (Azure Active Directory)

que básicamente es el equivalente a Active Directory en la nube de Azure. Igual que en Active directory en Entra ID vamos a poder crear grupos para asignar a nuestros usuarios y que puedan iniciar sesión en Azure SQL y Azure SQL Database además de en los SQL Server locales gracias a la integración con Azure ARC. 

Una de las ventajas que ha introducido Entra ID son los grupos de seguridad dinámicos y automáticos, lo que permite gestionar accesos sin intervención manual. Estos grupos pueden usarse para SQL Server y Azure SQL Database como hemos vistos antes y, especialmente, en entornos híbridos donde se combinan identidades locales y en la nube.

Creación de grupos dinámicos en Entra ID

Desde el portal de Entra ID, se puede configurar un grupo dinámico basado en reglas. Realmente es como un grupo normal solo que los miembros se van a añadir en base a unas reglas que definamos sobre sus propiedades. Por ejemplo, para asignar automáticamente usuarios al grupo SQL_ReadOnly si pertenecen al departamento de Finanzas:

  1. Iremos a Entra ID > Grupos y seleccionaremos Nuevo grupo.
  2. En “Tipo de grupo” elegiremos “Seguridad”
  3. En “Asignación de miembros” marcaremos la opción “Asignación dinámica de usuarios”.
  4. Aquí ya podremos definir nuestra regla, en este caso “user.department -eq «Finance»”
  5. Por último podremos hacer ya la asignación del grupo de Entra ID a SQL Server.

En Azure SQL Managed Instance o bases de datos en Azure, podemos usar Entra ID para autenticación y gestión de permisos:

Esto permite que los usuarios asignados automáticamente al grupo SQL_ReadOnly en Entra ID obtengan acceso sin intervención manual.

Ventajas de este enfoque

Como hemos visto antes, administrar permisos desde Active Directory reduce la complejidad de SQL Server y evita errores humanos al configurar accesos manualmente. Si ya lo sincronizamos con Entra ID nos permite una centralización total de la seguridad. Si hay cambios en la organización, basta con modificar los grupos en AD o Entra ID sin necesidad de tocar SQL Server. A mayores, el acceso se gestiona de manera consistente y auditable desde un único punto de control lo que minimiza riesgos de accesos indebidos.

Además con Entra ID, los permisos pueden gestionarse tanto para SQL Server on-premises como para Azure SQL, facilitando la migración a la nube y otorgando al usuario un inicio de sesión único (single sign-on) que le hará las cosas mucho más sencillas.

Conclusión

El uso de grupos de Active Directory y roles de SQL Server proporciona una forma eficiente de gestionar permisos en bases de datos. La integración con Entra ID y sus grupos de seguridad dinámicos añade una capa adicional de automatización y control, ideal para entornos híbridos o en la nube. Si implementamos estas estrategias, podemos lograr una administración más segura, flexible y escalable, reduciendo la carga administrativa y mejorando el control de accesos a nuestros datos en SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Niveles de compatibilidad de las bases de datos

Hoy me he encontrado con un caso que es más habitual del que me gustaría y quería compartirlo con vosotros y ver qué podemos aprender de él. Estaba revisando el servidor de un cliente que nunca ha tenido un DBA, era un SQL Server 2022 Standard que había montado su equipo de IT. El caso es que, aun siendo un SQL Server 2022, todas las bases de datos estaban en nivel de compatibilidad 100, es decir en el modo de funcionamiento propio de SQL Server 2008. Al preguntar, me han contado que desde su primer SQL Server 2008 su informático siempre había ido aplicando las actualizaciones y subidas de versiones cuando era necesario pero claro, no sabían que había que cambiar nada en las bases de datos. 

Este caso que os cuento no es excepcional, y muchos administradores de bases de datos han pasado por situaciones similares. Tener bases de datos en un SQL Server moderno pero con un nivel de compatibilidad antiguo es más común de lo que parece. Pero, ¿qué implica esto realmente? ¿Por qué es importante gestionar correctamente los niveles de compatibilidad? Vamos a profundizar en este tema y en las consideraciones clave antes de realizar cualquier cambio.

¿Qué es el Nivel de Compatibilidad en SQL Server?

El nivel de compatibilidad de una base de datos en SQL Server define qué conjunto de características y comportamientos del motor de base de datos están habilitados para esa base de datos en particular. Microsoft SQL Server introduce constantemente nuevas funcionalidades y mejoras en el motor de consulta con cada versión. Sin embargo, para evitar problemas de compatibilidad con aplicaciones antiguas, permite mantener una base de datos funcionando con un conjunto de reglas de versiones anteriores.

Por ejemplo, una base de datos con nivel de compatibilidad 100 (SQL Server 2008) ejecutada en un SQL Server 2022 seguirá comportándose en muchos aspectos como si estuviera en SQL Server 2008. Esto puede parecer una buena idea para garantizar que las consultas y procedimientos almacenados antiguos sigan funcionando sin problemas, pero también significa renunciar a muchas mejoras de rendimiento y nuevas funcionalidades del motor de base de datos.

¿Por qué es importante el Nivel de Compatibilidad?

El nivel de compatibilidad afecta aspectos fundamentales del comportamiento de SQL Server, incluyendo el optimizador de consultas, nuevas funciones y sintaxis de T-SQL y mejoras en la seguridad y el rendimiento general.

Como sabéis, SQL Server introduce mejoras constantes en el optimizador de consultas en cada nueva versión del producto. Mantener un nivel de compatibilidad antiguo significa que las consultas podrían no beneficiarse de los nuevos algoritmos y estrategias de ejecución de consultas. Además, algunas funciones y tipos de datos más modernos pueden no estar disponibles en niveles de compatibilidad antiguos.

En cuanto a seguridad, Microsoft mejora continuamente la seguridad en SQL Server, y algunas de estas mejoras solo están disponibles en niveles de compatibilidad más recientes. Lo mismo pasa con el rendimiento, características como Batch Mode on Rowstore, Adaptive Query Processing, Memory Grant Feedback, entre muchas otras, solo están habilitadas en niveles de compatibilidad más recientes.

El cambio clave con el Nivel de Compatibilidad 120 (SQL Server 2014)

Uno de los cambios más significativos en la historia de los niveles de compatibilidad de SQL Server ocurrió con SQL Server 2014 (Nivel 120). Microsoft rediseñó por completo el comportamiento del optimizador de consultas con la introducción del nuevo estimador de cardinalidad.

¿Qué es el estimador de cardinalidad y por qué es importante?

El estimador de cardinalidad es el componente del optimizador de consultas que predice cuántas filas se van a procesar en cada paso de una consulta. Estas predicciones, basadas entre otras cosas en las estadísticas, influyen directamente en la selección de planes de ejecución eficientes.

Con SQL Server 2014, Microsoft cambió la forma en que se estiman las filas, lo que en muchos casos mejoró el rendimiento, pero en otros, los menos, generó degradaciones inesperadas. Por eso, al cambiar el nivel de compatibilidad de 110 (SQL Server 2012) a 120 (SQL Server 2014), algunos planes de ejecución cambiaron drásticamente. Si tu base de datos aún se encuentra en un nivel de compatibilidad antiguo (110 o inferior), al actualizar a 120 o superior, es crucial revisar los planes de ejecución antes de aplicar el cambio en producción.

Impacto del Nivel de Compatibilidad 120 en los planes de mantenimiento

Otro cambio relevante con SQL Server 2014 y su nivel de compatibilidad 120 fue cómo se comportaban los planes de mantenimiento. Antes de SQL Server 2014, muchas bases de datos dependían de planes de mantenimiento que ejecutaban reconstrucción y reorganización de índices, estadísticas de actualización y otras tareas rutinarias de mantenimiento. Sin embargo, al actualizar a SQL Server 2014 con nivel de compatibilidad 120, muchos de estos procesos cambiaron significativamente debido a un nuevo comportamiento en la actualización de estadísticas

En versiones anteriores, las estadísticas se actualizaban con una heurística más básica basada en el número de cambios en los índices. A partir de SQL Server 2014, Microsoft introdujo un algoritmo mejorado que ajusta automáticamente la frecuencia de actualización de estadísticas en función de la variabilidad de los datos. Esto significa que algunos planes de mantenimiento antiguos pueden volverse ineficientes, ya que las estadísticas pueden actualizarse con menor frecuencia de lo esperado.

Cambios en la fragmentación de índices

También, antes de SQL Server 2014, los DBA solíamos programar reconstrucción y reorganización de índices en intervalos fijos. Sin embargo, con el nuevo estimador de cardinalidad, algunas consultas que antes se beneficiaban de la reconstrucción de índices ya no requieren mantenimiento tan frecuente, mientras que otras pueden necesitar ajustes más específicos.

Nuevo comportamiento en las esperas de consultas y la concesión de memoria

SQL Server 2014 introdujo Memory Grant Feedback, que ajusta dinámicamente la memoria asignada a las consultas. Este cambio afectó la manera en que los planes de mantenimiento deben ejecutarse en bases de datos de gran tamaño, ya que ahora SQL Server aprende con el tiempo y puede mejorar la asignación de memoria en ejecuciones repetitivas. Sin embargo, si por una actualización de estadísticas o mantenimiento de índices el plan se recompila todos esos cálculos ya no valen.

¿Cómo adaptar los planes de mantenimiento?

Si decides actualizar el nivel de compatibilidad a 120 o superior, es recomendable revisar y adaptar los planes de mantenimiento de la base de datos para evitar ineficiencias. Lo primero que tienes que hacer es revisar la estrategia de actualización de estadísticas.

En lugar de una actualización forzada en cada ciclo, es mejor (generalmente) dejar que SQL Server maneje esto dinámicamente. Por supuesto, siempre evalúa el impacto real en las consultas antes de aplicar actualizaciones manuales con UPDATE STATISTICS.

En cuanto a la reconstrucción de índices podemos utilizar la DMV sys.dm_db_index_physical_stats para analizar si realmente es necesario reconstruir índices. Y, como hemos dicho siempre que hablamos de mantenimiento de índices, ciertas tablas pueden beneficiarse más de una reorganización en lugar de una reconstrucción completa. Tendremos que valorar el nivel de mantenimiento en función de la fragmentación del índice.

En cualquier caso, Query Store puede ayudarnos a detectar cambios drásticos en planes de ejecución antes y después de cambiar el nivel de compatibilidad. Podemos incluso usar la opción de force plan si una consulta se ve afectada negativamente tras el cambio.

Consideraciones antes de cambiar el Nivel de Compatibilidad

A modo resumen de lo que llevamos hasta aquí, antes de modificar el nivel de compatibilidad de una base de datos, debemos hacer una serie de verificaciones y pruebas para asegurarnos de que el cambio no afectará negativamente a la operativa.

  • Analizar dependencias y compatibilidad con las aplicaciones
  • Revisar consultas y procedimientos almacenados
  • Ejecutar pruebas de rendimiento en un entorno de pruebas
  • Usar Query Store para comparar planes de ejecución
  • Ajustar planes de mantenimiento según el nuevo comportamiento de SQL Server

Cómo cambiar el Nivel de Compatibilidad

Para cambiar el nivel de compatibilidad de una base de datos en SQL Server, podemos  hacerlo desde las propiedades de la base de datos en SSMS en la pestaña “Opciones”. También lo puedes hacer utilizando la siguiente instrucción T-SQL:

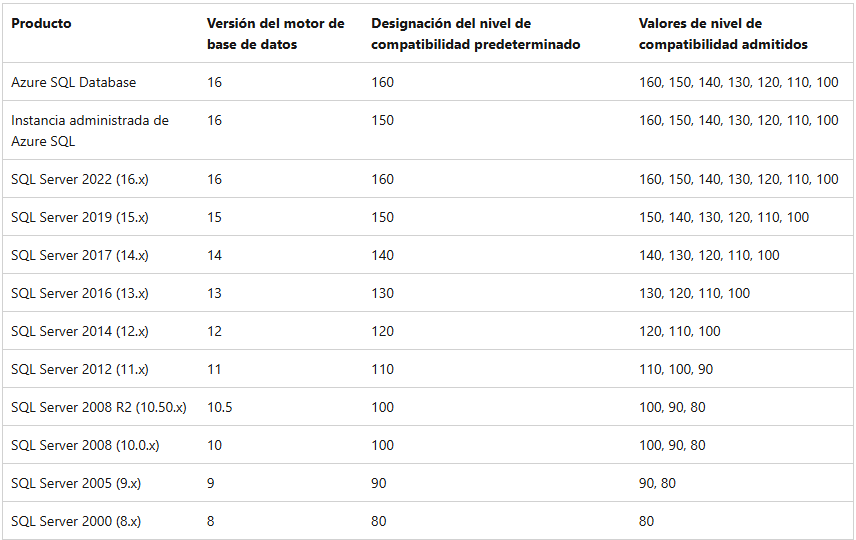
En este ejemplo 150 es para SQL Server 2019, los niveles de compatibilidad son los siguientes:

También podemos verificar el nivel de compatibilidad actual para todas las bases de datos con esta consulta:

Conclusión

El nivel de compatibilidad en SQL Server no es solo una configuración más; afecta directamente al rendimiento, comportamiento del optimizador de consultas y eficiencia de los planes de mantenimiento. Con el cambio introducido en SQL Server 2014, muchas bases de datos experimentaron transformaciones en sus planes de ejecución y rutinas de mantenimiento. Antes de hacer cualquier modificación, es clave realizar pruebas exhaustivas y ajustar estrategias de optimización. Si vamos a actualizar, hagámoslo bien y con un plan claro para minimizar riesgos y aprovechar al máximo las mejoras de SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios
¿Por qué necesitas usar AUTO_DROP en tus estadísticas?

¿Por qué necesitas usar AUTO_DROP en tus estadísticas?

Hoy vamos a hablar de una de las novedades que nos llegaron con SQL Server 2022 pero, de la que se ha hablado poco y no mucha gente conoce. Estoy hablando de la opción AUTO_DROP de las estadísticas. El objetivo de este artículo es explorar esta característica y entender cómo funciona y por qué es beneficioso para ti. 

El reto de las estadísticas manuales

Hubo un tiempo, no tan lejano, donde crear estadísticas manuales era un dolor de cabeza para cualquiera que trabajase con bases de datos SQL Server. Y principalmente era porque las estadísticas manuales eran vinculantes con el esquema. Es decir, si tu o un usuario o aplicación creabais una estadística manual en una tabla, esta estadística iba a bloquear la modificación de la estructura de la tabla. Esto era un problema a la hora de modificar o borrar columnas ya que la sola existencia de la estadística provocaba un error y requería pasos adicionales. Tenías que borrar la o las estadísticas, modificar la tabla y, después, recrear las estadísticas. Por este motivo, con estadísticas manuales, las modificaciones de tabla se convertían en un proceso manual la mayoría de las veces.

Introducción a la opción AUTO_DROP de las estadísticas

Con SQL Server 2022 llegó la opción AUTO_DROP de las estadísticas dispuesta a facilitarnos la vida un poco solucionando, en parte, el problema que mencionaba antes. En resumidas cuentas, cuando habilitamos esta opción para una estadística, esta se crea en un modo que permite que se borre automáticamente cuando se produzca una modificación de la estructura de la tabla.

Características clave de AUTO_DROP

La principal característica de esta funcionalidad es, como hemos visto, que no bloquea la estructura de la tabla. En lugar de eso, la estadística se borra automáticamente cuando es necesario. De esta manera, el comportamiento de las estadísticas manuales se equipara con el de las estadísticas creadas de manera automática por el motor de SQL Server, que también se borran cuando es necesario. 

Además, es importante destacar, que esta es una de esas pocas novedades que SQL Server activa por defecto para todas las bases de datos por lo que si quieres mantener el comportamiento como hasta ahora deberás desactivarlo manualmente.

Buenas prácticas y consideraciones

Ten en cuenta que las estadísticas creadas automáticamente por el motor de base de datos siempre usan la opción AUTO_DROP y no se les puede deshabilitar, si intentas cambiarlo te va a dar error. Esta opción solo está disponible para las estadísticas creadas manualmente y, en bases de datos con nivel de compatibilidad 160, estará activada de manera predeterminada, esto aplica para todas las bases de datos creadas en este nivel de compatibilidad pero también para las que hayas migrado de versiones anteriores. Ten en cuenta este comportamiento y desactívalo si lo deseas. 


¿Cómo usar la opción AUTO_DROP?

A la hora de crear una estadística manual podemos definir si queremos o no habilitar la opción AUTO DROP. Por ejemplo, este comando crea una estadística con AUTO_DROP:

Para crear una estadística SIN AUTO_DROP usaremos este:

Si lo que quieres es cambiar la opción AUTO_DROP en una estadística existente puedes hacerlo también. Esta vez con UPDATE STATISTICS. Por ejemplo este sería el script para activar AUTO_DROP en una estadística que no lo tenga.

Para desactivarlo solo cambia el ON del final por un OFF

Para consultar la configuración AUTO_DROP de nuestras estadísticas podemos hacerlo con la vista sys.stats.

Os comparto también un último script para generar automáticamente estos últimos de cambiar la opción AUTO_DROP para todas las estadísticas de usuario.

Conclusión

En conclusión, la opción AUTO_DROP de las estadísticas en SQL Server 2022 representa un avance significativo en la gestión de estadísticas manuales. Su implementación permite reducir la fricción en la modificación del esquema de las tablas, eliminando automáticamente las estadísticas cuando ya no son relevantes. Esto no solo simplifica la administración de la base de datos, sino que también evita errores comunes y la necesidad de procesos manuales adicionales.

Si bien esta funcionalidad está activada por defecto en bases de datos con nivel de compatibilidad 160, es importante conocer su impacto y decidir si se desea mantener o desactivar en cada caso. Al final, la correcta gestión de las estadísticas sigue siendo clave para optimizar el rendimiento de las consultas y garantizar un mantenimiento eficiente de nuestras bases de datos en SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Azure Data Studio ha muerto. Larga vida a VS Code.

El pasado 6 de febrero de 2025, Azure Data Studio (ADS) dejaba de recibir soporte y actualizaciones. Aunque se mantendrá operativo hasta el 28 de febrero de 2026, Microsoft ha dejado claro que el futuro del desarrollo SQL pasa por Visual Studio Code (VS Code) con la extensión MSSQL.

Este anuncio marca el fin de una era para quienes han utilizado ADS como su herramienta principal de administración y desarrollo SQL. Sin embargo, lejos de ser una mala noticia, este cambio representa una evolución lógica hacia un entorno más moderno, flexible y potente.

Hoy voy a desgranar qué significa el fin de Azure Data Studio, cómo afecta a los desarrolladores y DBAs, y por qué VS Code es el camino a seguir.

¿Por qué Microsoft ha decidido matar Azure Data Studio?

Azure Data Studio nació como una alternativa ligera y multiplataforma a SQL Server Management Studio (SSMS), con una interfaz moderna, soporte para notebooks y conectividad con Azure. Durante años, fue una herramienta fundamental para administradores de bases de datos y desarrolladores SQL, más bien para estos segundos, que buscaban una solución ágil.

Sin embargo, VS Code ha evolucionado hasta el punto de haber alcanzado en funcionalidad a ADS. Consolidar todo en un único entorno de desarrollo reduce la fragmentación y permite concentrar esfuerzos en una sola plataforma.

Motivos clave detrás de la migración a VS Code

Principalmente, como ya he comentado, VS Code ha mejorado tanto que ya hace todo lo que hacía ADS y más.

Con la extensión MSSQL, VS Code soporta conexiones a SQL Server, Azure SQL Database y Fabric. Pero no solo conectar, obviamente permite ejecutar consultas, visualizar esquemas, exportar resultados y administrar bases de datos con una experiencia optimizada.

Además, en VS Code tenemos a nuestra disposición herramientas avanzadas como Table Designer, Query Execution Plans y scripting.

Menos fragmentación, más velocidad de innovación

Por supuesto, mantener dos herramientas similares implica duplicar esfuerzos. Esto es otro de los principales motivos para consolidar todo en VS Code. De esta manera, Microsoft acelera el desarrollo de nuevas funcionalidades y se eliminan inconsistencias entre ADS y VS Code, asegurando que todos los usuarios tengan acceso a las últimas mejoras.

Integración total con el ecosistema DevOps y CI/CD

A día de hoy VS Code es la herramienta más utilizada por desarrolladores de software. Su ecosistema de extensiones permite integrar bases de datos con herramientas de DevOps, CI/CD y control de versiones. Microsoft está apostando por una experiencia SQL que encaje dentro del mundo cloud-native y automatizado.

¿Qué ofrece VS Code con la extensión MSSQL?

Si aún no has probado VS Code como entorno SQL, te sorprenderá lo completa que es su experiencia con la extensión MSSQL.

Como funciones destacadas de VS Code para SQL Server podemos encontrar el soporte para filtrado, ordenación y exportación a JSON, CSV y Excel. También la administración visual de bases de datos gracias a las herramientas Object Explorer y Table Designer que nos permiten gestionar esquemas sin escribir código. En cuanto a las herramientas de optimización del rendimiento SQL tenemos un visualizador de planes de ejecución de consultas. 

Por último, pero importante tenemos el soporte para DevOps y CI/CD especialmente pensado para proyectos de bases de datos SQL para integración con pipelines de despliegue. Esto es totalmente compatible con herramientas de control de versiones y automatización como Git o Azure DevOps.

Y no olvidemos que es extensible y personalizable, ya fuera de lo que es SQL tiene miles de extensiones disponibles en el marketplace de VS Code con soporte para Python, PowerShell, Bash, Kubernetes y más, todo en el mismo entorno.

Cómo migrar de Azure Data Studio a VS Code

Microsoft ha asegurado que la transición de Azure Data Studio a VS Code será sencilla, ya que casi todas las funcionalidades de ADS ya están disponibles en VS Code con la extensión MSSQL. 

Para la migración lo primero que debemos hacer, obviamente, es descargar e instalar VS Code. Una vez hecho esto deberemos instalar la extensión MSSQL ya sea desde el Marketplace de Extensiones (buscando «SQL Server (mssql)») o con este comando en la barra de búsqueda de comandos de VS Code:

Con todo instalado es el momento de configurar las conexiones a bases de datos Usa la opción «Agregar conexión» para configurar tus servidores SQL Server o Azure SQL.

Puedes trasladar manualmente tus conexiones de ADS sin necesidad de migración de datos. 

Por último, si usabas notebooks Jupyter, puedes instalar la extensión de Jupyter en VS Code. 

Y si eres administrador de bases de datos o necesitas funcionalidades avanzadas para SQL Server Agent y Schema Compare, existen alternativas dentro de SQL Projects y herramientas de terceros. Esto no es lo ideal pero, es lo mismo que nos pasaba en ADS y el motivo por el que, al menos de momento, yo sigo prefiriendo SSMS para trabajar.

Preguntas frecuentes sobre la transición

A continuación os respondo algunas de las preguntas que he visto sobre el tema de la desaparición de Azure Data Studio

¿Pierdo funcionalidades si dejo de usar Azure Data Studio?

No realmente. VS Code con MSSQL Extension cubre casi todas las funcionalidades de ADS, y en muchos casos, las mejora. Es cierto que no tiene todas las opciones que nos da SSMS pero es que ADS tampoco las tenía.

¿Mis scripts y consultas seguirán funcionando en VS Code?

Sí. No necesitas modificar nada. Lo que cambia es la herramienta de conexión pero los scripts SQL que ejecutabas en ADS funcionan sin problemas en VS Code porque vas a usar los mismos servidores.

¿Qué pasa si no quiero cambiarme de ADS?

¿Eres un rebelde y te gusta ir contracorriente? No pasa nada, puedes seguir usándo ADS hasta febrero de 2026, pero ya no recibirás actualizaciones ni soporte. El cambio es inevitable amigo.

Conclusión

Azure Data Studio nos ha servido bien, pero VS Code representa el futuro del desarrollo SQL. Con una comunidad activa, actualizaciones constantes y una integración más fluida con herramientas modernas, VS Code con MSSQL Extension es la mejor alternativa para administrar bases de datos SQL. Si aún no has probado VS Code, este es el momento perfecto para hacer la transición y aprovechar todas sus ventajas. Yo prometo hacer pronto un video en mi canal de youtube explicando la interfaz.

Para más información, consulta la documentación oficial.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios