cloud

Deadlock Priority

Uno de los problemas más temidos por usuarios y administradores de bases de datos son los deadlocks. Cuando varias transacciones acceden a los mismos recursos al mismo tiempo, el riesgo de bloqueos, y en particular de deadlocks, aumenta considerablemente. En estos casos, la prioridad de deadlock, o Deadlock Priority, se convierte en una herramienta esencial para evitar que procesos críticos se vean interrumpidos cuando SQL Server elige qué transacción finalizar. Antes de profundizar en este concepto, es importante entender qué es un deadlock y cómo afecta al rendimiento en SQL Server.

Qué es un deadlock en SQL Server

Deadlock PriorityUn deadlock ocurre cuando dos o más transacciones quedan atrapadas en un ciclo de espera mutua porque cada una está bloqueando recursos que la otra necesita. Ninguna puede continuar hasta que la otra libere el recurso, lo que genera un bloqueo indefinido. En estos casos, SQL Server interviene para romper el ciclo seleccionando una transacción como «víctima». SQL entonces finalizará la transacción victima para liberar los recursos y permitir que la otra continúe.

Para entender este fenómeno de manera más clara, es útil recurrir a un ejemplo clásico de la teoría de la concurrencia: la paradoja de la cena de los filósofos.

La paradoja de la cena de los filósofos y la concurrencia

La paradoja de la cena de los filósofos es un experimento mental creado para ilustrar los problemas que surgen cuando varios procesos (o personas, en este caso) intentan acceder simultáneamente a recursos compartidos de manera descoordinada. Imaginemos a cinco filósofos sentados alrededor de una mesa redonda. En la mesa, hay un plato de comida frente a cada uno, pero solo hay cinco tenedores disponibles, uno entre cada dos filósofos. Para comer, cada filósofo necesita dos tenedores: uno en la mano izquierda y otro en la mano derecha. Lo sé no tiene sentido necesitar dos tenedores pero es que esta es una adaptación de una teoría original de china donde hablan de palillo, para el caso da igual. 

Ahora, supongamos que cada filósofo sigue la misma estrategia: primero toma el tenedor de su izquierda y luego el de su derecha. El problema surge si todos los filósofos deciden tomar el tenedor de su izquierda al mismo tiempo. Cada uno tomará un tenedor, pero quedarán esperando indefinidamente a que el filósofo de su derecha libere el otro tenedor. Nadie podrá comer y todos estarán bloqueados.

Este es un ejemplo claro de deadlock. Cada filósofo (o transacción, en el contexto de SQL Server) tiene un recurso y está esperando por otro que está siendo utilizado por otro filósofo. Esto es básicamente, un ciclo de espera sin fin.

¿Cómo esta paradoja refleja los problemas de deadlock en SQL Server?

En SQL Server, la situación es muy similar. Las transacciones actúan como los filósofos de la historia, y los recursos, como los tenedores, son elementos que las transacciones necesitan para completarse. Cuando dos transacciones intentan acceder a los mismos recursos de manera descoordinada, pueden quedar bloqueadas de forma indefinida. En estos casos, el servidor debe intervenir para resolver el conflicto.

La solución en la paradoja de los filósofos sería introducir un mecanismo de coordinación, asegurando que no todos los filósofos intenten tomar el mismo tenedor al mismo tiempo. De manera similar, en SQL Server, es fundamental implementar estrategias que eviten los deadlocks, como el uso de la configuración de Deadlock Priority.

Configurando Deadlock Priority para gestionar los conflictos

SQL Server nos permite influir en la decisión de qué transacción finalizar cuando ocurre un deadlock mediante la instrucción SET DEADLOCK_PRIORITY. De este modo, asignaremos una prioridad a cada sesión gracias a esta configuración, con lo que, podremos influir sobre su probabilidad de ser finalizada en caso de un deadlock. Las prioridades van desde -10 (más susceptible a ser finalizada) hasta 10 (menos susceptible) o, también, con valores predefinidos como LOW, NORMAL y HIGH.

Por ejemplo, si estamos ejecutando una transacción crítica que no debe interrumpirse, podemos asignarle una prioridad alta:

De este modo, le estamos indicando a SQL Server que esta transacción debe ser protegida en caso de conflicto. Por otro lado, si tenemos una transacción menos importante, podemos asignarle una prioridad baja:

Esto asegura que, si se produce un deadlock, SQL Server finalizará primero la transacción con prioridad baja.

SQL Server y la toma de decisiones automáticas ante deadlocks

Aunque la prioridad de deadlock nos ofrece mayor control sobre qué transacciones sobrevivirán en caso de conflicto, no garantiza que una transacción nunca será finalizada. SQL Server sigue considerando otros factores, como el costo de finalizar una transacción, antes de decidir cuál terminar. 

A lo largo de mi experiencia como DBA he escuchado teorías de lo más locas sobre esta elección de víctima en caso de deadlock. Desde que las transacciones ejecutadas por job tienen una prioridad más baja hasta que existe un sistema interno de reputación de usuarios. Nada de esto es cierto, por lo menos atendiendo a la documentación oficial. Cualquier transacción que no tenga especificada una prioridad distinta es tratada como de prioridad normal. En caso de colisión, si ambas transacciones tienen la misma prioridad, el servidor seleccionará aquella que sea más barata de finalizar. Es decir, en la que haya realizado menos cambios y por tanto tenga menos que revertir o que tenga menor impacto en el sistema. 

Por esta razón, la prioridad de deadlock debe usarse como parte de una estrategia más amplia para gestionar la concurrencia y los bloqueos en SQL Server.

Optimización del rendimiento mediante el control de deadlocks

Aunque la configuración de Deadlock Priority es una herramienta útil, no debe ser nuestra única estrategia para evitar deadlocks. Una parte crucial de la prevención de bloqueos mutuos es optimizar las consultas para reducir el tiempo durante el cual mantienen bloqueados los recursos. Las transacciones que se completan rápidamente tienen menos probabilidades de verse envueltas en deadlocks, ya que liberan los recursos antes de que otras transacciones los necesiten.

Además, es importante diseñar los flujos de acceso a los recursos de manera coherente. Una técnica efectiva es garantizar que todas las transacciones sigan un orden predefinido al acceder a los recursos. Esto reduce significativamente la probabilidad de un ciclo de espera, similar a cómo los filósofos podrían ponerse de acuerdo en quién toma primero los cubiertos.

Monitorización y detección de deadlocks en SQL Server

Es fundamental que monitoricemos activamente los deadlocks en SQL Server para detectar patrones repetidos de bloqueo y ajustar nuestras configuraciones de prioridad de manera adecuada. Las herramientas de SQL Server, como los eventos extendidos (Extended Events) y las vistas de administración dinámica (DMVs), nos permiten identificar qué transacciones están causando los bloqueos y analizar sus causas.

Si notamos que una transacción crítica está siendo seleccionada frecuentemente como víctima de deadlocks, es posible que debamos ajustar su prioridad o revisar cómo accede a los recursos. Una monitorización continua nos ayuda a mantener un sistema fluido y a identificar posibles problemas antes de que afecten de manera significativa al rendimiento.

Conclusión

La configuración de Deadlock Priority en SQL Server es una herramienta eficaz para gestionar la concurrencia y evitar que procesos críticos sean interrumpidos en caso de deadlocks. Sin embargo, no debemos confiar únicamente en esta configuración. Los deadlocks suelen ser un síntoma de una planificación ineficiente de las transacciones o de un acceso mal gestionado a los recursos. Para minimizar su ocurrencia, es necesario combinar la configuración de prioridad con una estrategia de optimización de consultas y un monitoreo constante.

De este modo, no solo reducimos la probabilidad de deadlocks, sino que también garantizamos que las transacciones críticas se ejecuten sin interrupciones, asegurando un rendimiento óptimo en nuestro sistema SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Columnstore vs VertiPaq

Cuando gestionamos grandes volúmenes de datos, hay dos tecnologías de almacenamiento que suelen ser las principales protagonistas: el Columnstore de SQL Server y VertiPaq, el motor de almacenamiento de Power BI. Ambas tecnologías están diseñadas para optimizar el procesamiento de datos en entornos de análisis, pero lo hacen utilizando enfoques y arquitecturas diferentes. En este artículo, veremos en profundidad las similitudes y diferencias entre estas dos tecnologías, considerando aspectos como el rendimiento, la eficiencia en la compresión de datos y las características de uso que determinan su idoneidad para diferentes escenarios.

Antes de iniciar, es de justicia reconocer los méritos y es que, este artículo no habría sido posible sin el whitepaper “Vertipaq vs Columnstore” escrito por Alberto Ferrari de sqlbi que podéis descargar completo desde aquí. Es un documento con más de 12 años de antigüedad y casi 30 páginas dedicado a comparar el rendimiento entre ambas tecnologías del motor xVelocity introducido en  SQL Server 2012 para SQL Server y SSAS.

Columnstore de SQL Server: Desempeño y optimización

Los índices Columnstore en SQL Server son una solución avanzada que almacena datos en columnas en lugar de filas. Esta disposición mejora la compresión y reduce la cantidad de E/S necesaria para ejecutar consultas analíticas, especialmente en entornos de data warehousing. Sin embargo, el rendimiento del Columnstore no es uniforme en todos los escenarios. Por ejemplo, en consultas simples de agregación, SQL Server puede no aprovechar automáticamente los beneficios del índice Columnstore, requiriendo ajustes en las consultas para forzar el uso de este índice y lograr un rendimiento óptimo​.

En términos de tiempo de procesamiento, la reconstrucción completa de un índice Columnstore es significativamente más rápida que el procesamiento de una base de datos en Analysis Services con VertiPaq, lo que puede ser un factor decisivo en entornos donde la velocidad de procesamiento es crítica​.

VertiPaq en Power BI: Un motor de almacenamiento revolucionario

VertiPaq, utilizado por Power BI y SQL Server Analysis Services (SSAS) en su modalidad Tabular, está optimizado para el uso en memoria, ofreciendo una capacidad de respuesta excepcional al ejecutar análisis complejos en tiempo real. Su modelo de compresión en memoria permite cargar grandes volúmenes de datos y mantener una alta eficiencia en la ejecución de consultas. Además, VertiPaq maneja cálculos a nivel de hoja de manera extremadamente eficiente, superando en muchos casos al Columnstore en operaciones como conteos distintos y cálculos ponderados​.

No obstante, VertiPaq requiere que todo el modelo de datos esté en memoria, lo que puede ser una limitación si se trabaja con conjuntos de datos que superan la capacidad de la RAM disponible. En estos casos, SQL Server con Columnstore podría ser más adecuado, ya que SQL puede manejar de manera dinámica los datos en memoria, cargando y descargando información según sea necesario​.

Almacenamiento en columnas vs. almacenamiento en filas

Según acabamos de ver, el almacenamiento en columnas (ya sea en memoria como en VertiPaq o en disco como Columnstore) mejora el rendimiento de las consultas analíticas pero, seguro que os estáis preguntando por qué.

Sin entrar en detalle de bajo nivel que complicarían este artículo más de lo necesario, esta mejora es debida a la manera en que los datos se organizan y se acceden en este tipo de almacenamiento. 

En un sistema de almacenamiento tradicional basado en filas, como el que se utiliza en muchas bases de datos relacionales, los datos de todas las columnas de una fila se almacenan juntos en disco. Esto significa que cuando se realiza una consulta que necesita acceder a una o dos columnas específicas, el sistema tiene que leer la fila completa desde el disco, incluso si solo se necesita un subconjunto de las columnas.

Por el contrario, en un sistema de almacenamiento en columnas, los datos de cada columna se almacenan por separado. Es decir, todas las entradas de una columna se almacenan juntas. Esta estructura permite que las consultas que solo necesitan acceder a ciertas columnas puedan hacerlo de manera más eficiente, leyendo sólo los datos relevantes desde el disco.

Similitudes entre el Columnstore de SQL y VertiPaq de Power BI

Ambas tecnologías comparten un enfoque basado en columnas, lo que permite una compresión eficiente y un uso optimizado del almacenamiento. Además, tanto Columnstore como VertiPaq están diseñados para maximizar el rendimiento en consultas analíticas, lo que los hace ideales para entornos donde se requiere procesar grandes volúmenes de datos rápidamente. En ambos casos, la compresión de datos no solo reduce el espacio de almacenamiento, sino que también mejora la velocidad de las consultas, ya que se reduce la cantidad de datos a procesar​, como ya hemos visto en el apartado anterior.

Diferencias clave entre Columnstore y VertiPaq

A pesar de las similitudes, las diferencias entre Columnstore y VertiPaq son notables en varios aspectos. Por ejemplo, Columnstore se desempeña mejor en escenarios donde se aplican filtros a los datos, lo que le permite superar a VertiPaq en términos de velocidad cuando se trata de consultas que no requieren un escaneo completo de la tabla​.

Por otro lado, VertiPaq sobresale en operaciones que involucran cálculos complejos y conteos distintos, ofreciendo un rendimiento superior en estos casos debido a las optimizaciones inherentes a su motor de cálculo. Además, VertiPaq ofrece una rica capa de metadatos que facilita la creación de modelos de datos complejos y la implementación de medidas calculadas, lo que puede ser un punto decisivo en proyectos donde la facilidad de uso y la integración con herramientas de usuario final son importantes​.

Otra diferencia significativa es cómo cada tecnología maneja las relaciones muchos-a-muchos. VertiPaq maneja estas relaciones de manera extremadamente eficiente, lo que lo convierte en una opción superior en escenarios donde este tipo de relaciones son comunes. Columnstore, aunque también es competente en este aspecto, puede no igualar la velocidad de VertiPaq en todos los casos​.

Consideraciones adicionales

Más allá del rendimiento en consultas, es importante considerar otros factores como el tiempo de procesamiento y el uso de memoria. Como os he mencionado antes, Columnstore ofrece un tiempo de procesamiento significativamente más rápido al reconstruir índices, mientras que VertiPaq requiere que todo el modelo de datos esté en memoria, lo que puede ser una limitación en entornos con recursos de memoria limitados​.

Además, el uso de la caché en VertiPaq mejora significativamente el rendimiento en escenarios donde las mismas consultas se ejecutan repetidamente, ya que los resultados se almacenan en caché y se pueden recuperar rápidamente sin necesidad de volver a ejecutar la consulta completa​. En contraste, SQL Server no almacena en caché los resultados, lo que puede llevar a tiempos de respuesta más largos en consultas repetitivas.

Columnstore o VertiPaq, ¿cuál es mejor?

La elección entre el Columnstore de SQL Server y VertiPaq de Power BI depende en gran medida del entorno y las necesidades específicas de cada proyecto. VertiPaq, con su motor de almacenamiento en columnas altamente optimizado para el análisis en memoria, es ideal para escenarios donde necesitemos un rendimiento elevado en cálculos complejos y agregaciones, y donde los datos puedan ser cargados completamente en memoria. Su capacidad para manejar eficientemente consultas analíticas y ofrecer una rica capa de metadatos lo hace especialmente adecuado para modelos de análisis interactivos y ágiles en Power BI.

Por otro lado, el índice Columnstore de SQL Server brilla en entornos donde los datos no pueden ser completamente cargados en memoria, o donde necesitamos actualizaciones y escrituras frecuentes en grandes volúmenes de datos. Si bien el Columnstore también nos ofrece un almacenamiento basado en columnas, su integración con SQL Server permite un manejo más dinámico de la memoria, lo que es ventajoso en escenarios donde el tamaño del conjunto de datos excede la capacidad de la memoria disponible. Además, su capacidad para filtrar y procesar datos de manera eficiente en consultas específicas lo convierte en una opción poderosa para mejorar el rendimiento en bases de datos relacionales que manejan grandes volúmenes de datos.

En el contexto de Power BI, si bien no podemos usar directamente los índices Columnstore de SQL Server, podemos optar por usar DirectQuery para trabajar con datos en SQL Server y aprovechar esos índices. Sin embargo, esto puede implicar un compromiso en términos de rendimiento, debido a la latencia de la red, y funcionalidad (no todas las funciones DAX están disponibles en DirectQuery) en comparación con un modelo de datos totalmente importado y gestionado por VertiPaq.

Conclusión

En resumen, VertiPaq es la opción preferida cuando se necesita un rendimiento extremo en análisis interactivo y la memoria es suficiente para manejar los datos. El Columnstore de SQL Server, por su parte, es más adecuado en escenarios donde la gestión eficiente de grandes volúmenes de datos en disco es crítica, y se requiere flexibilidad en las operaciones de escritura y actualización. Debemos comprender las fortalezas y limitaciones de cada tecnología es fundamental para que podamos tomar las mejores decisiones informadas y, así, optimizar el rendimiento de nuestras soluciones analíticas en función de los requisitos específicos del proyecto.


Publicado por Roberto Carrancio en Índices, Power BI, Rendimiento, SQL Server, 0 comentarios

Operadores Spool en planes de ejecución

Una de las primeras cosas que hacemos, o por lo menos que deberíamos hacer, cuando estamos analizando el rendimiento de una consulta es mirar su plan de ejecución. En los planes de ejecución vemos paso a paso y gráficamente lo que hace nuestra consulta. Cada uno de estos pasos de los que hablamos está representado gráficamente por un operador y la mayoría son intuitivos y fáciles de comprender pero hay un tipo en concreto que parece que cuesta un poco más. Me refiero como no podía ser de otra manera a los operadores Spool. Estos componentes pueden marcar la diferencia en términos de eficiencia y tiempo de respuesta de las consultas. En este artículo, profundizaremos en los diferentes tipos de Spool, su propósito, cómo funcionan y cuándo deberíamos prestarles atención.

¿Qué es un operador Spool?

Antes de entrar en detalles, es importante entender qué es un operador Spool. Básicamente, son operadores que almacenan temporalmente un conjunto de filas durante la ejecución de una consulta. Este almacenamiento permite que SQL Server reutilice estos datos en lugar de volverlos a calcular o volver a leerlos desde el disco, lo que puede resultar en una mejora significativa del rendimiento en determinadas situaciones. Existen varios tipos de operadores spool en SQL Server y, aunque todos comparten la definición que hemos mencionado, cada uno tiene sus particularidades. 

Table Spool

El «Table Spool» es el tipo de Spool más común en SQL Server. Su objetivo principal es almacenar el resultado de una subconsulta o una parte del plan de ejecución que es probable que se reutilice. Este tipo de operador suele aparecer cuando tenemos consultas que requieren repetir una operación costosa varias veces. Por ejemplo, si una subconsulta se ejecuta en múltiples ocasiones dentro de una misma consulta, SQL Server puede decidir almacenar temporalmente el resultado de esa subconsulta en un Table Spool para evitar esas múltiples ejecuciones.

Un detalle importante a considerar es que, aunque el Table Spool puede reducir el tiempo de ejecución en general, también consume memoria temporal para almacenar los datos, lo que podría impactar en la eficiencia si el tamaño del Spool es considerablemente grande.

Index Spool

El «Index Spool» se utiliza cuando SQL Server anticipa que necesitará un índice temporal para mejorar la búsqueda de datos en una consulta específica. Este operador crea un índice en memoria, que puede ser utilizado para acelerar operaciones como JOINs o búsquedas basadas en condiciones de filtrado. Aunque esta operación añade un paso adicional al plan de ejecución, la creación de un índice temporal puede resultar en un rendimiento significativamente mejorado, especialmente en consultas que trabajan con grandes volúmenes de datos.

La clave para entender el impacto de un Index Spool está en el balance entre el coste de crearlo y los beneficios que aporta en la fase de búsqueda. En escenarios donde se ejecutan varias búsquedas en un conjunto de datos sin un índice adecuado, este operador se convierte en una solución efectiva.

Row Count Spool

El «Row Count Spool» es un tipo de operador que se emplea principalmente para controlar el número de filas que se procesan en una operación. A diferencia de los Spool anteriores, este no almacena datos per se, sino que mantiene un conteo de las filas que pasan a través de él. Este operador suele aparecer en situaciones donde se requiere un número preciso de filas como resultado de una subconsulta, como cuando usamos la cláusula TOP o una condición de filtrado que limita las filas a procesar.

En resumen, este operador actúa como un portero de discoteca que asegura que solo pasen el número exacto de filas necesarias. Es especialmente útil en operaciones que pueden generar un gran número de filas intermedias, pero donde solo se necesita un subconjunto de ellas. Así, el Row Count Spool ayuda a evitar el procesamiento innecesario, optimizando el rendimiento de la consulta.

Window Spool

El «Window Spool» es menos común pero no menos importante. Este tipo de operador se emplea principalmente en consultas que utilizan funciones de ventana, como ROW_NUMBER(), RANK() o LEAD(). El propósito del Window Spool es soportar el cálculo de estas funciones, almacenando temporalmente el conjunto de datos sobre el cual se aplicarán las funciones de ventana.

Las funciones de ventana requieren acceso a un conjunto completo de datos para calcular correctamente sus resultados. El operador Window Spool permite que SQL Server mantenga un «almacén» de estas filas mientras las operaciones de ventana se ejecutan, garantizando así que el resultado sea el esperado. Aunque puede añadir cierta sobrecarga en términos de memoria, su beneficio en la correcta ejecución de funciones analíticas es crucial.

Optimización y uso

Entender cuándo y cómo aparecen los Spool en los planes de ejecución es vital para optimizar el rendimiento de nuestras consultas. Si bien estos operadores pueden mejorar la eficiencia en muchos casos, su uso inadecuado o innecesario puede tener el efecto contrario. Es fundamental analizar los planes de ejecución y evaluar si la presencia de un Spool está realmente justificada en base al coste adicional que implica su utilización.

En algunos casos, podríamos encontrar que la eliminación de un Spool innecesario, ya sea mediante la reescritura de la consulta o ajustando los índices, resulta en un rendimiento superior. También es importante recordar que estos operadores suelen consumir memoria temporal, por lo que su impacto en la carga general del sistema debe ser monitorizado de cerca.

Recursión

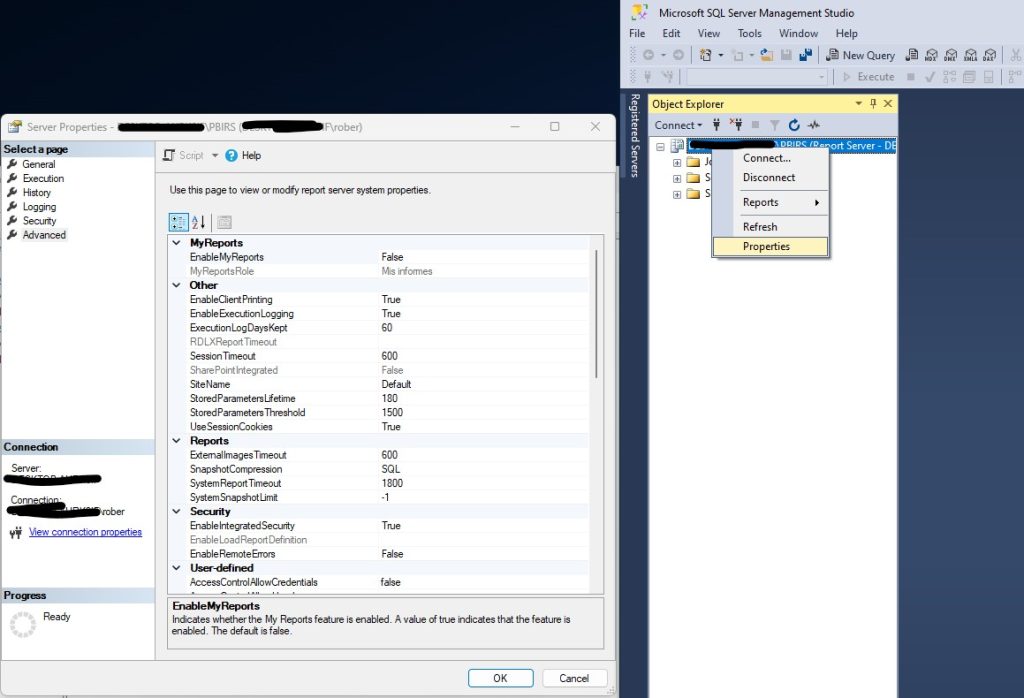
Las consultas recursivas son un ejemplo de la necesidad de operadores Spool. En una consulta recursiva típica, SQL Server tiende a utilizar dos tipos de Spool que resultan esenciales para su correcto funcionamiento y optimización: el Table Spool y el Index Spool.

Spool en recursividad

Table Spool en recursividad

Al principio de una consulta recursiva, SQL Server suele emplear un Table Spool. Este operador, como hemos visto, se utiliza para almacenar el conjunto inicial de filas que formarán la base de la recursión, conocido como la parte ancla en un CTE recursivo. La función principal de este operador es capturar estas filas iniciales para que puedan ser reutilizadas a lo largo de las iteraciones recursivas sin necesidad de recalcular o volver a leer los datos desde el origen.

Este Table Spool es especialmente útil en este contexto porque permite que el proceso recursivo se inicie de manera eficiente, asegurando que las filas base estén disponibles para las iteraciones subsiguientes sin añadir un coste significativo de I/O o de CPU. Este operador se convierte en un «almacén temporal» que facilita la generación de los resultados recursivos de manera escalable.

Index Spool en recursividad

En la fase final de la recursión, cuando se procesan y ordenan los resultados, SQL Server suele introducir un Index Spool. Este operador crea un índice temporal en memoria sobre el conjunto de datos generado durante la recursión. La finalidad de este índice es acelerar la búsqueda y ordenación de los datos, especialmente en consultas que requieren un orden específico o que deben cumplir con condiciones adicionales de filtrado.

El Index Spool optimiza la fase de finalización de la consulta recursiva, permitiendo que SQL Server gestione grandes volúmenes de datos generados por la recursión de manera más eficiente. La creación de este índice temporal puede ser costosa en términos de memoria y CPU, pero su impacto positivo en el rendimiento de la consulta suele justificar su utilización, especialmente en estructuras de datos jerárquicas complejas.

Conclusión

Los operadores Spool en SQL Server son herramientas poderosas que, cuando se utilizan correctamente, pueden mejorar significativamente el rendimiento de nuestras consultas. Desde el Table Spool, que almacena datos para evitar cálculos repetidos, hasta el Window Spool, que soporta funciones analíticas, cada tipo de Spool tiene un propósito específico y un impacto en la forma en que SQL Server procesa las consultas.

Para sacar el máximo provecho de los Spool, es esencial comprender cómo y cuándo aparecen en los planes de ejecución y evaluar su eficacia en cada caso. Aunque estos operadores pueden añadir complejidad al plan de ejecución, su correcta utilización puede ser la clave para lograr un rendimiento óptimo en SQL Server.

En definitiva, los Spool no son solo un detalle técnico, sino una pieza fundamental en la optimización avanzada de consultas. Con el conocimiento adecuado, podemos utilizarlos para transformar consultas lentas en operaciones altamente eficientes, maximizando el rendimiento de nuestras bases de datos.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario

Buenas prácticas en Power BI Report Server (PBIRS)

Continuamos con los artículos sobre Power BI Report Server, ya hemos visto tanto sus características principales como los consejos de implantación y mantenimiento y hoy, y para cerrar esta semana temática, vamos a hablar de buenas prácticas. Lo primero que tenemos que recordar es que Power BI Report Server (PBIRS) está construido sobre la base de SQL Server Reporting Service (SSRS), una herramienta de reporte de BI de Microsoft con más de 15 años en el mercado. Con esto quiero decir que la mayoría de las cosas que vamos a ver ahora os sonarán familiares si ya habéis administrado SSRS pero si no es así no os preocupéis que para eso lo vamos a ver.

Configuración avanzada de Report Server

Cuando instalamos PBIRS tendremos a nuestra disposición una herramienta de configuración calcada a la de SSRS donde podremos realizar las configuraciones más básicas de este servicio. Sin embargo, esto no es todo,habrá aspectos que configuraremos en el propio servicio web y otros, los más avanzados, para los que necesitaremos un SSMS. Y, en concreto, son tres de estas configuraciones de las que vamos a hablar en este apartado. Configuraciones que, para la mayoría de las empresas pueden funcionar pero, para otras igual no tanto.

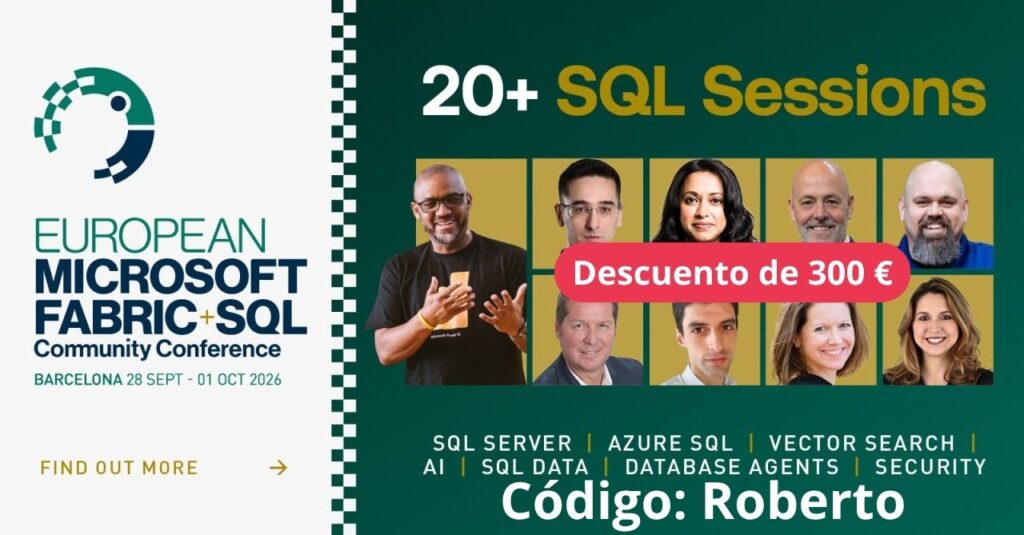
Para acceder a estas configuraciones nos conectaremos a nuestro PBIRS desde nuestro Management Studio (SSMS) usando la opción de conexión a SQL Server Reporting Service (SSRS). Una vez conectados abriremos las propiedades de la instancia y accederemos a las propiedades avanzadas. Aquí, entre otras, podremos encontrar la siguientes configuraciones:

Power BI Report Server Advanced Config

EnableMyReports

La configuración “Enable and disable My Reports» nos permite a los administradores activar o desactivar la funcionalidad de «Mis informes». Esta función, desactivada por defecto, ofrece a los usuarios la posibilidad de crear un espacio personal dentro del servidor donde pueden guardar y gestionar sus propios informes. Esto es similar al concepto Mi espacio de trabajo que tienen los usuarios dentro del servicio Power BI. Habilitar Mis informes es una excelente manera de fomentar la BI de autoservicio y puede ser beneficioso para fomentar la personalización y la autonomía de los usuarios, permitiéndoles trabajar de manera más eficiente sin sobrecargar los espacios compartidos del servidor. No obstante, dejarlo desactivado puede ser preferible en entornos donde la uniformidad y el control sobre los informes es una prioridad.

ExecutionLogDaysKept

ExecutionLogDaysKept es otra configuración importante que define cuántos días se conservan los registros de ejecución de informes en el servidor. Estos logs son fundamentales para el análisis de rendimiento y la solución de problemas, ya que contienen información detallada sobre cada ejecución de informes. Ajustar esta configuración nos permite a los administradores balancear entre la retención de información suficiente para análisis detallados y la gestión eficiente del espacio de almacenamiento. Por defecto esta propiedad está establecida en 60 días, un periodo de retención más largo puede ser útil para auditorías y análisis históricos, sobre todo si tienes informes que se ejecutan sólo una vez al mes o menos. Por otro lado, un periodo más corto puede ayudar a optimizar el rendimiento del servidor. 

EnablePowerBIReportExportUnderlyingData

Por último, la configuración EnablePowerBIReportExportUnderlyingData controla si los usuarios tienen permiso para exportar los datos subyacentes de los informes de Power BI. Esta opción es crucial para mantener la seguridad y privacidad de los datos. Permitir la exportación puede ser necesario para usuarios que requieran analizar la información fuera de la plataforma, pero también puede suponer un riesgo si los datos son sensibles. Por ello, esta configuración debe ser ajustada con cuidado, asegurando que solo los usuarios adecuados tengan acceso a esta funcionalidad y que se cumplan las políticas de seguridad de la organización. 

Si me preguntáis por mi opinión, yo soy totalmente partidario de deshabilitar esta opción. Además, un abuso de la descarga de información en horas de mucha actividad de usuarios puede suponernos un verdadero quebradero de cabeza.

Seguridad a nivel de carpetas en Report Server

Llegamos a una de las principales diferencias entre Power BI Report Server y el servicio en la nube de Power BI. Mientras en el cloud tenemos Workspaces que sirven como entornos aislados colaborativos para que los equipos desarrollen contenido de Power BI al unísono. Después creamos aplicaciones para facilitar la entrega del contenido a los usuarios. Estos conceptos no existen en Power BI Report Server. En PBIRS tendremos que usar carpetas.

Las carpetas dentro de Power BI Report Server (y SSRS) se comportan como carpetas dentro de un sistema de archivos. La seguridad a nivel de carpeta se puede aplicar para restringir el acceso a todo el contenido de la carpeta. Además, al igual que un sistema de archivos, se puede crear una jerarquía de carpetas. Esto es diferente a la naturaleza aplanada de App Workspaces dentro del servicio Power BI. 

Gestión de los permisos

Estemos alojando informes en el servicio o en PBIRS, debemos realizar una planificación cuidadosa desde el principio para proteger adecuadamente su contenido. Normalmente, tiene sentido crear carpetas para diferentes departamentos o equipos de la empresa como, por ejemplo, ventas, contabilidad, marketing, etc…

Aunque en Power BI Report Server (PBIRS), también podemos definir la seguridad en elementos individuales (por ejemplo, un único informe), normalmente no es una práctica. En implementaciones grandes, podemos encontrarnos con decenas o cientos de informes y mantener individualmente los permisos sería una pesadilla. Del mismo modo tenemos que huir de los permisos a usuarios individuales y, siempre que sea posible, utilizar grupos de usuarios. Si llevamos esto a rajatabla, podremos proteger múltiples informes relacionados y habilitar su uso para un subconjunto de usuarios sin complicaciones. 

En la mayoría de los casos, también recomiendo que os ciñais a una estructura de carpetas plana. De este modo, no solo será más fácil proteger las carpetas, también PBIRS coincidirá lógicamente con la estructura plana de Workspaces en el servicio Power BI. Esto nos facilitará la tarea de migración o  transferencia del contenido de Power BI Report Server (PBIRS) al servicio Power BI en la nube si alguna vez queremos hacerlo.

Reutilizar un modelo de datos en Report Server

Una de las limitaciones de Power BI Report Server (PBIRS) frente al servicio de Power BI en la nube es la capacidad de utilizar un mismo modelo de datos para diferentes informes. Así, mientras que en Power BI en la nube todos nuestros informes pueden acceder a un mismo modelo, si tenemos 12 informes que usan el mismo modelo de datos, en Power BI Report Server (PBIRS) tendremos que mantener 12 copias del modelo de datos. Esto, no hace falta que os lo diga, es un problema a la hora de actualizar los modelos y puede generar una discrepancia de datos entre los informes, que, en el mejor de los casos, nos provocará una reprimenda por parte de los usuarios. 

Sin embargo, nosotros que somos DBAs y sabemos de bases de datos y, sobre todo, de servicios de SQL Server, sabemos que podemos aprovecharnos de las capacidades de SQL Server Analysis Services para almacenar nuestras bases de datos dimensionales y, desde los informes de Power BI simplemente acceder a ese único origen de datos compartido para todos los reportes.

Analysis Services es una excelente opción si ya tenemos una inversión en SQL Server y sus componentes de BI, que la tendremos si hemos licenciado PBIRS con la licencia de SQL Server Enterprise. Sin embargo, si estamos implementando Power BI Report Server gracias al licenciamiento de Power BI Premium, también podemos aprovechar los conjuntos de datos que residen en la capacidad Premium como modelos de datos reutilizables.

Podemos establecer una conexión desde nuestros informes de Power BI a un conjunto de datos Premium como si fuera un modelo de Analysis Services. Para ello, debemos asegurarnos de que nuestra capacidad Premium tenga habilitada la lectura en la configuración del extremo XMLA.

Conclusión

En resumen, Power BI Report Server (PBIRS) es una herramienta muy potente, que, si se configura y gestiona adecuadamente, puede convertirse en un pilar fundamental para la inteligencia de negocio en tu organización. Desde la configuración avanzada para habilitar funciones como «Mis informes» o controlar la exportación de datos subyacentes, hasta la gestión cuidadosa de la seguridad a nivel de carpetas y la reutilización de modelos de datos, podemos optimizar cada aspecto de PBIRS para alinearlo con las necesidades y políticas de nuestra empresa. Implementar estas buenas prácticas no solo mejorará el rendimiento y la seguridad de nuestro entorno de reportes, sino que también facilitará futuras migraciones al servicio Power BI en la nube, asegurándonos que nuestra infraestructura de BI está preparada para el crecimiento y el cambio.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Power BI, Rendimiento, 0 comentarios

Despliegue y mantenimiento de PBIRS

Hoy vamos a seguir hablando de PBIRS, si en el pasado artículo vimos sus características, licenciamiento y cómo se compara con el servicio de Power BI en la nube (más bien cómo se complementa) hoy toca el turno de la configuración y mantenimiento del mismo. Lo primero que tenemos que saber es que la instalación de un servidor de Power BI Report Server (PBIRS), como la de cualquier otro servicio de producción, es un proceso que requiere una planificación meticulosa y un mantenimiento continuo para garantizar un rendimiento óptimo y la satisfacción de los usuarios. 

En este artículo, explicaremos algunas de las mejores prácticas que he identificado en mi experiencia con PBIRS, centrándonos en cómo implementarlas eficazmente y en cómo mantener la infraestructura una vez que esté en funcionamiento. La finalidad es maximizar la eficiencia, mejorar la seguridad y garantizar que los informes se ejecuten sin problemas, todo ello sin sacrificar la experiencia del usuario.

Planificando la Implementación de PBIRS

Como ya vimos cuando hablamos del despliegue de un servidor SQL Server, la planificación es un componente crucial en cualquier implementación, por tanto también cuando hablamos de PBIRS. Debemos comenzar con un análisis detallado de los requisitos de negocio y la capacidad técnica del entorno en el que se va a desplegar. Es esencial comprender no solo las necesidades actuales, sino también prever el crecimiento futuro y la escalabilidad de la plataforma.

Dimensionamiento y configuración del Servidor

Uno de los primeros pasos es dimensionar adecuadamente el servidor. La configuración del hardware debe estar alineada con la carga esperada de usuarios y la complejidad de los informes. Por ejemplo, si prevemos un uso intensivo de gráficos complejos o de grandes volúmenes de datos, será necesario disponer de un hardware más potente, con suficiente memoria RAM y capacidad de procesamiento para manejar las demandas sin comprometer el rendimiento.

Es recomendable dividir los recursos en diferentes servidores si el tráfico de usuarios o la carga de trabajo lo justifican, esto es un escalado horizontal. De esta manera, podemos evitar que un único punto de fallo impacte en la disponibilidad del servicio. Por supuesto, no debemos olvidar la importancia de configurar adecuadamente el almacenamiento, utilizando discos rápidos para el almacenamiento de bases de datos y optimizando las rutas de acceso para minimizar latencias.

Seguridad y gobernanza de los datos

A nadie le sorprende si os digo que la seguridad de los datos es primordial. PBIRS no es una excepción, y por ello es crucial establecer políticas de seguridad estrictas desde el inicio. Esto incluye la implementación de medidas como la autenticación segura, la encriptación de datos y la segregación de funciones para evitar accesos no autorizados.

Además, la gobernanza de los datos es otro aspecto que debemos considerar. Normalmente las organizaciones más grandes cuentan con equipos de gobierno del dato con quien deberemos trabajar estrechamente para establecer roles y permisos claros, así como auditar regularmente los accesos y las actividades dentro del servidor, nos ayudará a mantener un entorno seguro y conforme con las normativas vigentes. Es probable que en este proceso también intervenga el equipo de ciberseguridad, tanto en la toma de decisiones como en la monitorización continua de las auditorías.

Buenas Prácticas en PBIRS

Una vez que hemos planificado adecuadamente la implementación, es el momento de poner manos a la obra. Aquí es donde entran en juego las mejores prácticas específicas de implementación que nos permitirán maximizar el rendimiento y la funcionalidad de PBIRS.

Despliegue y Configuración Inicial

Durante el despliegue, es fundamental seguir las guías de instalación recomendadas por Microsoft, asegurándonos de que todas las dependencias están en su lugar y configuradas correctamente. Una vez instalado el servidor, debemos proceder con la configuración inicial, que incluye la creación de la base de datos de reportes, la configuración del servicio web y la aplicación de las políticas de seguridad definidas previamente.

Configuración de HTTPS en PBIRS

Un aspecto clave para la seguridad de PBIRS es el uso de HTTPS en lugar de HTTP para el servidor web. HTTPS asegura que los datos transmitidos entre los clientes y el servidor estén encriptados, lo que protege la información sensible de accesos no autorizados o ataques de intermediarios.

Implementar HTTPS en PBIRS requiere configurar el servidor web para aceptar conexiones seguras. Para ello, es necesario obtener e instalar un certificado SSL/TLS válido emitido por una autoridad de certificación de confianza. Los certificados SSL permiten que el servidor establezca una conexión segura y encriptada con los usuarios, lo que es fundamental para proteger la integridad y confidencialidad de los datos transmitidos.

Una vez que tenemos el certificado, debemos configurarlo en el servidor web de PBIRS. Este proceso generalmente implica asociar el certificado con el puerto 443, que es el puerto estándar para las conexiones HTTPS. Es crucial asegurarse de que todas las páginas y recursos del servidor se sirvan a través de HTTPS, redirigiendo automáticamente cualquier tráfico HTTP para evitar conexiones inseguras.

Mantenimiento Continuo de PBIRS

El mantenimiento es un aspecto que a menudo se subestima, pero es crucial para asegurar que el servidor siga funcionando de manera óptima a lo largo del tiempo. Este mantenimiento no solo incluye las actualizaciones regulares del software, sino también la monitorización proactiva y la gestión del rendimiento.

Monitorización y Rendimiento

Una de las mejores prácticas en el mantenimiento de PBIRS es la monitorización constante del rendimiento. Esto incluye la revisión de los logs de uso para identificar posibles cuellos de botella y la supervisión de los recursos del servidor para detectar cualquier signo de sobrecarga.

Utilizar herramientas de monitorización que permitan visualizar en tiempo real el uso de CPU, memoria y disco es fundamental. Esto nos permitirá anticiparnos a posibles problemas antes de que afecten a los usuarios finales. Además, realizar pruebas de estrés de manera periódica puede ayudarnos a ajustar la configuración del servidor para manejar mejor las cargas pico.

Actualizaciones y Parches

Mantener PBIRS actualizado es una práctica indispensable para asegurar tanto la estabilidad como la seguridad del sistema. Microsoft publica regularmente actualizaciones, normalmente 3 al año, que corrigen errores, mejoran el rendimiento y añaden nuevas funcionalidades. Sin embargo, antes de aplicar cualquier actualización, es recomendable realizar pruebas en un entorno de desarrollo o de preproducción para asegurarnos de que no introducirá nuevos problemas en el entorno de producción.

Además, es importante mantener actualizadas las bases de datos y los sistemas operativos subyacentes, ya que cualquier vulnerabilidad en estos componentes podría comprometer la seguridad y la integridad de los datos.

Gestión de la Capacidad y Escalabilidad

A medida que el uso de PBIRS crece, también lo hará la demanda de recursos. Por ello, es esencial gestionar la capacidad de manera proactiva, añadiendo recursos o distribuyendo la carga cuando sea necesario. Implementar una estrategia de escalabilidad, que incluya tanto la escalabilidad horizontal (añadir más servidores) como la vertical (mejorar los recursos de los servidores existentes), nos permitirá mantener un rendimiento óptimo a medida que crece la base de usuarios y la complejidad de los informes.

Optimización en la entrega de Informes

Para garantizar que los informes se entreguen de manera eficiente, es necesario optimizarlos. Esto implica una revisión continua tanto de consultas DAX como SQL para asegurarnos de que están bien escritas y no consumen recursos innecesarios. También es aconsejable utilizar particiones de datos en modelos grandes y evitar el uso excesivo de gráficos o visualizaciones que puedan ralentizar el rendimiento. 

Otro punto clave es configurar adecuadamente los tiempos de actualización de los informes. Definir horarios de actualización en momentos de baja demanda puede reducir significativamente el impacto en el rendimiento general del servidor.

Renovación de certificados

Por último no se nos debe olvidar que la implementación de HTTPS, de la que hemos hablado antes, no es un proceso único; es necesario que renovemos los certificados periódicamente para mantener la seguridad del sistema. Los certificados SSL tienen una validez limitada (de uno o dos años por norma general), por lo que debemos estar atentos a su fecha de expiración y renovarlos con antelación para evitar interrupciones en el servicio o alertas de seguridad para los usuarios.

Además, es recomendable utilizar certificados de autoridades de certificación reconocidas y evitar los certificados autofirmados en entornos de producción, ya que estos no son confiables por los navegadores modernos y pueden generar advertencias de seguridad para los usuarios.

Conclusión

La implementación y el mantenimiento de Power BI Report Server requieren un enfoque detallado y proactivo para garantizar que el sistema funcione de manera eficiente y segura. Desde la planificación inicial hasta el mantenimiento continuo, cada etapa del proceso ofrece oportunidades para optimizar el rendimiento y mejorar la experiencia del usuario. Al seguir las mejores prácticas descritas en este artículo, estaremos mejor preparados para abordar los desafíos que puedan surgir y asegurar que PBIRS continúe siendo una herramienta valiosa para la organización.

En última instancia, la clave del éxito radica en la planificación cuidadosa, la optimización constante y la monitorización proactiva, lo que nos permitirá maximizar el valor de nuestra inversión en Power BI Report Server y garantizar que sigue cumpliendo con las necesidades de negocio a lo largo del tiempo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Power BI, Rendimiento, 0 comentarios

PBIRS vs Power BI Service

Cuando hablamos de soluciones de Business Intelligence (BI) dentro del ecosistema de Microsoft, la primera opción que viene a la mente es Power BI. Sin embargo, dentro de esta herramienta tan robusta existen dos variantes principales que, a menudo, generan dudas sobre cuál elegir: Power BI Report Server (PBIRS) y el servicio de Power BI en la nube. En este artículo, exploraremos en profundidad las características, ventajas y limitaciones de cada opción, ayudándonos a discernir cuál se adapta mejor a nuestras necesidades organizativas.

¿Qué es Power BI?

Power BI es una suite de herramientas de análisis empresarial (BI) desarrollada por Microsoft que nos permite convertir datos en información útil mediante informes interactivos y visualizaciones impactantes. Dentro de Power BI tenemos integración de manera efectiva con una amplia gama de fuentes de datos, permitiéndonos analizar y compartir insights con facilidad prácticamente sea cual sea su origen. Además de poder combinar en un solo modelo de datos e informes datos de varios orígenes.

Hemos hablado de modelo de datos e informes y es que, Power BI Desktop (la aplicación que se instala en el ordenador y nos permite a los usuarios crear informes complejos y dashboards interactivos) consta de dos partes principales. Por un lado la integración de datos de los informes y su adaptación (lo que tradicionalmente se conoce como ETL) a cargo de Power Query y la propia aplicación para diseñar los informes que además permite cálculos avanzados con DAX. 

Así, a grandes rasgos, con Power BI Desktop, podemos conectar, transformar y modelar datos antes de visualizarlos en gráficos y tablas que ayuden a tomar decisiones informadas. La interfaz es intuitiva y, a pesar de su poder, está diseñada para ser accesible tanto a analistas de datos experimentados como a usuarios menos técnicos. Una vez que los informes están listos, los podemos publicar y compartir a través de Power BI Service (en la nube) o mediante Power BI Report Server (PBIRS), según la infraestructura y las necesidades de la organización.

Entendiendo PBIRS y Power BI en la Nube

Antes de entrar en sus diferencias, es importante entender qué son PBIRS y el servicio de Power BI en la nube. PBIRS es una plataforma local de informes basada en SSRS que nos permite mantener los datos y reportes dentro de nuestra infraestructura local, sin necesidad de depender de servicios externos. Esta opción es especialmente útil para aquellas empresas con estrictos requisitos de seguridad o que operan en sectores altamente regulados. Por otro lado, Power BI en la nube ofrece un servicio completamente gestionado por Microsoft, con actualizaciones frecuentes, escalabilidad casi ilimitada y acceso desde cualquier lugar.

Seguridad y Cumplimiento. Punto para PBIRS

Uno de los principales argumentos a favor de PBIRS es la seguridad. Muchas organizaciones tienen normativas estrictas sobre dónde deben residir los datos, lo que hace que la opción de mantener todo «en casa» sea atractiva. Con PBIRS, el control total sobre los servidores, bases de datos y la red es una realidad. Esto es crucial en sectores como el financiero, sanitario o gubernamental, donde el cumplimiento de normativas es ineludible.

Además, PBIRS permite la integración directa con las políticas de seguridad corporativas existentes, como Active Directory, lo que facilita la implementación de controles de acceso granulares y personalizados. En contraste, Power BI en la nube, aunque seguro y conforme a muchas normativas internacionales, deja el control de la infraestructura en manos de Microsoft, lo que puede no ser ideal para todas las organizaciones.

Flexibilidad y Personalización. Otro punto para PBIRS

PBIRS nos ofrece una mayor flexibilidad en términos de personalización y control de la infraestructura. Podemos ajustar los servidores a las necesidades específicas de nuestros informes y modelos de datos, lo que es fundamental cuando trabajamos con grandes volúmenes de información o requerimos configuraciones especializadas. Además, PBIRS permite utilizar Reporting Services, Power BI y Excel, lo que proporciona una solución integral para la gestión de informes en una única plataforma.

En contraste, Power BI en la nube se enfoca más en la simplicidad y la facilidad de uso. Aunque ofrece un entorno muy completo, su flexibilidad en cuanto a personalización es menor, ya que estamos limitados a las opciones y configuraciones que Microsoft ha diseñado para el servicio. Sin embargo, esta «limitación» viene acompañada de una gestión simplificada y la eliminación de la carga de mantenimiento y actualizaciones de la infraestructura.

Licenciamiento. Punto para el Servicio

Un aspecto clave en la decisión de optar por PBIRS o Power BI en la nube, es el modelo de licenciamiento. En PBIRS, los usuarios pueden consultar informes sin necesidad de adquirir licencias adicionales. Una vez que el servidor está configurado y licenciado, cualquier usuario de la organización con acceso al servidor puede visualizar los informes sin coste adicional. Sin embargo, las opciones de licenciamiento de PBIRS son escasas y caras, muy caras. Realmente no podemos licenciar exclusivamente PBIRS y, si lo queremos usar debemos adquirir una licencia de otro producto que incluya este. Estas licencias de otros productos que incluyen PBIRS son SQL Server Enterprise con Software Assurance o una capacidad Premium de Power BI (mínimo una F64 de instancia reservada y no pago por uso).

Este modelo contrasta con el de Power BI en la nube, donde cada usuario que quiera acceder a los informes debe contar con una licencia, ya sea Power BI Pro o Premium. Aunque este modelo de suscripción tiene sus ventajas en términos de escalabilidad y simplicidad de gestión, puede resultar costoso para organizaciones grandes o aquellas con muchos usuarios ocasionales.

Esta diferencia en el licenciamiento hace que PBIRS sea poco atractivo ya que muchas empresas no pueden permitirse el desembolso de dinero del que estamos hablando. Una licencia de SQL Server Enterprise cuesta unos 14.000€ por cada dos cores del servidor (y que menos que 8 cores para un servidor decente, lo que suman ya más 55.000€ ) más luego la suscripción del Software Assurance y, para el otro modo de licenciamiento, una instancia reservada con capacidad F64 tiene un coste de suscripción de unos 8000€ al mes.

Escalabilidad y Mantenimiento. Otro punto para el servicio

La escalabilidad es otro aspecto donde las diferencias entre PBIRS y Power BI en la nube se hacen evidentes. Power BI en la nube ofrece una escalabilidad casi ilimitada, ya que la infraestructura de Microsoft Azure se encarga de todo. Esto significa que podemos empezar con un pequeño proyecto piloto y escalar sin problemas a nivel empresarial sin necesidad de preocuparnos por la capacidad del servidor o el rendimiento, solo por el coste.

Por otro lado, con PBIRS, la escalabilidad depende completamente de nuestra infraestructura local. Si nuestras necesidades crecen, deberemos estar preparados para invertir en más hardware, espacio y, seguramente, más personal para gestionar y mantener el entorno. Esto puede ser una barrera para organizaciones en rápido crecimiento o que experimentan picos estacionales en la demanda de informes.

El mantenimiento es otro punto clave. Power BI en la nube se actualiza automáticamente, con nuevas características y mejoras implementadas por Microsoft de manera constante. Esto garantiza que siempre tengamos acceso a la última tecnología sin necesidad de realizar cambios manuales en nuestra infraestructura. En cambio, con PBIRS, somos responsables de aplicar las actualizaciones y parches, lo que requiere un equipo dedicado y una planificación cuidadosa para evitar interrupciones en el servicio.

Costes y Retorno de la Inversión. ¿Empate?

A la hora de evaluar PBIRS frente a Power BI en la nube, los costes son un factor determinante. PBIRS suele requerir una inversión inicial significativa en hardware, licencias y recursos humanos. Además, los costes de mantenimiento y actualización deben considerarse a largo plazo. Sin embargo, para organizaciones que ya disponen de una infraestructura robusta, este coste puede ser amortizado más fácilmente.

Por otro lado, Power BI en la nube sigue un modelo de suscripción, lo que permite empezar con costes más bajos y escalarlos según el uso y las necesidades. Aunque a largo plazo, las suscripciones pueden acumularse, ofrecen la ventaja de no requerir una inversión inicial significativa y permiten a las organizaciones ajustar sus gastos según la evolución de sus requerimientos.

El retorno de la inversión (ROI) en ambos casos depende en gran medida de la naturaleza de la organización y de cómo se utilice la herramienta. PBIRS puede ofrecer un ROI más alto en entornos donde la seguridad y el control son primordiales, mientras que Power BI en la nube podría ofrecer un mejor ROI para organizaciones que valoran la flexibilidad y la capacidad de escalar rápidamente.

Facilidad de Implementación y Adopción. El cloud gana esta batalla

La facilidad de implementación es otra área donde Power BI en la nube sobresale. Al ser un servicio gestionado, la configuración inicial es mínima y la adopción por parte de los usuarios finales suele ser más rápida. Los informes pueden compartirse fácilmente, y el acceso a los mismos está garantizado desde cualquier lugar y dispositivo, lo que fomenta una cultura de datos más abierta y colaborativa.

Por otro lado, PBIRS puede requerir un proceso de implementación más complejo, especialmente si no contamos con una infraestructura avanzada o experiencia en la gestión de servidores de informes. 

¿PBIRS o Power BI en la Nube?

La elección entre PBIRS y Power BI en la nube no es sencilla y depende en gran medida de las necesidades específicas de cada organización. Si la seguridad, el cumplimiento normativo y el control absoluto sobre la infraestructura son prioridades, PBIRS es la opción ideal. Si ya contamos en nuestra organización con una licencia de SQL Server Enterprise con SA ese problema de costes de licenciamiento se diluye y PBIRS pasa a ser una opción muy atractiva. Además, el hecho de que no se necesitan licencias adicionales para que los usuarios visualicen informes puede representar un ahorro significativo, en entornos con un gran número de usuarios.

Sin embargo, si valoramos la escalabilidad, la facilidad de uso y la reducción de la carga de mantenimiento, Power BI en la nube se posiciona como la opción más adecuada. Aunque implica un coste por usuario, la flexibilidad y el acceso global que ofrece son difíciles de igualar.

Conclusión

En resumen, ambas herramientas son complementarias y podríamos combinar un servicio en la nube con uno local. La clave está en evaluar cuidadosamente las necesidades de nuestra organización, los recursos disponibles y los objetivos a largo plazo antes de tomar una decisión. Al hacerlo, garantizamos que estamos invirtiendo en la solución que mejor se alinea con nuestra estrategia de BI.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

No te vayas aun. Hemos creado una página donde estamos recopilando todos estos artículos que dan respuesta a estas preguntas frecuentes de SQL Server. Pásate por aquí a echar un vistazo.

Antes de cerrar este artículo me gustaría agradecer la inestimable ayuda de mi amigo Ricardo Rincón, experto MVP en Power BI que me ha asesorado y ayudado, sobre todo a poner algo de luz en el tema del licenciamiento.

Publicado por Roberto Carrancio en Cloud, Power BI, 2 comentarios

Transacciones Distribuidas y DTC

Cuando hablamos de sistemas de bases de datos, uno de los retos más grandes es garantizar la consistencia de los datos en entornos distribuidos. No suele ser lo común pero, a medida que las arquitecturas de aplicaciones se vuelven más complejas, surge la necesidad de coordinar múltiples transacciones que puedan involucrar diferentes bases de datos o incluso diferentes servidores. Aquí es donde entra en juego el concepto de transacciones distribuidas, y en SQL Server, el Distributed Transaction Coordinator (DTC) juega un papel crucial.

¿Qué son las Transacciones Distribuidas?

Una transacción distribuida es aquella que abarca más de un recurso de red, como bases de datos o sistemas de archivos ubicados en diferentes servidores. A diferencia de una transacción local que afecta a una sola base de datos, las transacciones distribuidas tienen la capacidad de coordinar cambios en varias bases de datos, asegurando que todos los participantes de la transacción lleguen a un estado de compromiso o vuelvan a un estado previo en caso de fallo.

El desafío en las transacciones distribuidas es garantizar que todos los nodos involucrados lleguen a un consenso sobre el resultado de la transacción. Esto es fundamental para mantener la integridad de los datos y evitar inconsistencias que podrían llevar a resultados inesperados o, en el peor de los casos, a la corrupción de los datos.

Distributed Transaction Coordinator (DTC)

En SQL Server, el Distributed Transaction Coordinator (DTC) es el componente encargado de gestionar las transacciones distribuidas. Su función principal es asegurar que todas las partes de una transacción distribuida, que pueden involucrar múltiples bases de datos y servidores, se comprometan correctamente o se deshagan en caso de error.

DTC utiliza el protocolo de dos fases (2PC, por sus siglas en inglés) para coordinar las transacciones. Este protocolo se divide en dos fases: la fase de preparación y la fase de compromiso. En la primera fase, DTC pregunta a todos los participantes si están listos para comprometer la transacción. Si todos responden afirmativamente, se procede a la segunda fase, donde se envía la orden de compromiso. Si alguno de los participantes no puede comprometerse, se inicia el proceso de deshacer la transacción en todos los participantes, asegurando que el sistema vuelva a un estado coherente.

Configuración y uso de Transacciones Distribuidas en SQL Server

Para aprovechar las transacciones distribuidas en SQL Server, primero necesitamos asegurarnos de que DTC esté configurado y funcionando correctamente en todos los servidores involucrados. Esto implica la configuración tanto a nivel de sistema operativo como en SQL Server.

Configurar DTC a nivel sistema operativo y red

En cuanto a la configuración del sistema operativo, es crucial que DTC esté habilitado y configurado para permitir transacciones remotas, ya que, por defecto, estas suelen estar desactivadas por razones de seguridad. Para habilitar DTC, desde el panel de control tendremos que acceder a “Agregar o Quitar Componentes de Windows” y activar la opción “Habilitar el acceso DTC de red”. Una vez hecho esto, y reiniciado el servidor si se nos requiere, el equipo estará listo para admitir transacciones distribuidas.

Sin embargo, esto no es todo, es importante asegurarse de que las reglas del firewall permitan la comunicación entre los servicios DTC de los diferentes servidores. DTC usa llamadas al procedimiento remoto RPC por lo que los puertos necesarios son, en primer lugar el puerto 135 TCP y UDP para establecer la comunicación y después un puerto TCP dinámico del rango 49152-65535. Este rango se puede configurar cambiando configuraciones del registro de windows si lo deseamos pero lo importante es que, nuestro firewall admita conexiones tanto por el puerto 135 como por todos los del rango dinámico seleccionado.

Usar DTC en SQL Server

Una vez que DTC esté operativo, podremos comenzar a utilizar transacciones distribuidas en SQL Server. Esto se hace a través de la instrucción BEGIN DISTRIBUTED TRANSACTION, que inicia una transacción distribuida que abarca múltiples servidores. Es importante tener en cuenta que, aunque la sintaxis es similar a la de una transacción local, el alcance y la complejidad son considerablemente mayores.

Un ejemplo sencillo podría involucrar dos servidores SQL Server diferentes. Comenzamos la transacción distribuida en el primer servidor y realizamos las operaciones necesarias. Luego, nos conectamos al segundo servidor y realizamos más operaciones dentro de la misma transacción. Finalmente, decidimos si se comprometen los cambios (commit) o si se deshacen (rollback).

Consideraciones en el Uso de Transacciones Distribuidas

Aunque el uso de transacciones distribuidas y DTC ofrece grandes ventajas en términos de consistencia y fiabilidad, también presenta una serie de retos que debemos considerar.

En primer lugar, las transacciones distribuidas suelen ser más lentas que las locales debido a la sobrecarga de la coordinación entre múltiples nodos. Esto puede afectar el rendimiento de las aplicaciones, especialmente en sistemas con alta concurrencia.

Además, la complejidad de la configuración y la gestión de DTC puede ser un obstáculo en muchas organizaciones donde, también será común involucrar a varias personas de varios departamentos para el cambio. Es vital asegurarse de que todos los servidores involucrados estén correctamente configurados y que la comunicación entre ellos sea fluida. Cualquier problema en la configuración de DTC puede resultar en errores difíciles de diagnosticar, que pueden ser muy costosos de resolver en producción.

Otro aspecto a tener en cuenta es la fiabilidad del sistema. Aunque DTC está diseñado para manejar fallos, es esencial contar con mecanismos adicionales de recuperación y monitorización para minimizar el impacto de posibles fallos de red o de los servidores.

Por último, es fundamental considerar la seguridad en la configuración de DTC. Dado que las transacciones distribuidas pueden involucrar la transferencia de datos sensibles entre servidores, es necesario implementar medidas de seguridad robustas para proteger esta información. Esto incluye el uso de comunicaciones seguras, así como la correcta configuración de permisos y autenticaciones.

Buenas prácticas para la gestión de Transacciones Distribuidas

Para gestionar eficazmente las transacciones distribuidas en SQL Server, es importante seguir una serie de buenas prácticas que nos permitirán minimizar riesgos y maximizar el rendimiento.

En primer lugar, debemos evitar utilizar transacciones distribuidas a menos que sean absolutamente necesarias. Si es posible, debemos buscar alternativas, como la replicación o el uso de servicios distribuidos que manejen la consistencia eventual. Las transacciones distribuidas deben reservarse para casos en los que la consistencia estricta sea un requisito ineludible. Si, el primer consejo es no lo hagas, es lo que hay.

Cuando sea necesario utilizar transacciones distribuidas, es fundamental optimizar el diseño de las mismas para reducir al mínimo el tiempo que la transacción está abierta. Esto incluye realizar todas las operaciones preparatorias fuera de la transacción y asegurarse de que el código dentro de la transacción sea lo más eficiente posible.

Además, es recomendable implementar una monitorización continua del rendimiento y de los posibles errores de DTC. Existen herramientas en SQL Server que nos permiten rastrear y analizar el rendimiento de las transacciones distribuidas, así como diagnosticar problemas en tiempo real. Por ejemplo, SQL Server Profiler, xEvents o DMVs.

Conclusión

Las transacciones distribuidas y el uso de DTC en SQL Server son herramientas poderosas que permiten garantizar la consistencia de los datos en entornos complejos y distribuidos. Sin embargo, su uso requiere una planificación cuidadosa y una gestión rigurosa para evitar problemas de rendimiento y fiabilidad.

Es importante recordar que no todas las aplicaciones necesitan transacciones distribuidas. En muchos casos, existen soluciones alternativas que pueden ofrecer la consistencia y fiabilidad necesarias sin la complejidad adicional. Cuando se opte por utilizar transacciones distribuidas, debemos asegurarnos de seguir las buenas prácticas y mantener una supervisión constante para garantizar el éxito a largo plazo.

Si abordamos las transacciones distribuidas con una comprensión clara de sus beneficios y limitaciones, y si estamos dispuestos a invertir en su correcta implementación, podemos lograr una gestión eficiente y segura de nuestros sistemas distribuidos en SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!


Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios