Rendimiento

¿Deberíamos usar un ORM para desarrollar aplicaciones?

¿Deberíamos usar un ORM para desarrollar aplicaciones?

Cuando desarrollamos aplicaciones que interactúan con bases de datos SQL Server o Azure SQL, una de las decisiones más relevantes es si utilizar un Object-Relational Mapper (ORM) o escribir directamente consultas SQL optimizadas. Desde el punto de vista de un DBA, esta elección tiene un impacto significativo en el rendimiento, la seguridad y la mantenibilidad del sistema. En este artículo, analizaremos las ventajas y riesgos de los ORM para que los desarrolladores puedan tomar decisiones informadas.

¿Qué es un ORM y cuáles son los más usados con SQL Server?

Un Object-Relational Mapper (ORM) es una herramienta que permite a los desarrolladores interactuar con bases de datos SQL Server o Azure SQL a través de objetos y clases en su lenguaje de programación, evitando la necesidad de escribir consultas SQL manualmente. Esto facilita el desarrollo y mejora la productividad, pero también introduce riesgos en términos de rendimiento y optimización.

Entre los ORM más utilizados con SQL Server destacan Entity Framework, que ofrece una integración profunda con .NET y permite trabajar con consultas LINQ, Dapper, un micro ORM más ligero y eficiente que requiere consultas SQL explícitas, y NHibernate, una opción más flexible con características avanzadas de optimización.

Si bien los ORM pueden acelerar el desarrollo, es fundamental conocer sus ventajas y riesgos para evitar problemas de rendimiento y escalabilidad en entornos de producción. A continuación, analizaremos estos aspectos desde la perspectiva de un DBA.

Ventajas de usar un ORM en SQL Server o Azure SQL

Los ORM se están imponiendo en el mercado por sus ventajas a la hora de trabajar con base de datos. Vamos a ver cuales son estas principales ventajas.

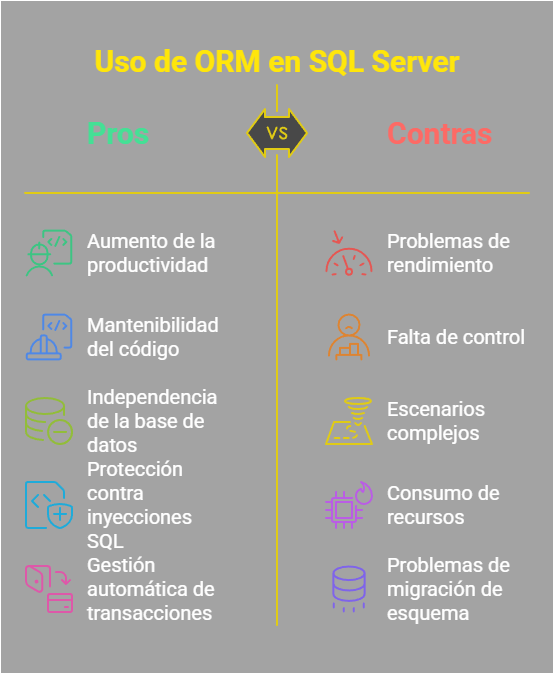
Aumento de la productividad

Uno de los principales atractivos de los ORM es su capacidad para abstraer la base de datos mediante modelos de objetos en el lenguaje de programación utilizado (C#, Python, Java, etc.). Esto permite a los desarrolladores escribir código sin preocuparse por los detalles específicos del SQL, lo que acelera el desarrollo.

Por ejemplo, en Entity Framework, la creación de un nuevo registro puede ser tan sencilla como:

Esto elimina la necesidad de escribir INSERT INTO manualmente, reduciendo el código repetitivo y mejorando la legibilidad.

Mantenimiento y escalabilidad del código

Los ORM promueven una arquitectura más limpia y estructurada. Dado que el acceso a datos se encapsula dentro de modelos y repositorios, es más fácil modificar o extender la funcionalidad sin afectar directamente la base de datos. Además, el uso de ORM facilita el mantenimiento en equipos grandes, donde distintos desarrolladores trabajan sobre la misma base de código.

Independencia del motor de Base de Datos

Muchos ORM permiten cambiar de motor de base de datos sin necesidad de modificar grandes secciones del código. Esto puede ser útil en escenarios donde la aplicación necesita soportar tanto SQL Server como PostgreSQL, o cuando una empresa decide migrar de on-premises a Azure SQL.

Protección contra inyecciones SQL (SQLi)

Los ORM utilizan parámetros en sus consultas, lo que minimiza el riesgo de ataques de inyección SQL. Por ejemplo:

Aquí, Entity Framework convierte internamente la consulta en una con parámetros, evitando el uso de concatenación de strings peligrosa como:

Este beneficio mejora la seguridad de la aplicación sin requerir validaciones manuales en cada consulta.

Gestión automática de transacciones

Los ORM suelen manejar transacciones de forma automática, asegurando la integridad de los datos sin necesidad de que los desarrolladores escriban explícitamente BEGIN TRANSACTION, COMMIT o ROLLBACK. Esto reduce errores en operaciones que afectan múltiples tablas.

Riesgos de usar un ORM en SQL Server o Azure SQL

Todas estas ventajas tienen una serie de contraprestaciones, unos problemas o, más bien, riesgos que tenemos que tratar adecuadamente o tendremos problemas más pronto que tarde. Voy a tratar de resumir ahora estos principales problemas para que vosotros no tengáis estos problemas.

Problemas de rendimiento (Consultas ineficientes)

Uno de los mayores problemas de los ORM es la generación de consultas ineficientes. A menudo, una consulta simple en SQL se convierte en múltiples llamadas a la base de datos debido a malas prácticas como el «N+1 problem«:

Aquí, en lugar de ejecutar una sola consulta JOIN, el ORM ejecutará una consulta por cada usuario, afectando gravemente el rendimiento. En bases de datos grandes, esto puede generar miles de consultas innecesarias.

Solución: Es recomendable utilizar carga diferida (lazy loading) de manera controlada o Include() para optimizar la carga de datos:

Falta de control sobre las consultas generadas

Los ORM generan consultas automáticamente, lo que a veces resulta en consultas innecesariamente complejas o con condiciones redundantes. Aunque los ORM permiten escribir consultas en SQL nativo (context.Database.ExecuteSqlRaw() en Entity Framework), muchos desarrolladores confían demasiado en la capa de abstracción y no analizan las consultas generadas.

Para mitigar este problema, se recomienda habilitar la inspección de consultas y monitorizar el rendimiento mediante herramientas como SQL Server Profiler u otras similares.

Dificultades en escenarios complejos

Cuando una aplicación requiere procedimientos almacenados (Stored Procedures), funciones (Functions) o consultas altamente optimizadas, los ORM pueden ser un obstáculo. Aunque algunos ORM permiten ejecutar procedimientos almacenados, su integración no siempre es natural.

En SQL Server, algunas operaciones críticas como manejo de particiones, índices columnstore o consultas optimizadas para OLAP son difíciles de realizar correctamente con un ORM, lo que puede afectar el rendimiento en cargas de trabajo intensivas.

Consumo de recursos y sobrecarga en la Base de Datos

Los ORM suelen manejar el tracking de cambios en los objetos, lo que genera una sobrecarga de memoria en aplicaciones con gran volumen de datos. En Entity Framework, esto se mitiga con .AsNoTracking():

Sin embargo, si los desarrolladores no son conscientes de esta necesidad, las aplicaciones pueden volverse más lentas a medida que el contexto de datos crece innecesariamente.

Problemas con la migración de esquema en producción

Herramientas de ORM como Entity Framework Migrations permiten gestionar cambios en el esquema de la base de datos de forma programática. Sin embargo, si no se manejan correctamente, pueden introducir cortes en producción, por ejemplo, si una tabla es renombrada o si se eliminan columnas en uso.

En bases de datos críticas, es preferible utilizar scripts de migración controlados manualmente en lugar de depender exclusivamente de herramientas automatizadas.

Un ORM mal configurado puede tratar todos los datos como texto

Un problema frecuente cuando se usa algunos ORM es la mala configuración de los tipos de datos. Si no se mapean correctamente las columnas a los tipos adecuados, el ORM puede convertir todos los datos a texto (nvarchar o varchar), lo que genera problemas de rendimiento y errores de modelado.

Por ejemplo, si un campo de fecha no se mapea correctamente:

Esto puede provocar conversiones implícitas y afectar el uso de índices en SQL Server, ya que las comparaciones se vuelven menos eficientes:

Solución: Verificar siempre la configuración de los tipos de datos y usar HasColumnType() en Entity Framework:

No aprovechar las optimización de los Procedimientos Almacenados

Uno de los puntos más críticos es que los ORM no aprovechan las capacidades de optimización de SQL Server, como la caché de planes de ejecución. Los procedimientos almacenados permiten a SQL Server reutilizar planes de ejecución optimizados, mientras que los ORM pueden generar consultas dinámicas que no se benefician de esta reutilización.

Por otro lado, en las últimas versiones de SQL se han introducido los Joins dinámicos en los planes de ejecución de procedimiento almacenados, cosa de lo que no aprovechan las consultas generadas por el ORM. Además, un procedimiento almacenado puede incluir hints, como por ejemplo OPTION (RECOMPILE), para ajustar la optimización a cada ejecución, algo difícil de lograr con consultas generadas por ORM.

Por último, en un procedimiento almacenado, podemos definir parámetros con los tipos exactos, evitando conversiones innecesarias que afectan el rendimiento.

En conclusión ,el uso de procedimientos almacenados garantiza un mejor aprovechamiento de la infraestructura de SQL Server.

¿Cuándo usar un ORM en SQL Server o Azure SQL?

Como vemos, estas herramientas pueden ser un arma de doble filo y lo que parecía una ventaja para los desarrolladores termina siendo un problema de rendimiento y dolores de cabeza continuos para el equipo. Tenemos que tener muy claro en qué casos usarlo y en qué casos no. Esto sería un pequeño resumen, a modo general, aunque siempre hay excepciones.

Casos en los que un ORM es adecuado:

  • Aplicaciones pequeñas o medianas donde la velocidad de desarrollo es clave.
  • Proyectos con equipos de desarrollo que no tienen conocimientos avanzados en SQL.
  • Aplicaciones que no requieren consultas SQL altamente optimizadas.
  • Proyectos en los que la independencia del motor de base de datos es un factor importante.

Casos en los que un ORM NO es la mejor opción:

  • Aplicaciones con alto tráfico y consultas complejas donde el rendimiento es crítico.
  • Sistemas que dependen de procedimientos almacenados, índices columnstore o consultas OLAP.
  • Aplicaciones con grandes volúmenes de datos que requieren optimización a nivel de base de datos.
  • Proyectos donde la sobrecarga del ORM afecta significativamente los tiempos de respuesta.

Conclusión

Los ORM son herramientas útiles que pueden mejorar la productividad y la seguridad en el desarrollo de aplicaciones. Sin embargo, como administradores de bases de datos, debemos asegurarnos de que su uso no impacte negativamente el rendimiento o la escalabilidad del sistema.

En conclusión, los ORM no son una solución mágica. Usarlos correctamente requiere comprender tanto sus ventajas como sus limitaciones, asegurándonos siempre de que no comprometan la eficiencia del sistema. Como DBA, nuestra labor es garantizar que las aplicaciones sean escalables y seguras, y para ello, una estrategia equilibrada entre ORM y SQL optimizado es la mejor opción.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario
¿Reconstruir índices? Quizá ya no tiene tanto sentido como pensábamos

¿Reconstruir índices? Quizá ya no tiene tanto sentido como pensábamos

Durante años, una de las tareas de mantenimiento más comunes en nuestros servidores SQL Server ha sido la reconstrucción de índices. La idea de eliminar la fragmentación, mejorar el rendimiento de las consultas y, en ocasiones, recuperar espacio en disco ha estado firmemente arraigada en nuestras rutinas. Sin embargo, la evolución de SQL Server con la introducción de características como Accelerated Database Recovery (ADR) y Read Committed Snapshot Isolation (RCSI) nos obliga a replantearnos si esta práctica sigue teniendo el mismo sentido que antes. En este artículo, basándonos en un experimento que hice recientemente, veremos cómo estas nuevas funcionalidades impactan en la necesidad de reconstruir índices y por qué, en muchos casos, puede que estemos invirtiendo tiempo y recursos de forma innecesaria.

¿Reconstruir índices con ADR? Un nuevo paradigma en la recuperación

Para entender por qué la reconstrucción de índices podría ser menos relevante con ADR, primero debemos recordar cómo funciona esta característica. Sin ADR, cuando modificamos una fila, SQL Server guarda los valores antiguos en el registro de transacciones y actualiza la fila directamente. Si la transacción se revierte, el motor debe recuperar los valores antiguos del registro y aplicarlos de nuevo a la fila. Cuantas más filas se hayan modificado, más tiempo tardará la reversión.

Con ADR, esta operativa cambia radicalmente. En lugar de sobrescribir la fila original, SQL Server escribe una nueva versión de la fila dentro de la misma tabla, manteniendo la versión antigua intacta. Esta estrategia permite que las reversiones de transacciones sean casi instantáneas, ya que no es necesario leer y aplicar información del registro de transacciones.

Como seguramente ya habréis imaginado, almacenar múltiples versiones de una misma fila en la tabla tiene un impacto directo en el consumo de espacio. Para demostrarlo, hace unos días realicé una prueba creando dos bases de datos idénticas, una con ADR habilitado (Test_ADR) y otra sin él (Test), y cargué ambas con un millón de filas en tablas con la misma estructura. Inicialmente, como era de esperar, la tabla con ADR activado (Products_ADR) ocupó más espacio que la tabla normal (Products). Esto se debe a que, de forma similar a RCSI, ADR necesita añadir una marca de tiempo a cada fila para rastrear sus versiones.

¿Reconstruir índices con ADR y RCSI? Un experimento revelador

La primera sorpresa llegó al reconstruir los índices en ambas tablas. Tras la reconstrucción, el tamaño de la tabla Products_ADR, que inicialmente era mayor, se redujo drásticamente hasta igualar el tamaño de la tabla Products. Esto nos plantea una pregunta intrigante: si ADR ya estaba activo al cargar los datos, ¿por qué la reconstrucción de índices liberó tanto espacio? Se podría pensar que las marcas de tiempo de versionado deberían haberse insertado con los datos iniciales, sin causar una fragmentación excesiva.

Repetí este experimento varias veces, incluso en bases de datos con ADR y RCSI activados simultáneamente, y los resultados fueron consistentes. Después de la carga inicial de datos, las tablas con ADR y/o RCSI tendían a ser más grandes. Sin embargo, tras una reconstrucción de índices, todos los tamaños se normalizaban.

La verdadera diferencia se hizo evidente al simular actividad de escritura. Al actualizar un 10% de las filas en todas las tablas, observamos que en la base de datos “normal”, el tamaño de los objetos se mantenía relativamente estable, con un ligero aumento en el índice no clúster de la columna actualizada. Esto es comprensible, ya que las filas modificadas podrían necesitar moverse a nuevas páginas para mantener el orden del índice. No obstante, en las bases de datos con ADR y/o RCSI habilitados, el tamaño de los objetos explotó, llegando casi a duplicarse tras la primera actualización. Al realizar más rondas de actualizaciones, la tendencia se mantuvo: mientras que la base de datos sin ADR crecía de forma gradual, las bases de datos con ADR y RCSI experimentaban un crecimiento mucho más rápido.

¿Por qué crecen las bases de datos con el versionado de filas?

El crecimiento del tamaño de las bases de datos al habilitar funcionalidades como ADR (Accelerated Database Recovery) y RCSI (Read Committed Snapshot Isolation) se debe al mecanismo de versionado de filas, que permite lecturas consistentes sin bloqueos. Sin embargo, aunque la ubicación del almacén de versiones sea la TempDB como con RCSI existe un overhead por fila que explica este aumento de tamaño. 

Cuando ADR está habilitado

La Recuperación Acelerada de Bases de Datos utiliza un almacén de versiones persistente (PVS) que se encuentra dentro de la propia base de datos de usuario. Esto significa que las versiones anteriores de las filas modificadas se almacenan en el mismo archivo de datos (.mdf) de la base de datos. Como resultado directo, el tamaño de la base de datos en disco aumenta para albergar estas versiones.

Adicionalmente, cada fila de la tabla contendrá un puntero de 14 bytes que apunta a la ubicación de su versión en el PVS, incluso si la fila no ha sido modificada recientemente. Este overhead por fila es el principal causante del aumento del tamaño de la base de datos.

Cuando RCSI está habilitado (sin ADR)

Si la base de datos tiene habilitado el aislamiento por instantánea de lectura confirmada (RCSI) pero no la Recuperación Acelerada de Bases de Datos (ADR), el almacén de versiones se crea y se mantiene en la base de datos del sistema TempDB. Esto significa que las versiones de las filas modificadas en la base de datos de usuario se almacenan temporalmente en TempDB. Por lo tanto, podriamos pensar que la base de datos de usuario en sí misma debería no experimentar un aumento tan drástico debido al almacenamiento de las versiones, aunque TempDB sí crecerá para acomodar estas versiones.

Sin embargo, al igual que con ADR, cada fila de la tabla en la base de datos de usuario seguirá teniendo el puntero de 14 bytes que apunta al almacén de versiones, aunque en este caso, el almacén esté ubicado en TempDB. Este overhead por fila en la base de datos de usuario hace que el crecimiento que veamos en la tabla sea igual que en las que están en una base de datos con ADR.

Otras funcionalidades afectadas por el versionado de filas

Además de ADR y RCSI que, como acabamos de ver, usan un almacén de versiones, hay más funcionalidades de SQL que lo necesitan. En concreto, las más comunes son las bases de datos secundarias legibles en configuraciones Always On que emplean un almacén de versiones para ofrecer lecturas consistentes en la réplica secundaria.

Otra característica son las vistas indexadas que utilizan el versionado de filas para mantener la consistencia y los Triggers AFTER UPDATE que pueden depender del versionado de filas para acceder a los estados anteriores de las filas modificadas.

En resumen, el crecimiento de las bases de datos con el versionado de filas se debe tanto al almacenamiento de las versiones anteriores de las filas en sí (dentro de la base de datos con ADR, o en TempDB con RCSI) como al overhead de un puntero de 14 bytes añadido a cada fila en la base de datos de usuario para referenciar este almacén de versiones. Es crucial tener en cuenta estas implicaciones de almacenamiento al planificar la implementación de estas funcionalidades.

¿Reconstruir índices para ahorrar espacio? Una ilusión temporal

Ante este crecimiento acelerado de las tablas con ADR y RCSI, la reacción natural sería pensar en la reconstrucción de índices como una solución para recuperar el espacio «perdido». Y, efectivamente, al reconstruir los índices en estas tablas infladas, su tamaño volvía a los valores iniciales, dando la sensación de haber «ahorrado» espacio en disco.

Sin embargo, esta ganancia de espacio es puramente ilusoria y temporal. En cuanto la carga de trabajo habitual se reanudaba y se volvían a realizar actualizaciones, el tamaño de las tablas con ADR y RCSI volvía a inflarse rápidamente. Nos encontrábamos en un ciclo sin fin de crecimiento y reconstrucción, sin abordar la causa fundamental del aumento de tamaño.

La clave para entender esta dinámica reside en la forma en que ADR y RCSI gestionan el versionado de filas. Al mantener las versiones antiguas de las filas modificadas, es inevitable que el espacio ocupado por la tabla crezca con la actividad de escritura. La reconstrucción de índices simplemente reorganiza los datos y elimina las versiones antiguas que ya no son necesarias en el momento de la reconstrucción, pero no evita que se generen nuevas versiones con futuras modificaciones. Por lo tanto, si nuestro objetivo es «ahorrar» espacio mediante la reconstrucción de índices en un entorno con ADR o RCSI, debemos entender que este ahorro será efímero. El espacio «ahorrado» volverá a ser necesario a medida que se generen nuevas versiones de las filas.

¿Reconstruir índices como en 2005? Los tiempos cambian

Esta observación nos lleva a una reflexión importante sobre nuestras prácticas de mantenimiento. Si seguimos reconstruyendo índices como si estuviéramos en 2005, pensando que estamos logrando una mejora significativa en términos de espacio en disco y rendimiento, es hora de detenernos y reconsiderar nuestra estrategia. Las mejores prácticas evolucionan con los nuevos avances de la tecnología.

La evolución de las mejores prácticas nos indica que la obsesión por la utilización del espacio en disco a menudo nos lleva a tratar los síntomas, como la hinchazón de las tablas, en lugar de la causa subyacente, que en entornos con ADR y RCSI es el versionado de filas necesario para su funcionamiento. Reconstruir índices regularmente en estos entornos puede ser una solución ilusoria para el espacio , ya que el espacio ganado se volverá a utilizar rápidamente a medida que la carga de trabajo genere nuevas versiones de las filas. 

Incluso podría ser contraproducente a largo plazo si se realiza sin una justificación real de mejora del rendimiento, especialmente considerando la menor penalización por fragmentación en unidades de estado sólido (SSD), que ofrecen tiempos de acceso aleatorio mucho más rápidos que los discos duros tradicionales (HDD). Además en entornos con almacenamiento virtualizado, la contigüidad física de los datos es aún menos común y tiene menos relevancia la fragmentación de los índices.

Casos donde la reconstrucción sí tiene sentido 

Existen casos específicos donde la reconstrucción sí tiene sentido, pero son menos comunes. Por ejemplo, cuando se insertan inicialmente filas con muchos valores nulos que posteriormente se actualizan y ya no se modifican. En estos casos una reconstrucción podría compactar las páginas y liberar espacio que ya no es necesario. Sin embargo, en la mayoría de los escenarios con ADR o RCSI habilitados, si nuestro principal objetivo al reconstruir índices es ganar espacio en disco, las ganancias serán en gran medida temporales e insignificantes. Debemos enfocarnos en el problema real que estamos tratando de resolver: ¿es el espacio en disco o el rendimiento de las consultas? En muchos casos, ADR y RCSI están diseñados para mejorar la concurrencia y la disponibilidad, lo que podría reducir la necesidad de reconstrucciones de índices frecuentes con fines de rendimiento, especialmente en combinación con un hardware de almacenamiento adecuado.

Conclusión

Los experimentos que he realizado nos muestran claramente que la reconstrucción de índices en bases de datos con ADR y/o RCSI activados tiene un impacto diferente al que estábamos acostumbrados. Si bien inicialmente puede parecer que recuperamos espacio en disco, este ahorro es fugaz, ya que la propia naturaleza del versionado de filas hará que las tablas vuelvan a crecer con la actividad de escritura.

Es fundamental que nosotros, como profesionales de bases de datos, comprendamos a fondo cómo funcionan estas nuevas características y cómo impactan en nuestras tareas de mantenimiento. En lugar de seguir ciegamente las prácticas del pasado, debemos analizar el problema real que intentamos resolver. Si el aumento de tamaño de nuestras tablas es una consecuencia directa del versionado de filas necesario para ADR y RCSI, quizás la solución no sea reconstruir índices constantemente, sino dimensionar adecuadamente nuestro almacenamiento y enfocar nuestros esfuerzos en otras áreas de optimización.

En definitiva, la llegada de ADR y RCSI nos invita a replantearnos nuestras rutinas de mantenimiento de índices. Entender el mecanismo subyacente del versionado de filas es crucial para tomar decisiones informadas y evitar invertir tiempo y recursos en acciones que nos ofrecen solo una sensación temporal de mejora. La evolución de SQL Server nos exige una evolución en nuestra forma de gestionarlo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 0 comentarios

¿Por qué usar SSAS o Azure Analysis Services (AAS) en 2025?

Estamos viviendo la época dorada de los datos, la toma de decisiones basada en datos se ha convertido en un pilar fundamental para las organizaciones que buscan competitividad y eficiencia, por no hablar de la inteligencia artificial y el machine learning no serían nada sin datos. Esto ha llevado a una necesidad cada vez más creciente de datos, pero no datos de cualquier manera, la necesidad de herramientas que permitan el modelado y análisis avanzados es más crítica que nunca. En este sentido, SQL Server Analysis Services (SSAS) y Azure Analysis Services (AAS) continúan siendo soluciones clave para transformar datos en información estratégica.

En este artículo, quiero intentar responder a la pregunta ¿por qué SSAS y AAS siguen siendo relevantes en 2025? Para ello vamos a hablar de sus beneficios, y cuándo optar por una solución on-premises o en la nube.

La evolución del análisis de datos y la relevancia de SSAS/AAS

Con el crecimiento de plataformas de datos como Microsoft Fabric, Power BI y Synapse Analytics, es normal preguntarse si SSAS o AAS siguen siendo relevantes. La respuesta corta es sí, y la larga es que su uso ha evolucionado para adaptarse a nuevos escenarios.

SSAS y AAS siguen siendo las mejores soluciones para modelos de datos semánticos con alta reutilización y complejidad. Los modelos analíticos requieren rendimiento, escalabilidad, seguridad y gobernanza de primer nivel, y estas tecnologías lo ofrecen mejor que muchas alternativas.

Tendencias que refuerzan la importancia de SSAS y AAS:

La demanda de análisis de datos en tiempo real ha crecido significativamente, impulsando el uso de modelos híbridos que combinan almacenamiento en memoria con consultas en vivo a bases de datos. Al mismo tiempo, la necesidad de modelos escalables que puedan soportar miles de usuarios simultáneamente hace que soluciones como SSAS y AAS sean fundamentales para empresas de gran tamaño. Además, estas herramientas siguen desempeñando un papel clave en la integración con otras plataformas de Microsoft como Power BI, SQL Server, Synapse Analytics y Azure Data Lake, lo que refuerza su importancia en arquitecturas modernas de inteligencia empresarial.

Beneficios de SSAS y AAS

Uno de los principales motivos por los que SSAS y AAS siguen siendo relevantes es su capacidad para ofrecer un rendimiento excepcional en el análisis de datos. Gracias a la tecnología VertiPaq, los modelos tabulares permiten consultas rápidas mediante compresión y almacenamiento en memoria. Esto es crucial en un contexto donde los usuarios esperan tiempos de respuesta inmediatos en sus informes y dashboards.

Otro aspecto fundamental es la capacidad de manejar grandes volúmenes de información de manera eficiente. Los modelos en SSAS y AAS pueden procesar billones de filas sin comprometer el rendimiento, algo que sigue siendo una ventaja en comparación con otras soluciones. Aunque Power BI Premium y Fabric han mejorado en este aspecto, SSAS y AAS continúan siendo superiores para centralizar y administrar modelos de datos complejos que requieren alto rendimiento y reutilización en múltiples reportes.

La seguridad es otro factor determinante. Este 2025, la protección de datos debería ser una prioridad para todas las organizaciones. Tanto SSAS como AAS permiten la implementación de mecanismos avanzados de seguridad, como Row-Level Security (RLS) y Object-Level Security (OLS), lo que garantiza que cada usuario acceda únicamente a la información que le corresponde. Esta capacidad es especialmente valiosa en entornos empresariales donde la confidencialidad de los datos es crítica.

Por último, la integración con otras herramientas sigue siendo una de sus grandes ventajas. SSAS y AAS se conectan de manera nativa con Power BI, SQL Server, Azure Synapse Analytics y Data Factory, facilitando la creación de soluciones analíticas robustas y escalables. La posibilidad de definir modelos semánticos reutilizables permite a las empresas garantizar la consistencia de los datos en toda la organización, evitando la duplicación de esfuerzos y asegurando que todos los usuarios trabajen con la misma información consolidada.

¿SSAS o AAS? ¿On-premises o en la nube?

La elección entre SSAS (on-premises) y AAS (Azure) depende del contexto de cada empresa. Los factores clave siguen siendo coste, escalabilidad, mantenimiento y requisitos de seguridad.

¿Cuándo elegir SSAS?

Es cierto que la nube se está imponiendo como solución pero aún quedan casos donde puede ser recomendable una solución local como SSAS. Si la empresa sigue operando mayormente on-premises y no ha migrado a la nube o si tenemos licenciamiento de SQL Server con SSAS ya incluido SSAS puede ser mejor solución que AAS. Además, con esta solución tendremos el máximo control sobre la infraestructura y cumpliremos con los requisitos de esos escenarios con estrictos requisitos de seguridad que impiden almacenar datos en la nube ya sea por legislación o políticas de empresa. En este último caso podremos combinar SSAS con PBIRS todo el local.

¿Cuándo elegir AAS?

Por el contrario, si la empresa ya usa Azure y otros servicios en la nube o si necesitamos escalabilidad dinámica sin administrar servidores AAS es una solución que puede reducir costes en mantenimiento y licencias on-premises. Si usamos Power BI o Fabric en la nube también podremos aprovechar la integración nativa con AAS.

¿Y Microsoft Fabric? ¿Sustituye a AAS?

Microsoft Fabric ha introducido un nuevo paradigma con Power BI Semantic Models, que combina capacidades de SSAS/AAS con Power BI Premium. Sin embargo, AAS sigue siendo la mejor opción en entornos donde se requiere máxima flexibilidad y control sobre modelos semánticos.

Conclusión

A pesar de la evolución de las plataformas de datos en la nube, SSAS y AAS siguen siendo fundamentales en arquitecturas de BI modernas. Su capacidad para ofrecer modelos de datos centralizados, rendimiento óptimo y seguridad avanzada los mantiene como una opción relevante para empresas que buscan eficiencia en el análisis de datos.

Si la empresa opera on-premises, SSAS sigue siendo una opción válida. Por el contrario, si la estrategia es cloud-first, AAS ofrece flexibilidad y escalabilidad sin preocuparse por infraestructura. Si se usa Power BI, Microsoft Fabric puede ser una alternativa para simplificar la arquitectura, aunque AAS sigue siendo preferible en entornos empresariales grandes.

En resumen, SSAS y AAS continúan siendo pilares del análisis de datos en 2025, y su relevancia dependerá del contexto y la estrategia de cada organización. La clave está en aprovechar su potencia para construir soluciones analíticas de alto rendimiento, integradas con las últimas tecnologías de Microsoft.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Power BI, 0 comentarios

SQL Server Analysis Services (SSAS)

SQL Server Analysis Services (SSAS) es una de las tecnologías más robustas y flexibles para el análisis de datos en el ecosistema Microsoft. Desde su introducción en 1998 como OLAP Services (parte de SQL Server 7), ha evolucionado hasta convertirse en un pilar fundamental para la inteligencia empresarial (BI), proporcionando capacidades avanzadas para el modelado y la explotación de datos. En este artículo, os quiero introducir SSAS como herramienta, sus modelos, arquitectura y buenas prácticas para su implementación.

Introducción a SSAS

SSAS es una solución de Microsoft para la creación de modelos analíticos que permiten consultas optimizadas sobre grandes volúmenes de datos. Se integra con el ecosistema de SQL Server y herramientas como Power BI, Excel y otros clientes de BI. Su propósito es ofrecer un rendimiento excepcional en la consulta de datos y permitir cálculos complejos con una estructura optimizada.

Existen dos modos principales en los que SSAS puede operar el multidimensional y el tabular.

Modelos de SSAS: Multidimensional vs. Tabular

La elección entre los modelos multidimensional y tabular depende de diversos factores como el volumen de datos, la complejidad del análisis y la facilidad de uso.

Modelo Multidimensional (OLAP)

El clásico modelo analítico utiliza cubos y dimensiones para organizar la información de manera jerárquica. Se basa en la idea de organizar los datos en cubos OLAP (Online Analytical Processing), donde cada cubo representa un conjunto de datos preprocesados y optimizados para consultas analíticas rápidas. Estos cubos contienen medidas numéricas (como ventas o ingresos) y dimensiones (como tiempo, ubicación o producto), que permiten a los usuarios explorar la información desde múltiples perspectivas. Estos cubos pueden almacenarse como MOLAP (Multidimensional OLAP), ROLAP (Relational OLAP) o HOLAP (Hybrid OLAP). Gracias a esta arquitectura, las consultas se ejecutan con una latencia mínima, permitiendo análisis complejos como agregaciones, drill-downs y cálculos avanzados sin afectar el rendimiento de la base de datos transaccional. Por cierto, estas consultas son expresiones MDX (Multidimensional Expressions), que es el lenguaje de consulta optimizado para OLAP. 

Como ventajas del Modelo Multidimensional podemos destacar su alto rendimiento en consultas agregadas preprocesadas y el soporte avanzado para modelado complejo de datos lo que lo hacen ideal para escenarios con jerarquías bien definidas.

Como desventajas del Modelo Multidimensional tenemos una curva de aprendizaje elevada debido a la necesidad de conocer MDX y una mayor complejidad en la administración y diseño de modelos que con otras alternativas.

Modelo Tabular (In-Memory)

Un modelo tabular en SQL Server Analysis Services (SSAS) es un enfoque más moderno para el análisis de datos que utiliza una arquitectura en memoria basada en el motor VertiPaq (si, igual que Power BI), optimizado para consultas de alto rendimiento. A diferencia del modelo multidimensional, el modelo tabular almacena los datos en formato columnar en lugar de estructuras de cubo preprocesadas, lo que permite una mayor comprensión y rapidez en las consultas. Se basa en tablas y relaciones, similar a un modelo relacional, y emplea el lenguaje DAX (Data Analysis Expressions) para la creación de cálculos y medidas. Su flexibilidad y facilidad de desarrollo lo han convertido en una alternativa popular al modelo multidimensional, ya que permite una integración más sencilla con herramientas de BI como Power BI y Excel, facilitando el análisis de datos sin la complejidad de los cubos OLAP tradicionales.

Como ventajas del Modelo Tabular destacaría su mayor facilidad de desarrollo en comparación con el modelo multidimensional (DAX es más sencillo que MDX), sus excelentes tiempos de respuesta debido a su estructura en memoria y su mejor integración con herramientas modernas como Power BI.

Por el contrario, las desventajas principales del Modelo Tabular son el consumo de memoria más elevado en modelos de gran tamaño y las limitaciones en la gestión de relaciones complejas en comparación con OLAP.

Arquitectura de SSAS

SSAS opera bajo una arquitectura de servidor que permite múltiples conexiones concurrentes de usuarios y herramientas de BI. La arquitectura básica que tenemos que tener clara antes de empezar incluye la o las fuentes de datos, es decir el origen de los datos (que puede ser de SQL Server, Azure SQL Database, Oracle, Teradata, entre otros) y el modelo de datos. Obviamente estos datos se van a introducir en un modelo de datos de SSAS mediante un cubo OLAP o un modelo tabular (en estrella a poder ser 🙂).

Una vez con esto definido llega la parte del modelado. En SSAS la información se procesa y se almacena en SSAS en formatos optimizados. En este punto igual hay que hacer algunas consultas a través de MDX (para OLAP) o DAX (para modelos tabulares) para terminar de pulir detalles antes de conectar nuestros clientes BI que serán herramientas como Power BI, Excel, Reporting Services y aplicaciones personalizadas consumen los modelos de SSAS.

Prácticas recomendadas en la implementación de SSAS

Al diseñar una solución con SSAS, es importante seguir ciertas recomendaciones para garantizar rendimiento y escalabilidad. Tenemos que tener en cuenta que estas aplicaciones analíticas van a almacenar y operar con gran cantidad de datos y por tanto definir un buen modelo de datos es fundamental. Tendremos que prestar especial atención para evitar redundancias y asegurar integridad referencial. En modelos tabulares, minimizar el uso de columnas de texto para optimizar la compresión.

A la hora de optimizar el rendimiento en OLAP utilizaremos agregaciones para reducir el tiempo de consulta mientras que en modelos tabulares, buscaremos reducir la cardinalidad de las columnas para mejorar la compresión. También podemos implementar particionamiento en modelos grandes para mejorar el procesamiento.

En cuanto a seguridad, podremos configurar roles y permisos en SSAS para restringir el acceso a datos sensibles. Si queremos ir más allá tenemos también Row-Level Security en modelos tabulares para aplicar filtros por usuario.

Y para cerrar este apartado, como no podía ser de otra manera, tenemos que hablar de la monitorización del uso de memoria y CPU sobre todo en entornos productivos.

SSAS en la Nube: Azure Analysis Services

Como ha pasado con otros servicios, Microsoft también ha llevado SSAS a la nube de Azure con Azure Analysis Services (AAS), ofreciendo las mismas capacidades de modelado de datos pero con las ventajas adicionales propias de Azure. Estas son la escalabilidad dinámica según la demanda de consultas, la integración con servicios de Azure como Azure SQL Database y Azure Synapse Analytics y el modelo de pago por uso sin necesidad de administrar infraestructura.

Para organizaciones que buscan reducir costes de mantenimiento y beneficiarse de la flexibilidad de la nube, Azure Analysis Services es una excelente opción.

Conclusión

SSAS sigue siendo una herramienta clave para arquitecturas de BI en empresas de todos los tamaños. Su capacidad para manejar grandes volúmenes de datos y realizar análisis avanzados lo convierte en una opción robusta tanto en entornos on-premises como en la nube. La elección entre modelo tabular o multidimensional dependerá de los requisitos del negocio y la facilidad de integración con otras herramientas.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Power BI, 1 comentario

Fin del soporte de SQL Server 2019: ¿Qué Significa?¿Qué Cambia?

El pasado viernes 28 de febrero de 2025 marcó un hito en la historia de SQL Server 2019: finalizó su soporte estándar. Aunque todavía queda el soporte extendido hasta el 8 de enero de 2030, este cambio tiene implicaciones significativas para las empresas que aún dependen de esta versión. Además, el jueves 27 de febrero se lanzó la última Cumulative Update (CU32) para SQL Server 2019, lo que significa que ya no habrá más actualizaciones regulares para esta versión.

En este artículo, quiero aprovechar esta noticia para explicar las diferencias entre el soporte estándar y extendido, y además veremos qué implica la última CU, y analizaremos las características que han desaparecido oficialmente con SQL Server 2019.

Diferencias entre el soporte estándar y el soporte extendido

Como norma general, Microsoft ofrece dos niveles de soporte para sus productos empresariales, el soporte estándar y el soporte extendido. Cada uno tiene un propósito diferente y afecta la forma en que las empresas deben gestionar sus sistemas.

Soporte estándar: Actualizaciones y asistencia completa

El soporte estándar, que terminó el 28 de febrero de 2025 para SQL Server 2019, es el más completo y proporciona actualizaciones completas, soporte y mejoras. 

Durante este período, Microsoft lanza regularmente actualizaciones de seguridad y funcionalidad que corrigen vulnerabilidades y mejoran el rendimiento del software.

En lo relativo al soporte técnico, se ofrece asistencia gratuita por parte de Microsoft a través de distintos canales, incluyendo documentación.

Además, se publican Service Packs y Cumulative Updates con mejoras significativas en compatibilidad y rendimiento.

En resumen, durante este tiempo de soporte estándar, cualquier incidencia puede ser reportada y Microsoft trabaja activamente en resolver errores críticos y mejorar el rendimiento.

Soporte extendido: Solo parches de seguridad

A partir de ahora, SQL Server 2019 entra en la fase de soporte extendido, que dura hasta el 8 de enero de 2030. Este periodo implica cambios importantes en las actualizaciones y soporte, aunque no desaparezcan del todo.

Por ejemplo, no habrá más mejoras de funcionalidad. Las únicas actualizaciones serán parches de seguridad críticos.

En relación con el soporte técnico, la asistencia por parte de Microsoft ya no es gratuita y requiere un contrato especial.

Además, a partir de este punto ya no se garantizarán ajustes para nuevas versiones de Windows Server o entornos en la nube, es decir, la compatibilidad pasa a ser limitada.

Para las empresas que aún dependen de SQL Server 2019, esto significa que deben considerar seriamente una migración a una versión más reciente, como SQL Server 2022 o Azure SQL, para garantizar la seguridad y estabilidad de sus bases de datos.

Última Cumulative Update para SQL Server 2019

Un dia antes del fin de soporte estándar, el jueves 27 de febrero de 2025, Microsoft lanzó la última Cumulative Update (CU32) para SQL Server 2019. Es un paquete de actualización que incluye correcciones de errores, optimizaciones de rendimiento y mejoras de seguridad. Sin embargo, ahora que el soporte estándar ha terminado, no habrá más CUs regulares para SQL Server 2019.

Las empresas deben asegurarse de aplicar esta última actualización lo antes posible para garantizar que su entorno SQL Server 2019 esté en la mejor condición posible antes de entrar en la fase de soporte extendido.

Características eliminadas en SQL Server 2022

Con la llegada de SQL Server 2022, Microsoft ha eliminado algunas funcionalidades que habían sido introducidas en versiones anteriores pero que no lograron una adopción significativa. La más notable es Big Data Cluster (BDC), una solución que permitía la integración de SQL Server con entornos de big data basados en Kubernetes.

Adiós a Big Data Cluster

5 años ha durado esta característica que introdujo SQL Server 2019. La idea era buena, una solución para ejecutar cargas de trabajo analíticas en clústeres de datos distribuidos con tecnologías como Spark y HDFS. Sin embargo, con SQL Server 2022, Microsoft ha descontinuado esta característica, lo que significa que ya no hay soporte oficial para BDC. No hace falta hacer muchas conjeturas, el enemigo estaba en casa con las soluciones en la nube que Microsoft comercializa con las mismas funciones que BCD.

Por tanto, las empresas que aún dependen de Big Data Cluster deben considerar alternativas como Azure Synapse Analytics que ofrece capacidades similares para análisis de grandes volúmenes de datos, Apache Spark en Azure Databricks para entornos que necesitan procesamiento distribuido y Data Lake en Azure como repositorio de datos escalable. O, la solución más sencilla, Microsoft Fabric, con todas esas funcionalidades integradas en un mismo sistema.

¿Qué deben hacer las empresas ahora?

Con el fin del soporte estándar de SQL Server 2019 y la eliminación de características clave en SQL Server 2022, las organizaciones deben tomar decisiones estratégicas para sus entornos de base de datos. 

En primer lugar hay que aplicar la última CU de SQL Server 2019. Mientras se plantean otras opciones es clave asegurarse de que el sistema esté en la versión más reciente antes de la fase de soporte extendido.

Una vez con SQL Server con la CU 32 es el momento de evaluar una actualización a SQL Server 2022 o migrar a Azure para continuar recibiendo soporte completo y acceder a nuevas funcionalidades. Si la infraestructura lo permite, mover cargas de trabajo a la nube puede ser una opción atractiva pero, si deseamos (o necesitamos) continuar en entornos locales SQL Server 2022 es la única opción posible.

Por último, si estás utilizando Big Data Cluster es momento de comparar las alternativas en las opciones que nos da Microsoft en Azure o Fabric.

Conclusión

El fin del soporte estándar de SQL Server 2019 marca un punto de inflexión para muchas empresas. Aunque todavía quedan casi cinco años de soporte extendido, la falta de actualizaciones de funcionalidad y el coste del soporte técnico pueden hacer que la actualización a SQL Server 2022 o la migración a Azure SQL sea la mejor opción. Además, la desaparición de Big Data Cluster confirma la tendencia de Microsoft de enfocarse en soluciones más modernas en la nube para el análisis de grandes volúmenes de datos.

Es el momento ideal para planificar una estrategia de actualización y asegurarse de que la infraestructura de bases de datos esté preparada para el futuro.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Tipos de datos de texto en SQL Server

El manejo de datos de texto en SQL Server es una tarea fundamental que influye en la eficiencia del almacenamiento y en el rendimiento de las consultas. Los textos son prácticamente el tipo de datos más común pero no por ello menos importante. Elegir el tipo de dato correcto no solo optimiza el uso del espacio y mejora la velocidad de acceso, sino que también evita problemas de conversión y compatibilidad. Para ponérselo difícil, SQL Server proporciona varios tipos de datos para almacenar texto, cada uno con características específicas que los hacen adecuados para distintos escenarios.

Tipos de datos de texto en SQL Server

SQL Server ofrece distintos tipos de datos para almacenar texto. Clasificándolos en grupos podríamos hablar de los tipos de longitud fija y los de longitud variable. Además según sus características podríamos también hablar de los tipos grandes y unos que no se deberían usar porque ya están deprecados y solo se mantienen por compatibilidad. 

Tipos de longitud fija y variable

Estos tipos de datos son los más comunes en bases de datos relacionales, ya que permiten definir el tamaño del almacenamiento y optimizar el uso del espacio.

CHAR y VARCHAR

Los tipos CHAR y VARCHAR almacenan texto en formato de un solo byte por carácter, utilizando una codificación específica como Latin1_General.

El tipo CHAR siempre ocupa el número de bytes definidos en su declaración, sin importar la cantidad real de caracteres almacenados. Si se define una columna como CHAR(50), cada fila ocupará exactamente 50 bytes, rellenando con espacios si el contenido es menor. Este comportamiento es eficiente en datos de longitud fija, como códigos de país o identificadores.

Por otro lado, VARCHAR permite almacenar texto de longitud variable, reservando sólo los bytes necesarios para cada valor más un pequeño encabezado que indica la longitud. Si una columna está definida como VARCHAR(50) pero el valor almacenado solo tiene 10 caracteres, SQL Server solo reservará esos 10 bytes más los metadatos, reduciendo el desperdicio de espacio.

NCHAR y NVARCHAR

A diferencia de CHAR y VARCHAR, los tipos NCHAR y NVARCHAR utilizan Unicode, lo que les permite almacenar caracteres de múltiples alfabetos en el mismo sistema. Para poder hacer esto, cada carácter en estos tipos ocupa dos bytes en lugar de uno.

NCHAR es un tipo de longitud fija, similar a CHAR, pero con soporte Unicode. NVARCHAR, en cambio, almacena sólo los caracteres necesarios y se recomienda para datos de texto multilingües de longitud variable. Si la base de datos necesita almacenar nombres internacionales, direcciones o cualquier otro dato que pueda incluir caracteres especiales, NVARCHAR es la opción más adecuada.

Tipos de datos de texto de gran tamaño

Para almacenar grandes volúmenes de texto, SQL Server proporciona variantes especializadas de VARCHAR y NVARCHAR, así como los tipos TEXT y NTEXT, que están en desuso.

VARCHAR(MAX) y NVARCHAR(MAX)

SQL Server introdujo VARCHAR(MAX) y NVARCHAR(MAX) para permitir el almacenamiento de texto de longitud variable sin las restricciones de VARCHAR(n). Estos tipos pueden contener hasta 2 GB de datos, lo que los hace ideales para almacenar grandes documentos, descripciones extensas o datos textuales sin una longitud definida.

El motor de SQL Server optimiza el almacenamiento de estos tipos dependiendo de su tamaño. Si el contenido es menor a 8 KB, se almacena directamente en la página de datos de la tabla, al igual que VARCHAR(n). Sin embargo, si el valor excede ese límite, SQL Server lo almacena en páginas separadas (páginas LOB) y guarda una referencia en la tabla principal, lo que puede afectar el rendimiento de ciertas consultas.

TEXT y NTEXT (deprecados)

En versiones anteriores de SQL Server (pero muy antiguas), los tipos TEXT y NTEXT se utilizaban para almacenar grandes volúmenes de texto. Sin embargo, estos tipos fueron declarados obsoletos a partir de SQL Server 2005 y ya no se recomiendan para nuevas implementaciones.

El problema principal con TEXT y NTEXT es que SQL Server los trata como objetos separados de la tabla principal, lo que hace que las consultas sobre estos datos sean menos eficientes. Además, su manipulación es más compleja, ya que muchas funciones de texto estándar como LEN() o SUBSTRING() no funcionan directamente sobre estos tipos sin una conversión previa. 

Dado que VARCHAR(MAX) y NVARCHAR(MAX) ofrecen una alternativa más flexible y optimizada, se recomienda migrar cualquier columna TEXT o NTEXT a estos nuevos tipos.

Impacto del almacenamiento y rendimiento según el tipo de datos

El almacenamiento eficiente de los datos de texto es clave para el rendimiento de SQL Server. Todos los datos en SQL Server se almacenan en páginas de 8 KB, lo que significa que la elección del tipo de dato afecta la cantidad de información que cabe en cada página y, por lo tanto, la velocidad de acceso y manipulación de los datos.

Los tipos de longitud fija, como CHAR y NCHAR, pueden desperdiciar espacio si los valores almacenados son más cortos de lo esperado. Sin embargo, su acceso es más rápido en ciertos escenarios, ya que SQL Server sabe exactamente dónde empieza cada registro sin necesidad de calcular su tamaño. Esto es útil en columnas con valores homogéneos en longitud.

Los tipos de longitud variable, como VARCHAR y NVARCHAR, optimizan el uso del espacio, pero pueden introducir fragmentación en el almacenamiento, especialmente si los valores cambian de tamaño con frecuencia. En bases de datos de alto rendimiento, esto puede afectar la eficiencia de las consultas.

Por último, el uso de VARCHAR(MAX) y NVARCHAR(MAX) debe ser solo para casos puntuales e imprescindibles, ya que, cuando los valores almacenados superan los 8 KB, SQL Server los mueve a páginas de datos separadas, lo que puede ralentizar las consultas. Si es posible, es preferible definir una longitud específica en VARCHAR(n) o NVARCHAR(n) para mantener el rendimiento. Además, estos tipos de datos de gran tamaño no se pueden indexar con índices “normales” y si necesitamos filtrar por ellos tendremos que recurrir a los Full-Text Index

Conversiones de tipos de datos

Una de las mejores y a la vez peores cosas que ponen a nuestra disposición las bases de datos es la conversión implícita entre tipos de datos de texto. Mejores porque nos simplifica mucho la vida pero cuidado porque es un arma de doble filo. Todo lo que ganas en simplicidad lo pierdes en rendimiento. Cuando SQL Server compara valores con diferentes tipos, realiza conversiones automáticas que pueden afectar el rendimiento.

Si una columna está definida como VARCHAR y se compara con un valor NVARCHAR, SQL Server convierte automáticamente la columna completa a Unicode antes de ejecutar la consulta. Este proceso puede forzar un escaneo completo de la tabla en lugar de permitir el uso de índices optimizados, ralentizando significativamente las búsquedas.

Para evitar este problema, es fundamental asegurarse de que las comparaciones se realicen con tipos de datos compatibles. Si una columna es VARCHAR, los valores en las consultas deben ser también VARCHAR, y si es NVARCHAR, deben llevar el prefijo N para indicar que son Unicode.

También es importante evitar concatenaciones que provoquen conversiones innecesarias. Si una operación de concatenación involucra un valor NVARCHAR, todo el resultado se convierte a Unicode, lo que puede aumentar el uso de memoria y afectar el rendimiento.

Conclusión

SQL Server ofrece varias opciones para almacenar datos de texto, cada una con ventajas y desventajas según el escenario de uso. CHAR y NCHAR son adecuados para datos de longitud fija, mientras que VARCHAR y NVARCHAR son más eficientes para texto variable. Para grandes volúmenes de datos, VARCHAR(MAX) y NVARCHAR(MAX) proporcionan flexibilidad sin las limitaciones de los tipos TEXT y NTEXT, que ya están obsoletos.

La correcta elección del tipo de dato de texto tiene un impacto directo en el almacenamiento, la velocidad de consulta y la eficiencia del sistema. Comprender las diferencias entre estos tipos y sus implicaciones en el rendimiento es clave para diseñar bases de datos eficientes y escalables.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Niveles de compatibilidad de las bases de datos

Hoy me he encontrado con un caso que es más habitual del que me gustaría y quería compartirlo con vosotros y ver qué podemos aprender de él. Estaba revisando el servidor de un cliente que nunca ha tenido un DBA, era un SQL Server 2022 Standard que había montado su equipo de IT. El caso es que, aun siendo un SQL Server 2022, todas las bases de datos estaban en nivel de compatibilidad 100, es decir en el modo de funcionamiento propio de SQL Server 2008. Al preguntar, me han contado que desde su primer SQL Server 2008 su informático siempre había ido aplicando las actualizaciones y subidas de versiones cuando era necesario pero claro, no sabían que había que cambiar nada en las bases de datos. 

Este caso que os cuento no es excepcional, y muchos administradores de bases de datos han pasado por situaciones similares. Tener bases de datos en un SQL Server moderno pero con un nivel de compatibilidad antiguo es más común de lo que parece. Pero, ¿qué implica esto realmente? ¿Por qué es importante gestionar correctamente los niveles de compatibilidad? Vamos a profundizar en este tema y en las consideraciones clave antes de realizar cualquier cambio.

¿Qué es el Nivel de Compatibilidad en SQL Server?

El nivel de compatibilidad de una base de datos en SQL Server define qué conjunto de características y comportamientos del motor de base de datos están habilitados para esa base de datos en particular. Microsoft SQL Server introduce constantemente nuevas funcionalidades y mejoras en el motor de consulta con cada versión. Sin embargo, para evitar problemas de compatibilidad con aplicaciones antiguas, permite mantener una base de datos funcionando con un conjunto de reglas de versiones anteriores.

Por ejemplo, una base de datos con nivel de compatibilidad 100 (SQL Server 2008) ejecutada en un SQL Server 2022 seguirá comportándose en muchos aspectos como si estuviera en SQL Server 2008. Esto puede parecer una buena idea para garantizar que las consultas y procedimientos almacenados antiguos sigan funcionando sin problemas, pero también significa renunciar a muchas mejoras de rendimiento y nuevas funcionalidades del motor de base de datos.

¿Por qué es importante el Nivel de Compatibilidad?

El nivel de compatibilidad afecta aspectos fundamentales del comportamiento de SQL Server, incluyendo el optimizador de consultas, nuevas funciones y sintaxis de T-SQL y mejoras en la seguridad y el rendimiento general.

Como sabéis, SQL Server introduce mejoras constantes en el optimizador de consultas en cada nueva versión del producto. Mantener un nivel de compatibilidad antiguo significa que las consultas podrían no beneficiarse de los nuevos algoritmos y estrategias de ejecución de consultas. Además, algunas funciones y tipos de datos más modernos pueden no estar disponibles en niveles de compatibilidad antiguos.

En cuanto a seguridad, Microsoft mejora continuamente la seguridad en SQL Server, y algunas de estas mejoras solo están disponibles en niveles de compatibilidad más recientes. Lo mismo pasa con el rendimiento, características como Batch Mode on Rowstore, Adaptive Query Processing, Memory Grant Feedback, entre muchas otras, solo están habilitadas en niveles de compatibilidad más recientes.

El cambio clave con el Nivel de Compatibilidad 120 (SQL Server 2014)

Uno de los cambios más significativos en la historia de los niveles de compatibilidad de SQL Server ocurrió con SQL Server 2014 (Nivel 120). Microsoft rediseñó por completo el comportamiento del optimizador de consultas con la introducción del nuevo estimador de cardinalidad.

¿Qué es el estimador de cardinalidad y por qué es importante?

El estimador de cardinalidad es el componente del optimizador de consultas que predice cuántas filas se van a procesar en cada paso de una consulta. Estas predicciones, basadas entre otras cosas en las estadísticas, influyen directamente en la selección de planes de ejecución eficientes.

Con SQL Server 2014, Microsoft cambió la forma en que se estiman las filas, lo que en muchos casos mejoró el rendimiento, pero en otros, los menos, generó degradaciones inesperadas. Por eso, al cambiar el nivel de compatibilidad de 110 (SQL Server 2012) a 120 (SQL Server 2014), algunos planes de ejecución cambiaron drásticamente. Si tu base de datos aún se encuentra en un nivel de compatibilidad antiguo (110 o inferior), al actualizar a 120 o superior, es crucial revisar los planes de ejecución antes de aplicar el cambio en producción.

Impacto del Nivel de Compatibilidad 120 en los planes de mantenimiento

Otro cambio relevante con SQL Server 2014 y su nivel de compatibilidad 120 fue cómo se comportaban los planes de mantenimiento. Antes de SQL Server 2014, muchas bases de datos dependían de planes de mantenimiento que ejecutaban reconstrucción y reorganización de índices, estadísticas de actualización y otras tareas rutinarias de mantenimiento. Sin embargo, al actualizar a SQL Server 2014 con nivel de compatibilidad 120, muchos de estos procesos cambiaron significativamente debido a un nuevo comportamiento en la actualización de estadísticas

En versiones anteriores, las estadísticas se actualizaban con una heurística más básica basada en el número de cambios en los índices. A partir de SQL Server 2014, Microsoft introdujo un algoritmo mejorado que ajusta automáticamente la frecuencia de actualización de estadísticas en función de la variabilidad de los datos. Esto significa que algunos planes de mantenimiento antiguos pueden volverse ineficientes, ya que las estadísticas pueden actualizarse con menor frecuencia de lo esperado.

Cambios en la fragmentación de índices

También, antes de SQL Server 2014, los DBA solíamos programar reconstrucción y reorganización de índices en intervalos fijos. Sin embargo, con el nuevo estimador de cardinalidad, algunas consultas que antes se beneficiaban de la reconstrucción de índices ya no requieren mantenimiento tan frecuente, mientras que otras pueden necesitar ajustes más específicos.

Nuevo comportamiento en las esperas de consultas y la concesión de memoria

SQL Server 2014 introdujo Memory Grant Feedback, que ajusta dinámicamente la memoria asignada a las consultas. Este cambio afectó la manera en que los planes de mantenimiento deben ejecutarse en bases de datos de gran tamaño, ya que ahora SQL Server aprende con el tiempo y puede mejorar la asignación de memoria en ejecuciones repetitivas. Sin embargo, si por una actualización de estadísticas o mantenimiento de índices el plan se recompila todos esos cálculos ya no valen.

¿Cómo adaptar los planes de mantenimiento?

Si decides actualizar el nivel de compatibilidad a 120 o superior, es recomendable revisar y adaptar los planes de mantenimiento de la base de datos para evitar ineficiencias. Lo primero que tienes que hacer es revisar la estrategia de actualización de estadísticas.

En lugar de una actualización forzada en cada ciclo, es mejor (generalmente) dejar que SQL Server maneje esto dinámicamente. Por supuesto, siempre evalúa el impacto real en las consultas antes de aplicar actualizaciones manuales con UPDATE STATISTICS.

En cuanto a la reconstrucción de índices podemos utilizar la DMV sys.dm_db_index_physical_stats para analizar si realmente es necesario reconstruir índices. Y, como hemos dicho siempre que hablamos de mantenimiento de índices, ciertas tablas pueden beneficiarse más de una reorganización en lugar de una reconstrucción completa. Tendremos que valorar el nivel de mantenimiento en función de la fragmentación del índice.

En cualquier caso, Query Store puede ayudarnos a detectar cambios drásticos en planes de ejecución antes y después de cambiar el nivel de compatibilidad. Podemos incluso usar la opción de force plan si una consulta se ve afectada negativamente tras el cambio.

Consideraciones antes de cambiar el Nivel de Compatibilidad

A modo resumen de lo que llevamos hasta aquí, antes de modificar el nivel de compatibilidad de una base de datos, debemos hacer una serie de verificaciones y pruebas para asegurarnos de que el cambio no afectará negativamente a la operativa.

  • Analizar dependencias y compatibilidad con las aplicaciones
  • Revisar consultas y procedimientos almacenados
  • Ejecutar pruebas de rendimiento en un entorno de pruebas
  • Usar Query Store para comparar planes de ejecución
  • Ajustar planes de mantenimiento según el nuevo comportamiento de SQL Server

Cómo cambiar el Nivel de Compatibilidad

Para cambiar el nivel de compatibilidad de una base de datos en SQL Server, podemos  hacerlo desde las propiedades de la base de datos en SSMS en la pestaña “Opciones”. También lo puedes hacer utilizando la siguiente instrucción T-SQL:

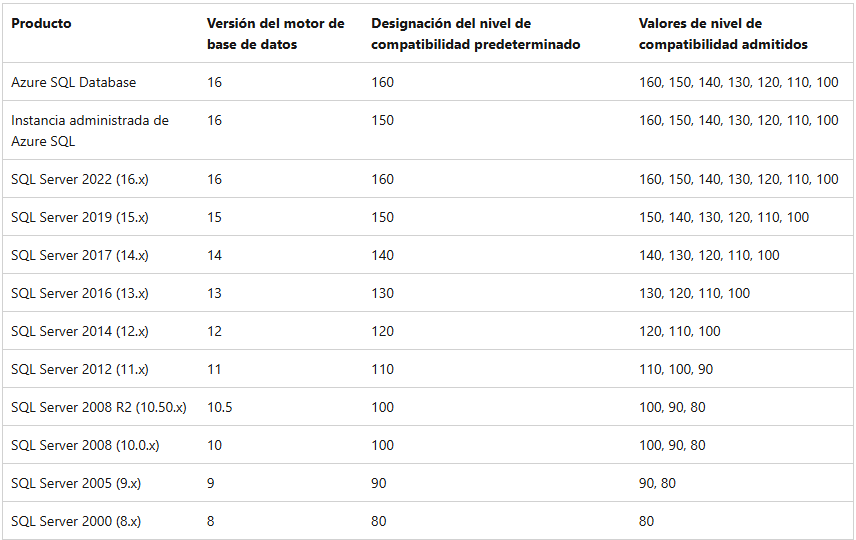
En este ejemplo 150 es para SQL Server 2019, los niveles de compatibilidad son los siguientes:

También podemos verificar el nivel de compatibilidad actual para todas las bases de datos con esta consulta:

Conclusión

El nivel de compatibilidad en SQL Server no es solo una configuración más; afecta directamente al rendimiento, comportamiento del optimizador de consultas y eficiencia de los planes de mantenimiento. Con el cambio introducido en SQL Server 2014, muchas bases de datos experimentaron transformaciones en sus planes de ejecución y rutinas de mantenimiento. Antes de hacer cualquier modificación, es clave realizar pruebas exhaustivas y ajustar estrategias de optimización. Si vamos a actualizar, hagámoslo bien y con un plan claro para minimizar riesgos y aprovechar al máximo las mejoras de SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios