Rendimiento

Compresión en índices columnares: COLUMNSTORE_ARCHIVE

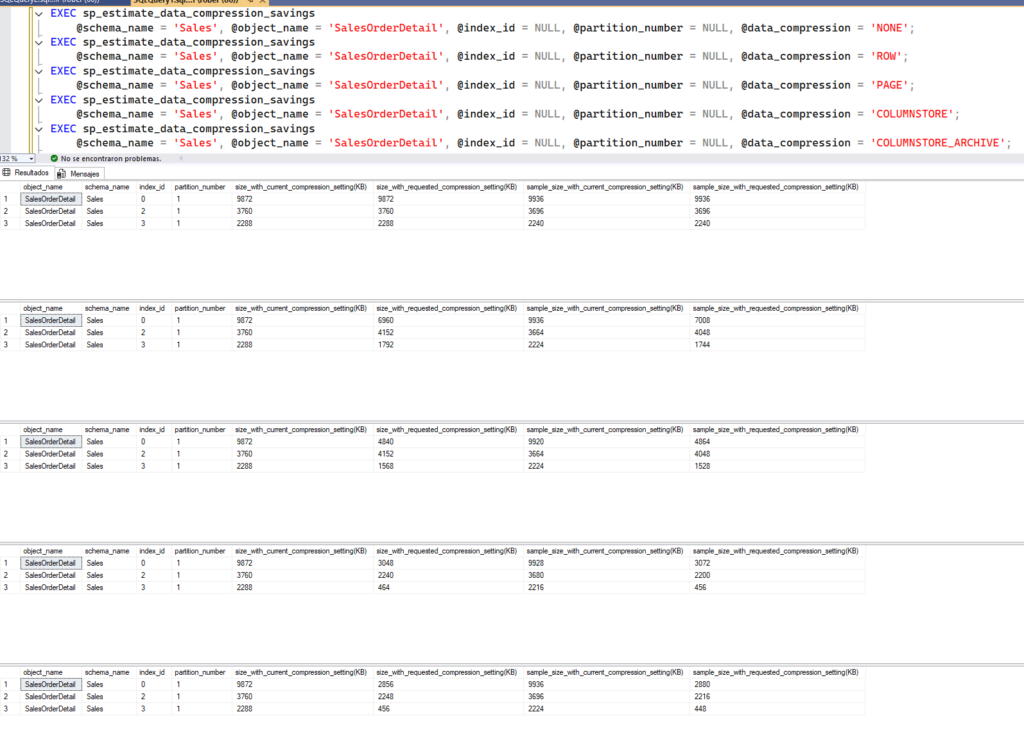
Llevamos un par de artículos ya hablando sobre compresión de datos y ya hemos visto cómo esta afecta tanto a las tablas como a los índices tanto en SQL Server como en Azure SQL. Sin embargo, hay un tipo de índice que no se ve afectado por la compresión y son los índices columnares. Lo cierto es que este tipo de índices ya tienen un nivel altísimo de compresión de datos al ser columnares pero, aún podemos comprimirlos más si es lo que queremos. Estoy hablando de una opción no tan conocida y usada que es el COLUMNSTORE_ARCHIVE.

Índices Columnares y su naturaleza comprimida

Como he comentado ya en la introducción, la propia naturaleza columnar de los índices columnstore ya de por si facilita la compresión. En concreto, por defecto y por definición se aplican técnicas de compresión avanzadas. A diferencia de los índices tradicionales basados en filas, los índices Columnstore almacenan los datos en formato columnar, lo que permite aplicar técnicas de compresión más avanzadas.

Cuando creamos un índice Columnstore, SQL Server automáticamente aplica compresión de diccionario, codificación por lotes y compresión de bits, lo que reduce significativamente el tamaño del almacenamiento y mejora la eficiencia en la lectura de datos.

La compresión de diccionario reduce el tamaño del almacenamiento eliminando valores repetitivos dentro de cada segmento de datos. Por su parte, la codificación por lotes (Run-Length Encoding) optimiza la compresión al almacenar secuencias de valores repetidos como una sola entrada. Por último, la compresión de bits (Bit-Packing) reduce el tamaño del almacenamiento al optimizar el número de bits utilizados para representar los valores almacenados.

¿Qué es Columnstore_Archive?

El índice Columnstore_Archive es una extensión del índice Columnstore comprimido estándar, diseñado para proporcionar una comprensión aún mayor aplicando algoritmos de compresión adicionales. Mientras que un índice Columnstore ya aplica técnicas avanzadas de reducción de datos como codificación de diccionario, codificación por lotes y compresión de bits, Columnstore_Archive utiliza una compresión más agresiva basada en el algoritmo Xpress Compression Algorithm (XCA)​.

Diferencias clave entre Columnstore y Columnstore_Archive

CaracterísticaÍndice Columnstore NormalColumnstore Archive
Compresión aplicadaCodificación de diccionario, run-length, bit-packingTodo lo anterior + compresión LZ77+Huffman
Impacto en almacenamientoReducción del 50-70%Reducción del 70-90%
Impacto en CPUBajoAlto (más procesamiento en consultas)
Velocidad de lecturaAltaReducida por el proceso de descompresión
Casos de uso idealesDatos transaccionales y de consulta frecuenteDatos históricos, auditoría y repositorios de solo lectura

Cómo funciona la compresión en Columnstore_Archive

Como he comentado, el modo Columnstore_Archive añade una capa extra de compresión sobre los segmentos Columnstore existentes. Esto se logra mediante una combinación de técnicas de compresión basadas en LZ77 y Huffman, utilizadas en el algoritmo Xpress Compression Algorithm (XCA)​.

Fases del proceso de compresión de Columstore_Archive

  1. Compresión LZ77: Reemplaza secuencias repetidas de bytes con referencias a posiciones anteriores en el flujo de datos. Esto reduce el tamaño al eliminar redundancias en los segmentos Columnstore.
  2. Codificación Huffman: Utiliza un esquema de codificación basado en la frecuencia de los datos para minimizar aún más el tamaño. Los valores más comunes se almacenan con menos bits, mejorando la eficiencia de almacenamiento.

Cómo maneja SQL Server los datos comprimidos en Columstore_Archive

Cuando se escribe un índice Columnstore_Archive, SQL Server aplica la compresión LZ77 + Huffman a los segmentos Columnstore ya existentes. Al leer datos de un índice Columnstore Archive, SQL Server debe descomprimir estos segmentos antes de ejecutar la consulta, lo que implica un uso de CPU significativamente mayor.

Implementar Columstore_Archive

Si queremos habilitar Columnstore_Archive en una tabla o índice usaremos el comando ALTER TABLE o ALTER INDEX de la siguiente manera:

1. Habilitar Columnstore_Archive en una partición

    2. Habilitar Columnstore_Archive en todas las particiones

    3. Habilitar Columnstore en todas las particiones y Columnstore_Archive en alguna

    3b. Otra forma de habilitar Columnstore en todas las particiones y Columnstore_Archive en alguna:

    Impacto en el rendimiento de Columnstore_Archive

    Columnstore_Archive permite una reducción extrema del tamaño de almacenamiento, lo que lo hace ideal para entornos donde el espacio en disco o las copias de seguridad representan un coste significativo. Al disminuir el tamaño de los datos almacenados, se reducen los costes operativos y se optimiza el uso del almacenamiento, especialmente en bases de datos alojadas en la nube.

    Sin embargo, esta ventaja viene acompañada de un mayor consumo de CPU en las consultas, ya que los datos deben ser descomprimidos en tiempo de ejecución. En escenarios donde las consultas analíticas son frecuentes y de gran volumen, este aumento en el uso de CPU puede impactar el rendimiento general del sistema, por lo que es fundamental evaluar su aplicación caso por caso.

    Casos de uso ideales para Columnstore_Archive

    El uso de Columnstore_Archive está especialmente indicado en escenarios donde los datos almacenados son mayormente de solo lectura o tienen un acceso esporádico. Tablas con registros históricos, auditorías o grandes volúmenes de datos que rara vez se consultan pueden beneficiarse enormemente de la reducción de almacenamiento sin que el impacto en la CPU sea un problema. En entornos de Data Warehouse donde la retención de datos es fundamental, Columnstore_Archive puede ser clave para reducir los costes de almacenamiento sin comprometer la integridad de los datos.

    También es una opción interesante en Azure SQL Managed Instance y otras bases de datos en la nube, donde los costes de almacenamiento suelen ser elevados. Reducir el tamaño de la base de datos mediante Columnstore_Archive puede generar ahorros significativos, especialmente en cargas de trabajo que dependen de replicaciones geográficas y copias de seguridad, donde el tamaño de los datos afecta directamente los costes de operación.

    Buenas prácticas con Columnstore_Archive

    Para aprovechar al máximo Columnstore_Archive, es fundamental evaluar cuidadosamente qué tablas o índices pueden beneficiarse de esta compresión. No es recomendable aplicarlo en datos de acceso frecuente, ya que el proceso de descompresión puede generar una sobrecarga en la CPU que afecte el rendimiento de las consultas. Monitorizar el impacto en el rendimiento con herramientas como Query Store y ejecutar pruebas antes de aplicar la compresión en entornos de producción son pasos esenciales para garantizar que los beneficios en almacenamiento no se vean opacados por problemas de latencia.

    Conclusión

    Columnstore_Archive es una solución avanzada para la compresión extrema de datos en SQL Server, útil en escenarios donde el almacenamiento es la principal preocupación. Sin embargo, su mayor consumo de CPU puede ser un factor limitante en bases de datos con consultas frecuentes. Si el objetivo es maximizar la eficiencia del almacenamiento sin comprometer demasiado el rendimiento, Columnstore Archive es una opción poderosa que debe aplicarse estratégicamente en los casos adecuados. Una planificación cuidadosa y una evaluación continua del impacto en rendimiento permitirán sacar el máximo provecho de esta tecnología sin afectar la operativa de la base de datos.


    Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 0 comentarios

    Compresión en Azure SQL Managed Instance

    Azure SQL Managed Instance (MI) es una plataforma para la gestión de bases de datos en la nube con un equilibrio perfecto entre la administración manual y delegada en el proveedor, pero es esencial comprender sus características y limitaciones para optimizar su rendimiento. Hoy vamos a hablar de la compresión de datos, de la que ya hablamos detenidamente en otro artículo, como estrategia para mitigar limitaciones relacionadas con los recursos de IO, RAM y CPU. En este artículo, exploraremos cómo la compresión de datos puede ayudar a superar estas limitaciones, proporcionando datos objetivos sobre las especificaciones de Azure MI y los precios (en la región de España Central a modo de ejemplo).

    Características y limitaciones de Azure SQL Managed Instance

    Lo primero que tenemos que tener claro es el terreno de juego en el que estamos, la nube es teóricamente escalable sin límite, sin embargo, tanto los proveedores como, sobre todo, nuestro bolsillo va a ser el principal limitante. Veamos qué es lo que nos ofrece Azure para el caso de las Managed Instance.

    Niveles de servicio y recursos asignados:

    Azure MI ofrece principalmente dos niveles de servicio el de uso general y el crítico. Además, dentro de estos niveles de servicio vamos a poder elegir tres tipos de hardware diferente. Parece un poco lioso, y realmente lo es, así que vamos a tratar de hacerlo fácil.

    Lo primero que tenemos que conocer son los niveles de servicio que son:

    • De uso general (General Purpose): Diseñado para cargas de trabajo empresariales comunes con requisitos de rendimiento moderados y alta disponibilidad.
    • Crítico para la empresa (Business Critical): Orientado a aplicaciones de misión crítica que requieren alta velocidad de transacciones y baja latencia.

    Estos niveles de servicio van a marcar los límites de recursos que podemos asignar a nuestra instancia, pero además de estos tenemos que tener en cuenta el tipo de hardware. Por ejemplo en el nivel de uso general el límite de CPUs que podemos asignar es de 80 cores para el hardware estándar y el serie premium pero solo hasta 64 cores en el hardware optimizado para memoria. Es el nivel crítico para la empresa el hardware estándar tendrá un máximo de 80 cores mientras que el hardware premium y el optimizado para memoria podrá tener hasta 128.

    Compresión para salvar los límites de RAM para Azure MI

    Una de las cosas curiosas de Azure SQL MI es que la asignación de recursos de memoria RAM no es seleccionable y depende directamente de la cantidad de núcleos virtuales que tengamos.

    • Hardware de la serie estándar: 5,1 GB de RAM por vCore con un máximo de 480 Gb. Por ejemplo, 16 vCore = 81,6 GB de RAM.
    • Hardware de la serie Premium: 7 GB de RAM por vCore con un máximo de 560 Gb. Por ejemplo, 16 vCore = 112 GB de RAM.
    • Hardware optimizado para memoria: 13,6 GB de RAM por vCore con un máximo de 870,4 Gb. Por ejemplo, 16 vCore=217 GB de RAM.

    Como podéis ver, la cantidad máxima de RAM es muy limitada y más cuando no nos dejamos el presupuesto de toda la empresa en núcleos de Azure MI. Por esta razón es fundamental habilitar la compresión en todas las tablas e índices de nuestras bases de datos. Cuantos más datos podamos cachear mejor, recordad que para que SQL tenga un rendimiento decente tiene que ser capaz de tener en memoria la información a la que se accede frecuentemente además de espacio suficiente para cachear planes de ejecución y demás operaciones que se hacen en memoria.

    Almacenamiento en Azure MI

    Ahora vamos con una de las cosas que menos me gustan de este modelo de dimensionamiento que tiene Azure MI y es que la capacidad de almacenamiento está limitada por la cantidad de núcleos adquirida. De esta manera, en el nivel de uso general con menos de 8 núcleos no puedes tener más de 2 Tb de datos, con menos de 16 núcleos no puedes tener más de 8 Tb de datos y para llegar hasta el máximo de 16 Tb de datos vas a necesitar 16 núcleos o más. Veamos esto en precios con el hardware estándar para que nos duela menos al ver los costes.

    Propósito general:

    • ¿Necesitas menos de 2 TB? Puedes dimensionar 4 núcleos, 1.013,99 € mensuales.
    • ¿Necesitas más de 2 TB? Necesitas mínimo de 8 núcleos, 2.569,88 € mensuales.
    • ¿Necesitas más de 8 TB? Necesitas mínimo de 16 núcleos, 5.143,85 € mensuales.
    • ¿Necesitas más de 16 TB? Lo siento, no puedes tener esa cantidad. (Puedes tener más núcleos pagando más, pero esta lista se basa en los tamaños de disco).

    Veamos también cómo va el almacenamiento en el nivel crítico para la empresa (esta vez en hardware premium que es más flexible):

    • ¿Necesitas menos de 1 TB? Puedes dimensionar 4 núcleos virtuales, 2.614,23 € mensuales.
    • ¿Necesitas más de 1 TB? Mínimo de 8 núcleos, 5.237,48 € mensuales.
    • ¿Necesitas más de 2 TB? Mínimo de 16 núcleos, 10.483,97 € mensuales.
    • ¿Necesitas más de 4 TB? Mínimo de 24 núcleos, 15.584,32 € mensuales.
    • ¿Necesitas más de 5,5 TB? En España no se puede.

    Os dejo ahora una imagen extraída de la documentación oficial sobre las limitaciones de espacio. Para el cálculo de precios podéis usar la calculadora oficial.

    Velocidad de los discos

    Si todo esto que hemos visto no es un problema para vosotros esperad porque ahora viene lo realmente “problemático” en Azure MI. La velocidad de estos discos, medida en IOPS (E/S por segundo), es realmente baja y, aunque va aumentando con el tamaño de los archivos, no llega a ser comparable a sistemas tradicionales On-Prem. Además de que escalar los ficheros nos va a implicar necesidades extra de tamaño y por tanto de cores y, si lo habéis adivinado, de más dinero todos los meses. Veamos esta otra imagen de la misma documentación que comentábamos antes: 

    Ahora os voy a dejar otra imagen de Kingston sobre las velocidades de sus discos actuales

    Como veis, en el mejor de los casos, un archivo de Azure MI de más de 4 Tb tendría una velocidad de 250 Mib/s (Mebibits por segundo) o lo que es lo mismo 32,7 MB/s (Megabytes por segundo). Un SSD M2 NVME actual de cuatro canales nos está dando 8000. 

    Recuerda que para tener 4Tb (32,7 MB/s) en una instancia de nivel crítico para la empresa estamos hablando de más de 15.000 € al mes, eso sin contar con dimensionar también el fichero de log que, en este nivel de servicio y en España, ni podríamos llevarlo a este tamaño. En el nivel propósito general si podemos pero, estamos hablando de 5.100 € al mes para tener 8 Tb (4 para datos y 4 para log). 

    Nada más que decir.

    Conclusión: Compresión para reducir las lecturas

    Lo que os quería hacer ver con todo este texto que os he puesto hasta ahora es que en Azure MI las reglas del juego cambian y reducir las lecturas en disco y maximizar el tiempo que los datos permanecen en caché es clave para el rendimiento. Por este motivo necesitarás una buena política de indexación, comprimir los datos y, si es posible, eliminar todos los datos que ya no sean necesarios. 

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

    Compresión en SQL Server

    La compresión de datos en SQL Server es una funcionalidad clave que permite optimizar el almacenamiento y mejorar el rendimiento de entrada/salida (E/S) en bases de datos con grandes volúmenes de información. SQL Server ofrece dos tipos principales de compresión: a nivel de fila y a nivel de página. En este artículo veremos ambos métodos así como sus ventajas y casos de uso, y mostraremos cómo evaluar el impacto de estas técnicas en el almacenamiento mediante herramientas nativas de SQL Server.

    Compresión de fila

    La compresión de fila elimina redundancias en datos almacenados en columnas de tipos de datos de longitud fija, como CHAR e INT. Además, optimiza el almacenamiento de valores NULL y ceros.

    Características principales:

    Como no podía ser de otra manera, la principal característica de este tipo de compresión es la optimización ligera de espacio. Con esto quiero decir que reduce el tamaño al eliminar espacios en blanco innecesarios y valores repetitivos pero sin mucho impacto en el sistema. No es una compresión muy intrusiva, lo que nos lleva a su segunda característica principal, la compatibilidad. La compresión a nivel de fila es transparente para las operaciones de lectura y escritura, ya que no requiere descompresión y tiene un impacto bajo en la CPU (tercera característica). Esto la hace una solución ideal para sistemas con limitaciones de procesamiento.

    Casos de uso:

    Como ya hemos dicho esta solución es la más recomendada en tablas con numerosos valores NULL o ceros o tablas con columnas de tipos de datos de longitud fija donde tengamos limitaciones o estemos cerca del límite de la CPU. Si no tenemos problemas de CPU podremos optar por el siguiente tipo de compresión como vamos a ver ahora mismo.

    Compresión de página

    La compresión de página es la más completa, combina la compresión de fila con técnicas de codificación más avanzadas, como el uso de diccionarios para reducir patrones repetitivos dentro de las páginas de datos. Es decir, además de toda la compresión que ya teníamos a nivel de fila elimina los datos duplicados en disco para reducir así el espacio. Es como una “deduplicación” de los datos de la tabla, así entre comillas pero para entendernos.

    Características principales:

    Lo estarás ya imaginando, la principal característica de la compresión a nivel de página es la reducción significativa del espacio. Es ideal para tablas con datos repetitivos o históricos. Por contra tiene un mayor uso de CPU ya que requiere más procesamiento, especialmente durante la compresión inicial. Hay que poner en una balanza este coste extra de CPU al comprimir con la eficiencia en almacenamiento. En teoría reduce los costes al minimizar el espacio físico necesario pero carga la CPU. 

    Ahora bien, si no tenemos tantas escrituras y nuestro consumo de CPU es mayoritariamente en lecturas podemos llevarnos una sorpresa. Comprimir los datos hace que podamos almacenar más datos en RAM, incluso en la caché del procesador y puede darse el caso que lo que notemos sea justo lo contrario, una reducción del uso de la CPU. Si lo piensas no es tan descabellado, es la manera de trabajar de los índices.

    Casos de uso:

    En este caso, los casos de uso son un poco más específicos que en el anterior tipo. Usaremos la compresión a nivel de página en tablas de archivos históricos y tablas de solo lectura. También nos lo podemos plantear en bases de datos con grandes tablas con volúmenes de datos repetitivos siempre y cuando el consumo de CPU no sea un problema para nosotros. Por último, en servidores donde el principal cuello de botella sea la E/S de disco (ejem, Azure, ejem) el beneficio también será sustancial.

    Evaluación del impacto en el almacenamiento

    Antes de implementar la compresión, es fundamental evaluar el impacto potencial en el almacenamiento para entender los beneficios que puede ofrecer. SQL Server proporciona el procedimiento almacenado de sistema sp_estimate_data_compression_savings, que permite estimar el ahorro de espacio para diferentes tipos de compresión.

    Sintaxis del procedimiento:

    Ejemplo práctico:

    Supongamos que tenemos una tabla Ventas en el esquema dbo y queremos evaluar el impacto de habilitar compresión de página:

    Resultado:

    El procedimiento devuelve una estimación del espacio actual y el espacio proyectado después de aplicar la compresión. Esto incluye:

    • size_with_current_compression_setting: Tamaño actual.
    • size_with_requested_compression_setting: Tamaño estimado con la compresión solicitada.
    • savings_in_bytes: Ahorro en bytes.

    Implementación de la compresión

    Una vez evaluado el impacto, podemos habilitar la compresión mediante las siguientes instrucciones:

    Beneficios adicionales de la compresión

    En líneas generales, sea cual sea el tipo de compresión que utilicemos, hay una serie de ventajas que son comunes. El principal beneficio que podemos destacar es la reducción de espacio físico en disco o en almacenamiento en la nube lo que implica directamente una reducción de costes. Por otro lado, vamos a encontrarnos con mejoras en E/S lo que se traduce en operaciones más rápidas al transferir menos datos. 

    Por último, debemos hablar de la compatibilidad. La compresión no es solo a nivel tabla, también se aplica a índices, optimizando consultas.

    Conclusión

    La compresión en SQL Server es una herramienta poderosa para reducir costes y mejorar el rendimiento de bases de datos. Evaluar previamente el impacto con sp_estimate_data_compression_savings asegura que tomemos decisiones informadas, maximizando los beneficios en almacenamiento y rendimiento. Ya sea con compresión de fila o de página, estas técnicas pueden adaptarse a una amplia gama de necesidades y escenarios empresariales.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en SQL Server, 0 comentarios

    ¿Por qué usar una red aislada para la comunicación de Always On (heartbeat network)?

    La implementación de una arquitectura de alta disponibilidad en SQL Server Always On es un elemento clave para garantizar la continuidad del negocio y la disponibilidad de los datos. Mucho hemos hablado ya de este tema en el blog pero, si queremos ir un paso más allá, uno de los aspectos fundamentales en esta configuración es la red de comunicación entre los nodos de un grupo de disponibilidad o una instancia de clúster de conmutación por error. En este contexto, el uso de una red aislada para la comunicación de Always On, conocida como heartbeat network, juega un papel esencial en la estabilidad y rendimiento de la solución.

    En este artículo, veremos por qué es recomendable utilizar una red dedicada para la comunicación de Always On, sus beneficios, y las mejores prácticas para su implementación.

    Importancia de la comunicación en Always On

    Always On en SQL Server nos permite la creación de entornos de alta disponibilidad y recuperación ante desastres mediante grupos de disponibilidad o clústeres de conmutación por error. Cuando lo configuramos, los nodos intercambian información de estado para determinar si uno de los servidores está en funcionamiento o si ha fallado y es necesario realizar una conmutación por error (failover).

    Este intercambio de información se realiza a través de un mecanismo denominado heartbeat, que envía señales de estado periódicas entre los nodos del clúster. Si un nodo deja de responder en un tiempo determinado, el sistema automáticamente asume que ha fallado y puede desencadenar una conmutación automática al nodo secundario si así lo hemos configurado.

    Además de la señal de heartbeat, en un Grupo de Disponibilidad Always On, esta misma red puede utilizarse para la sincronización de datos entre réplicas. Esto es especialmente crítico en entornos con replicación síncrona, donde la latencia y la estabilidad de la red influyen directamente en el rendimiento del sistema.

    ¿Por qué usar una red aislada para el heartbeat en Always On?

    Como acabamos de ver, el tráfico de comunicación de Always On es crítico para mantener la estabilidad del clúster. Sin una red dedicada, esta comunicación puede verse afectada por la congestión de la red principal, lo que podría provocar falsos positivos en la detección de fallos y generar conmutaciones innecesarias. Además el rendimiento de SQL podría verse afectado sobre todo en replicaciones síncronas donde todos los nodos tienen que confirmar la escritura del dato antes de aplicarse. A continuación, analizamos las razones principales por las que una red aislada es recomendada.

    1. Optimización del rendimiento en la replicación de datos

    En configuraciones de Grupos de Disponibilidad Always On, los datos pueden replicarse de forma síncrona o asíncrona entre los nodos.En la replicación asíncrona, el rendimiento no se ve tan afectado por la latencia de la red, ya que el nodo primario no espera confirmación antes de continuar procesando transacciones. Sin embargo, en la replicación síncrona, cada transacción debe confirmarse en todas las réplicas antes de considerarse completada. Si la red es lenta o está congestionada, la latencia de confirmación aumentará, ralentizando drásticamente el rendimiento de las aplicaciones que dependen de la base de datos.

    Utilizar una red dedicada para la sincronización de Always On reduce la latencia y garantiza tiempos de respuesta óptimos, evitando que la red de producción interfiera en la replicación de datos.

    2. Evita congestión en la red de producción

    Si la red de Always On comparte infraestructura con la red utilizada por los clientes y aplicaciones, el tráfico de consultas, backups y cargas de datos puede afectar negativamente la comunicación entre los nodos. Una red separada para heartbeat y sincronización de datos garantiza que las señales críticas del clúster no se pierdan ni se retrasen debido a otras cargas de trabajo.

    3. Reduce los falsos positivos en la detección de fallos

    Si los paquetes de heartbeat se retrasan o se pierden por congestión en la red, el clúster podría interpretar que un nodo ha fallado y desencadenar una conmutación innecesaria. Esto no solo interrumpe el servicio, sino que también puede generar pérdida de rendimiento o afectar transacciones en curso. Con una red dedicada, el tráfico de heartbeat permanece estable, minimizando estos riesgos.

    4. Mayor estabilidad en entornos de “misión crítica”

    En sectores críticos como finanzas, salud o comercio electrónico, donde SQL Server gestiona transacciones en tiempo real, cualquier interrupción puede tener un impacto severo. Una red dedicada para la sincronización y el heartbeat de Always On ayuda a mantener la estabilidad operativa, asegurando que la replicación de datos no se vea afectada por otros procesos.

    5. Mejor eficiencia en la recuperación ante desastres

    En escenarios donde Always On se extiende a un sitio de recuperación ante desastres (DR), la replicación de datos entre ubicaciones puede beneficiarse de una red dedicada para evitar problemas de latencia y pérdida de paquetes. Al separar el tráfico de sincronización, se mejora la eficiencia de la conmutación a los servidores de respaldo, reduciendo el tiempo de recuperación en caso de fallos.

    6. Mayor seguridad en la comunicación entre nodos

    Al utilizar una red aislada, los paquetes de comunicación de Always On quedan protegidos de posibles ataques de red o interferencias de otras aplicaciones. Esto es especialmente importante en entornos donde se manejan datos sensibles o regulados. 

    Buenas prácticas para implementar una red de heartbeat en Always On

    Para aprovechar al máximo los beneficios de una red dedicada en Always On, es recomendable seguir algunas buenas prácticas:

    Utilizar interfaces de red dedicadas para la red heartbeat 

    Cada nodo del clúster debe contar con al menos dos interfaces de red, una para la red de producción y otra exclusivamente para la comunicación de Always On (heartbeat + sincronización de datos). Esto permite segmentar el tráfico y garantizar que los paquetes críticos siempre tengan prioridad.

    Configurar métricas de latencia adecuadas

    Ajustar los valores de timeout y umbrales de latencia en el clúster es clave para evitar falsos positivos en la detección de fallos. Dependiendo de la infraestructura, puede ser necesario aumentar los valores predeterminados para optimizar la replicación.

    Implementar calidad de servicio (QoS)

    Si la red dedicada no es una opción viable, se pueden aplicar reglas de Quality of Service (QoS) para priorizar el tráfico de Always On sobre otros tipos de tráfico en la red de producción.

    Monitorizar constantemente la red heartbeat de Always On

    La monitorización activa de la red de comunicación y replicación de Always On es crucial para detectar anomalías antes de que afecten la estabilidad del clúster. Herramientas como SQL Server Management Studio (SSMS) y System Center Operations Manager (SCOM) pueden ayudar en esta tarea.

    Usar VLANs y segmentación de red para heartbeat 

    Si no es posible contar con una red física dedicada, una alternativa viable es configurar una VLAN (Virtual LAN) para separar lógicamente el tráfico de Always On del resto del tráfico de la red.

    Configurar múltiples rutas de comunicación

    Para entornos de alta disponibilidad extrema, es recomendable configurar múltiples rutas de comunicación entre los nodos utilizando distintas interfaces de red y switches redundantes. Esto permite continuar la comunicación en caso de fallos en una de las rutas.

    Conclusión

    El uso de una red aislada para la comunicación de Always On no solo garantiza una mayor estabilidad en la detección de fallos, sino que también optimiza el rendimiento en la replicación de datos, especialmente en configuraciones síncronas. Al reducir la latencia y evitar interferencias con el tráfico de producción, se mejora significativamente la eficiencia del clúster y se minimiza el riesgo de interrupciones.

    Para cualquier organización que dependa de SQL Server Always On, implementar una red dedicada para heartbeat y sincronización es una estrategia clave para mantener un rendimiento óptimo y asegurar la continuidad del servicio en entornos críticos.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Alta Disponibilidad, Rendimiento, SQL Server, 0 comentarios

    ¿Hasta qué punto ayuda el conocimiento del negocio a un DBA?

    El papel del administrador de bases de datos (DBA) ha evolucionado considerablemente con el tiempo. Si bien sus responsabilidades fundamentales siguen siendo la administración de sistemas, optimización del rendimiento y mantenimiento de la disponibilidad, el contexto en el que operan los datos ha adquirido una relevancia creciente. El conocimiento del negocio no solo potencia la eficiencia de un DBA, sino que también le permite aportar soluciones alineadas con los objetivos estratégicos de la organización.

    Diseño y modelado de bases de datos con propósito de negocio

    El diseño de bases de datos es una de las áreas donde más se nota la diferencia entre un DBA con conocimientos técnicos y otro que, además, entiende el negocio. Cuando un administrador comprende los procesos empresariales, como la estructura de ventas, el control de inventario o los flujos de producción, el modelado de datos se vuelve más coherente y efectivo. Este conocimiento permite crear esquemas que reflejan la operativa real, optimizando no sólo la integridad de los datos, sino también la capacidad del sistema para dar respuesta a las necesidades de la organización.

    Por ejemplo, en un escenario donde los reportes financieros son fundamentales para la toma de decisiones, un DBA con visión de negocio podrá anticipar qué tablas y consultas son críticas. Esto le permitirá definir índices, particiones y optimizaciones específicas para esas áreas, asegurando que los procesos clave se ejecuten con rapidez. Por el contrario, un diseño basado exclusivamente en criterios técnicos puede generar soluciones rígidas que dificultan la adaptación a los cambios en los requisitos del negocio.

    Todo esto es importante aunque el DBA no sea quien define y modela ya que, aun en estos casos, su supervisión es crítica. Además esta visión global le facilitará anticiparse a problemas causados por un fallo en este sentido.

    Optimización de rendimiento alineada con el negocio

    El conocimiento del negocio también desempeña un papel clave en la optimización del rendimiento. Aunque las métricas técnicas son esenciales para medir la eficiencia de una base de datos, estas carecen de sentido si no están alineadas con las prioridades de la empresa. Cuando los DBA entendemos el impacto real de un proceso podemos enfocarnos en optimizar las consultas o tareas que realmente afectan al negocio.

    Cuando una consulta tarda demasiado en ejecutarse, es fundamental comprender cómo se utilizan esos datos. Si el rendimiento afecta directamente a la generación de reportes de ventas o análisis de inventario, nuestras acciones como DBA deberán enfocarse en resolver ese problema con la mayor prioridad. Al conocer la operativa, podemos tomar decisiones más acertadas, como proponer estrategias de ColumnStore, particionado o ajustes de índices específicos, sabiendo que estas optimizaciones repercutirán directamente en la eficiencia operativa de la organización.

    Por último también podremos anticiparnos y preparar el servidor para momentos de especial carga de trabajo como periodos de ofertas en tiendas, cierres fiscales en sistemas contables o cualquier eventualidad propia de nuestra empresa.

    Resolución de incidencias y priorización de tareas acorde a las necesidades de negocio

    La resolución de incidencias es otra área donde el conocimiento del negocio puede marcar una gran diferencia. Un DBA experimentado sabe que no todas las consultas o procesos tienen el mismo impacto. La comprensión de los procesos críticos, como el cierre contable mensual o los análisis de producción, nos permite a los administradores priorizar las tareas según su urgencia y relevancia para el negocio.

    Por ejemplo, durante un cierre financiero, un problema en las consultas que alimentan los reportes puede paralizar decisiones clave de la alta dirección. Un DBA que entiende la importancia de estos procesos actuará con celeridad, enfocando sus esfuerzos en identificar y resolver la causa raíz del problema. Esta capacidad para priorizar no solo mejora la eficiencia del administrador, sino que también garantiza que el negocio continúe funcionando sin interrupciones.

    Migraciones y rediseños orientados a las necesidades de negocio

    En proyectos de migración o rediseño de bases de datos, el conocimiento del negocio es aún más relevante. Estos procesos suelen implicar cambios estructurales y la adopción de nuevas tecnologías, lo que requiere una planificación detallada y un entendimiento claro de las necesidades empresariales. Un DBA que domina el contexto del negocio será capaz de proponer soluciones que no solo mejoren el rendimiento técnico, sino que también aporten valor a la organización. Por no hablar de que sin conocimiento de lo que pasa en el negocio solo vamos a poder cubrir las necesidades actuales que vemos sin ser capaces de prever lo que pasará en un futuro cercano. ¿Cómo vamos a poder dimensionar así correctamente un servidor nuevo?

    Durante una migración de SQL Server 2019 a 2022, por ejemplo, los administradores con esta perspectiva no nos limitaremos a realizar una actualización técnica. Evaluaremos el modelo de datos, identificaremos oportunidades de optimización y propondremos mejoras que beneficien a los procesos críticos del negocio. Esto puede incluir desde la implementación de nuevas funcionalidades del motor a ajustes en el almacenamiento de datos o la adopción de estrategias más eficientes para la gestión de consultas complejas.

    Colaboración entre equipos y comunicación efectiva

    Como DBA el conocimiento del negocio también nos facilita la colaboración con otros equipos, como desarrolladores, analistas de negocio y administradores de sistemas. Al actuar como un puente entre el lenguaje técnico y las necesidades empresariales, el administrador de bases de datos puede contribuir a la creación de soluciones más efectivas y alineadas con los objetivos de la organización. Esta comunicación fluida permite anticipar problemas, evitar malentendidos y asegurar que los esfuerzos propios del DBA tengan un impacto positivo en el funcionamiento global del negocio.

    Conclusión

    El conocimiento del negocio es una herramienta imprescindible para un administrador de bases de datos que aspire a aportar valor más allá de sus competencias técnicas. Esta comprensión le permite diseñar bases de datos eficientes, optimizar procesos clave y resolver problemas con mayor rapidez y eficacia. Además, facilita la colaboración con otros equipos y asegura que las decisiones del DBA estén siempre alineadas con los objetivos estratégicos de la organización. Al entender el contexto empresarial, el administrador no solo gestiona datos, sino que se convierte en un aliado fundamental para el éxito y la competitividad del negocio.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!


    Publicado por Roberto Carrancio en Otros, 0 comentarios

    Cómo ser DBA y no morir en el intento (Artículo de HUMOR)

    Trabajar de DBA de SQL Server es un oficio lleno de misterio, expectativas y, por qué no decirlo, frustraciones. Para empezar, nadie fuera del departamento técnico sabe realmente qué hacemos. La frase «oye, ¿y eso no lo hace Excel?» ya la hemos oído más veces que el «hola» de nuestra madre. Y es que la vida del DBA no es fácil. Somos los héroes olvidados del backend, los guardianes de las consultas bien escritas, los que nos mantenemos despiertos mientras el servidor dice «timeout expired».

    El Ritual del SELECT TOP 1

    El primer mandamiento del DBA es: «No harás un SELECT * sobre producción». ¿Lo hemos hecho? Más veces de las que admitiremos públicamente. Nos han pillado… Una vez. Desde entonces, siempre usamos el sagrado TOP 1 como si fuera un amuleto de buena suerte.

    Y claro, cuando el jefe nos pregunta si la consulta es rápida, respondemos con la calma del que sabe que su CTE tiene 15 niveles de recursión: «Depende de cuántas JOINS a tablas tenga».

    Mi job de mantenimiento es tu pesadilla

    Hay dos tipos de personas en el mundo: las que confían ciegamente en sus backups y las que aún no han sufrido una catástrofe. Un DBA vive cada día en ese delgado filo entre la tranquilidad y el infarto. Si CHECKDB devuelve errores, la presión sanguínea sube más rápido que un autoincremental en una tabla de log. Y, por supuesto, siempre está el compañero de «¿para qué necesitamos índices? El SQL Server ya lo resuelve solo».

    Amigo, si piensas eso, espero que te guste el café frío y las noches de insomnio porque tú y los deadlocks vais a ser mejores amigos.

    El cliente que cambia las reglas del juego

    Todos hemos tenido ese momento glorioso cuando un desarrollador dice: «es que necesitaba agregar una columna con un VARCHAR(MAX) para meter más datos«. Claro, porque meter más datos no tiene ningún impacto en el rendimiento… spoiler alert: sí lo tiene. El resultado suele ser que la tabla pasa de «normalita» a «más ancha que la autopista de circunvalación».

    Y ahí estamos nosotros, intentando convencerles de que VARCHAR(100) ya era suficiente. Pero no, necesitamos ser «future-proof». Lo único proof aquí es el dolor de cabeza que nos deja el nuevo plan de ejecución.

    El Optimizer: Nuestro juez implacable

    La vida de un DBA también gira en torno a una relación tóxica: nosotros y el Optimizer. Esa entidad invisible que, por algún motivo, decide que el seek es aburrido y prefiere hacer un table scan como si estuviera buscando las llaves del coche en un descampado. ¿La causa? Quizás fue el parameter sniffing, la luna llena o simplemente un lunes.

    Cuando el Execution Plan se vuelve contra nosotros, tenemos dos opciones: optimizar o sacar la carta prohibida del HINT. Porque, seamos sinceros, a veces un OPTION (RECOMPILE) nos salva más que un paracetamol.

    El usuario de «Es solo una consulta»

    Si trabajas de DBA, habrás oído la temida frase: «es solo una consulta rápida, ¿puedo lanzarla en producción?«. «Solo una consulta rápida» significa que va a tardar 45 minutos, tirar el servidor y llevarse puestos otros procesos en el camino. No falla.

    Es más, cuando el usuario aparece en nuestra bandeja de entrada con el ASAP, ya sabemos que no será ni rápido ni sencillo. El «as soon as possible» no aplica en SQL Server si hay un WHERE mal puesto y un índice invisible que clama venganza.

    Conclusión: Ser DBA es un oficio heroico

    Al final del día, seguimos aquí. Porque aunque SQL Server sea un pequeño tirano, nos encanta domarlo. Amamos ver cómo un plan de ejecución mejora, cómo los backups funcionan cuando los necesitamos y cómo ese usuario que decía que «la base de datos está lenta» acaba reconociendo que el problema estaba en su código.

    La próxima vez que un compañero te pregunte si el problema es del servidor, responde con un guiño: «¿Y has revisado tu código?«. Porque, amigos, el DBA no culpa… solo observa.

    ¡Larga vida a la optimización de consultas y que los CHECKDB estén siempre de vuestro lado!

    Espero que este artículo te haya resultado divertido y ameno. Si tienes alguna duda o comentario, no dudes en contactarnos en Twitter o por mail o dejarnos un mensaje en los comentarios de aquí abajo. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir.

    Publicado por Roberto Carrancio en Otros, 0 comentarios

    Always On Availability Groups sin WSFC

    Always On Availability Groups (AG) es una funcionalidad avanzada de SQL Server que proporciona alta disponibilidad, recuperación ante desastres y replicación. Tradicionalmente, esta tecnología se implementa utilizando Windows Server Failover Cluster (WSFC). Sin embargo, existe una alternativa que elimina la dependencia de WSFC, simplificando la infraestructura en ciertos entornos y adaptándose mejor a escenarios específicos. En este artículo, y a raíz de una petición vuestra en un comentario a uno de mis videos en youtube, os explicaré cómo configurar AG en Windows sin cluster, sus características, limitaciones y casos de uso, además de los scripts necesarios para su administración.

    Introducción a Always On sin WSFC

    La configuración de Always On sin WSFC, también conocida como grupos de Disponibilidad de Escala de Lectura (Read-Scale Availability Groups, RSAG), es ideal en entornos donde no es posible o necesario implementar un cluster. Esta arquitectura, disponible desde SQL Server 2017, permite que las réplicas de SQL Server funcionen de manera independiente, conectándose directamente entre sí para mantener la sincronización de los datos. A diferencia de la configuración tradicional, no existe una gestión centralizada del Quórum ni un mecanismo de failover automático. En su lugar, los DBA asumimos un papel activo en la supervisión, configuración y administración de los failovers, listeners y otros elementos. Aunque este modelo elimina parte de la complejidad asociada a los clusters, también requiere conocimientos avanzados para garantizar un funcionamiento eficiente y seguro.

    Características de Always On sin WSFC

    La autonomía de las réplicas es una de las principales características de esta configuración. Cada instancia de SQL Server opera de forma independiente y no depende de un cluster subyacente para coordinar sus roles. El failover, por otro lado, debe realizarse manualmente o mediante scripts personalizados, lo que otorga flexibilidad pero requiere una monitorización constante. Los listeners, que en un entorno con WSFC se configuran automáticamente, aquí deben implementarse manualmente utilizando soluciones externas como balanceadores de carga o DNS, lo que puede agregar complejidad operativa.

    En términos de sincronización, esta configuración solo admite el modo asíncrono, lo que prioriza el rendimiento pero, sumado a la falta de balanceo automático, descarta su uso como solución de alta disponibilidad para todos los escenarios. Además, aunque al eliminar la necesidad de WSFC, la infraestructura se simplifica, reduciendo los costes asociados sigue siendo necesario licenciar ambas instancias con una edición Enterprise lo que eleva los costes.

    Ventajas y Limitaciones

    La eliminación del cluster de Windows en esta configuración aporta beneficios significativos, como la reducción de costes al no requerir licencias adicionales ni configuraciones complejas asociadas a WSFC. Esto hace que sea una solución atractiva para entornos de pruebas y desarrollo. Además, la autonomía de las réplicas facilita la implementación en sistemas más simples, evitando la necesidad de depender de un cluster para mantener la alta disponibilidad.

    Sin embargo, esta configuración también tiene limitaciones importantes. La ausencia de un mecanismo de quorum aumenta el riesgo de situaciones de split-brain (ocurre cuando uno o más nodos de un clúster experimentan la desconexión de los otros nodos, lo que resulta en la formación de subclústeres), especialmente en escenarios donde no se monitoriza adecuadamente el estado de las réplicas. Por otro lado, la falta de un listener nativo complica la integración con aplicaciones que dependen de un punto de acceso único para conectarse al nodo activo. La escalabilidad también es más limitada en comparación con un entorno gestionado por WSFC, lo que la hace menos adecuada para infraestructuras complejas o con muchos nodos.

    Casos de Uso

    Always On sin cluster en Windows es una solución especialmente útil en entornos de pruebas y desarrollo, donde la alta disponibilidad no es crítica pero la replicación de datos es necesaria para realizar simulaciones y validaciones. También es una opción adecuada para aquellos escenarios que no requieren failover automático, pero necesitan una forma de mantener datos sincronizados entre varias instancias para dividir las cargas de trabajo, por ejemplo replicas de solo lectura para análisis en tiempo real.

    En sistemas autónomos, donde las réplicas pueden operar independientemente, esta arquitectura también encuentra un buen uso. Asimismo, es una alternativa viable cuando se dispone de soluciones externas avanzadas, como balanceadores de carga o gestión de DNS, que pueden mitigar las limitaciones asociadas a la falta de listeners nativos.

    Configuración de Always On sin WSFC

    La configuración comienza habilitando Always On en cada instancia de SQL Server desde el Configuration Manager, asegurándose de que las bases de datos estén en modo de recuperación completa. Los endpoints deben configurarse manualmente en cada réplica para permitir la comunicación entre ellas. Una vez configurados los endpoints, se procede a crear el grupo de disponibilidad desde la réplica primaria utilizando T-SQL, definiendo las bases de datos y réplicas participantes, junto con sus modos de sincronización.

    En las réplicas secundarias, las bases de datos deben restaurarse en modo de recuperación incompleta (NORECOVERY) antes de añadirlas al grupo de disponibilidad. Finalmente, los listeners deben configurarse manualmente si es necesario, ya sea mediante un DNS dedicado o un balanceador de carga externo, lo que permite redirigir el tráfico al nodo activo.

    Gestión y Scripts de Administración

    La administración de Always On sin WSFC depende en gran medida de scripts personalizados ya que no dispondremos del dashboard de Always On. Por ejemplo, el estado de sincronización de las réplicas puede verificarse con consultas a las vistas dinámicas sys.dm_hadr_database_replica_states. Además, algunas columnas de esta DMV relacionadas con el clúster pueden mostrar datos sobre un clúster predeterminado interno. Estas columnas son solo para uso interno y se pueden ignorar.

    El failover manual, que es una tarea común en esta configuración, se realiza utilizando el comando ALTER AVAILABILITY GROUP … FAILOVER. Además, tras un failover, es necesario reanudar las bases de datos en la nueva réplica primaria con el comando ALTER DATABASE … SET HADR RESUME.

    Conclusión

    Always On Availability Groups sin cluster en Windows es una alternativa poderosa para entornos específicos, especialmente aquellos donde los costes o la complejidad de WSFC no son aceptables. Aunque su implementación y administración requieren habilidades avanzadas y mayor supervisión, esta configuración ofrece flexibilidad y simplicidad en infraestructura, siendo especialmente adecuada para entornos de pruebas, desarrollo y réplicas de solo lectura. Sin embargo, su uso en producción debe evaluarse cuidadosamente, teniendo en cuenta sus limitaciones en términos de Quórum, failover automático y escalabilidad.

    Con una correcta planificación y monitorización, esta arquitectura puede proporcionar una solución eficaz para mantener datos sincronizados en escenarios específicos. Si se implementa correctamente, Always On sin cluster puede ser un recurso invaluable para arquitecturas modernas y simplificadas.

    Te invito a seguirnos en el canal de YouTube donde pronto trataré de mostrar la configuración paso a paso de este tipo de Always On.

    Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

    Publicado por Roberto Carrancio en Alta Disponibilidad, SQL Server, 0 comentarios