SQL Server

Migrar SQL 2019 a 2022 con el menor tiempo de inactividad

El fin de soporte de SQL Server 2019 está a la vuelta de la esquina, eso ya lo sabemos. También hemos hablado en esta casa de cómo planificar una migración y, cuando lo hicimos, comentamos la posibilidad de valorar métodos para una migración Online, sin tiempo de inactividad o con el mínimo posible. Y, eso es justo de lo que os quiero contar hoy, esos métodos de migración casi transparentes para el usuario por su nula o baja inactividad.

Preparar una migración

Antes de entrar en las opciones de migración online, es fundamental preparar adecuadamente el entorno. La planificación es clave. Sin entrar mucho en detalle, que ya le dedicamos un artículo entero a este tema, debemos asegurarnos de que todas las aplicaciones que interactúan con la base de datos sean compatibles con SQL Server 2022. Una buena práctica es clonar el entorno de producción en un entorno de pruebas donde podamos simular la migración. Este paso extra nos permitirá identificar posibles inconvenientes y corregirlos antes de afectar el entorno productivo.

También es crucial realizar una evaluación de los requisitos de hardware y software, ya que SQL Server 2022 puede requerir actualizaciones en los sistemas operativos o en el hardware para aprovechar todas sus nuevas características. Una vez que hemos cubierto estos aspectos, estamos listos para explorar las opciones de migración online que nos ayudarán a reducir el tiempo de inactividad.

Migraciones Online (sin inactividad)

Una migración en caliente, también conocida como migración online, es el proceso en el que la base de datos se migra a un nuevo servidor o versión sin interrumpir el servicio o con una interrupción mínima. En lugar de detener las operaciones para realizar la migración, la base de datos permanece activa, y los usuarios pueden seguir accediendo a los datos mientras se lleva a cabo el proceso. Esto es especialmente crítico en entornos donde la disponibilidad continua es esencial, como en sistemas de comercio electrónico, fábricas que no pueden parar la producción o cualquier otro sistema que opere en tiempo real.

Un concepto clave asociado a las migraciones en caliente es el RTO, o «Recovery Time Objective» (Objetivo de Tiempo de Recuperación). El RTO se refiere al tiempo máximo tolerable durante el cual un sistema, aplicación o proceso puede estar inactivo antes de que se produzca un impacto significativo en la organización. En el contexto de una migración, el RTO define cuánto tiempo podemos permitir que la base de datos esté inaccesible durante el cambio, y es un factor crucial para determinar la estrategia de migración.

Cuando hablamos de minimizar el tiempo de inactividad, estamos trabajando directamente para cumplir con el RTO definido. Un RTO corto, como por ejemplo de unos pocos minutos, implica que necesitamos utilizar métodos avanzados de migración en caliente, como Always On, Database Mirroring o Log Shipping, que permiten que el tiempo de transición sea prácticamente imperceptible para los usuarios. De esta manera, podemos asegurar que la migración no solo sea efectiva, sino que también cumpla con las expectativas y requisitos de disponibilidad de la organización.

Migración con Always On: Alto coste, cero inactividad

Always On Availability Groups es, sin duda, una de las tecnologías más potentes y flexibles para lograr una migración con tiempo de inactividad cero o cercano a cero. La idea detrás de Always On es crear un grupo de disponibilidad que replique las bases de datos seleccionadas en uno o más nodos secundarios. Esto no solo ofrece alta disponibilidad y recuperación ante desastres, sino que también facilita las migraciones.

Always On existente

En el mejor de los casos, ya dispondremos de un Always On con dos o más servidores SQL Server 2019. En este caso, para aprovechar Always On en la migración a SQL Server 2022, lo primero que haremos será agregar un nuevo nodo (o varios) con SQL Server 2022 a nuestro grupo de disponibilidad actual. Es importante que el nodo con SQL Server 2022 tenga configurada una replicación síncrona para garantizar que no tendremos pérdida de datos. 

Una vez que el nodo 2022 esté sincronizado y funcionando correctamente, podemos proceder a realizar un failover manual al nuevo nodo. Durante este proceso, la mayoría de las conexiones se mantendrán activas y la interrupción será mínima (de pocos milisegundos).

Con el servicio balanceado al nodo SQL Server 2022, los nodos con SQL Server 2019 perderán la conexión, ya que no podrán alojar bases de datos de un servidor con una versión superior, por lo que tendremos que sacarlos del grupo de disponibilidad y actualizarlos a SQL 2022 o desmontarlos. En este punto, es el momento de añadir el resto de nodos con SQL Server 2022, si aún no lo habíamos hecho, para mantener la alta disponibilidad.

Si nuestro anterior Always On disponía de uno o varios Listener no tendremos que hacer nada más y no habrá ninguna pérdida de servicio. En caso contrario, las aplicaciones y usuarios deberán apuntar al nuevo servidor, con el tiempo de inactividad que conlleve el cambio por su lado.

Sin Always On anteriores

Si no disponemos de un grupo de alta disponibilidad Always On anterior la cosa se complica. Primero tenemos que asegurarnos de cumplir los requisitos para montar el Always On como disponer de una licencia SQL Server Enterprise o una sola base de datos (es la limitación de los Always On básicos con licencia estándar). Si cumplimos con estos requisitos, estamos listos para el siguiente paso, la configuración del Always On. Es importante destacar que este paso necesita de la instalación y configuración del servicio de clúster de Windows (WSFC) lo que nos puede requerir de uno o varios reinicios, con las consecuentes pérdidas de inactividad del servicio de base de datos.

Con el Always On ya configurado los pasos son los descritos en el apartado anterior: asegurarnos de que la replicación es correcta, balancear el servicio, modificar las conexiones de las aplicaciones para que apunten al nuevo servidor y desmontar el AG y apagar el servidor SQL Server 2019.

Migración con DB Mirroring: menor coste, baja inactividad

Database Mirroring es una antigua solución de alta disponibilidad anterior a la implementación de Always On pero que, hasta el día de hoy, se mantiene por compatibilidad. Además, no requiere de WSFC ni de licencia enterprise para funcionar lo que lo hace una solución ideal para nuestra migración con baja inactividad. 

Estos son los pasos a seguir para una migración de baja inactividad con DB Mirroring:

En el servidor SQL Server 2019:

  1. Hacer una copia completa de la base de datos.
  2. Hacer una copia de log de la base de datos.

En el servidor SQL Server 2022:

  1. Restaurar con No Recovery la copia completa de la base de datos
  2. Restaurar con No Recovery la copia de log de la base de datos.

Configurar el DB Mirroring:

  1. En el SQL Server 2019:
  1.  En el SQL Server 2012:
  1. Verifica que la configuración es correcta y que se está replicando en tiempo real. Puedes usar este script:

Migración:

  1. Detén las conexiones de los usuarios y balancea el DB Mirroring para convertir el servidor SQL Server 2022 en principal. Ejecuta este comando en el SQL Server 2022:
  1. Modifica las conexiones de tus aplicaciones y usuarios para que apunten al servidor SQL Server 2022 y restablece la conexión
  2. Elimina el DB Mirroring


Como puedes ver, gracias a este método de migración la pérdida de servicio ha sido mínima, sin embargo, sí que llega a existir. Además cuantas más bases de datos tengas más se va a alargar el proceso que se tiene que repetir manualmente por cada una de ellas.

Migración con Log Shipping: bajo coste, inactividad moderada

El Log Shipping es otra alternativa para realizar la migración de SQL Server 2019 a 2022, especialmente en entornos donde el presupuesto es limitado o donde necesitemos una solución más sencilla. Aunque el Log Shipping no nos ofrezca las mismas ventajas que Always On o Database Mirroring en términos de disponibilidad continua, sigue siendo una herramienta efectiva para minimizar el tiempo de inactividad.

Para el proceso de migración con Log Shipping, configuraremos la copia y restauración periódica de los archivos de registro de transacciones desde el servidor principal con SQL Server 2019 a un servidor secundario con SQL Server 2022. A diferencia de los otros métodos, el Log Shipping requiere un breve tiempo de inactividad al momento de realizar el balanceo final al nuevo servidor.

Para llevar a cabo este balanceo, debemos asegurarnos de que todos los logs pendientes se hayan restaurado en el servidor con SQL Server 2022. Una vez hecho esto, deshabilitaremos el servidor principal y configuraremos el nuevo servidor como el principal. Aunque este método requiere un breve tiempo de inactividad, sigue siendo una opción viable para entornos donde la alta disponibilidad no es crítica o donde la simplicidad y el bajo coste son prioritarios.

Conclusión

Migrar de SQL Server 2019 a 2022 sin inactividad es un proceso que puede parecer difícil, pero con las herramientas y estrategias adecuadas, podemos minimizar significativamente el tiempo de inactividad necesario. Always On, Database Mirroring y Log Shipping ofrecen soluciones adaptadas a diferentes necesidades y presupuestos. Always On es la opción más completa para entornos que no pueden permitirse ningún tipo de interrupción. Database Mirroring ofrece una buena combinación de seguridad y simplicidad, mientras que Log Shipping es ideal para aquellos que buscáis una solución económica y efectiva.

Cada uno de estos métodos tiene sus particularidades y ventajas, y la elección entre ellos dependerá de las características y requisitos específicos de nuestro entorno. Lo que es innegable es que, con la planificación adecuada y el uso de estas tecnologías, podemos llevar a cabo una migración exitosa a SQL Server 2022, garantizando así la continuidad de nuestras operaciones y aprovechando las ventajas de la nueva versión con el mínimo impacto en nuestros usuarios.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Alta Disponibilidad, SQL Server, 0 comentarios

Operadores Spool en planes de ejecución

Una de las primeras cosas que hacemos, o por lo menos que deberíamos hacer, cuando estamos analizando el rendimiento de una consulta es mirar su plan de ejecución. En los planes de ejecución vemos paso a paso y gráficamente lo que hace nuestra consulta. Cada uno de estos pasos de los que hablamos está representado gráficamente por un operador y la mayoría son intuitivos y fáciles de comprender pero hay un tipo en concreto que parece que cuesta un poco más. Me refiero como no podía ser de otra manera a los operadores Spool. Estos componentes pueden marcar la diferencia en términos de eficiencia y tiempo de respuesta de las consultas. En este artículo, profundizaremos en los diferentes tipos de Spool, su propósito, cómo funcionan y cuándo deberíamos prestarles atención.

¿Qué es un operador Spool?

Antes de entrar en detalles, es importante entender qué es un operador Spool. Básicamente, son operadores que almacenan temporalmente un conjunto de filas durante la ejecución de una consulta. Este almacenamiento permite que SQL Server reutilice estos datos en lugar de volverlos a calcular o volver a leerlos desde el disco, lo que puede resultar en una mejora significativa del rendimiento en determinadas situaciones. Existen varios tipos de operadores spool en SQL Server y, aunque todos comparten la definición que hemos mencionado, cada uno tiene sus particularidades. 

Table Spool

El «Table Spool» es el tipo de Spool más común en SQL Server. Su objetivo principal es almacenar el resultado de una subconsulta o una parte del plan de ejecución que es probable que se reutilice. Este tipo de operador suele aparecer cuando tenemos consultas que requieren repetir una operación costosa varias veces. Por ejemplo, si una subconsulta se ejecuta en múltiples ocasiones dentro de una misma consulta, SQL Server puede decidir almacenar temporalmente el resultado de esa subconsulta en un Table Spool para evitar esas múltiples ejecuciones.

Un detalle importante a considerar es que, aunque el Table Spool puede reducir el tiempo de ejecución en general, también consume memoria temporal para almacenar los datos, lo que podría impactar en la eficiencia si el tamaño del Spool es considerablemente grande.

Index Spool

El «Index Spool» se utiliza cuando SQL Server anticipa que necesitará un índice temporal para mejorar la búsqueda de datos en una consulta específica. Este operador crea un índice en memoria, que puede ser utilizado para acelerar operaciones como JOINs o búsquedas basadas en condiciones de filtrado. Aunque esta operación añade un paso adicional al plan de ejecución, la creación de un índice temporal puede resultar en un rendimiento significativamente mejorado, especialmente en consultas que trabajan con grandes volúmenes de datos.

La clave para entender el impacto de un Index Spool está en el balance entre el coste de crearlo y los beneficios que aporta en la fase de búsqueda. En escenarios donde se ejecutan varias búsquedas en un conjunto de datos sin un índice adecuado, este operador se convierte en una solución efectiva.

Row Count Spool

El «Row Count Spool» es un tipo de operador que se emplea principalmente para controlar el número de filas que se procesan en una operación. A diferencia de los Spool anteriores, este no almacena datos per se, sino que mantiene un conteo de las filas que pasan a través de él. Este operador suele aparecer en situaciones donde se requiere un número preciso de filas como resultado de una subconsulta, como cuando usamos la cláusula TOP o una condición de filtrado que limita las filas a procesar.

En resumen, este operador actúa como un portero de discoteca que asegura que solo pasen el número exacto de filas necesarias. Es especialmente útil en operaciones que pueden generar un gran número de filas intermedias, pero donde solo se necesita un subconjunto de ellas. Así, el Row Count Spool ayuda a evitar el procesamiento innecesario, optimizando el rendimiento de la consulta.

Window Spool

El «Window Spool» es menos común pero no menos importante. Este tipo de operador se emplea principalmente en consultas que utilizan funciones de ventana, como ROW_NUMBER(), RANK() o LEAD(). El propósito del Window Spool es soportar el cálculo de estas funciones, almacenando temporalmente el conjunto de datos sobre el cual se aplicarán las funciones de ventana.

Las funciones de ventana requieren acceso a un conjunto completo de datos para calcular correctamente sus resultados. El operador Window Spool permite que SQL Server mantenga un «almacén» de estas filas mientras las operaciones de ventana se ejecutan, garantizando así que el resultado sea el esperado. Aunque puede añadir cierta sobrecarga en términos de memoria, su beneficio en la correcta ejecución de funciones analíticas es crucial.

Optimización y uso

Entender cuándo y cómo aparecen los Spool en los planes de ejecución es vital para optimizar el rendimiento de nuestras consultas. Si bien estos operadores pueden mejorar la eficiencia en muchos casos, su uso inadecuado o innecesario puede tener el efecto contrario. Es fundamental analizar los planes de ejecución y evaluar si la presencia de un Spool está realmente justificada en base al coste adicional que implica su utilización.

En algunos casos, podríamos encontrar que la eliminación de un Spool innecesario, ya sea mediante la reescritura de la consulta o ajustando los índices, resulta en un rendimiento superior. También es importante recordar que estos operadores suelen consumir memoria temporal, por lo que su impacto en la carga general del sistema debe ser monitorizado de cerca.

Recursión

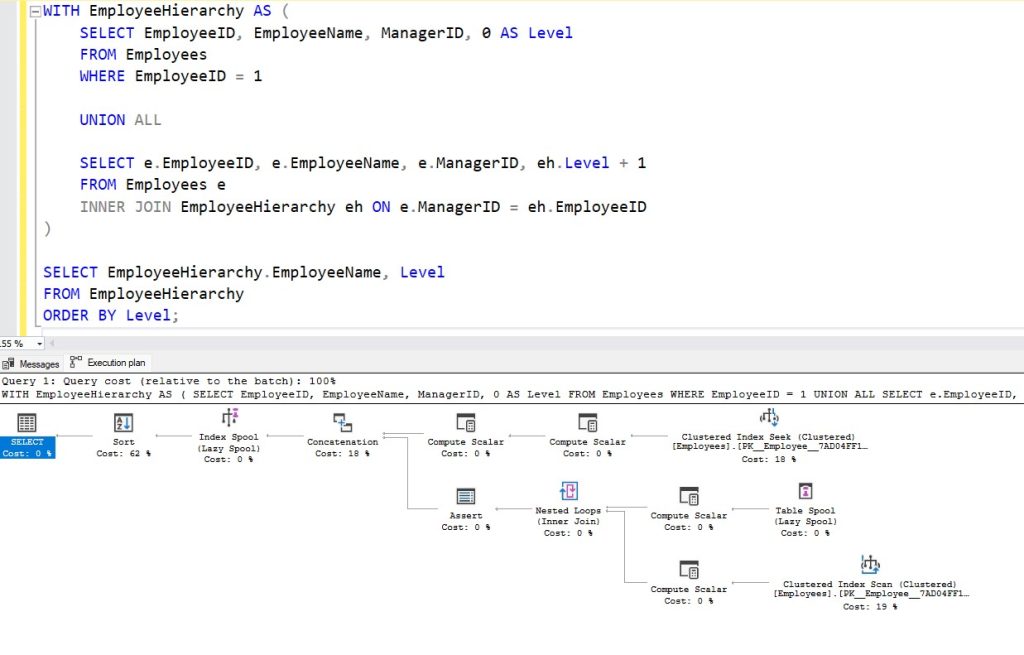
Las consultas recursivas son un ejemplo de la necesidad de operadores Spool. En una consulta recursiva típica, SQL Server tiende a utilizar dos tipos de Spool que resultan esenciales para su correcto funcionamiento y optimización: el Table Spool y el Index Spool.

Spool en recursividad

Table Spool en recursividad

Al principio de una consulta recursiva, SQL Server suele emplear un Table Spool. Este operador, como hemos visto, se utiliza para almacenar el conjunto inicial de filas que formarán la base de la recursión, conocido como la parte ancla en un CTE recursivo. La función principal de este operador es capturar estas filas iniciales para que puedan ser reutilizadas a lo largo de las iteraciones recursivas sin necesidad de recalcular o volver a leer los datos desde el origen.

Este Table Spool es especialmente útil en este contexto porque permite que el proceso recursivo se inicie de manera eficiente, asegurando que las filas base estén disponibles para las iteraciones subsiguientes sin añadir un coste significativo de I/O o de CPU. Este operador se convierte en un «almacén temporal» que facilita la generación de los resultados recursivos de manera escalable.

Index Spool en recursividad

En la fase final de la recursión, cuando se procesan y ordenan los resultados, SQL Server suele introducir un Index Spool. Este operador crea un índice temporal en memoria sobre el conjunto de datos generado durante la recursión. La finalidad de este índice es acelerar la búsqueda y ordenación de los datos, especialmente en consultas que requieren un orden específico o que deben cumplir con condiciones adicionales de filtrado.

El Index Spool optimiza la fase de finalización de la consulta recursiva, permitiendo que SQL Server gestione grandes volúmenes de datos generados por la recursión de manera más eficiente. La creación de este índice temporal puede ser costosa en términos de memoria y CPU, pero su impacto positivo en el rendimiento de la consulta suele justificar su utilización, especialmente en estructuras de datos jerárquicas complejas.

Conclusión

Los operadores Spool en SQL Server son herramientas poderosas que, cuando se utilizan correctamente, pueden mejorar significativamente el rendimiento de nuestras consultas. Desde el Table Spool, que almacena datos para evitar cálculos repetidos, hasta el Window Spool, que soporta funciones analíticas, cada tipo de Spool tiene un propósito específico y un impacto en la forma en que SQL Server procesa las consultas.

Para sacar el máximo provecho de los Spool, es esencial comprender cómo y cuándo aparecen en los planes de ejecución y evaluar su eficacia en cada caso. Aunque estos operadores pueden añadir complejidad al plan de ejecución, su correcta utilización puede ser la clave para lograr un rendimiento óptimo en SQL Server.

En definitiva, los Spool no son solo un detalle técnico, sino una pieza fundamental en la optimización avanzada de consultas. Con el conocimiento adecuado, podemos utilizarlos para transformar consultas lentas en operaciones altamente eficientes, maximizando el rendimiento de nuestras bases de datos.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario

Buenas prácticas en Power BI Report Server (PBIRS)

Continuamos con los artículos sobre Power BI Report Server, ya hemos visto tanto sus características principales como los consejos de implantación y mantenimiento y hoy, y para cerrar esta semana temática, vamos a hablar de buenas prácticas. Lo primero que tenemos que recordar es que Power BI Report Server (PBIRS) está construido sobre la base de SQL Server Reporting Service (SSRS), una herramienta de reporte de BI de Microsoft con más de 15 años en el mercado. Con esto quiero decir que la mayoría de las cosas que vamos a ver ahora os sonarán familiares si ya habéis administrado SSRS pero si no es así no os preocupéis que para eso lo vamos a ver.

Configuración avanzada de Report Server

Cuando instalamos PBIRS tendremos a nuestra disposición una herramienta de configuración calcada a la de SSRS donde podremos realizar las configuraciones más básicas de este servicio. Sin embargo, esto no es todo,habrá aspectos que configuraremos en el propio servicio web y otros, los más avanzados, para los que necesitaremos un SSMS. Y, en concreto, son tres de estas configuraciones de las que vamos a hablar en este apartado. Configuraciones que, para la mayoría de las empresas pueden funcionar pero, para otras igual no tanto.

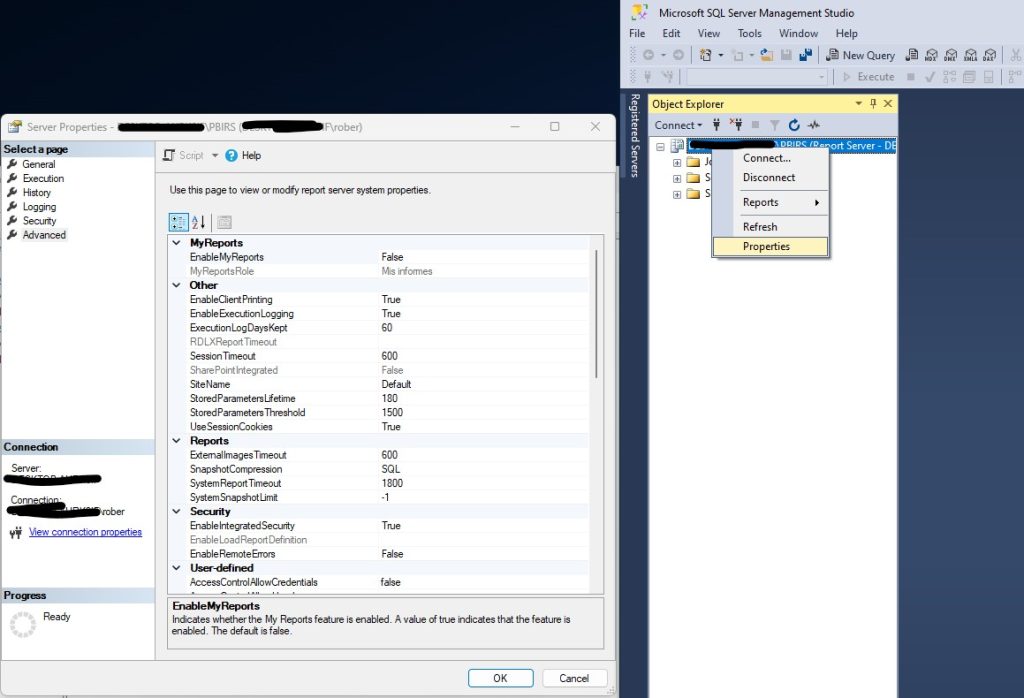
Para acceder a estas configuraciones nos conectaremos a nuestro PBIRS desde nuestro Management Studio (SSMS) usando la opción de conexión a SQL Server Reporting Service (SSRS). Una vez conectados abriremos las propiedades de la instancia y accederemos a las propiedades avanzadas. Aquí, entre otras, podremos encontrar la siguientes configuraciones:

Power BI Report Server Advanced Config

EnableMyReports

La configuración “Enable and disable My Reports» nos permite a los administradores activar o desactivar la funcionalidad de «Mis informes». Esta función, desactivada por defecto, ofrece a los usuarios la posibilidad de crear un espacio personal dentro del servidor donde pueden guardar y gestionar sus propios informes. Esto es similar al concepto Mi espacio de trabajo que tienen los usuarios dentro del servicio Power BI. Habilitar Mis informes es una excelente manera de fomentar la BI de autoservicio y puede ser beneficioso para fomentar la personalización y la autonomía de los usuarios, permitiéndoles trabajar de manera más eficiente sin sobrecargar los espacios compartidos del servidor. No obstante, dejarlo desactivado puede ser preferible en entornos donde la uniformidad y el control sobre los informes es una prioridad.

ExecutionLogDaysKept

ExecutionLogDaysKept es otra configuración importante que define cuántos días se conservan los registros de ejecución de informes en el servidor. Estos logs son fundamentales para el análisis de rendimiento y la solución de problemas, ya que contienen información detallada sobre cada ejecución de informes. Ajustar esta configuración nos permite a los administradores balancear entre la retención de información suficiente para análisis detallados y la gestión eficiente del espacio de almacenamiento. Por defecto esta propiedad está establecida en 60 días, un periodo de retención más largo puede ser útil para auditorías y análisis históricos, sobre todo si tienes informes que se ejecutan sólo una vez al mes o menos. Por otro lado, un periodo más corto puede ayudar a optimizar el rendimiento del servidor. 

EnablePowerBIReportExportUnderlyingData

Por último, la configuración EnablePowerBIReportExportUnderlyingData controla si los usuarios tienen permiso para exportar los datos subyacentes de los informes de Power BI. Esta opción es crucial para mantener la seguridad y privacidad de los datos. Permitir la exportación puede ser necesario para usuarios que requieran analizar la información fuera de la plataforma, pero también puede suponer un riesgo si los datos son sensibles. Por ello, esta configuración debe ser ajustada con cuidado, asegurando que solo los usuarios adecuados tengan acceso a esta funcionalidad y que se cumplan las políticas de seguridad de la organización. 

Si me preguntáis por mi opinión, yo soy totalmente partidario de deshabilitar esta opción. Además, un abuso de la descarga de información en horas de mucha actividad de usuarios puede suponernos un verdadero quebradero de cabeza.

Seguridad a nivel de carpetas en Report Server

Llegamos a una de las principales diferencias entre Power BI Report Server y el servicio en la nube de Power BI. Mientras en el cloud tenemos Workspaces que sirven como entornos aislados colaborativos para que los equipos desarrollen contenido de Power BI al unísono. Después creamos aplicaciones para facilitar la entrega del contenido a los usuarios. Estos conceptos no existen en Power BI Report Server. En PBIRS tendremos que usar carpetas.

Las carpetas dentro de Power BI Report Server (y SSRS) se comportan como carpetas dentro de un sistema de archivos. La seguridad a nivel de carpeta se puede aplicar para restringir el acceso a todo el contenido de la carpeta. Además, al igual que un sistema de archivos, se puede crear una jerarquía de carpetas. Esto es diferente a la naturaleza aplanada de App Workspaces dentro del servicio Power BI. 

Gestión de los permisos

Estemos alojando informes en el servicio o en PBIRS, debemos realizar una planificación cuidadosa desde el principio para proteger adecuadamente su contenido. Normalmente, tiene sentido crear carpetas para diferentes departamentos o equipos de la empresa como, por ejemplo, ventas, contabilidad, marketing, etc…

Aunque en Power BI Report Server (PBIRS), también podemos definir la seguridad en elementos individuales (por ejemplo, un único informe), normalmente no es una práctica. En implementaciones grandes, podemos encontrarnos con decenas o cientos de informes y mantener individualmente los permisos sería una pesadilla. Del mismo modo tenemos que huir de los permisos a usuarios individuales y, siempre que sea posible, utilizar grupos de usuarios. Si llevamos esto a rajatabla, podremos proteger múltiples informes relacionados y habilitar su uso para un subconjunto de usuarios sin complicaciones. 

En la mayoría de los casos, también recomiendo que os ciñais a una estructura de carpetas plana. De este modo, no solo será más fácil proteger las carpetas, también PBIRS coincidirá lógicamente con la estructura plana de Workspaces en el servicio Power BI. Esto nos facilitará la tarea de migración o  transferencia del contenido de Power BI Report Server (PBIRS) al servicio Power BI en la nube si alguna vez queremos hacerlo.

Reutilizar un modelo de datos en Report Server

Una de las limitaciones de Power BI Report Server (PBIRS) frente al servicio de Power BI en la nube es la capacidad de utilizar un mismo modelo de datos para diferentes informes. Así, mientras que en Power BI en la nube todos nuestros informes pueden acceder a un mismo modelo, si tenemos 12 informes que usan el mismo modelo de datos, en Power BI Report Server (PBIRS) tendremos que mantener 12 copias del modelo de datos. Esto, no hace falta que os lo diga, es un problema a la hora de actualizar los modelos y puede generar una discrepancia de datos entre los informes, que, en el mejor de los casos, nos provocará una reprimenda por parte de los usuarios. 

Sin embargo, nosotros que somos DBAs y sabemos de bases de datos y, sobre todo, de servicios de SQL Server, sabemos que podemos aprovecharnos de las capacidades de SQL Server Analysis Services para almacenar nuestras bases de datos dimensionales y, desde los informes de Power BI simplemente acceder a ese único origen de datos compartido para todos los reportes.

Analysis Services es una excelente opción si ya tenemos una inversión en SQL Server y sus componentes de BI, que la tendremos si hemos licenciado PBIRS con la licencia de SQL Server Enterprise. Sin embargo, si estamos implementando Power BI Report Server gracias al licenciamiento de Power BI Premium, también podemos aprovechar los conjuntos de datos que residen en la capacidad Premium como modelos de datos reutilizables.

Podemos establecer una conexión desde nuestros informes de Power BI a un conjunto de datos Premium como si fuera un modelo de Analysis Services. Para ello, debemos asegurarnos de que nuestra capacidad Premium tenga habilitada la lectura en la configuración del extremo XMLA.

Conclusión

En resumen, Power BI Report Server (PBIRS) es una herramienta muy potente, que, si se configura y gestiona adecuadamente, puede convertirse en un pilar fundamental para la inteligencia de negocio en tu organización. Desde la configuración avanzada para habilitar funciones como «Mis informes» o controlar la exportación de datos subyacentes, hasta la gestión cuidadosa de la seguridad a nivel de carpetas y la reutilización de modelos de datos, podemos optimizar cada aspecto de PBIRS para alinearlo con las necesidades y políticas de nuestra empresa. Implementar estas buenas prácticas no solo mejorará el rendimiento y la seguridad de nuestro entorno de reportes, sino que también facilitará futuras migraciones al servicio Power BI en la nube, asegurándonos que nuestra infraestructura de BI está preparada para el crecimiento y el cambio.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Power BI, Rendimiento, 0 comentarios

Despliegue y mantenimiento de PBIRS

Hoy vamos a seguir hablando de PBIRS, si en el pasado artículo vimos sus características, licenciamiento y cómo se compara con el servicio de Power BI en la nube (más bien cómo se complementa) hoy toca el turno de la configuración y mantenimiento del mismo. Lo primero que tenemos que saber es que la instalación de un servidor de Power BI Report Server (PBIRS), como la de cualquier otro servicio de producción, es un proceso que requiere una planificación meticulosa y un mantenimiento continuo para garantizar un rendimiento óptimo y la satisfacción de los usuarios. 

En este artículo, explicaremos algunas de las mejores prácticas que he identificado en mi experiencia con PBIRS, centrándonos en cómo implementarlas eficazmente y en cómo mantener la infraestructura una vez que esté en funcionamiento. La finalidad es maximizar la eficiencia, mejorar la seguridad y garantizar que los informes se ejecuten sin problemas, todo ello sin sacrificar la experiencia del usuario.

Planificando la Implementación de PBIRS

Como ya vimos cuando hablamos del despliegue de un servidor SQL Server, la planificación es un componente crucial en cualquier implementación, por tanto también cuando hablamos de PBIRS. Debemos comenzar con un análisis detallado de los requisitos de negocio y la capacidad técnica del entorno en el que se va a desplegar. Es esencial comprender no solo las necesidades actuales, sino también prever el crecimiento futuro y la escalabilidad de la plataforma.

Dimensionamiento y configuración del Servidor

Uno de los primeros pasos es dimensionar adecuadamente el servidor. La configuración del hardware debe estar alineada con la carga esperada de usuarios y la complejidad de los informes. Por ejemplo, si prevemos un uso intensivo de gráficos complejos o de grandes volúmenes de datos, será necesario disponer de un hardware más potente, con suficiente memoria RAM y capacidad de procesamiento para manejar las demandas sin comprometer el rendimiento.

Es recomendable dividir los recursos en diferentes servidores si el tráfico de usuarios o la carga de trabajo lo justifican, esto es un escalado horizontal. De esta manera, podemos evitar que un único punto de fallo impacte en la disponibilidad del servicio. Por supuesto, no debemos olvidar la importancia de configurar adecuadamente el almacenamiento, utilizando discos rápidos para el almacenamiento de bases de datos y optimizando las rutas de acceso para minimizar latencias.

Seguridad y gobernanza de los datos

A nadie le sorprende si os digo que la seguridad de los datos es primordial. PBIRS no es una excepción, y por ello es crucial establecer políticas de seguridad estrictas desde el inicio. Esto incluye la implementación de medidas como la autenticación segura, la encriptación de datos y la segregación de funciones para evitar accesos no autorizados.

Además, la gobernanza de los datos es otro aspecto que debemos considerar. Normalmente las organizaciones más grandes cuentan con equipos de gobierno del dato con quien deberemos trabajar estrechamente para establecer roles y permisos claros, así como auditar regularmente los accesos y las actividades dentro del servidor, nos ayudará a mantener un entorno seguro y conforme con las normativas vigentes. Es probable que en este proceso también intervenga el equipo de ciberseguridad, tanto en la toma de decisiones como en la monitorización continua de las auditorías.

Buenas Prácticas en PBIRS

Una vez que hemos planificado adecuadamente la implementación, es el momento de poner manos a la obra. Aquí es donde entran en juego las mejores prácticas específicas de implementación que nos permitirán maximizar el rendimiento y la funcionalidad de PBIRS.

Despliegue y Configuración Inicial

Durante el despliegue, es fundamental seguir las guías de instalación recomendadas por Microsoft, asegurándonos de que todas las dependencias están en su lugar y configuradas correctamente. Una vez instalado el servidor, debemos proceder con la configuración inicial, que incluye la creación de la base de datos de reportes, la configuración del servicio web y la aplicación de las políticas de seguridad definidas previamente.

Configuración de HTTPS en PBIRS

Un aspecto clave para la seguridad de PBIRS es el uso de HTTPS en lugar de HTTP para el servidor web. HTTPS asegura que los datos transmitidos entre los clientes y el servidor estén encriptados, lo que protege la información sensible de accesos no autorizados o ataques de intermediarios.

Implementar HTTPS en PBIRS requiere configurar el servidor web para aceptar conexiones seguras. Para ello, es necesario obtener e instalar un certificado SSL/TLS válido emitido por una autoridad de certificación de confianza. Los certificados SSL permiten que el servidor establezca una conexión segura y encriptada con los usuarios, lo que es fundamental para proteger la integridad y confidencialidad de los datos transmitidos.

Una vez que tenemos el certificado, debemos configurarlo en el servidor web de PBIRS. Este proceso generalmente implica asociar el certificado con el puerto 443, que es el puerto estándar para las conexiones HTTPS. Es crucial asegurarse de que todas las páginas y recursos del servidor se sirvan a través de HTTPS, redirigiendo automáticamente cualquier tráfico HTTP para evitar conexiones inseguras.

Mantenimiento Continuo de PBIRS

El mantenimiento es un aspecto que a menudo se subestima, pero es crucial para asegurar que el servidor siga funcionando de manera óptima a lo largo del tiempo. Este mantenimiento no solo incluye las actualizaciones regulares del software, sino también la monitorización proactiva y la gestión del rendimiento.

Monitorización y Rendimiento

Una de las mejores prácticas en el mantenimiento de PBIRS es la monitorización constante del rendimiento. Esto incluye la revisión de los logs de uso para identificar posibles cuellos de botella y la supervisión de los recursos del servidor para detectar cualquier signo de sobrecarga.

Utilizar herramientas de monitorización que permitan visualizar en tiempo real el uso de CPU, memoria y disco es fundamental. Esto nos permitirá anticiparnos a posibles problemas antes de que afecten a los usuarios finales. Además, realizar pruebas de estrés de manera periódica puede ayudarnos a ajustar la configuración del servidor para manejar mejor las cargas pico.

Actualizaciones y Parches

Mantener PBIRS actualizado es una práctica indispensable para asegurar tanto la estabilidad como la seguridad del sistema. Microsoft publica regularmente actualizaciones, normalmente 3 al año, que corrigen errores, mejoran el rendimiento y añaden nuevas funcionalidades. Sin embargo, antes de aplicar cualquier actualización, es recomendable realizar pruebas en un entorno de desarrollo o de preproducción para asegurarnos de que no introducirá nuevos problemas en el entorno de producción.

Además, es importante mantener actualizadas las bases de datos y los sistemas operativos subyacentes, ya que cualquier vulnerabilidad en estos componentes podría comprometer la seguridad y la integridad de los datos.

Gestión de la Capacidad y Escalabilidad

A medida que el uso de PBIRS crece, también lo hará la demanda de recursos. Por ello, es esencial gestionar la capacidad de manera proactiva, añadiendo recursos o distribuyendo la carga cuando sea necesario. Implementar una estrategia de escalabilidad, que incluya tanto la escalabilidad horizontal (añadir más servidores) como la vertical (mejorar los recursos de los servidores existentes), nos permitirá mantener un rendimiento óptimo a medida que crece la base de usuarios y la complejidad de los informes.

Optimización en la entrega de Informes

Para garantizar que los informes se entreguen de manera eficiente, es necesario optimizarlos. Esto implica una revisión continua tanto de consultas DAX como SQL para asegurarnos de que están bien escritas y no consumen recursos innecesarios. También es aconsejable utilizar particiones de datos en modelos grandes y evitar el uso excesivo de gráficos o visualizaciones que puedan ralentizar el rendimiento. 

Otro punto clave es configurar adecuadamente los tiempos de actualización de los informes. Definir horarios de actualización en momentos de baja demanda puede reducir significativamente el impacto en el rendimiento general del servidor.

Renovación de certificados

Por último no se nos debe olvidar que la implementación de HTTPS, de la que hemos hablado antes, no es un proceso único; es necesario que renovemos los certificados periódicamente para mantener la seguridad del sistema. Los certificados SSL tienen una validez limitada (de uno o dos años por norma general), por lo que debemos estar atentos a su fecha de expiración y renovarlos con antelación para evitar interrupciones en el servicio o alertas de seguridad para los usuarios.

Además, es recomendable utilizar certificados de autoridades de certificación reconocidas y evitar los certificados autofirmados en entornos de producción, ya que estos no son confiables por los navegadores modernos y pueden generar advertencias de seguridad para los usuarios.

Conclusión

La implementación y el mantenimiento de Power BI Report Server requieren un enfoque detallado y proactivo para garantizar que el sistema funcione de manera eficiente y segura. Desde la planificación inicial hasta el mantenimiento continuo, cada etapa del proceso ofrece oportunidades para optimizar el rendimiento y mejorar la experiencia del usuario. Al seguir las mejores prácticas descritas en este artículo, estaremos mejor preparados para abordar los desafíos que puedan surgir y asegurar que PBIRS continúe siendo una herramienta valiosa para la organización.

En última instancia, la clave del éxito radica en la planificación cuidadosa, la optimización constante y la monitorización proactiva, lo que nos permitirá maximizar el valor de nuestra inversión en Power BI Report Server y garantizar que sigue cumpliendo con las necesidades de negocio a lo largo del tiempo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, Rendimiento, 0 comentarios

Transacciones Distribuidas y DTC

Cuando hablamos de sistemas de bases de datos, uno de los retos más grandes es garantizar la consistencia de los datos en entornos distribuidos. No suele ser lo común pero, a medida que las arquitecturas de aplicaciones se vuelven más complejas, surge la necesidad de coordinar múltiples transacciones que puedan involucrar diferentes bases de datos o incluso diferentes servidores. Aquí es donde entra en juego el concepto de transacciones distribuidas, y en SQL Server, el Distributed Transaction Coordinator (DTC) juega un papel crucial.

¿Qué son las Transacciones Distribuidas?

Una transacción distribuida es aquella que abarca más de un recurso de red, como bases de datos o sistemas de archivos ubicados en diferentes servidores. A diferencia de una transacción local que afecta a una sola base de datos, las transacciones distribuidas tienen la capacidad de coordinar cambios en varias bases de datos, asegurando que todos los participantes de la transacción lleguen a un estado de compromiso o vuelvan a un estado previo en caso de fallo.

El desafío en las transacciones distribuidas es garantizar que todos los nodos involucrados lleguen a un consenso sobre el resultado de la transacción. Esto es fundamental para mantener la integridad de los datos y evitar inconsistencias que podrían llevar a resultados inesperados o, en el peor de los casos, a la corrupción de los datos.

Distributed Transaction Coordinator (DTC)

En SQL Server, el Distributed Transaction Coordinator (DTC) es el componente encargado de gestionar las transacciones distribuidas. Su función principal es asegurar que todas las partes de una transacción distribuida, que pueden involucrar múltiples bases de datos y servidores, se comprometan correctamente o se deshagan en caso de error.

DTC utiliza el protocolo de dos fases (2PC, por sus siglas en inglés) para coordinar las transacciones. Este protocolo se divide en dos fases: la fase de preparación y la fase de compromiso. En la primera fase, DTC pregunta a todos los participantes si están listos para comprometer la transacción. Si todos responden afirmativamente, se procede a la segunda fase, donde se envía la orden de compromiso. Si alguno de los participantes no puede comprometerse, se inicia el proceso de deshacer la transacción en todos los participantes, asegurando que el sistema vuelva a un estado coherente.

Configuración y uso de Transacciones Distribuidas en SQL Server

Para aprovechar las transacciones distribuidas en SQL Server, primero necesitamos asegurarnos de que DTC esté configurado y funcionando correctamente en todos los servidores involucrados. Esto implica la configuración tanto a nivel de sistema operativo como en SQL Server.

Configurar DTC a nivel sistema operativo y red

En cuanto a la configuración del sistema operativo, es crucial que DTC esté habilitado y configurado para permitir transacciones remotas, ya que, por defecto, estas suelen estar desactivadas por razones de seguridad. Para habilitar DTC, desde el panel de control tendremos que acceder a “Agregar o Quitar Componentes de Windows” y activar la opción “Habilitar el acceso DTC de red”. Una vez hecho esto, y reiniciado el servidor si se nos requiere, el equipo estará listo para admitir transacciones distribuidas.

Sin embargo, esto no es todo, es importante asegurarse de que las reglas del firewall permitan la comunicación entre los servicios DTC de los diferentes servidores. DTC usa llamadas al procedimiento remoto RPC por lo que los puertos necesarios son, en primer lugar el puerto 135 TCP y UDP para establecer la comunicación y después un puerto TCP dinámico del rango 49152-65535. Este rango se puede configurar cambiando configuraciones del registro de windows si lo deseamos pero lo importante es que, nuestro firewall admita conexiones tanto por el puerto 135 como por todos los del rango dinámico seleccionado.

Usar DTC en SQL Server

Una vez que DTC esté operativo, podremos comenzar a utilizar transacciones distribuidas en SQL Server. Esto se hace a través de la instrucción BEGIN DISTRIBUTED TRANSACTION, que inicia una transacción distribuida que abarca múltiples servidores. Es importante tener en cuenta que, aunque la sintaxis es similar a la de una transacción local, el alcance y la complejidad son considerablemente mayores.

Un ejemplo sencillo podría involucrar dos servidores SQL Server diferentes. Comenzamos la transacción distribuida en el primer servidor y realizamos las operaciones necesarias. Luego, nos conectamos al segundo servidor y realizamos más operaciones dentro de la misma transacción. Finalmente, decidimos si se comprometen los cambios (commit) o si se deshacen (rollback).

Consideraciones en el Uso de Transacciones Distribuidas

Aunque el uso de transacciones distribuidas y DTC ofrece grandes ventajas en términos de consistencia y fiabilidad, también presenta una serie de retos que debemos considerar.

En primer lugar, las transacciones distribuidas suelen ser más lentas que las locales debido a la sobrecarga de la coordinación entre múltiples nodos. Esto puede afectar el rendimiento de las aplicaciones, especialmente en sistemas con alta concurrencia.

Además, la complejidad de la configuración y la gestión de DTC puede ser un obstáculo en muchas organizaciones donde, también será común involucrar a varias personas de varios departamentos para el cambio. Es vital asegurarse de que todos los servidores involucrados estén correctamente configurados y que la comunicación entre ellos sea fluida. Cualquier problema en la configuración de DTC puede resultar en errores difíciles de diagnosticar, que pueden ser muy costosos de resolver en producción.

Otro aspecto a tener en cuenta es la fiabilidad del sistema. Aunque DTC está diseñado para manejar fallos, es esencial contar con mecanismos adicionales de recuperación y monitorización para minimizar el impacto de posibles fallos de red o de los servidores.

Por último, es fundamental considerar la seguridad en la configuración de DTC. Dado que las transacciones distribuidas pueden involucrar la transferencia de datos sensibles entre servidores, es necesario implementar medidas de seguridad robustas para proteger esta información. Esto incluye el uso de comunicaciones seguras, así como la correcta configuración de permisos y autenticaciones.

Buenas prácticas para la gestión de Transacciones Distribuidas

Para gestionar eficazmente las transacciones distribuidas en SQL Server, es importante seguir una serie de buenas prácticas que nos permitirán minimizar riesgos y maximizar el rendimiento.

En primer lugar, debemos evitar utilizar transacciones distribuidas a menos que sean absolutamente necesarias. Si es posible, debemos buscar alternativas, como la replicación o el uso de servicios distribuidos que manejen la consistencia eventual. Las transacciones distribuidas deben reservarse para casos en los que la consistencia estricta sea un requisito ineludible. Si, el primer consejo es no lo hagas, es lo que hay.

Cuando sea necesario utilizar transacciones distribuidas, es fundamental optimizar el diseño de las mismas para reducir al mínimo el tiempo que la transacción está abierta. Esto incluye realizar todas las operaciones preparatorias fuera de la transacción y asegurarse de que el código dentro de la transacción sea lo más eficiente posible.

Además, es recomendable implementar una monitorización continua del rendimiento y de los posibles errores de DTC. Existen herramientas en SQL Server que nos permiten rastrear y analizar el rendimiento de las transacciones distribuidas, así como diagnosticar problemas en tiempo real. Por ejemplo, SQL Server Profiler, xEvents o DMVs.

Conclusión

Las transacciones distribuidas y el uso de DTC en SQL Server son herramientas poderosas que permiten garantizar la consistencia de los datos en entornos complejos y distribuidos. Sin embargo, su uso requiere una planificación cuidadosa y una gestión rigurosa para evitar problemas de rendimiento y fiabilidad.

Es importante recordar que no todas las aplicaciones necesitan transacciones distribuidas. En muchos casos, existen soluciones alternativas que pueden ofrecer la consistencia y fiabilidad necesarias sin la complejidad adicional. Cuando se opte por utilizar transacciones distribuidas, debemos asegurarnos de seguir las buenas prácticas y mantener una supervisión constante para garantizar el éxito a largo plazo.

Si abordamos las transacciones distribuidas con una comprensión clara de sus beneficios y limitaciones, y si estamos dispuestos a invertir en su correcta implementación, podemos lograr una gestión eficiente y segura de nuestros sistemas distribuidos en SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!


Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Bloqueos Optimizados

Hoy vamos a hablar de una de las características nuevas que implementan las bases de datos de Azure para maximizar el rendimiento sin comprometer la integridad de los datos. Cuando diseñamos y gestionamos nuestras bases de datos, debemos considerar cómo se gestionan los bloqueos, especialmente en entornos con alta concurrencia. La gestión de bloqueos es crucial para garantizar que múltiples transacciones puedan ejecutarse en paralelo sin conflictos. En este artículo, exploraremos en profundidad los bloqueos optimizados en las Azure Databases, cómo funcionan y cómo pueden ser aprovechados para mejorar el rendimiento de nuestras aplicaciones.

¿Qué son los bloqueos optimizados en Azure SQL Database?

Los bloqueos optimizados son una característica avanzada de Azure SQL Database diseñada para reducir la contención (bloqueos) y, por tanto, mejorar el rendimiento de las transacciones en entornos con alta concurrencia. En esencia, esta característica permite al motor de bases de datos minimizar el tiempo durante el cual las transacciones mantienen bloqueos, reduciendo así la posibilidad de que otras transacciones tengan que esperar para acceder a los mismos recursos. En entornos con alta concurrencia, como los que a menudo manejamos en la nube, esta optimización puede marcar la diferencia entre una aplicación fluida y una plagada de cuellos de botella.

El principio básico detrás de los bloqueos optimizados es el uso eficiente de los recursos del sistema. Las bases de datos tradicionales suelen imponer bloqueos a nivel de fila, página o tabla, lo que puede llevar a que las transacciones se bloqueen entre sí si intentan acceder a los mismos datos. Con los bloqueos optimizados, Azure SQL Database ajusta dinámicamente el nivel de bloqueo, permitiendo que las transacciones adquieran solo los bloqueos necesarios y los liberen lo antes posible. De este modo, se mejora la eficiencia general del sistema.

¿Dónde puedo usar los bloqueos optimizados?

A día de hoy, los bloqueos optimizados son una característica exclusiva de las Azure SQL Databases, no vamos a encontrar esta funcionalidad ni en versiones de SQL Server ni en Azure Managed Instance. Si estamos trabajando con Azure SQL Databases (sea cual sea nuestro nivel de servicio) debemos saber que los bloqueos optimizados están habilitados por defecto y, por tanto, podremos esperar el comportamiento que veremos a continuación siempre y cuando no los deshabilitemos. También es importante mencionar que esta funcionalidad depende de la recuperación acelerada de base de datos (ADR) por lo que si en algún momento deshabilitamos ADR en nuestra base de datos perderemos la funcionalidad de los bloqueos optimizados.

Funcionamiento de los bloqueos optimizados

Para entender cómo los bloqueos optimizados logran mejorar el rendimiento, es imprescindible entender cómo funciona esta gestión a bajo nivel. Cuando una transacción se ejecuta en Azure SQL Database, el motor de la base de datos evalúa el impacto potencial de los bloqueos necesarios. Dependiendo de factores como la naturaleza de la consulta, el nivel de aislamiento de la transacción y la carga actual del sistema, el motor decide si aplicar un bloqueo exclusivo, compartido o, en algunos casos, ninguno en absoluto. De esto ya hemos hablado en nuestro artículo sobre los bloqueos y deadlocks.

Uno de los aspectos clave de esta optimización es la técnica conocida como «lock escalation» o escalado de bloqueos. En lugar de aplicar bloqueos a nivel de fila o página, que pueden ser demasiado restrictivos, el motor de Azure SQL Database puede optar por escalar el bloqueo a un nivel superior (como a nivel de tabla) o utilizar técnicas de versionado de filas (row versioning). Esto permite que múltiples transacciones accedan simultáneamente a diferentes partes de los datos sin interferir entre sí.

Además, los bloqueos optimizados se integran con otras características avanzadas de Azure SQL Database, como las transacciones de larga duración y el procesamiento de consultas en paralelo. El motor de la base de datos tiene la capacidad de ajustar dinámicamente la estrategia de bloqueo según la duración y complejidad de las transacciones, lo que minimiza el impacto en el rendimiento.

TID y LAQ: Las claves para entender esto

Si queremos profundizar en los bloqueos optimizados hay dos conceptos fundamentales que debemos dominar: el Transaction ID (TID) y el Lock Acquisition Queue (LAQ). Estos términos juegan un papel crucial en la forma en que el motor de base de datos gestiona y optimiza los bloqueos, especialmente en entornos con alta concurrencia.

Transaction ID (TID)

El Transaction ID (identificador de transacción) , conocido como TID, es un identificador único asignado por el motor de la base de datos a cada transacción que se inicia en Azure SQL Database. Este identificador es esencial para la gestión de bloqueos, ya que permite al sistema rastrear de manera precisa qué transacción está accediendo a qué recursos en un momento dado. Además, el TID facilita la implementación de estrategias de bloqueo como la escalada de bloqueos y el versionado de filas.

Cuando una transacción se ejecuta en Azure SQL Database, el TID se convierte en la referencia central para todas las operaciones que esa transacción realiza. Cada vez que la transacción intenta leer o modificar un registro, el motor de la base de datos utiliza el TID para determinar si es necesario adquirir un nuevo bloqueo, mantener un bloqueo existente o escalarlo. Esta capacidad de rastreo granular es lo que permite a Azure SQL Database aplicar bloqueos de manera eficiente y minimizar la contención entre transacciones.

El TID también juega un papel fundamental en la resolución de conflictos entre transacciones concurrentes. Si dos transacciones intentan acceder al mismo recurso al mismo tiempo, el motor de la base de datos utilizará los TIDs asociados para decidir cuál transacción obtendrá acceso al recurso y cuál tendrá que esperar o, en casos extremos, finalizará esa transacción y deberá ser reintentada. Este proceso es esencial para mantener la integridad de los datos y evitar condiciones de carrera, donde el resultado de una transacción podría depender del orden en que se completan otras transacciones.

TID en acción

Vamos a ver cómo aplica esto en la práctica con un ejemplo muy sencillo. Para ello partiremos de la siguiente consulta que, como veis, crea una tabla, inserta unos valores y en una transacción actualiza esos registros. Antes de cerrar la transacción consultamos los bloqueos e intentos de bloqueos generados para después cerrar la transacción y borrar la tabla.

Si ejecutamos esto en SQL Server o en una base de datos de una instancia administrada de Azure (Azure Managed Instance) veremos que se generan cuatro registros, tres bloqueos exclusivos a nivel de clave y un intento de bloqueo exclusivo a nivel de página. Os dejo un ejemplo:

No Bloqueos Optimizados TIP

Sin embargo, la misma consulta sobre una base de datos de Azure con bloqueos optimizados solo genera un bloqueo exclusivo a nivel de transacción:

Bloqueos Optimizados TIP

Lock Acquisition Queue (LAQ)

El Lock Acquisition Queue (bloqueo después de la calificación), o LAQ, es otro concepto clave en la gestión de bloqueos optimizados. La LAQ es esencialmente una cola en la que las transacciones esperan para adquirir un bloqueo sobre un recurso determinado. Cuando trabajamos en un entorno de base de datos concurrido, donde múltiples transacciones pueden intentar acceder al mismo recurso simultáneamente, la LAQ nos ayuda a gestionar y organizar estas solicitudes de bloqueo para minimizar el tiempo de espera y evitar conflictos.

Cuando una transacción intenta adquirir un bloqueo sobre un recurso que ya está bloqueado por otra transacción, se coloca en la LAQ correspondiente a ese recurso. A medida que los recursos se van liberando, las transacciones en la LAQ se procesan en orden, lo que garantiza que las transacciones que han estado esperando más tiempo tengan prioridad para acceder al recurso. Este enfoque ayuda a reducir la contención y asegura que las transacciones no se bloqueen indefinidamente, lo que nos podría causar tiempos de espera excesivos y degradación del rendimiento.

La LAQ no solo gestiona el orden en que las transacciones adquieren bloqueos, sino que también juega un papel crucial en la optimización de los bloqueos mismos. En lugar de simplemente otorgar un bloqueo cuando un recurso se libera, el motor de Azure SQL Database utiliza la información en la LAQ para decidir si es necesario escalar el bloqueo a un nivel superior, como a nivel de tabla, o si se puede mantener a un nivel más granular, como a nivel de fila. Esta flexibilidad es clave para maximizar la concurrencia y minimizar la sobrecarga de bloqueo.

LAQ en acción

Si recordáis cuando hablamos de los bloqueos, comentamos que las consultas se evalúan fila a fila para comprobar si se pueden realizar o creando primero un bloqueo compartido de actualización (U). En caso de no haber conflicto ese bloqueo escala a un bloqueo (X) antes de realizar la actualización. Este paradigma cambia cuando tenemos bloqueos optimizados y un nivel de aislamiento Read Committed Snapshot o RCSI (por defecto en las bases de datos de Azure) evaluando ahora las consultas contra la versión confirmada más reciente y en caso de no haber conflicto la transacción adquiere un bloqueo (X) y se completa.

¿Te ha sonado a chino todo esto? No te preocupes que te lo enseño con un ejemplo. Mira esta captura sobre una base de datos de Azure.

Bloqueos Optimizados LAQ 1

En el ejemplo anterior, he creado una tabla en la sesión de la izquierda, introducido tres registros y posteriormente he actualizado el primero dentro de una transacción que no he llegado a confirmar ni revertir la transacción. Mientras tanto, en la sesión de la derecha he actualizado otro de los registros de la tabla sin problema. Esto en SQL Server o en Azure Managed instance generaría un bloqueo y la transacción de la derecha no llegaría a completarse pues, aunque son registros diferentes, la tabla no tiene ningún índice y eso hace que el bloqueo (X) no se realice a nivel de fila. ¿No te lo crees? Te lo demuestro.

No Bloqueos Optimizados LAQ

Beneficios de los Bloqueos Optimizados en entornos de alta concurrencia

Los entornos de alta concurrencia, como en los que solemos trabajar cuando tenemos aplicaciones empresariales críticas, son los que más se benefician de los bloqueos optimizados. En estos escenarios, múltiples usuarios o aplicaciones pueden estar accediendo a la base de datos simultáneamente, realizando lecturas y escrituras en paralelo. Sin una gestión adecuada de los bloqueos, es fácil que se produzcan cuellos de botella, donde una transacción tiene que esperar a que otra libere un recurso.

Con los bloqueos optimizados, Azure SQL Database reduce significativamente la posibilidad de que esto ocurra. Al minimizar el tiempo de bloqueo y ajustar dinámicamente el nivel de bloqueo, nos permite que más transacciones se ejecuten en paralelo sin interferir entre sí. Esto no solo mejora el rendimiento de la base de datos, sino que también reduce el tiempo de respuesta de las aplicaciones que dependen de ella.

Por ejemplo, en una aplicación de comercio electrónico con alta concurrencia de usuarios durante una campaña de ventas, los bloqueos optimizados aseguran que las transacciones de actualización de inventario y procesamiento de pedidos no se bloqueen mutuamente, permitiendo una experiencia de usuario fluida y sin interrupciones.

Inconvenientes de los Bloqueos Optimizados

Aunque los bloqueos optimizados están habilitados por defecto en Azure SQL Database desde Marzo de 2024 y, ahora mismo, no hay manera de deshabilitarlos, es importante que sepamos cómo funciona esta característica para evitar sustos. La clave para ello es entender, tanto la nueva gestión de bloqueos optimizados como el perfil de carga de trabajo de nuestra base de datos. Si bien los bloqueos optimizados son efectivos en la mayoría de los escenarios, ciertos tipos de consultas o transacciones pueden requerir ajustes específicos en la aplicación.

Resultados inesperados 

Acabamos de ver un ejemplo de las bondades de los bloqueos optimizados en combinación con RCSI pero esto tiene más implicaciones. El hecho de que ahora las transacciones de escritura se evalúan contra la versión confirmada almacenada en el snapshot y no se bloqueen nos puede traer resultados inesperados. Por ejemplo suponed que tenemos una tabla con un campo ID de empleado y un campo sueldo. Pongamos que una transacción A quiere actualizar los datos del empleado con ID 1 de 1000 a 1100. Mientras esa transacción no ha terminado, tenemos otra transacción B que quiere actualizar los sueldos mayores que 1001 un 10%. 

En un entorno tradicional de SQL Server la transacción B esperaría al bloqueo de la transacción A y se ejecutaría tras esta, dando un resultado de un sueldo de 1210 para el empleado con ID 1 pues cuando la transacción B se ejecute el update de la transacción A habrá finalizado y el sueldo será de 1100 cumpliendo con la condición de sueldo mayor que 1001. Sin embargo, con los bloqueos optimizados y RCSI la transacción B se evaluaría contra la última versión confirmada (el snapshot de antes de iniciar la transacción A) y, por tanto, el empleado con ID 1 no cumpliría con la condición de la consulta.

Sin bloqueos Optimizados:

NO Bloqueos Optimizados LAQ Issues

Con bloqueos Optimizados:

Bloqueos Optimizados LAQ Issues

¿Podemos hacer algo?

¿Os había dicho que los bloqueos optimizados no se pueden deshabilitar? Vamos a matizarlo. Hemos visto ya que para que funcionen los bloqueos optimizados tenemos que tener habilitado ADR, pues bien esto es como no decir nada pues ADR está habilitado siempre en las bases de datos de Azure sin posibilidad de deshabilitarse. 

Entonces, si no puedo deshabilitar los bloqueos optimizados ni ADR, ¿qué opción tengo? Realmente pocas. Básicamente, nuestra única opción es jugar con los niveles de aislamiento. Por definición esta característica es incompatible con Serializable y con Repeteable Reads por lo que cambiar esta configuración sería nuestra única opción. Y seamos sinceros, esto es una broma de mal gusto, no es viable en una base de datos con alta concurrencia. Aunque, en algunos casos, un nivel de aislamiento más alto puede ser necesario para garantizar la integridad de los datos, esto también incrementa el tiempo de bloqueo, y mucho, haciendo inviable técnicamente esta solución teórica. 

Conclusión

En resumen, los bloqueos optimizados en Azure SQL Database representan un cambio importante en la gestión de concurrencia. Teóricamente para mejorar el rendimiento de nuestras aplicaciones pero, en ocasiones puede ser un problema. En este momento, se hace imprescindible conocer a fondo los conceptos de Transaction ID (TID) y Lock Acquisition Queue (LAQ) para que esta gestión de bloqueos no nos juegue una mala pasada. Podéis pensar que la solución pasa por migrar nuestras bases de datos de Azure a una instancia administrada pero, seamos sinceros ¿Cuanto creeis que tardarán en aplicar este cambio allí también? 

Esto nos genera un debate muy interesante sobre la pérdida de control que hemos sufrido en la nube, especialmente en la infraestructura SAAS. Este caso es especialmente delicado pues un cambio de configuración sin posibilidad de marcha atrás ha cambiado completamente el comportamiento de nuestras aplicaciones pudiendo generar resultados inesperados. Y tú, ¿qué opinas? Te leo en los comentarios.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

TRUNCATE vs DELETE a fondo

Cuando hablamos de bases de datos, uno de los temas que a menudo genera confusión es la diferencia entre las operaciones TRUNCATE y DELETE en SQL Server. Ambas sirven para eliminar datos, pero lo hacen de maneras fundamentalmente distintas, lo que las hace adecuadas para diferentes escenarios. Seguro que todos habéis oído hablar de que truncate es una operación que no se puede revertir, incluso habréis escuchado que no registra la operación en el log de transacciones. Bien pues eso, como suele pasar con todas estas cosas, tiene matices. Digamos que son verdades a medias que pueden servir para un usuario no tan avanzado pero que, si queremos ir más allá, tenemos que comprender a fondo.

Operaciones DDL y DML 

Para entender las diferencias entre TRUNCATE y DELETE, lo primero que debemos comprender es las categorías a las que pertenecen: TRUNCATE es una operación DDL (Data Definition Language), mientras que DELETE es una operación DML (Data Manipulation Language). Las operaciones DDL, como CREATE, ALTER o DROP, se utilizan para definir o modificar la estructura de las bases de datos y sus objetos. Por el contrario, las operaciones DML, como INSERT, UPDATE y DELETE, se utilizan para manipular los datos que residen dentro de esas estructuras.

La clasificación de TRUNCATE como una operación DDL implica que no solo afecta los datos, sino también la estructura de la tabla de una manera fundamental. Al eliminar datos con TRUNCATE, no se eliminan registros individuales, sino que se vacía la tabla por completo, lo que va a tener un impacto distinto en el rendimiento y el uso de recursos del sistema, entre otras cosas.

TRUNCATE en SQL Server

La operación TRUNCATE en SQL Server es rápida y eficiente cuando se necesita eliminar todos los datos de una tabla. La teoría dice que, a diferencia de DELETE, que borra registros fila por fila y puede generar una gran cantidad de entradas en el log de transacciones, TRUNCATE simplemente resetea las páginas de datos, liberando todo el espacio asociado a los registros en un solo paso. Entendamos esto. 

Si recordáis, cuando hablamos de las estructuras físicas de los datos, os conté que SQL Server almacena los registros en páginas de 8 Kbs. El tamaño de la página en sí no es importante aquí pero si tenemos que entender que estas páginas son exclusivas para una tabla, es decir una tabla puede tener sus datos en varias páginas pero cada página solo va a almacenar datos de una tabla.
Bien, pues con esto en mente, ya podemos entender lo que acabamos de decir, cuando ejecutamos un TRUNCATE, lo que hace el motor de base de datos es buscar todas las páginas de datos de esa tabla y, sin importar lo que haya dentro, eliminarlas directamente. También va a actuar sobre una serie de metadatos en tablas de sistema pero eso lo veremos más adelante, no nos compliquemos ahora. Este comportamiento no solo reduce el uso de
log de transacciones, sino que también hace que la operación sea considerablemente más rápida.

Otras consideraciones de TRUNCATE en SQL Server

Otra característica clave de TRUNCATE es que no activa los triggers de la tabla, dado que no se considera una operación sobre registros individuales como ya acabamos de explicar. Sin embargo, hay una excepción importante a esto, aunque TRUNCATE elimina todos los registros, no puede ser utilizado si existen restricciones de integridad referencial, como claves foráneas (Foreign Keys). Para utilizar TRUNCATE en estos casos, primero se deben eliminar o deshabilitar las restricciones referenciales.

DELETE en SQL Server

Por otro lado, la operación DELETE es más versátil, ya que permite eliminar registros de forma selectiva utilizando una cláusula WHERE. Esto la convierte en la mejor opción cuando necesitamos eliminar solo una parte de los datos de una tabla. Además, DELETE es una operación completamente registrada, lo que significa que cada eliminación se registra en el log de transacciones (fila a fila), permitiendo una recuperación granular de los datos si fuese necesario.

Sin embargo, esta granularidad tiene un coste en términos de rendimiento. Al registrar cada eliminación de forma individual, DELETE puede ser significativamente más lento que TRUNCATE cuando se trata de eliminar grandes volúmenes de datos. Además, DELETE activa triggers y respeta las restricciones de integridad referencial, lo que puede añadir complejidad adicional a la operación.

TRUNCATE y DELETE con Campos IDENTITY y Secuencias

Un aspecto crítico al utilizar TRUNCATE y DELETE es cómo cada una de estas operaciones afectan los campos autoincrementales y las secuencias.

Campos IDENTITY

En SQL Server, los campos autoincrementales, conocidos como campos IDENTITY, generan un valor único y creciente para cada nuevo registro. Cuando se utiliza DELETE para eliminar registros, el valor actual de IDENTITY no se ve afectado. Esto significa que, después de una operación de DELETE, el próximo registro insertado continuará con el siguiente valor de IDENTITY, sin importar cuántos registros hayan sido eliminados. Por ejemplo, si el último valor fue 100, el próximo registro será 101, incluso si todos los registros anteriores fueron eliminados.

En cambio, cuando se utiliza TRUNCATE, el comportamiento es diferente. TRUNCATE reinicia el valor de IDENTITY a su valor inicial, generalmente 1. Esto ocurre porque TRUNCATE no solo elimina todos los registros, sino que también resetea el estado interno de la tabla, incluyendo los contadores incrementales (una de esas operaciones de metadatos de las que hablábamos antes). Esta diferencia es crucial en escenarios donde el mantenimiento del orden de IDENTITY es importante.

Secuencias

Las secuencias en SQL Server, a diferencia de los campos IDENTITY, son objetos independientes que generan valores únicos secuenciales que pueden ser utilizados en múltiples tablas. Cuando se utiliza DELETE o TRUNCATE, las secuencias no se ven afectadas directamente, ya que el valor generado por una secuencia no está ligado al contenido de una tabla específica. Por esta razón, si queremos reiniciar una secuencia, esto debe hacerse explícitamente utilizando una instrucción ALTER SEQUENCE. 

Permisos Necesarios para TRUNCATE y DELETE

Otra diferencia fundamental entre TRUNCATE y DELETE es el nivel de permisos requerido para ejecutar cada operación.

Para ejecutar una operación DELETE, un usuario necesita permisos de DELETE en la tabla en cuestión. Estos permisos son relativamente comunes y se pueden otorgar a través de roles estándar como db_datawriter o directamente a nivel de tabla. Dado que DELETE es una operación DML, no requiere permisos adicionales sobre la estructura de la tabla ni afecta los metadatos de la base de datos.

Por otro lado, TRUNCATE es una operación DDL, lo que significa que requiere permisos más elevados. Para ejecutar TRUNCATE, el usuario necesita permisos de ALTER en la tabla, ya que la operación afecta tanto la estructura de la tabla como los datos. Además, si la tabla está involucrada en restricciones de integridad referencial, el usuario también necesitará permisos adicionales para manejar esas relaciones. Tenemos que tener muy en cuenta este requisito de permisos más elevados en entornos donde deseamos limitar el acceso a operaciones que pueden alterar significativamente la estructura de la base de datos.

Rollback en TRUNCATE y DELETE

Llegamos a lo que todos estabais esperando, la capacidad de hacer rollback y deshacer una transacción de borrado. Como hemos visto hasta ahora, DELETE va a registrar cada una de las filas borradas como una operación en el log de transacciones por lo que podemos revertir la operación, teóricamente incluso parcialmente. Pero, ¿y qué pasa con TRUNCATE? ¿Es cierto que no se puede hacer ROLLBACK? Seguramente creas que no se puede, porque eso es lo que te han contado. Pero esa afirmación viene de una inexactitud que quiero aclarar aquí y ahora. Para ello abre un poco tu mente que voy a contarte esos matices de los que hablaba en la introducción. Mira la siguiente captura:

TRUNCATE

¿Qué ha pasado aquí? Esto no era lo que te habían explicado. He creado una tabla e insertado tres registros. Luego en una transacción he hecho un TRUNCATE y la tabla se ha borrado pero, cuando he hecho un ROLLBACK, los datos seguían ahí. Lo primero que tenemos que entender en este punto es como SQL Server gestiona las transacciones, esto es algo que explicamos aquí, por lo que si no lo has leído y el próximo párrafo te suena a chino te recomiendo ir al enlace en este punto y aclarar esos conceptos. 

¿Cuándo no se puede hacer ROLLBACK de un TRUNCATE?

TRUNCATE, aunque no registra fila a fila los borrados, sí que deja rastro en el log, mínimo pero deja rastro. Concretamente registra las páginas que han sido borradas. Incluso las bloquea hasta que la transacción se confirma. Esto quiere decir que si se puede hacer ROLLBACK de un TRUNCATE siempre que la transacción no esté confirmada, es decir, dentro de una transacción implícita o explícita, antes de hacer COMMIT. Gracias a registrar y bloquear las páginas borradas (impedir su borrado o sobrescritura) mientras no haya un COMMIT es posible volver a restaurarlas en caso de ROLLBACK.

Si ahora estás pensando que nada tiene sentido y que te han engañado, tranquilo, no es del todo así. Realmente, en parte, sí que es cierta la afirmación de que no se puede hacer ROLLBACK de un TRUNCATE. Lo que pasa es que solo aplica a deshacer una transacción desde el fichero de log, es decir a restaurar la base de datos a un punto en el tiempo previo a una transacción.

TRUNCATE en Diferentes Sistemas Gestores de Bases de Datos 

Ahora que hemos visto cómo funcionan TRUNCATE y DELETE en SQL Server, es interesante analizar cómo TRUNCATE se comporta en otros sistemas gestores de bases de datos.

Truncate en Oracle

En Oracle, la operación TRUNCATE funciona de manera muy similar a SQL Server. Es una operación DDL que vacía una tabla de forma rápida y eficiente, sin generar una cantidad significativa de entradas en el log de transacciones. Como en SQL Server, TRUNCATE no puede ser utilizado si la tabla tiene claves foráneas activas, lo que exige deshabilitar estas restricciones antes de ejecutar la operación. Sin embargo, Oracle permite la opción de TRUNCATE … CASCADE, que automáticamente trunca las tablas relacionadas que dependan de la tabla principal.

Truncate en MySQL/MariaDB

En MySQL y MariaDB, TRUNCATE también se considera una operación DDL, aunque internamente se ejecuta como un DROP TABLE seguido de un CREATE TABLE para recrear la estructura de la tabla. Este enfoque significa que el rendimiento es similar al de otros sistemas, con la ventaja añadida de que libera de inmediato el espacio de almacenamiento utilizado por la tabla. Por el contrario, este planteamiento también significa que es una operación 100% irreversible, no como lo que acabamos de ver en SQL Server. Además, a diferencia de SQL Server y Oracle, MySQL no permite truncar una tabla si existen tablas que dependen de ella a través de claves foráneas, incluso si esas claves están deshabilitadas.

Truncate en PostgreSQL

En PostgreSQL, TRUNCATE sigue siendo una operación DDL, pero con algunas características adicionales. Además de ser rápido y eficiente, PostgreSQL permite truncar múltiples tablas en una sola operación, lo que puede ser útil en escenarios donde se necesita vaciar varias tablas relacionadas de una sola vez. También incluye la opción CASCADE, que automáticamente trunca todas las tablas relacionadas. Al igual que en otros sistemas, TRUNCATE no activa triggers, lo que lo hace muy útil para operaciones de mantenimiento de bases de datos.

Truncate en Microsoft Fabric

En el caso de Fabric Datawarehouse, un sistema optimizado para grandes volúmenes de datos y cargas de trabajo analíticas, os iba a decir que TRUNCATE no es una operación permitida. Sin embargo, en los últimos días esto ha cambiado y ahora sí que es posible hacerlo. Aunque es una característica realmente nueva de la que aún hay poca información, TRUNCATE en los warehouse de Fabric se comporta de manera similar a otros sistemas, pero con algunas consideraciones adicionales.

Dado que Fabric Datawarehouse está diseñado para gestionar grandes cantidades de datos de manera eficiente, TRUNCATE es especialmente útil para operaciones de limpieza y reinicialización de tablas. Sin embargo, no pierde la esencia de un almacén de datos por lo que, lo que TRUNCATE, es este caso, es una operación sólo de metadatos. Escribe un nuevo registro delta eliminando todos los archivos parquet existentes. De esta manera es mucho más rápido que DELETE, pero preserva la historia de la tabla, a diferencia de CTAS/DROP/RENAME.


Conclusión

Aunque TRUNCATE registra menos información en el log de transacciones que DELETE, registra lo suficiente para permitirnos un rollback completo dentro de una transacción implícita o explícita. Este equilibrio entre un registro mínimo y la capacidad de revertir la operación hace de TRUNCATE una opción muy interesante para eliminar rápidamente grandes volúmenes de datos. Sin embargo, al usarlo debemos extremar las precauciones, ya que la reversión es todo o nada, y siempre debemos tener en cuenta que los permisos necesarios son más elevados.

En resumen, TRUNCATE ofrece una opción rápida y efectiva para la limpieza de tablas, siempre que comprendamos sus implicaciones y limitaciones en el contexto de transacciones y logs. Si la prioridad es el rendimiento y se necesita vaciar una tabla por completo sin preocuparse por las restricciones de integridad referencial, TRUNCATE es la opción más adecuada. En cambio, si se requiere eliminar registros selectivos o si existen dependencias de claves foráneas que no pueden ser deshabilitadas, DELETE será la operación preferida.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

No te vayas aun. Hemos creado una página donde estamos recopilando todos estos artículos que dan respuesta a estas preguntas frecuentes de SQL Server. Pásate por aquí a echar un vistazo.

Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios