Teoría BBDD

DBCC LOG

Hoy os quiero hablar de uno de esos “secretos a voces” que tiene SQL Server. En SQL Server, existen herramientas y comandos que, aunque nadie te va a decir oficialmente que están disponibles, son bien conocidos por los DBAs y pueden ser extremadamente útiles. Uno de estos comandos es DBCC LOG, una funcionalidad que nos permite acceder al contenido del log de transacciones de SQL Server. A lo largo de este artículo, veremos cómo funciona DBCC LOG, sus aplicaciones prácticas y algunas consideraciones que debemos tener en cuenta para utilizarlo eficazmente.

Introducción a DBCC LOG

En SQL Server el log de transacciones es una de las piezas fundamentales del sistema. Este log almacena una secuencia de todas las modificaciones realizadas en la base de datos, lo que nos permite, además, la recuperación de datos en caso de fallos y la replicación en entornos distribuidos. A través del comando DBCC LOG, podemos acceder directamente a este registro, algo que puede ser especialmente valioso en escenarios de depuración o análisis forense de la base de datos.

Sin embargo, a diferencia de otros comandos de la familia DBCC (Database Console Commands), DBCC LOG no está documentado oficialmente por Microsoft, lo que significa que su uso conlleva ciertos riesgos y limitaciones. No obstante, para aquellos de nosotros que manejamos SQL Server en profundidad, esta herramienta puede ofrecer una visión muy valiosa de lo que ocurre “bajo el capó” de nuestra base de datos.

¿Cómo funciona DBCC LOG?

El comando DBCC LOG nos permite visualizar el contenido del log de transacciones de una base de datos específica. Así, al ejecutar este comando, obtendremos una salida que incluye cada una de las entradas de este registro, desde operaciones de inserción, eliminación y actualización hasta transacciones de nivel más bajo como asignaciones de páginas o cambios en la estructura de las tablas.

La sintaxis básica para ejecutar DBCC LOG es la siguiente:

Como veis, el comando necesita de los parametros que yo he llamado NombreBaseDeDatos que es el nombre de la base de datos cuyo log queremos inspeccionar, y, del parametro TipoDeSalida que tiene que ser un número entre 0 y 4 que determina el nivel de detalle de la información que recibimos. Este segundo parámetro es crucial, ya que permite ajustar la cantidad y el tipo de datos que se devuelven, desde un resumen básico hasta una vista muy detallada de las operaciones.

Es importante entender que la salida generada por DBCC LOG puede ser extensa y, en muchos casos, poco intuitiva. No es un comando que se utilice habitualmente para tareas diarias, sino más bien en situaciones específicas donde necesitamos conocer el estado exacto de las transacciones en un momento dado.

¿Qué información nos devuelve?

La salida de DBCC LOG varía en función del parametro de tipo de salida que elijamos. Así, tendremos distintos niveles de detalle de más a menos entre 0 y 3 y todo el detalle con el parámetro 4 (igual que el 3) pero en este caso recogido en un volcado hexadecimal.


DBCC LOG(‘basededatos’,0) 

  • Current LSN
  • Operation
  • Context
  • TransactionID
  • LogBlockGeneration

DBCC LOG(‘basededatos’,1) 

  • Current LSN
  • Operation
  • Context
  • TransactionID
  • LogBlockGeneration
  • TagBits
  • Log Record Fixed Length
  • Log Record Length
  • Previous LSN
  • Flag Bits
  • Log Reserve
  • Description

DBCC LOG(‘basededatos’,2) 

  • Current LSN
  • Operation
  • Context
  • Transaction ID
  • LogBlockGeneration
  • Tag Bits
  • Log Record 
  • Fixed Length
  • Log Record Length
  • Previous LSN
  • Flag Bits
  • Log Reserve
  • AllocUnitId
  • AllocUnitName
  • Page ID
  • Slot ID
  • Previous Page LSN
  • Number of Locks
  • Lock Information
  • Description

DBCC LOG(‘basededatos’,3) 

  • Current LSN
  • Operation
  • Context
  • Transaction ID
  • LogBlockGeneration
  • Tag Bits
  • Log Record Fixed Length
  • Log Record Length
  • Previous LSN
  • Flag Bits
  • Log Reserve
  • AllocUnitId
  • AllocUnitName
  • Page ID
  • Slot ID
  • Previous Page LSN
  • PartitionId
  • RowFlags
  • Num Elements
  • Offset in Row
  • Modify Size
  • Checkpoint Begin
  • CHKPT Begin DB Version
  • Max XDESID
  • Num Transactions
  • Checkpoint End
  • CHKPT End DB Version
  • Minimum LSN Dirty Pages
  • Oldest Replicated Begin LSN
  • Next Replicated End LSN
  • Last Distributed Backup End LSN
  • Last Distributed End LSN
  • Repl Min Hold LSN
  • Server UID
  • SPID
  • Beginlog Status
  • Xact Type
  • Begin Time
  • Transaction Name
  • Transaction SID
  • Parent Transaction ID
  • Oldest Active Transaction ID
  • Xact ID
  • Xact Node ID
  • Xact Node Local ID
  • End AGE
  • End Time
  • Transaction Begin
  • Replicated Records
  • Oldest Active LSN
  • Server Name
  • Database Name
  • Mark Name
  • Master XDESID
  • Master DBID
  • Preplog Begin LSN
  • Prepare Time Virtual Clock
  • Previous Savepoint
  • Savepoint Name
  • Rowbits First Bit
  • Rowbits Bit Count
  • Rowbits Bit Value
  • Number of Locks
  • Lock Information
  • LSN before writes
  • Pages Written Command Type
  • Publication ID
  • Article ID
  • Partial Status
  • Command
  • Byte Offset
  • New Value
  • Old Value
  • New Split Page
  • Rows Deleted Bytes Freed
  • CI Table Id
  • CI Index Id
  • NewAllocUnitId
  • FileGroup ID
  • Meta Status
  • File Status
  • File ID
  • Physical Name
  • Logical Name Format LSN
  • RowsetId
  • TextPtr Column Offset Flags
  • Text Size
  • Offset Old Size
  • New Size
  • Description
  • Bulk allocated extent count
  • Bulk RowsetId Bulk AllocUnitId
  • Bulk allocation first IAM Page ID
  • Bulk allocated extent ids
  • VLFs added
  • InvalidateCache Id
  • InvalidateCache keys
  • CopyVerionInfo Source Page Id
  • CopyVerionInfo Source Page LSN
  • CopyVerionInfo Source Slot Id
  • CopyVerionInfo Source Slot Count
  • RowLog Contents 0
  • RowLog Contents 1
  • RowLog Contents 2
  • RowLog Contents 3
  • RowLog Contents 4
  • RowLog Contents 5
  • Compression Log Type
  • Compression Info
  • PageFormat PageType
  • PageFormat PageFlags
  • PageFormat PageLevel
  • PageFormat PageStat
  • PageFormat FormatOption

DBCC LOG(‘basededatos’,4) 

  • Current LSN
  • Operation
  • Context
  • Transaction ID
  • LogBlockGeneration
  • Tag Bits
  • Log Record Fixed Length
  • Log Record Length
  • Previous LSN Flag Bits
  • Log Reserve
  • Description
  • Log Record

Aplicaciones Prácticas de DBCC LOG

Una de las aplicaciones más directas de DBCC LOG es la identificación de transacciones específicas que han tenido lugar en la base de datos. Por ejemplo, en un escenario donde necesitamos auditar cambios realizados por un usuario o aplicación, podemos utilizar este comando para rastrear esas modificaciones en el log de transacciones.

Supongamos que necesitamos investigar un problema de corrupción de datos o pérdida de información. Al acceder al log de transacciones con DBCC LOG, podemos reconstruir los pasos previos al incidente y entender qué ocurrió exactamente. Este nivel de análisis es particularmente útil en entornos donde la estabilidad y consistencia de la base de datos son críticas.

Otra aplicación interesante es la optimización del rendimiento. Aunque DBCC LOG no se usa directamente para este fin, entender el log de transacciones puede ayudarnos a identificar patrones de uso que afecten al rendimiento. Por ejemplo, podríamos descubrir que ciertas transacciones están generando un número excesivo de registros, lo que a su vez podría estar ralentizando las operaciones de escritura en la base de datos.

Limitaciones y Consideraciones

Aunque DBCC LOG es una herramienta poderosa, su uso no está exento de limitaciones. La primera de ellas es la falta de documentación oficial, lo que significa que estamos trabajando en un terreno relativamente inexplorado. Es crucial tener cuidado al interpretar los resultados y no hacer suposiciones precipitadas basadas en la salida del comando.

Además, debido a la cantidad de información que puede devolver, es recomendable utilizar DBCC LOG en entornos controlados y con un propósito claro. No es un comando para ejecutarse indiscriminadamente en un entorno de producción sin un motivo justificado, ya que podría generar una gran carga en el sistema y dificultar la interpretación de los datos.

Otro aspecto a considerar es la compatibilidad. A lo largo de las diferentes versiones de SQL Server, la estructura interna del log de transacciones puede cambiar, lo que significa que los resultados de DBCC LOG pueden variar entre versiones. Esto puede complicar la utilización del comando en sistemas donde se utilizan múltiples versiones de SQL Server o donde se planea una migración.

Por último, el uso de procedimientos indocumentados, aunque no supone en sí mismo la pérdida del soporte por parte de Microsoft, este si puede no hacerse cargo si ve que el problema está relacionado con alguno de estos procedimientos.

 Dificultad de interpretación

Además de todo lo anteriormente mencionado, cabe destacar la dificultad para interpretar la salida de estos comandos, no solo por la complejidad de su contenido sino, además por la cantidad de registros generados. Fijaos en la siguiente imagen en la que, creo una base de datos nueva, en esa base de datos simplemente creo una tabla, sin ningún registro, no hago nada más y, sin embargo, la salida de DBCC LOG es de 461 filas

Conclusión

El comando DBCC LOG en SQL Server es una herramienta avanzada que, si bien no está documentada oficialmente, puede proporcionar información muy valiosa sobre el estado y las operaciones de una base de datos. Desde la auditoría de transacciones hasta la resolución de problemas complejos, este comando nos permite acceder a detalles intrincados del funcionamiento interno de SQL Server.

Es importante recordar que, debido a su naturaleza no documentada, debemos usar DBCC LOG con precaución y siempre con un propósito claro. En manos de un experto, puede ser la llave para desentrañar problemas difíciles o mejorar la comprensión de cómo se comporta una base de datos bajo determinadas condiciones.

En resumen, aunque DBCC LOG no es una herramienta para el uso cotidiano, su potencial en situaciones específicas lo convierte en un recurso valioso para quienes manejamos SQL Server a un nivel profundo. Si bien su interpretación puede ser compleja, el conocimiento que podemos extraer de este comando es difícilmente igualable, especialmente en contextos donde cada detalle cuenta.
 

Publicado por Roberto Carrancio en SQL Server, 0 comentarios

Operadores Spool en planes de ejecución

Una de las primeras cosas que hacemos, o por lo menos que deberíamos hacer, cuando estamos analizando el rendimiento de una consulta es mirar su plan de ejecución. En los planes de ejecución vemos paso a paso y gráficamente lo que hace nuestra consulta. Cada uno de estos pasos de los que hablamos está representado gráficamente por un operador y la mayoría son intuitivos y fáciles de comprender pero hay un tipo en concreto que parece que cuesta un poco más. Me refiero como no podía ser de otra manera a los operadores Spool. Estos componentes pueden marcar la diferencia en términos de eficiencia y tiempo de respuesta de las consultas. En este artículo, profundizaremos en los diferentes tipos de Spool, su propósito, cómo funcionan y cuándo deberíamos prestarles atención.

¿Qué es un operador Spool?

Antes de entrar en detalles, es importante entender qué es un operador Spool. Básicamente, son operadores que almacenan temporalmente un conjunto de filas durante la ejecución de una consulta. Este almacenamiento permite que SQL Server reutilice estos datos en lugar de volverlos a calcular o volver a leerlos desde el disco, lo que puede resultar en una mejora significativa del rendimiento en determinadas situaciones. Existen varios tipos de operadores spool en SQL Server y, aunque todos comparten la definición que hemos mencionado, cada uno tiene sus particularidades. 

Table Spool

El «Table Spool» es el tipo de Spool más común en SQL Server. Su objetivo principal es almacenar el resultado de una subconsulta o una parte del plan de ejecución que es probable que se reutilice. Este tipo de operador suele aparecer cuando tenemos consultas que requieren repetir una operación costosa varias veces. Por ejemplo, si una subconsulta se ejecuta en múltiples ocasiones dentro de una misma consulta, SQL Server puede decidir almacenar temporalmente el resultado de esa subconsulta en un Table Spool para evitar esas múltiples ejecuciones.

Un detalle importante a considerar es que, aunque el Table Spool puede reducir el tiempo de ejecución en general, también consume memoria temporal para almacenar los datos, lo que podría impactar en la eficiencia si el tamaño del Spool es considerablemente grande.

Index Spool

El «Index Spool» se utiliza cuando SQL Server anticipa que necesitará un índice temporal para mejorar la búsqueda de datos en una consulta específica. Este operador crea un índice en memoria, que puede ser utilizado para acelerar operaciones como JOINs o búsquedas basadas en condiciones de filtrado. Aunque esta operación añade un paso adicional al plan de ejecución, la creación de un índice temporal puede resultar en un rendimiento significativamente mejorado, especialmente en consultas que trabajan con grandes volúmenes de datos.

La clave para entender el impacto de un Index Spool está en el balance entre el coste de crearlo y los beneficios que aporta en la fase de búsqueda. En escenarios donde se ejecutan varias búsquedas en un conjunto de datos sin un índice adecuado, este operador se convierte en una solución efectiva.

Row Count Spool

El «Row Count Spool» es un tipo de operador que se emplea principalmente para controlar el número de filas que se procesan en una operación. A diferencia de los Spool anteriores, este no almacena datos per se, sino que mantiene un conteo de las filas que pasan a través de él. Este operador suele aparecer en situaciones donde se requiere un número preciso de filas como resultado de una subconsulta, como cuando usamos la cláusula TOP o una condición de filtrado que limita las filas a procesar.

En resumen, este operador actúa como un portero de discoteca que asegura que solo pasen el número exacto de filas necesarias. Es especialmente útil en operaciones que pueden generar un gran número de filas intermedias, pero donde solo se necesita un subconjunto de ellas. Así, el Row Count Spool ayuda a evitar el procesamiento innecesario, optimizando el rendimiento de la consulta.

Window Spool

El «Window Spool» es menos común pero no menos importante. Este tipo de operador se emplea principalmente en consultas que utilizan funciones de ventana, como ROW_NUMBER(), RANK() o LEAD(). El propósito del Window Spool es soportar el cálculo de estas funciones, almacenando temporalmente el conjunto de datos sobre el cual se aplicarán las funciones de ventana.

Las funciones de ventana requieren acceso a un conjunto completo de datos para calcular correctamente sus resultados. El operador Window Spool permite que SQL Server mantenga un «almacén» de estas filas mientras las operaciones de ventana se ejecutan, garantizando así que el resultado sea el esperado. Aunque puede añadir cierta sobrecarga en términos de memoria, su beneficio en la correcta ejecución de funciones analíticas es crucial.

Optimización y uso

Entender cuándo y cómo aparecen los Spool en los planes de ejecución es vital para optimizar el rendimiento de nuestras consultas. Si bien estos operadores pueden mejorar la eficiencia en muchos casos, su uso inadecuado o innecesario puede tener el efecto contrario. Es fundamental analizar los planes de ejecución y evaluar si la presencia de un Spool está realmente justificada en base al coste adicional que implica su utilización.

En algunos casos, podríamos encontrar que la eliminación de un Spool innecesario, ya sea mediante la reescritura de la consulta o ajustando los índices, resulta en un rendimiento superior. También es importante recordar que estos operadores suelen consumir memoria temporal, por lo que su impacto en la carga general del sistema debe ser monitorizado de cerca.

Recursión

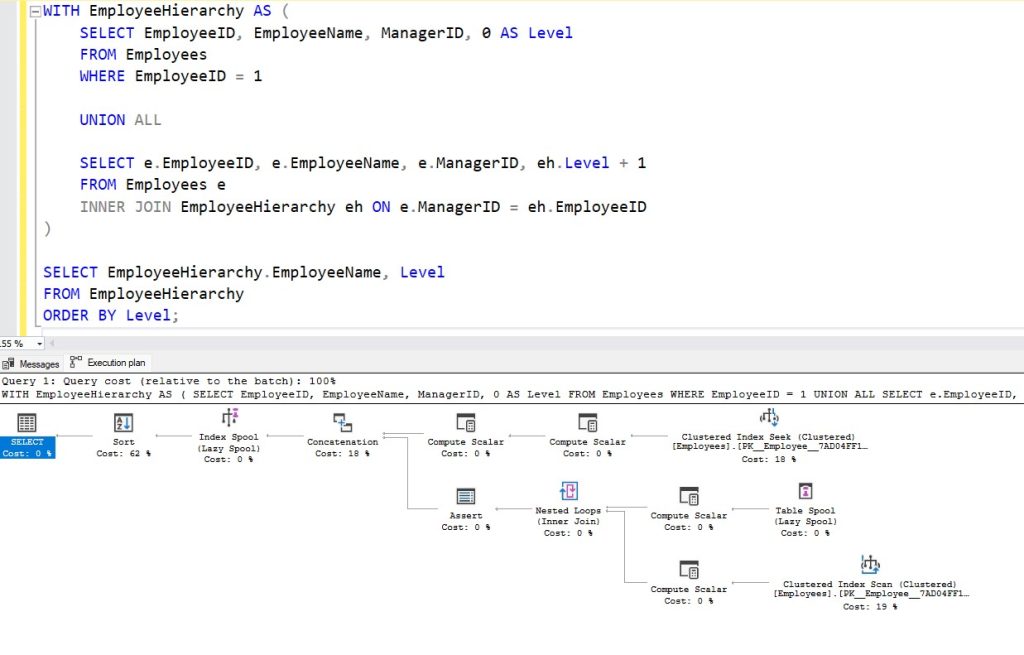
Las consultas recursivas son un ejemplo de la necesidad de operadores Spool. En una consulta recursiva típica, SQL Server tiende a utilizar dos tipos de Spool que resultan esenciales para su correcto funcionamiento y optimización: el Table Spool y el Index Spool.

Spool en recursividad

Table Spool en recursividad

Al principio de una consulta recursiva, SQL Server suele emplear un Table Spool. Este operador, como hemos visto, se utiliza para almacenar el conjunto inicial de filas que formarán la base de la recursión, conocido como la parte ancla en un CTE recursivo. La función principal de este operador es capturar estas filas iniciales para que puedan ser reutilizadas a lo largo de las iteraciones recursivas sin necesidad de recalcular o volver a leer los datos desde el origen.

Este Table Spool es especialmente útil en este contexto porque permite que el proceso recursivo se inicie de manera eficiente, asegurando que las filas base estén disponibles para las iteraciones subsiguientes sin añadir un coste significativo de I/O o de CPU. Este operador se convierte en un «almacén temporal» que facilita la generación de los resultados recursivos de manera escalable.

Index Spool en recursividad

En la fase final de la recursión, cuando se procesan y ordenan los resultados, SQL Server suele introducir un Index Spool. Este operador crea un índice temporal en memoria sobre el conjunto de datos generado durante la recursión. La finalidad de este índice es acelerar la búsqueda y ordenación de los datos, especialmente en consultas que requieren un orden específico o que deben cumplir con condiciones adicionales de filtrado.

El Index Spool optimiza la fase de finalización de la consulta recursiva, permitiendo que SQL Server gestione grandes volúmenes de datos generados por la recursión de manera más eficiente. La creación de este índice temporal puede ser costosa en términos de memoria y CPU, pero su impacto positivo en el rendimiento de la consulta suele justificar su utilización, especialmente en estructuras de datos jerárquicas complejas.

Conclusión

Los operadores Spool en SQL Server son herramientas poderosas que, cuando se utilizan correctamente, pueden mejorar significativamente el rendimiento de nuestras consultas. Desde el Table Spool, que almacena datos para evitar cálculos repetidos, hasta el Window Spool, que soporta funciones analíticas, cada tipo de Spool tiene un propósito específico y un impacto en la forma en que SQL Server procesa las consultas.

Para sacar el máximo provecho de los Spool, es esencial comprender cómo y cuándo aparecen en los planes de ejecución y evaluar su eficacia en cada caso. Aunque estos operadores pueden añadir complejidad al plan de ejecución, su correcta utilización puede ser la clave para lograr un rendimiento óptimo en SQL Server.

En definitiva, los Spool no son solo un detalle técnico, sino una pieza fundamental en la optimización avanzada de consultas. Con el conocimiento adecuado, podemos utilizarlos para transformar consultas lentas en operaciones altamente eficientes, maximizando el rendimiento de nuestras bases de datos.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario

Transacciones Distribuidas y DTC

Cuando hablamos de sistemas de bases de datos, uno de los retos más grandes es garantizar la consistencia de los datos en entornos distribuidos. No suele ser lo común pero, a medida que las arquitecturas de aplicaciones se vuelven más complejas, surge la necesidad de coordinar múltiples transacciones que puedan involucrar diferentes bases de datos o incluso diferentes servidores. Aquí es donde entra en juego el concepto de transacciones distribuidas, y en SQL Server, el Distributed Transaction Coordinator (DTC) juega un papel crucial.

¿Qué son las Transacciones Distribuidas?

Una transacción distribuida es aquella que abarca más de un recurso de red, como bases de datos o sistemas de archivos ubicados en diferentes servidores. A diferencia de una transacción local que afecta a una sola base de datos, las transacciones distribuidas tienen la capacidad de coordinar cambios en varias bases de datos, asegurando que todos los participantes de la transacción lleguen a un estado de compromiso o vuelvan a un estado previo en caso de fallo.

El desafío en las transacciones distribuidas es garantizar que todos los nodos involucrados lleguen a un consenso sobre el resultado de la transacción. Esto es fundamental para mantener la integridad de los datos y evitar inconsistencias que podrían llevar a resultados inesperados o, en el peor de los casos, a la corrupción de los datos.

Distributed Transaction Coordinator (DTC)

En SQL Server, el Distributed Transaction Coordinator (DTC) es el componente encargado de gestionar las transacciones distribuidas. Su función principal es asegurar que todas las partes de una transacción distribuida, que pueden involucrar múltiples bases de datos y servidores, se comprometan correctamente o se deshagan en caso de error.

DTC utiliza el protocolo de dos fases (2PC, por sus siglas en inglés) para coordinar las transacciones. Este protocolo se divide en dos fases: la fase de preparación y la fase de compromiso. En la primera fase, DTC pregunta a todos los participantes si están listos para comprometer la transacción. Si todos responden afirmativamente, se procede a la segunda fase, donde se envía la orden de compromiso. Si alguno de los participantes no puede comprometerse, se inicia el proceso de deshacer la transacción en todos los participantes, asegurando que el sistema vuelva a un estado coherente.

Configuración y uso de Transacciones Distribuidas en SQL Server

Para aprovechar las transacciones distribuidas en SQL Server, primero necesitamos asegurarnos de que DTC esté configurado y funcionando correctamente en todos los servidores involucrados. Esto implica la configuración tanto a nivel de sistema operativo como en SQL Server.

Configurar DTC a nivel sistema operativo y red

En cuanto a la configuración del sistema operativo, es crucial que DTC esté habilitado y configurado para permitir transacciones remotas, ya que, por defecto, estas suelen estar desactivadas por razones de seguridad. Para habilitar DTC, desde el panel de control tendremos que acceder a “Agregar o Quitar Componentes de Windows” y activar la opción “Habilitar el acceso DTC de red”. Una vez hecho esto, y reiniciado el servidor si se nos requiere, el equipo estará listo para admitir transacciones distribuidas.

Sin embargo, esto no es todo, es importante asegurarse de que las reglas del firewall permitan la comunicación entre los servicios DTC de los diferentes servidores. DTC usa llamadas al procedimiento remoto RPC por lo que los puertos necesarios son, en primer lugar el puerto 135 TCP y UDP para establecer la comunicación y después un puerto TCP dinámico del rango 49152-65535. Este rango se puede configurar cambiando configuraciones del registro de windows si lo deseamos pero lo importante es que, nuestro firewall admita conexiones tanto por el puerto 135 como por todos los del rango dinámico seleccionado.

Usar DTC en SQL Server

Una vez que DTC esté operativo, podremos comenzar a utilizar transacciones distribuidas en SQL Server. Esto se hace a través de la instrucción BEGIN DISTRIBUTED TRANSACTION, que inicia una transacción distribuida que abarca múltiples servidores. Es importante tener en cuenta que, aunque la sintaxis es similar a la de una transacción local, el alcance y la complejidad son considerablemente mayores.

Un ejemplo sencillo podría involucrar dos servidores SQL Server diferentes. Comenzamos la transacción distribuida en el primer servidor y realizamos las operaciones necesarias. Luego, nos conectamos al segundo servidor y realizamos más operaciones dentro de la misma transacción. Finalmente, decidimos si se comprometen los cambios (commit) o si se deshacen (rollback).

Consideraciones en el Uso de Transacciones Distribuidas

Aunque el uso de transacciones distribuidas y DTC ofrece grandes ventajas en términos de consistencia y fiabilidad, también presenta una serie de retos que debemos considerar.

En primer lugar, las transacciones distribuidas suelen ser más lentas que las locales debido a la sobrecarga de la coordinación entre múltiples nodos. Esto puede afectar el rendimiento de las aplicaciones, especialmente en sistemas con alta concurrencia.

Además, la complejidad de la configuración y la gestión de DTC puede ser un obstáculo en muchas organizaciones donde, también será común involucrar a varias personas de varios departamentos para el cambio. Es vital asegurarse de que todos los servidores involucrados estén correctamente configurados y que la comunicación entre ellos sea fluida. Cualquier problema en la configuración de DTC puede resultar en errores difíciles de diagnosticar, que pueden ser muy costosos de resolver en producción.

Otro aspecto a tener en cuenta es la fiabilidad del sistema. Aunque DTC está diseñado para manejar fallos, es esencial contar con mecanismos adicionales de recuperación y monitorización para minimizar el impacto de posibles fallos de red o de los servidores.

Por último, es fundamental considerar la seguridad en la configuración de DTC. Dado que las transacciones distribuidas pueden involucrar la transferencia de datos sensibles entre servidores, es necesario implementar medidas de seguridad robustas para proteger esta información. Esto incluye el uso de comunicaciones seguras, así como la correcta configuración de permisos y autenticaciones.

Buenas prácticas para la gestión de Transacciones Distribuidas

Para gestionar eficazmente las transacciones distribuidas en SQL Server, es importante seguir una serie de buenas prácticas que nos permitirán minimizar riesgos y maximizar el rendimiento.

En primer lugar, debemos evitar utilizar transacciones distribuidas a menos que sean absolutamente necesarias. Si es posible, debemos buscar alternativas, como la replicación o el uso de servicios distribuidos que manejen la consistencia eventual. Las transacciones distribuidas deben reservarse para casos en los que la consistencia estricta sea un requisito ineludible. Si, el primer consejo es no lo hagas, es lo que hay.

Cuando sea necesario utilizar transacciones distribuidas, es fundamental optimizar el diseño de las mismas para reducir al mínimo el tiempo que la transacción está abierta. Esto incluye realizar todas las operaciones preparatorias fuera de la transacción y asegurarse de que el código dentro de la transacción sea lo más eficiente posible.

Además, es recomendable implementar una monitorización continua del rendimiento y de los posibles errores de DTC. Existen herramientas en SQL Server que nos permiten rastrear y analizar el rendimiento de las transacciones distribuidas, así como diagnosticar problemas en tiempo real. Por ejemplo, SQL Server Profiler, xEvents o DMVs.

Conclusión

Las transacciones distribuidas y el uso de DTC en SQL Server son herramientas poderosas que permiten garantizar la consistencia de los datos en entornos complejos y distribuidos. Sin embargo, su uso requiere una planificación cuidadosa y una gestión rigurosa para evitar problemas de rendimiento y fiabilidad.

Es importante recordar que no todas las aplicaciones necesitan transacciones distribuidas. En muchos casos, existen soluciones alternativas que pueden ofrecer la consistencia y fiabilidad necesarias sin la complejidad adicional. Cuando se opte por utilizar transacciones distribuidas, debemos asegurarnos de seguir las buenas prácticas y mantener una supervisión constante para garantizar el éxito a largo plazo.

Si abordamos las transacciones distribuidas con una comprensión clara de sus beneficios y limitaciones, y si estamos dispuestos a invertir en su correcta implementación, podemos lograr una gestión eficiente y segura de nuestros sistemas distribuidos en SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!


Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Bloqueos Optimizados

Hoy vamos a hablar de una de las características nuevas que implementan las bases de datos de Azure para maximizar el rendimiento sin comprometer la integridad de los datos. Cuando diseñamos y gestionamos nuestras bases de datos, debemos considerar cómo se gestionan los bloqueos, especialmente en entornos con alta concurrencia. La gestión de bloqueos es crucial para garantizar que múltiples transacciones puedan ejecutarse en paralelo sin conflictos. En este artículo, exploraremos en profundidad los bloqueos optimizados en las Azure Databases, cómo funcionan y cómo pueden ser aprovechados para mejorar el rendimiento de nuestras aplicaciones.

¿Qué son los bloqueos optimizados en Azure SQL Database?

Los bloqueos optimizados son una característica avanzada de Azure SQL Database diseñada para reducir la contención (bloqueos) y, por tanto, mejorar el rendimiento de las transacciones en entornos con alta concurrencia. En esencia, esta característica permite al motor de bases de datos minimizar el tiempo durante el cual las transacciones mantienen bloqueos, reduciendo así la posibilidad de que otras transacciones tengan que esperar para acceder a los mismos recursos. En entornos con alta concurrencia, como los que a menudo manejamos en la nube, esta optimización puede marcar la diferencia entre una aplicación fluida y una plagada de cuellos de botella.

El principio básico detrás de los bloqueos optimizados es el uso eficiente de los recursos del sistema. Las bases de datos tradicionales suelen imponer bloqueos a nivel de fila, página o tabla, lo que puede llevar a que las transacciones se bloqueen entre sí si intentan acceder a los mismos datos. Con los bloqueos optimizados, Azure SQL Database ajusta dinámicamente el nivel de bloqueo, permitiendo que las transacciones adquieran solo los bloqueos necesarios y los liberen lo antes posible. De este modo, se mejora la eficiencia general del sistema.

¿Dónde puedo usar los bloqueos optimizados?

A día de hoy, los bloqueos optimizados son una característica exclusiva de las Azure SQL Databases, no vamos a encontrar esta funcionalidad ni en versiones de SQL Server ni en Azure Managed Instance. Si estamos trabajando con Azure SQL Databases (sea cual sea nuestro nivel de servicio) debemos saber que los bloqueos optimizados están habilitados por defecto y, por tanto, podremos esperar el comportamiento que veremos a continuación siempre y cuando no los deshabilitemos. También es importante mencionar que esta funcionalidad depende de la recuperación acelerada de base de datos (ADR) por lo que si en algún momento deshabilitamos ADR en nuestra base de datos perderemos la funcionalidad de los bloqueos optimizados.

Funcionamiento de los bloqueos optimizados

Para entender cómo los bloqueos optimizados logran mejorar el rendimiento, es imprescindible entender cómo funciona esta gestión a bajo nivel. Cuando una transacción se ejecuta en Azure SQL Database, el motor de la base de datos evalúa el impacto potencial de los bloqueos necesarios. Dependiendo de factores como la naturaleza de la consulta, el nivel de aislamiento de la transacción y la carga actual del sistema, el motor decide si aplicar un bloqueo exclusivo, compartido o, en algunos casos, ninguno en absoluto. De esto ya hemos hablado en nuestro artículo sobre los bloqueos y deadlocks.

Uno de los aspectos clave de esta optimización es la técnica conocida como «lock escalation» o escalado de bloqueos. En lugar de aplicar bloqueos a nivel de fila o página, que pueden ser demasiado restrictivos, el motor de Azure SQL Database puede optar por escalar el bloqueo a un nivel superior (como a nivel de tabla) o utilizar técnicas de versionado de filas (row versioning). Esto permite que múltiples transacciones accedan simultáneamente a diferentes partes de los datos sin interferir entre sí.

Además, los bloqueos optimizados se integran con otras características avanzadas de Azure SQL Database, como las transacciones de larga duración y el procesamiento de consultas en paralelo. El motor de la base de datos tiene la capacidad de ajustar dinámicamente la estrategia de bloqueo según la duración y complejidad de las transacciones, lo que minimiza el impacto en el rendimiento.

TID y LAQ: Las claves para entender esto

Si queremos profundizar en los bloqueos optimizados hay dos conceptos fundamentales que debemos dominar: el Transaction ID (TID) y el Lock Acquisition Queue (LAQ). Estos términos juegan un papel crucial en la forma en que el motor de base de datos gestiona y optimiza los bloqueos, especialmente en entornos con alta concurrencia.

Transaction ID (TID)

El Transaction ID (identificador de transacción) , conocido como TID, es un identificador único asignado por el motor de la base de datos a cada transacción que se inicia en Azure SQL Database. Este identificador es esencial para la gestión de bloqueos, ya que permite al sistema rastrear de manera precisa qué transacción está accediendo a qué recursos en un momento dado. Además, el TID facilita la implementación de estrategias de bloqueo como la escalada de bloqueos y el versionado de filas.

Cuando una transacción se ejecuta en Azure SQL Database, el TID se convierte en la referencia central para todas las operaciones que esa transacción realiza. Cada vez que la transacción intenta leer o modificar un registro, el motor de la base de datos utiliza el TID para determinar si es necesario adquirir un nuevo bloqueo, mantener un bloqueo existente o escalarlo. Esta capacidad de rastreo granular es lo que permite a Azure SQL Database aplicar bloqueos de manera eficiente y minimizar la contención entre transacciones.

El TID también juega un papel fundamental en la resolución de conflictos entre transacciones concurrentes. Si dos transacciones intentan acceder al mismo recurso al mismo tiempo, el motor de la base de datos utilizará los TIDs asociados para decidir cuál transacción obtendrá acceso al recurso y cuál tendrá que esperar o, en casos extremos, finalizará esa transacción y deberá ser reintentada. Este proceso es esencial para mantener la integridad de los datos y evitar condiciones de carrera, donde el resultado de una transacción podría depender del orden en que se completan otras transacciones.

TID en acción

Vamos a ver cómo aplica esto en la práctica con un ejemplo muy sencillo. Para ello partiremos de la siguiente consulta que, como veis, crea una tabla, inserta unos valores y en una transacción actualiza esos registros. Antes de cerrar la transacción consultamos los bloqueos e intentos de bloqueos generados para después cerrar la transacción y borrar la tabla.

Si ejecutamos esto en SQL Server o en una base de datos de una instancia administrada de Azure (Azure Managed Instance) veremos que se generan cuatro registros, tres bloqueos exclusivos a nivel de clave y un intento de bloqueo exclusivo a nivel de página. Os dejo un ejemplo:

No Bloqueos Optimizados TIP

Sin embargo, la misma consulta sobre una base de datos de Azure con bloqueos optimizados solo genera un bloqueo exclusivo a nivel de transacción:

Bloqueos Optimizados TIP

Lock Acquisition Queue (LAQ)

El Lock Acquisition Queue (bloqueo después de la calificación), o LAQ, es otro concepto clave en la gestión de bloqueos optimizados. La LAQ es esencialmente una cola en la que las transacciones esperan para adquirir un bloqueo sobre un recurso determinado. Cuando trabajamos en un entorno de base de datos concurrido, donde múltiples transacciones pueden intentar acceder al mismo recurso simultáneamente, la LAQ nos ayuda a gestionar y organizar estas solicitudes de bloqueo para minimizar el tiempo de espera y evitar conflictos.

Cuando una transacción intenta adquirir un bloqueo sobre un recurso que ya está bloqueado por otra transacción, se coloca en la LAQ correspondiente a ese recurso. A medida que los recursos se van liberando, las transacciones en la LAQ se procesan en orden, lo que garantiza que las transacciones que han estado esperando más tiempo tengan prioridad para acceder al recurso. Este enfoque ayuda a reducir la contención y asegura que las transacciones no se bloqueen indefinidamente, lo que nos podría causar tiempos de espera excesivos y degradación del rendimiento.

La LAQ no solo gestiona el orden en que las transacciones adquieren bloqueos, sino que también juega un papel crucial en la optimización de los bloqueos mismos. En lugar de simplemente otorgar un bloqueo cuando un recurso se libera, el motor de Azure SQL Database utiliza la información en la LAQ para decidir si es necesario escalar el bloqueo a un nivel superior, como a nivel de tabla, o si se puede mantener a un nivel más granular, como a nivel de fila. Esta flexibilidad es clave para maximizar la concurrencia y minimizar la sobrecarga de bloqueo.

LAQ en acción

Si recordáis cuando hablamos de los bloqueos, comentamos que las consultas se evalúan fila a fila para comprobar si se pueden realizar o creando primero un bloqueo compartido de actualización (U). En caso de no haber conflicto ese bloqueo escala a un bloqueo (X) antes de realizar la actualización. Este paradigma cambia cuando tenemos bloqueos optimizados y un nivel de aislamiento Read Committed Snapshot o RCSI (por defecto en las bases de datos de Azure) evaluando ahora las consultas contra la versión confirmada más reciente y en caso de no haber conflicto la transacción adquiere un bloqueo (X) y se completa.

¿Te ha sonado a chino todo esto? No te preocupes que te lo enseño con un ejemplo. Mira esta captura sobre una base de datos de Azure.

Bloqueos Optimizados LAQ 1

En el ejemplo anterior, he creado una tabla en la sesión de la izquierda, introducido tres registros y posteriormente he actualizado el primero dentro de una transacción que no he llegado a confirmar ni revertir la transacción. Mientras tanto, en la sesión de la derecha he actualizado otro de los registros de la tabla sin problema. Esto en SQL Server o en Azure Managed instance generaría un bloqueo y la transacción de la derecha no llegaría a completarse pues, aunque son registros diferentes, la tabla no tiene ningún índice y eso hace que el bloqueo (X) no se realice a nivel de fila. ¿No te lo crees? Te lo demuestro.

No Bloqueos Optimizados LAQ

Beneficios de los Bloqueos Optimizados en entornos de alta concurrencia

Los entornos de alta concurrencia, como en los que solemos trabajar cuando tenemos aplicaciones empresariales críticas, son los que más se benefician de los bloqueos optimizados. En estos escenarios, múltiples usuarios o aplicaciones pueden estar accediendo a la base de datos simultáneamente, realizando lecturas y escrituras en paralelo. Sin una gestión adecuada de los bloqueos, es fácil que se produzcan cuellos de botella, donde una transacción tiene que esperar a que otra libere un recurso.

Con los bloqueos optimizados, Azure SQL Database reduce significativamente la posibilidad de que esto ocurra. Al minimizar el tiempo de bloqueo y ajustar dinámicamente el nivel de bloqueo, nos permite que más transacciones se ejecuten en paralelo sin interferir entre sí. Esto no solo mejora el rendimiento de la base de datos, sino que también reduce el tiempo de respuesta de las aplicaciones que dependen de ella.

Por ejemplo, en una aplicación de comercio electrónico con alta concurrencia de usuarios durante una campaña de ventas, los bloqueos optimizados aseguran que las transacciones de actualización de inventario y procesamiento de pedidos no se bloqueen mutuamente, permitiendo una experiencia de usuario fluida y sin interrupciones.

Inconvenientes de los Bloqueos Optimizados

Aunque los bloqueos optimizados están habilitados por defecto en Azure SQL Database desde Marzo de 2024 y, ahora mismo, no hay manera de deshabilitarlos, es importante que sepamos cómo funciona esta característica para evitar sustos. La clave para ello es entender, tanto la nueva gestión de bloqueos optimizados como el perfil de carga de trabajo de nuestra base de datos. Si bien los bloqueos optimizados son efectivos en la mayoría de los escenarios, ciertos tipos de consultas o transacciones pueden requerir ajustes específicos en la aplicación.

Resultados inesperados 

Acabamos de ver un ejemplo de las bondades de los bloqueos optimizados en combinación con RCSI pero esto tiene más implicaciones. El hecho de que ahora las transacciones de escritura se evalúan contra la versión confirmada almacenada en el snapshot y no se bloqueen nos puede traer resultados inesperados. Por ejemplo suponed que tenemos una tabla con un campo ID de empleado y un campo sueldo. Pongamos que una transacción A quiere actualizar los datos del empleado con ID 1 de 1000 a 1100. Mientras esa transacción no ha terminado, tenemos otra transacción B que quiere actualizar los sueldos mayores que 1001 un 10%. 

En un entorno tradicional de SQL Server la transacción B esperaría al bloqueo de la transacción A y se ejecutaría tras esta, dando un resultado de un sueldo de 1210 para el empleado con ID 1 pues cuando la transacción B se ejecute el update de la transacción A habrá finalizado y el sueldo será de 1100 cumpliendo con la condición de sueldo mayor que 1001. Sin embargo, con los bloqueos optimizados y RCSI la transacción B se evaluaría contra la última versión confirmada (el snapshot de antes de iniciar la transacción A) y, por tanto, el empleado con ID 1 no cumpliría con la condición de la consulta.

Sin bloqueos Optimizados:

NO Bloqueos Optimizados LAQ Issues

Con bloqueos Optimizados:

Bloqueos Optimizados LAQ Issues

¿Podemos hacer algo?

¿Os había dicho que los bloqueos optimizados no se pueden deshabilitar? Vamos a matizarlo. Hemos visto ya que para que funcionen los bloqueos optimizados tenemos que tener habilitado ADR, pues bien esto es como no decir nada pues ADR está habilitado siempre en las bases de datos de Azure sin posibilidad de deshabilitarse. 

Entonces, si no puedo deshabilitar los bloqueos optimizados ni ADR, ¿qué opción tengo? Realmente pocas. Básicamente, nuestra única opción es jugar con los niveles de aislamiento. Por definición esta característica es incompatible con Serializable y con Repeteable Reads por lo que cambiar esta configuración sería nuestra única opción. Y seamos sinceros, esto es una broma de mal gusto, no es viable en una base de datos con alta concurrencia. Aunque, en algunos casos, un nivel de aislamiento más alto puede ser necesario para garantizar la integridad de los datos, esto también incrementa el tiempo de bloqueo, y mucho, haciendo inviable técnicamente esta solución teórica. 

Conclusión

En resumen, los bloqueos optimizados en Azure SQL Database representan un cambio importante en la gestión de concurrencia. Teóricamente para mejorar el rendimiento de nuestras aplicaciones pero, en ocasiones puede ser un problema. En este momento, se hace imprescindible conocer a fondo los conceptos de Transaction ID (TID) y Lock Acquisition Queue (LAQ) para que esta gestión de bloqueos no nos juegue una mala pasada. Podéis pensar que la solución pasa por migrar nuestras bases de datos de Azure a una instancia administrada pero, seamos sinceros ¿Cuanto creeis que tardarán en aplicar este cambio allí también? 

Esto nos genera un debate muy interesante sobre la pérdida de control que hemos sufrido en la nube, especialmente en la infraestructura SAAS. Este caso es especialmente delicado pues un cambio de configuración sin posibilidad de marcha atrás ha cambiado completamente el comportamiento de nuestras aplicaciones pudiendo generar resultados inesperados. Y tú, ¿qué opinas? Te leo en los comentarios.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

TRUNCATE vs DELETE a fondo

Cuando hablamos de bases de datos, uno de los temas que a menudo genera confusión es la diferencia entre las operaciones TRUNCATE y DELETE en SQL Server. Ambas sirven para eliminar datos, pero lo hacen de maneras fundamentalmente distintas, lo que las hace adecuadas para diferentes escenarios. Seguro que todos habéis oído hablar de que truncate es una operación que no se puede revertir, incluso habréis escuchado que no registra la operación en el log de transacciones. Bien pues eso, como suele pasar con todas estas cosas, tiene matices. Digamos que son verdades a medias que pueden servir para un usuario no tan avanzado pero que, si queremos ir más allá, tenemos que comprender a fondo.

Operaciones DDL y DML 

Para entender las diferencias entre TRUNCATE y DELETE, lo primero que debemos comprender es las categorías a las que pertenecen: TRUNCATE es una operación DDL (Data Definition Language), mientras que DELETE es una operación DML (Data Manipulation Language). Las operaciones DDL, como CREATE, ALTER o DROP, se utilizan para definir o modificar la estructura de las bases de datos y sus objetos. Por el contrario, las operaciones DML, como INSERT, UPDATE y DELETE, se utilizan para manipular los datos que residen dentro de esas estructuras.

La clasificación de TRUNCATE como una operación DDL implica que no solo afecta los datos, sino también la estructura de la tabla de una manera fundamental. Al eliminar datos con TRUNCATE, no se eliminan registros individuales, sino que se vacía la tabla por completo, lo que va a tener un impacto distinto en el rendimiento y el uso de recursos del sistema, entre otras cosas.

TRUNCATE en SQL Server

La operación TRUNCATE en SQL Server es rápida y eficiente cuando se necesita eliminar todos los datos de una tabla. La teoría dice que, a diferencia de DELETE, que borra registros fila por fila y puede generar una gran cantidad de entradas en el log de transacciones, TRUNCATE simplemente resetea las páginas de datos, liberando todo el espacio asociado a los registros en un solo paso. Entendamos esto. 

Si recordáis, cuando hablamos de las estructuras físicas de los datos, os conté que SQL Server almacena los registros en páginas de 8 Kbs. El tamaño de la página en sí no es importante aquí pero si tenemos que entender que estas páginas son exclusivas para una tabla, es decir una tabla puede tener sus datos en varias páginas pero cada página solo va a almacenar datos de una tabla.
Bien, pues con esto en mente, ya podemos entender lo que acabamos de decir, cuando ejecutamos un TRUNCATE, lo que hace el motor de base de datos es buscar todas las páginas de datos de esa tabla y, sin importar lo que haya dentro, eliminarlas directamente. También va a actuar sobre una serie de metadatos en tablas de sistema pero eso lo veremos más adelante, no nos compliquemos ahora. Este comportamiento no solo reduce el uso de
log de transacciones, sino que también hace que la operación sea considerablemente más rápida.

Otras consideraciones de TRUNCATE en SQL Server

Otra característica clave de TRUNCATE es que no activa los triggers de la tabla, dado que no se considera una operación sobre registros individuales como ya acabamos de explicar. Sin embargo, hay una excepción importante a esto, aunque TRUNCATE elimina todos los registros, no puede ser utilizado si existen restricciones de integridad referencial, como claves foráneas (Foreign Keys). Para utilizar TRUNCATE en estos casos, primero se deben eliminar o deshabilitar las restricciones referenciales.

DELETE en SQL Server

Por otro lado, la operación DELETE es más versátil, ya que permite eliminar registros de forma selectiva utilizando una cláusula WHERE. Esto la convierte en la mejor opción cuando necesitamos eliminar solo una parte de los datos de una tabla. Además, DELETE es una operación completamente registrada, lo que significa que cada eliminación se registra en el log de transacciones (fila a fila), permitiendo una recuperación granular de los datos si fuese necesario.

Sin embargo, esta granularidad tiene un coste en términos de rendimiento. Al registrar cada eliminación de forma individual, DELETE puede ser significativamente más lento que TRUNCATE cuando se trata de eliminar grandes volúmenes de datos. Además, DELETE activa triggers y respeta las restricciones de integridad referencial, lo que puede añadir complejidad adicional a la operación.

TRUNCATE y DELETE con Campos IDENTITY y Secuencias

Un aspecto crítico al utilizar TRUNCATE y DELETE es cómo cada una de estas operaciones afectan los campos autoincrementales y las secuencias.

Campos IDENTITY

En SQL Server, los campos autoincrementales, conocidos como campos IDENTITY, generan un valor único y creciente para cada nuevo registro. Cuando se utiliza DELETE para eliminar registros, el valor actual de IDENTITY no se ve afectado. Esto significa que, después de una operación de DELETE, el próximo registro insertado continuará con el siguiente valor de IDENTITY, sin importar cuántos registros hayan sido eliminados. Por ejemplo, si el último valor fue 100, el próximo registro será 101, incluso si todos los registros anteriores fueron eliminados.

En cambio, cuando se utiliza TRUNCATE, el comportamiento es diferente. TRUNCATE reinicia el valor de IDENTITY a su valor inicial, generalmente 1. Esto ocurre porque TRUNCATE no solo elimina todos los registros, sino que también resetea el estado interno de la tabla, incluyendo los contadores incrementales (una de esas operaciones de metadatos de las que hablábamos antes). Esta diferencia es crucial en escenarios donde el mantenimiento del orden de IDENTITY es importante.

Secuencias

Las secuencias en SQL Server, a diferencia de los campos IDENTITY, son objetos independientes que generan valores únicos secuenciales que pueden ser utilizados en múltiples tablas. Cuando se utiliza DELETE o TRUNCATE, las secuencias no se ven afectadas directamente, ya que el valor generado por una secuencia no está ligado al contenido de una tabla específica. Por esta razón, si queremos reiniciar una secuencia, esto debe hacerse explícitamente utilizando una instrucción ALTER SEQUENCE. 

Permisos Necesarios para TRUNCATE y DELETE

Otra diferencia fundamental entre TRUNCATE y DELETE es el nivel de permisos requerido para ejecutar cada operación.

Para ejecutar una operación DELETE, un usuario necesita permisos de DELETE en la tabla en cuestión. Estos permisos son relativamente comunes y se pueden otorgar a través de roles estándar como db_datawriter o directamente a nivel de tabla. Dado que DELETE es una operación DML, no requiere permisos adicionales sobre la estructura de la tabla ni afecta los metadatos de la base de datos.

Por otro lado, TRUNCATE es una operación DDL, lo que significa que requiere permisos más elevados. Para ejecutar TRUNCATE, el usuario necesita permisos de ALTER en la tabla, ya que la operación afecta tanto la estructura de la tabla como los datos. Además, si la tabla está involucrada en restricciones de integridad referencial, el usuario también necesitará permisos adicionales para manejar esas relaciones. Tenemos que tener muy en cuenta este requisito de permisos más elevados en entornos donde deseamos limitar el acceso a operaciones que pueden alterar significativamente la estructura de la base de datos.

Rollback en TRUNCATE y DELETE

Llegamos a lo que todos estabais esperando, la capacidad de hacer rollback y deshacer una transacción de borrado. Como hemos visto hasta ahora, DELETE va a registrar cada una de las filas borradas como una operación en el log de transacciones por lo que podemos revertir la operación, teóricamente incluso parcialmente. Pero, ¿y qué pasa con TRUNCATE? ¿Es cierto que no se puede hacer ROLLBACK? Seguramente creas que no se puede, porque eso es lo que te han contado. Pero esa afirmación viene de una inexactitud que quiero aclarar aquí y ahora. Para ello abre un poco tu mente que voy a contarte esos matices de los que hablaba en la introducción. Mira la siguiente captura:

TRUNCATE

¿Qué ha pasado aquí? Esto no era lo que te habían explicado. He creado una tabla e insertado tres registros. Luego en una transacción he hecho un TRUNCATE y la tabla se ha borrado pero, cuando he hecho un ROLLBACK, los datos seguían ahí. Lo primero que tenemos que entender en este punto es como SQL Server gestiona las transacciones, esto es algo que explicamos aquí, por lo que si no lo has leído y el próximo párrafo te suena a chino te recomiendo ir al enlace en este punto y aclarar esos conceptos. 

¿Cuándo no se puede hacer ROLLBACK de un TRUNCATE?

TRUNCATE, aunque no registra fila a fila los borrados, sí que deja rastro en el log, mínimo pero deja rastro. Concretamente registra las páginas que han sido borradas. Incluso las bloquea hasta que la transacción se confirma. Esto quiere decir que si se puede hacer ROLLBACK de un TRUNCATE siempre que la transacción no esté confirmada, es decir, dentro de una transacción implícita o explícita, antes de hacer COMMIT. Gracias a registrar y bloquear las páginas borradas (impedir su borrado o sobrescritura) mientras no haya un COMMIT es posible volver a restaurarlas en caso de ROLLBACK.

Si ahora estás pensando que nada tiene sentido y que te han engañado, tranquilo, no es del todo así. Realmente, en parte, sí que es cierta la afirmación de que no se puede hacer ROLLBACK de un TRUNCATE. Lo que pasa es que solo aplica a deshacer una transacción desde el fichero de log, es decir a restaurar la base de datos a un punto en el tiempo previo a una transacción.

TRUNCATE en Diferentes Sistemas Gestores de Bases de Datos 

Ahora que hemos visto cómo funcionan TRUNCATE y DELETE en SQL Server, es interesante analizar cómo TRUNCATE se comporta en otros sistemas gestores de bases de datos.

Truncate en Oracle

En Oracle, la operación TRUNCATE funciona de manera muy similar a SQL Server. Es una operación DDL que vacía una tabla de forma rápida y eficiente, sin generar una cantidad significativa de entradas en el log de transacciones. Como en SQL Server, TRUNCATE no puede ser utilizado si la tabla tiene claves foráneas activas, lo que exige deshabilitar estas restricciones antes de ejecutar la operación. Sin embargo, Oracle permite la opción de TRUNCATE … CASCADE, que automáticamente trunca las tablas relacionadas que dependan de la tabla principal.

Truncate en MySQL/MariaDB

En MySQL y MariaDB, TRUNCATE también se considera una operación DDL, aunque internamente se ejecuta como un DROP TABLE seguido de un CREATE TABLE para recrear la estructura de la tabla. Este enfoque significa que el rendimiento es similar al de otros sistemas, con la ventaja añadida de que libera de inmediato el espacio de almacenamiento utilizado por la tabla. Por el contrario, este planteamiento también significa que es una operación 100% irreversible, no como lo que acabamos de ver en SQL Server. Además, a diferencia de SQL Server y Oracle, MySQL no permite truncar una tabla si existen tablas que dependen de ella a través de claves foráneas, incluso si esas claves están deshabilitadas.

Truncate en PostgreSQL

En PostgreSQL, TRUNCATE sigue siendo una operación DDL, pero con algunas características adicionales. Además de ser rápido y eficiente, PostgreSQL permite truncar múltiples tablas en una sola operación, lo que puede ser útil en escenarios donde se necesita vaciar varias tablas relacionadas de una sola vez. También incluye la opción CASCADE, que automáticamente trunca todas las tablas relacionadas. Al igual que en otros sistemas, TRUNCATE no activa triggers, lo que lo hace muy útil para operaciones de mantenimiento de bases de datos.

Truncate en Microsoft Fabric

En el caso de Fabric Datawarehouse, un sistema optimizado para grandes volúmenes de datos y cargas de trabajo analíticas, os iba a decir que TRUNCATE no es una operación permitida. Sin embargo, en los últimos días esto ha cambiado y ahora sí que es posible hacerlo. Aunque es una característica realmente nueva de la que aún hay poca información, TRUNCATE en los warehouse de Fabric se comporta de manera similar a otros sistemas, pero con algunas consideraciones adicionales.

Dado que Fabric Datawarehouse está diseñado para gestionar grandes cantidades de datos de manera eficiente, TRUNCATE es especialmente útil para operaciones de limpieza y reinicialización de tablas. Sin embargo, no pierde la esencia de un almacén de datos por lo que, lo que TRUNCATE, es este caso, es una operación sólo de metadatos. Escribe un nuevo registro delta eliminando todos los archivos parquet existentes. De esta manera es mucho más rápido que DELETE, pero preserva la historia de la tabla, a diferencia de CTAS/DROP/RENAME.


Conclusión

Aunque TRUNCATE registra menos información en el log de transacciones que DELETE, registra lo suficiente para permitirnos un rollback completo dentro de una transacción implícita o explícita. Este equilibrio entre un registro mínimo y la capacidad de revertir la operación hace de TRUNCATE una opción muy interesante para eliminar rápidamente grandes volúmenes de datos. Sin embargo, al usarlo debemos extremar las precauciones, ya que la reversión es todo o nada, y siempre debemos tener en cuenta que los permisos necesarios son más elevados.

En resumen, TRUNCATE ofrece una opción rápida y efectiva para la limpieza de tablas, siempre que comprendamos sus implicaciones y limitaciones en el contexto de transacciones y logs. Si la prioridad es el rendimiento y se necesita vaciar una tabla por completo sin preocuparse por las restricciones de integridad referencial, TRUNCATE es la opción más adecuada. En cambio, si se requiere eliminar registros selectivos o si existen dependencias de claves foráneas que no pueden ser deshabilitadas, DELETE será la operación preferida.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

No te vayas aun. Hemos creado una página donde estamos recopilando todos estos artículos que dan respuesta a estas preguntas frecuentes de SQL Server. Pásate por aquí a echar un vistazo.

Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Kerberos SPN para SQL Server

En el pasado artículo os hablé de la autenticación en SQL Server y profundizamos en los protocolos NTLM y Kerberos que se usan para la autenticación con usuarios de Directorio Activo. Cuando hablamos de Kerberos, os comenté que pese a ser un sistema más rápido y seguro que NTLM necesita de más configuraciones. En concreto comentamos los Service Principal Names (SPN) que es en lo que vamos a profundizar hoy. Un SPN mal configurado puede desencadenar una serie de problemas, desde forzar el uso de NTLM hasta errores de autenticación. Por ello, comprender en detalle cómo funciona Kerberos en combinación con SQL Server, y más específicamente, cómo configurar adecuadamente los SPN, es fundamental para cualquier DBA. 

¿Qué es un SPN y por qué es importante en SQL Server?

Los Service Principal Names, son identificadores únicos que permiten a los ordenadores localizar un servicio específico dentro de una red. Si llevamos esto a SQL Server, el SPN actúa como un enlace entre una instancia de SQL Server y su identidad en la red, permitiendo a los clientes autenticarse correctamente mediante Kerberos. En escenarios de autenticación Kerberos, el SPN se registra en el Active Directory y se asocia a la cuenta de servicio que ejecuta SQL Server. Esta configuración asegura que Kerberos pueda autenticar correctamente a los usuarios que intentan conectarse a la base de datos. De lo contrario, los usuarios podrían enfrentar errores de autenticación que, en el mejor de los casos, causan inconvenientes, y en el peor, generan brechas de seguridad. Si el SPN no está configurado correctamente, el proceso de autenticación podría revertir al protocolo NTLM, que es menos seguro y menos eficiente que Kerberos.

Configuración de SPN

Configurar correctamente los Service Principal Names es esencial para garantizar la autenticación Kerberos en SQL Server. En primer lugar, es necesario identificar bajo qué cuenta se ejecuta el servicio SQL Server, ya que el SPN debe registrarse en el Active Directory bajo esa cuenta específica. 

Un detalle muy importante que no podemos pasar por alto es que un SPN debe ser único en todo el dominio. Si dos servicios diferentes compartieran el mismo SPN, tendríamos fallos en la autenticación que además, por experiencia propia os lo digo, son muy difíciles de diagnosticar y solucionar. Para evitar estos conflictos, se recomienda utilizar el comando setspn -L para listar los SPN actuales y verificar la ausencia de duplicados antes de crear un nuevo SPN.

Configurar SPN para SQL Server

Cuando vamos a registrar un servidor SQL Server es crucial que el SPN se registre tanto para el nombre del servidor como para su FQDN (Fully Qualified Domain Name). Esto asegura que, independientemente de cómo se conecten los clientes al servidor (mediante el nombre corto o el FQDN), la autenticación Kerberos se realice sin problemas. La sintaxis básica para registrar un SPN para SQL Server es la siguiente y nos servirá tanto para la instancia por defecto del servidor:

Podríamos usar el parámetro -A para crear los Service Principal Names pero yo personalmente prefiero usar -S en el comando setspn ya que verifica automáticamente si el SPN ya existe, previniendo registros duplicados.

Creación de SPN en Instancias Nombradas de SQL Server

Cuando trabajamos con instancias con nombre de SQL Server, la creación de SPN requiere un enfoque ligeramente diferente al de las instancias predeterminadas. Las instancias nombradas utilizan un puerto dinámico por defecto, lo que puede complicar la configuración del SPN. Para facilitar la gestión y evitar problemas de autenticación, deberemos asignar un puerto fijo a la instancia nombrada. Una vez hecho esto, para la configuración del SPN seguiremos un procedimiento similar al de una instancia predeterminada pero, registrando también los Service Principal Names con el nombre de la instancia.

Supongamos que tenemos una instancia con nombre de SQL Server llamada «SQLInstancia» que se ejecuta en el servidor «servidorSQL» con el puerto fijo 1436. El SPN se configuraría de la siguiente manera:

Realmente podríamos dejar el puerto dinámico por defecto y registrar el SPN solo por el nombre pero, no soy partidario de ello. Este método que os acabo de enseñar nos asegura que la autenticación Kerberos funciona correctamente independientemente de si la conexión se realiza por nombre de la instancia o por el puerto.

Eliminación de SPN

Eliminar un SPN incorrecto o redundante es una operación delicada, pero a veces necesaria para resolver conflictos o corregir configuraciones. Si detectamos que un SPN fue registrado incorrectamente, o si estamos migrando un servicio y necesitamos limpiar los registros antiguos, podemos utilizar el comando setspn -D para borrar los registros de SPN.

Por ejemplo, si necesitamos eliminar un SPN registrado para una instancia predeterminada en el servidor «servidorSQL», el comando sería:

O bien, para eliminar un SPN de una instancia con nombre:

Es importante tener precaución al usar el comando setspn -D, ya que eliminar un SPN incorrectamente puede llevar a problemas de autenticación, especialmente en entornos de producción. Antes de realizar la eliminación, es recomendable listar todos los Service Principal Names registrados con setspn -L cuentaServicio para confirmar que estamos eliminando el SPN correcto.

Además, cuando eliminemos un SPN debemos gestionarlo cuidadosamente, asegurándonos de que el servicio no se quede sin SPN registrado, lo que podría causar fallos en la autenticación de los usuarios y, por tanto, afectar a la disponibilidad del servicio.

SPN para Otros Servicios de SQL Server

Además de las instancias del motor de base de datos de SQL Server, otros servicios de SQL Server, como SQL Server Reporting Services (SSRS), SQL Server Analysis Services (SSAS) y SQL Server Integration Services (SSIS), también requieren la configuración de SPN para soportar la autenticación Kerberos. Aunque su uso está disminuyendo en favor de Power BI y otras herramientas nuevas en la nube como Fabric aún es común encontrarse con instalaciones locales de estos servicios que tendremos que administrar. Cada uno de estos servicios tiene sus propios requisitos y consideraciones para la correcta configuración de SPN. Vamos a ver cómo configurar los Service Principal Names para cada uno de estos servicios.

SQL Server Reporting Services (SSRS) y Power BI Report Server (PBIRS)

SQL Server Reporting Services (SSRS) es un servicio que se utiliza para generar, administrar y entregar informes a través de una interfaz web. De la misma manera y sobre esa base existe un servicio local de Power BI Server para publicar informes llamado Power BI Report Server (PBIRS). Para asegurar que las conexiones a SSRS y PBIRS se autentiquen correctamente mediante Kerberos, debemos registrar un SPN para el servicio HTTP que utilizan.

Supongamos que un SSRS o PBIRS está configurado en un servidor llamado «servidorSQL» con el nombre de instancia «Reportes» y está accesible a través de HTTP. Los Service Principal Names se configuran de la siguiente manera:

IMPORTANTE: Además del registro de Kerberos en SSRS deberemos habilitar esta conexión en el fichero de configuración «RsReportServer.config». Para ello nos aseguraremos de añadir (o que esté añadida) la palabra clave «<RSWindowsNegotiate>» como primera entrada en el apartado «<AuthenticationTypes>«.

Consideraciones Adicionales para HTTPS

Si SSRS o PBIRS están configurados para utilizar HTTPS, la configuración del SPN no cambia en cuanto a la necesidad de registrar los Service Principal Names para el servicio HTTP. Sin embargo, es crucial que el certificado SSL esté correctamente configurado y que el nombre del certificado coincida con el nombre de host utilizado para acceder al servidor. Esto asegura que la autenticación Kerberos funcione sin problemas en un entorno seguro.

Configuración para Entornos con Nombres de Alias o CNAME

En algunos escenarios, es posible que PBIRS esté configurado para acceder a través de un nombre de alias o un CNAME, lo cual es común en configuraciones de alta disponibilidad o cuando se utiliza un balanceador de carga. En estos casos, también debemos registrar un SPN para el alias o CNAME, de manera que las autenticaciones se gestionen correctamente:

Esto asegura que cualquier solicitud de autenticación Kerberos que se realice a través del alias sea manejada adecuadamente, previniendo errores de autenticación que podrían derivar en problemas de acceso a los informes.

SQL Server Analysis Services (SSAS)

SQL Server Analysis Services (SSAS) es un servicio que proporciona herramientas de bases de datos tabulares y de cubos para análisis y minería de datos. Para SSAS, el SPN debe registrarse para el servicio «MSOLAPSvc.3». Si, por ejemplo, tenemos una instancia de SSAS llamada «Analisis» en el servidor «servidorSQL», los Service Principal Names se configurarán de la siguiente manera: 

Si SSAS utiliza un puerto predeterminado o fijo, ese puerto debe incluirse en el SPN. Es importante verificar el puerto en uso antes de registrar el SPN para evitar errores en la configuración.

SQL Server Integration Services (SSIS)

SQL Server Integration Services (SSIS) no requiere típicamente la configuración de un SPN, ya que SSIS es más comúnmente utilizado en el contexto de ejecución local de paquetes. Sin embargo, si SSIS está configurado para ejecutar paquetes en un servidor remoto y queremos o necesitamos usar la autenticación Kerberos, necesitaremos registrar un SPN para el servicio de agente de SQL Server.

El SPN para SQL Server Agent, que es responsable de ejecutar trabajos que pueden incluir paquetes SSIS, se configuraría de la siguiente manera para una instancia predeterminada en «servidorSQL»:

SQL Server Browser Service

SQL Server Browser Service es el servicio responsable de enrutar las solicitudes de conexión a la instancia correcta de SQL Server en servidores que ejecutan múltiples instancias. Aunque no es común, si necesitamos configurar Kerberos para este servicio, el SPN se registraría así:

Este SPN permitiría que el SQL Server Browser Service maneje correctamente las conexiones basadas en Kerberos, asegurando la autenticación en entornos con múltiples instancias o nombres de alias.

Mantenimiento de SPN

El mantenimiento continuo de los Service Principal Names es tan importante como su configuración inicial. Debemos estar atentos a cualquier cambio en la infraestructura, como la migración de SQL Server a un nuevo servidor, el cambio de cuentas de servicio o la actualización del nombre del dominio, ya que estos eventos pueden requerir una actualización de los SPN correspondientes.

Es recomendable establecer procedimientos regulares de monitorización para asegurar que los SPN siguen registrados correctamente. Si detectamos un problema de autenticación que sugiere un fallo en Kerberos, el primer paso que debemos realizar es verificar el estado de los Service Principal Names.

Herramientas como klist o el ya mencionado comando setspn pueden ser útiles para diagnosticar problemas de tickets Kerberos. Del mismo modo, el visor de eventos de Windows puede proporcionarnos detalles adicionales sobre fallos de autenticación que nos ayudarán a diagnosticar los problemas.

En caso de encontrarnos con un SPN duplicado o incorrecto, la solución pasa por eliminar el registro incorrecto utilizando el comando setspn -D, como ya hemos visto, y, acto seguido, registrar de nuevo el o los SPN correctos. Esta intervención debe realizarse con cuidado, ya que eliminar un SPN sin registrar el nuevo puede resultar en una pérdida de conectividad con el servicio SQL Server.

SPN y Always On

En entornos de alta disponibilidad, como los clusters de failover de SQL Server o las configuraciones Always On, la gestión de los Service Principal Names se vuelve aún más compleja. En estos escenarios, los SPN deben configurarse no sólo para la instancia de SQL Server, sino también para el nombre del recurso del clúster o el listener de Always On.

Por ejemplo, en un entorno Always On, los SPN deben registrarse tanto para cada réplica como para el listener. Esto garantiza que, en caso de failover, los clientes puedan seguir conectándose al servicio SQL Server utilizando Kerberos, sin experimentar interrupciones. El manejo incorrecto de los Service Principal Names en estos entornos puede provocar fallos en la autenticación y en la conmutación por error, por lo que es esencial prestar mucha atención en estos casos.

Conclusión

Los SPN de Kerberos son un componente crítico en la infraestructura de autenticación de SQL Server. Su correcta configuración y mantenimiento nos aseguran que los entornos de base de datos funcionan de manera segura y eficiente. A medida que la complejidad de nuestras infraestructuras crezca, es fundamental que prestemos atención a los detalles de configuración de SPN, especialmente en entornos de alta disponibilidad.

Un SPN mal configurado no solo puede comprometer la seguridad, sino que también puede afectar negativamente el rendimiento y la disponibilidad de nuestros servicios. Por lo tanto, debemos abordar la gestión de SPN con el mismo rigor y precisión que aplicamos a otros aspectos de la administración de bases de datos. Al hacerlo, garantizaremos que SQL Server siga siendo un pilar confiable en nuestras infraestructuras críticas.

 Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

No te vayas aun. Hemos creado una página donde estamos recopilando todos estos artículos que dan respuesta a estas preguntas frecuentes de SQL Server. Pásate por aquí a echar un vistazo.

Publicado por Roberto Carrancio en SQL Server, 0 comentarios

Autenticación en SQL Server

Hace unos días hablábamos sobre la diferencia entre los inicios de sesión y los usuarios en SQL Server y Azure SQL y pudimos ver cómo teníamos a nuestro alcance varios métodos de autenticación para iniciar sesión. Como vimos los logins podían ser usuarios nativos de SQL Server o heredados del dominio de Windows o de Azure (lo que se conoce como Entra ID y antes como Azure Active Directory). Esta autenticación es un aspecto crítico para los sistemas de datos, la seguridad de nuestros datos depende en gran medida de cómo controlamos el acceso a ellos. 

En este artículo, vamos a explorar en profundidad los distintos modos de autenticación disponibles en SQL Server y Azure SQL. Por un lado, tendremos los métodos tradicionales como la autenticación de SQL Server y Windows, y por otro lado, la integración con Azure Entra ID (anteriormente conocido como Azure Active Directory). También quiero entrar en los protocolos subyacentes, Kerberos y NTLM, sobre los que se basan estos métodos de autenticación.

Modos de Autenticación en SQL Server y Azure SQL

SQL Server y Azure SQL ofrecen varias opciones para autenticar usuarios. Cada una de estas opciones está diseñada para escenarios específicos, y la elección de un método sobre otro puede tener implicaciones significativas en la seguridad y la facilidad de administración.

Autenticación de SQL Server

La autenticación de SQL Server es probablemente el método más tradicional. Se basa en un sistema interno de gestión de inicios de sesión y contraseñas dentro de SQL Server. Este método no depende del sistema operativo ni de ningún servicio externo para validar las credenciales, lo que significa que los usuarios y las contraseñas se gestionan directamente en el propio motor de bases de datos. Este tipo de autenticación es ideal en escenarios donde necesitamos un control granular sobre el acceso de usuarios que no están en nuestro dominio de Windows o cuando estamos trabajando en entornos mixtos.

Autenticación de Windows

La autenticación de Windows permite a los usuarios autenticarse usando sus credenciales de dominio de Windows. Este método es mi preferido en entornos donde se utiliza Active Directory para gestionar usuarios y grupos. La principal ventaja de la autenticación de Windows es que podemos integrar sin problemas SQL Server en un entorno de seguridad ya establecido. Además nos permite hacer uso de los grupos de Directorio Activo, lo que nos puede simplificar enormemente la tarea y aumentar la seguridad. Por último, otra ventaja es que no solo simplifica la gestión de credenciales, sino que también permite aprovechar protocolos de seguridad avanzados como Kerberos, lo que añade una capa adicional de protección como veremos más adelante.

Autenticación con Azure Entra ID

Con la aparición de servicios en la nube, la autenticación a través de Azure Entra ID se ha convertido en una opción cada vez más importante, especialmente para entornos de Azure SQL. Este método permite a los usuarios autenticarse mediante sus credenciales de Azure Entra ID, lo que facilita una integración más fluida con otros servicios de Azure. Además, permite implementar las características de seguridad avanzadas de Azure como la autenticación Multifactor (MFA) y las políticas de acceso condicional, que no son posibles con los métodos tradicionales de autenticación.

Protocolos de Autenticación: Kerberos y NTLM

Al hablar de autenticación en entornos Windows, es fundamental entender los protocolos que operan en segundo plano. Kerberos y NTLM son los dos principales protocolos de autenticación utilizados, cada uno con características y aplicaciones distintas. A pesar de que ambos sirven para el mismo propósito, sus diferencias son significativas, especialmente en términos de seguridad y rendimiento. Para tomar decisiones informadas sobre cuál utilizar, es esencial comprender cómo funcionan y en qué se distinguen.

NTLM

NTLM (NT Lan Manager) es un protocolo de autenticación desarrollado por Microsoft que ha estado en uso desde la era de Windows NT. A pesar de su antigüedad y las limitaciones de seguridad que presenta, NTLM sigue siendo utilizado en escenarios donde Kerberos no está disponible o no puede ser implementado, como en redes que no están unidas a un dominio.

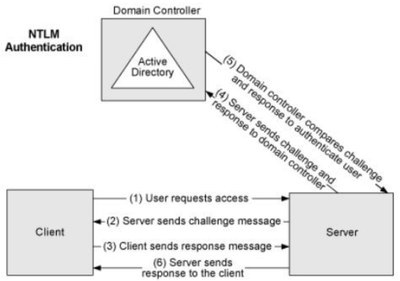
El proceso de autenticación con NTLM es relativamente sencillo pero menos seguro que Kerberos. NTLM se basa en un desafío-respuesta (challenge-response), donde el cliente primero establece una conexión con el servidor y envía el nombre de usuario. El servidor genera un valor de desafío (un número aleatorio) que se envía al cliente. El cliente, a su vez, cifra este desafío utilizando un hash de la contraseña del usuario y lo envía de vuelta al servidor. El servidor compara este resultado con lo que esperaba y, si coinciden, se concede el acceso.

Autenticacion-NTLM

Una de las principales limitaciones de NTLM es la falta de autenticación mutua. Es decir, mientras que el servidor autentica al cliente, el cliente no autentica al servidor, lo que deja abierta la posibilidad de ataques como el «man-in-the-middle». Además, NTLM es vulnerable al ataque de «pass-the-hash», donde un atacante puede reutilizar el hash de la contraseña para acceder a recursos sin conocer la contraseña original.

Autenticación NTLM en SQL Server

En SQL Server, NTLM se utiliza principalmente cuando Kerberos no está configurado correctamente o cuando la conexión se realiza en un entorno de trabajo que no soporta Kerberos, como un grupo de trabajo (WORKGROUP) en lugar de un dominio. También, cuando accedamos desde el propio servidor local y no por la red, SIEMPRE se va a usar NTLM. Por último, es común ver NTLM en escenarios legacy, donde las aplicaciones antiguas no son compatibles con Kerberos.

Kerberos

Kerberos es un protocolo de autenticación mucho más avanzado que NTLM, introducido en Windows 2000. Basado en un sistema de «tickets», Kerberos no solo ofrece mayor seguridad, sino también un rendimiento mejorado en comparación con NTLM.

Kerberos opera utilizando un tercero de confianza, conocido como el Key Distribution Center (KDC), que emite tickets de autenticación. El proceso comienza cuando un usuario solicita acceso a un servicio. El cliente primero se autentica ante el KDC, que le proporciona un Ticket Granting Ticket (TGT). Este TGT permite al usuario solicitar tickets de servicio (Service Tickets) para acceder a diferentes recursos en la red. Cada ticket de servicio se presenta al servidor para establecer la autenticación, y dado que estos tickets están cifrados, Kerberos ofrece una mayor protección contra ataques.

Autenticacion-Kerberos

Una de las características más importantes de Kerberos es la autenticación mutua, donde tanto el cliente como el servidor validan las identidades del otro, reduciendo significativamente el riesgo de ataques de suplantación de identidad. Además, Kerberos es más eficiente en términos de red y recursos, ya que no requiere múltiples rondas de comunicación para completar la autenticación como en NTLM.

Autenticación Kerberos en SQL Server

En SQL Server, Kerberos es el protocolo que se usa preferentemente siempre y cuando esté disponible, es decir, configurado correctamente en un entorno de dominio de Active Directory. Esto no solo mejora la seguridad, sino que también nos permite el uso de características avanzadas como la delegación de autenticación, que es esencial para aplicaciones que requieren pasar las credenciales de usuario a través de múltiples capas de servicios. Sin esta delegación de autenticación, por ejemplo, es imposible “saltar” desde tu ordenador local a un servidor vinculado configurado en tu servidor SQL con el inicio de sesión de Active Directory.

Comparación: NTLM vs Kerberos

Cuando comparamos NTLM y Kerberos en entornos SQL Server, es evidente que Kerberos ofrece numerosas ventajas, tanto en términos de seguridad como de eficiencia. Sin embargo, la elección entre uno y otro puede depender de varios factores, incluidos los requisitos del entorno y la compatibilidad de las aplicaciones. 

Seguridad

Kerberos es claramente superior en términos de seguridad. La autenticación mutua y el uso de tickets cifrados hacen que Kerberos sea menos susceptible a los ataques de red comunes. Por el contrario, NTLM, con su enfoque de desafío-respuesta y su vulnerabilidad al ataque pass-the-hash, es menos seguro y, por lo tanto, menos adecuado para entornos donde la seguridad es una preocupación primordial.

Rendimiento

En términos de rendimiento, Kerberos también tiene la ventaja. Al usar tickets, Kerberos reduce la carga de comunicación y mejora la eficiencia de la autenticación, especialmente en redes grandes con muchos usuarios y servicios. NTLM, aunque funcional, puede generar una carga adicional en la red debido a la necesidad de múltiples rondas de autenticación.

Compatibilidad y Configuración

A pesar de sus ventajas, Kerberos requiere una configuración más compleja y solo funciona en entornos de dominio de Active Directory. NTLM, aunque menos seguro, es más sencillo de implementar y funciona en una gama más amplia de escenarios, incluidos aquellos que no están dentro de un dominio.También deberemos tener en cuenta la complejidad extra de configuración de un entorno compatible con Kerberos donde tendremos que registrar correctamente los SPN (Service Principal Names) cuando usemos una cuenta de servicio que no sea la por defecto en una instancia por defecto y siempre que usemos instancias con nombre.

Conclusión

La elección del modo de autenticación en SQL Server o Azure SQL no es trivial y debe basarse en las necesidades específicas de seguridad y administración de cada entorno. La autenticación de SQL Server proporciona flexibilidad en escenarios específicos, mientras que la autenticación de Windows y Azure Entra ID ofrecen ventajas significativas en términos de seguridad y facilidad de gestión. Además, el entendimiento de los protocolos subyacentes como Kerberos y NTLM nos permite tomar decisiones más informadas sobre cómo proteger nuestras bases de datos contra amenazas externas. Al final, lo más importante es elegir el método de autenticación que no solo se alinee con las políticas de seguridad de la organización, sino que también se adapte a las características y necesidades del entorno en el que operamos.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

No te vayas aun. Hemos creado una página donde estamos recopilando todos estos artículos que dan respuesta a estas preguntas frecuentes de SQL Server. Pásate por aquí a echar un vistazo.


Publicado por Roberto Carrancio en Cloud, SQL Server, 1 comentario