Teoría BBDD

SQL AVANZADO – Agrupaciones con Cube y Rollup

Continuamos con los videos de T-SQL avanzado con los modificadores WITH CUBE y WITH ROLLUP. Estos son modificadores de la cláusula GROUP BY. Gracias a WITH CUBE vamos a poder totalizar nuestras agrupaciones junto a los resultados de nuestras consultas y con WITH ROLLUP podremos ver solo totales agrupados por varios campos.

Al igual que comentamos en nuestro anterior video de T_SQL Avanzado el uso de este tipo de consultas en vistas que luego se consumirán desde Power BI nos va a evitar caer en el error de romper el plegado de consultas. También vamos a conseguir con una sola consulta los resultados que, de otra manera, necesitaríamos por lo menos dos consultas, con el doble de lecturas sobre los datos y, por tanto, con mayor consumo de recursos.

Banner-Telegram

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 0 comentarios

SQL AVANZADO: ¿Cómo hacer PIVOT y UNPIVOT?

Empezamos una nueva serie en este video blog sobre como hacer consultas SQL complejas. Uno de los conceptos más importantes y menos conocido del código SQL avanzado es la opción de Pivot y Unpivot para pivotar o despivotar consultas respectivamente.

Gracias a estas opciones de Pivot y Unpivot vamos a poder delegar en el origen SQL agrupaciones avanzadas que, a veces por desconocimiento, estamos haciendo en modelos tabulares con grandes y costosas transformaciones. Como os digo, no son pocas las veces que en informes de Crystal reports o consultas con Power Query tratamos de realizar estas transformaciones no plegables. Con este detalle, haciendo el Pivot en una vista en el origen, podremos optimizar enormemente el rendimiento de nuestros informes.

Banner-Telegram

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, Videos, 1 comentario

Tipos de dato Fecha y Hora

Uno de los retos más importantes que vamos a enfrentar cuando trabajamos con datos es la gestión de las fechas y horas. Al igual que nos pasaba con los datos numéricos, elegir el tipo de datos de fecha y/o hora correcto es de vital importancia y no debe ser ignorado. En SQL Server, tenemos a nuestra disposición varios tipos de datos para manejar la fecha y la hora. Pero, ¿sabemos realmente cuándo y cómo utilizar cada uno de ellos? En este artículo, vamos a profundizar en este tema pues no es solo tarea del diseñador de la base de datos sino que, como DBAs tendremos que asesorar al usuario para evitar incidencias con las conversiones de datos en un futuro.

Tipos de Datos de Fecha y Hora

Tanto SQL Server como Azure SQL ofrecen varios tipos de datos para trabajar con fechas y horas: datetime, smalldatetime, date, time, datetime2 y datetimeoffset. Cada uno de ellos tiene unas particularidades y responde a unas necesidades concretas que deberemos conocer para una elección correcta del tipo de dato llegado el momento.

Datetime y SmallDatetime (fecha y hora)

Datetime y SmallDatetime son los tipos de datos más antiguos y existen desde las primeras versiones de SQL Server. Nos van a permitir manejar las fechas y las horas sin demasiada complicación aunque por contra perderemos detalle comparado con otros tipos más modernos. En concreto, Datetime tiene una precisión de hasta 3 milisegundos, mientras que SmallDatetime tiene una precisión de hasta un minuto.

Date y Time (solo fecha y solo hora)

Con la llegada al mercado de SQL Server 2008 se introdujeron los tipos de datos Date y Time. Estos tipos de datos nos permiten almacenar únicamente la fecha o la hora, respectivamente respondiendo así a una necesidad hasta entonces sin cubrir.

Datetime2 (fecha y hora)

Datetime2 es una evolución del tipo de datos datetime que tiene una mayor precisión y un rango de fechas más amplio. Puede tener una precisión de hasta 100 nanosegundos lo que lo convierte en compatible con los estándares ANSI e ISO 8601. Es el tipo de datos que yo te recomendaría usar si estás diseñando una nueva base de datos desde el principio y no te quieres complicar en exceso.

Datetimeoffset (fecha, hora y zona horaria)

Por último, Datetimeoffset es el tipo de datos de fecha y hora más completo que ofrecen SQL Server y Azure SQL. Es similar a datetime2, pero incluye información sobre la zona horaria. Es útil cuando se trabaja con diferentes zonas horarias pero, si no es nuestro caso, este extra de información solo va a conllevar más consumo de espacio y, por tanto, de recursos a la hora de trabajar.

Ejemplos

Veamos todos estos tipos de datos en un ejemplo para que se entienda mejor:

FECHA-sysdatetime

Datetime vs Datetime2: Conversiones entre tipos de datos

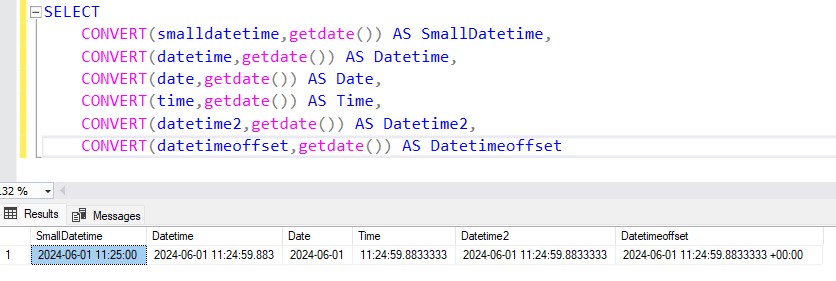
Como ya hemos visto, Datetime2 es especialmente interesante debido a su gran precisión y rango. Esto, que a priori es una ventaja, puede llevarnos a errores cuando convertimos a Datetime2 desde Datetime. Si os fijáis en la captura del apartado anterior yo he usado la función SYSDATETIME() que devuelve un resultado Datetime2 y no GETDATE() que devuelve Datetime. Veamos el mismo ejemplo con la función GETDATE()

FECHA-getdate

Como veis, al convertir un valor Datetime a Datetime2 no se rellena con 0 la precisión faltante sino que, en este caso, se ha rellenado con un 3 periódico. Si volvéis a leer ahora  lo que os he contado de Datetime veréis que os he dicho que la precisión es de hasta 3 milisegundos y en ningún momento os he dicho que tenga una precisión de milisegundos. Es decir, la precisión es de uno entre 300 fracciones de segundo y no de 1/1000 segundos.

Al convertir ese valor Datetime a Datetime2 no tenemos información para completar ese extra de precisión. Además, es imposible representar en un número en base 10 el valor 1/300 por eso vemos ese 333 de manera infinita en los decimales. 

Estilos de fecha y hora

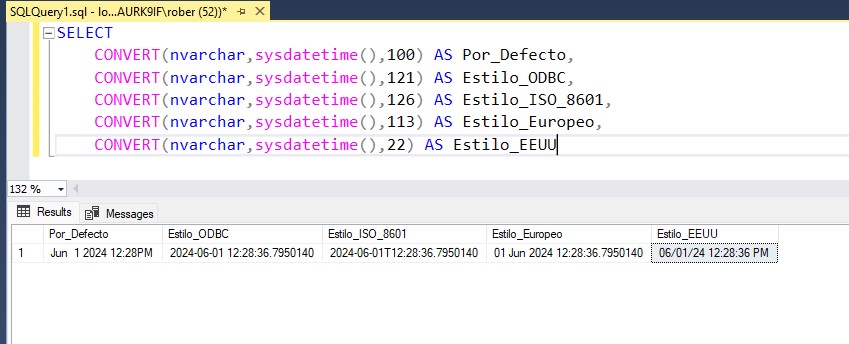
Además de los tipos de datos, un aspecto clave en la representación de las fechas almacenadas en la base de datos es el estilo. Por defecto, se muestra en formato Año, Mes y Dia seguido de la hora en Horas, Minutos, Segundos y Milisegundos. Sin embargo, podremos actuar sobre este comportamiento y elegir el estilo que deseemos con unos valores a la hora de convertir los datos de fecha a texto para su representación.

FECHA-estilos

Podéis encontrar todos los estilos disponibles en esta documentación oficial.

Conclusión

Manejar correctamente los tipos de datos de fecha y hora en SQL Server o Azure SQL es esencial para mantener la integridad de los datos y realizar cálculos precisos. Aunque puede parecer un tema sencillo al principio es más complejo cuando empiezas a trabajar con ello y a profundizar. Sin embargo, como todo, con un poco de práctica y estudio, se puede dominar. Espero que este artículo te haya ayudado en el dominio de los tipos de datos de fecha en SQL Server y Azure SQL. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, 2 comentarios

Masterclass Niveles de Aislamiento en SQL Server

Como ya os anuncié la semana pasada, la madrugada del pasado jueves 23 (hora española) tuvo lugar el evento Noches de DBAs en el que, invitado por Alberto de Rossi, pude dar una masterclass sobre niveles de aislamiento en SQL Server para la comunidad Power BI User Group de Lima. Por suerte para todos, esta masterclass está grabada y publicada abiertamente en YouTube. A continuación os comparto la grabación y las diapositivas que vimos en la sesión.

Como sabéis, los niveles de aislamiento y los bloqueos son uno de los temas que más hemos tratado en el blog por lo que a continuación os voy a dejar varios de los artículos en los que podéis profundizar para encontrar más información sobre el tema:

Espero que os haya gustado esta sesión, y que sea la primera de muchas. Dejad vuestro me gusta y comentario para que desde la comunidad nos tengan en cuenta. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 0 comentarios

¿Qué son las bases de datos NoSQL?

Recientemente vi un vídeo corto en TikTok en el que el creador del lenguaje SQL se hacía eco de las novedades de las bases de datos NoSQL y, al contrario de lo que podéis estar pensando, alababa sus bondades. 

Menos mal que habló de bases de datos NoSQL porque si llega a decir algo parecido sobre Excel yo pierdo la fe en esto que hacemos y me convierto en monje de clausura con voto de silencio de por vida.

Pero, no perdamos el foco, la verdad es que el paradigma en cuanto a consumo de información está cambiando y esto nos está llevando a un escenario en el que nos encontramos constantemente con nuevos desafíos y oportunidades. Uno de estos desafíos es que cada vez es más común encontrarnos con entornos en los que las restricciones de una base de datos relacional limitarían su usabilidad. De ahí ha surgido una gran oportunidad y no es otra que el surgimiento de las bases de datos NoSQL. Pero, ¿qué son exactamente las bases de datos NoSQL y por qué son importantes?

¿Qué son las bases de datos NoSQL?

Debemos leer NoSQL como Not Only SQL o “No Solo SQL” en español, son un tipo de sistema de gestión de bases de datos que permite el almacenamiento y la recuperación de datos que se modelan de formas distintas a las tabulares utilizadas en las bases de datos relacionales. Estas bases de datos surgieron en respuesta a las limitaciones de las bases de datos SQL tradicionales, especialmente para manejar grandes cantidades de datos distribuidos o para trabajar con archivos de distinto formato en la era del contenido multimedia.

Características de las bases de datos NoSQL

Las bases de datos NoSQL tienen varias características que las distinguen de las bases de datos SQL tradicionales. Algunas de estas características incluyen:

  • Escalabilidad horizontal: Las bases de datos NoSQL están diseñadas para expandirse fácilmente a través de múltiples servidores sin interrupciones de servicio. Esto las hace ideales para aplicaciones con grandes volúmenes de datos y muchas operaciones de lectura y escritura.
  • Flexibilidad de esquemas: A diferencia de las bases de datos SQL, que requieren que defina un esquema antes de insertar datos, las bases de datos NoSQL suelen ser “sin esquema”. Esto significa que puede insertar datos sin definir primero qué tipo de datos va a insertar.
  • Alta disponibilidad: Las bases de datos NoSQL utilizan una variedad de técnicas para garantizar la redundancia y la distribución de los datos, lo que las hace muy resistentes a los fallos y asegura que los datos estén siempre disponibles cuando se necesiten.

Bases de datos distribuidas

Las bases de datos distribuidas son sistemas en los que los datos no están todos almacenados en un solo lugar, sino que están repartidos por varios servidores, a menudo en diferentes ubicaciones físicas. Este tipo de bases de datos son comunes en las bases de datos NoSQL.

La distribución de los datos tiene varias ventajas, como la escalabilidad (puedes añadir más servidores para manejar más datos) y la disponibilidad (si un servidor falla, los datos todavía están disponibles en otros servidores). Sin embargo, también presenta desafíos, como la necesidad de manejar la consistencia de los datos entre los servidores y la gestión de altas latencias cuando las ubicaciones de los servidores están muy separadas entre sí.

Tipos de bases de datos NoSQL

Existen varios tipos de bases de datos NoSQL, cada una con sus propias características y ventajas. Algunos de los tipos más comunes incluyen:

  • Bases de datos clave-valor: Estas bases de datos almacenan datos como un conjunto de pares clave-valor. Son altamente escalables y se utilizan en sistemas de almacenamiento en caché, sesiones de usuario y más.
  • Bases de datos de documentos: Estas bases de datos almacenan datos en documentos, normalmente en formato JSON. Son flexibles y se utilizan en aplicaciones de contenido, catálogos y más.
  • Bases de datos de columnas: Estas bases de datos organizan los datos por columnas en lugar de filas. Son eficientes y se utilizan en análisis de datos, sistemas de recomendación y más.
  • Bases de datos de grafos: Estas bases de datos utilizan estructuras de grafo para representar y almacenar datos. Son útiles para trabajar con datos interconectados, como redes sociales, sistemas de recomendación y más.

SQL-Like en bases de datos NoSQL

Aunque las bases de datos NoSQL se alejan del modelo relacional y del lenguaje SQL, algunas de ellas ofrecen interfaces de consulta que son similares a SQL, a menudo denominadas “SQL-Like”. Estas interfaces permiten a los desarrolladores que están familiarizados con SQL trabajar con bases de datos NoSQL con una curva de aprendizaje más suave.

Por ejemplo, Cassandra ofrece un lenguaje de consulta llamado CQL (Cassandra Query Language) que es muy similar a SQL. Permite a los usuarios realizar consultas de selección, inserción, actualización y eliminación de manera similar a como lo harían en una base de datos SQL.

MongoDB y otras soluciones NoSQL

MongoDB es una base de datos de documentos NoSQL muy popular. Almacena los datos en un formato similar a JSON llamado BSON, que permite una gran flexibilidad en la estructura de los datos. MongoDB es conocido por su escalabilidad horizontal y su rendimiento en aplicaciones con grandes volúmenes de datos.

Otra solución NoSQL popular es Redis, una base de datos en memoria que se utiliza principalmente como sistema de almacenamiento en caché. Redis almacena los datos en estructuras de datos simples como cadenas, listas, conjuntos, conjuntos ordenados con consultas de rango, mapas, HyperLogLogs, índices de bits y flujos.

Conclusión

Las bases de datos NoSQL ofrecen una serie de ventajas sobre las bases de datos SQL tradicionales, incluyendo flexibilidad, escalabilidad y alta disponibilidad. Aunque no son la solución adecuada para todas las situaciones, en los casos correctos pueden proporcionar un rendimiento y una eficiencia significativamente mejores. Como siempre, la elección de la tecnología adecuada depende de las necesidades específicas de su aplicación y su equipo.

En resumen, las bases de datos NoSQL ofrecen soluciones poderosas para manejar los desafíos de los grandes volúmenes de datos y las altas tasas de lectura y escritura. Aunque no son adecuadas para todas las situaciones, pueden ser una excelente opción para ciertas aplicaciones. Como siempre, la elección de la tecnología adecuada depende de las necesidades específicas de nuestra aplicación y el equipo de trabajo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Otros, 0 comentarios

¿Por qué NO debes USAR NoLOCK en tus consultas SQL?

En ocasiones podemos pensar en un nivel de aislamiento read uncommitted o en el uso de la clausula NoLOCK como la solución a nuestros problemas de bloqueos. Si a ti también te ha pasado este video es para ti. Vamos a ver como su uso tiene muchos riegos y hay resultados inesperados que, para mi, hacen que no sea la mejor de la soluciones.

Espero que te haya gustado esta demostración rápida de los problemas a los que nos podemos enfrentar por usar NoLOCK. Ahora que ya conoces los riegos te recomiendo valorar una solución como Read Committed Snapshot para tus transacciones. Si quieres saber más de niveles de aislamiento te recomiendo nuestros post sobre niveles de aislamiento, niveles de aislaminto – casos prácticos y el uso de nolock.

Banner-Telegram

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 0 comentarios

Estimación de Cardinalidad en SQL Server

Como DBAs siempre nos encontramos en una constante búsqueda de optimización y mejora del rendimiento de nuestras bases de datos. Esto, antes o después nos lleva a encontrarnos con  un concepto fundamental pero que puede resultar complicado al principio: la estimación de cardinalidad. Este concepto, aunque pueda parecer magia interna de SQL Server, es esencial para entender cómo el motor de base de datos de SQL Server decide el mejor plan de ejecución para ejecutar nuestras consultas. Es decir, es la clave para elegir el camino más óptimo para resolver lo que le hemos pedido.

Estimación de Cardinalidad

Como hemos adelantado ya en la introducción ,la estimación de cardinalidad es el proceso mediante el cual SQL Server trata de predecir el número de filas a las que va a afectar una consulta. No sólo calcula el número total de filas afectadas sino que lo hace con una granularidad total, calculando cuántas filas pasarán por todos y cada uno de los distintos componentes de los planes de ejecución posibles para resolver la consulta. Este número, también conocido como cardinalidad, es crucial para el optimizador de consultas, ya que sin esta información el motor de base de datos no podría elegir el plan de ejecución más eficiente. SQL Server utiliza estadísticas para realizar estas estimaciones de cardinalidad. 

Estadísticas en SQL Server: La base de la cardinalidad

Como acabamos de ver, el optimizador de consultas utiliza las estadísticas para estimar la cardinalidad. Por ejemplo, si estamos buscando registros de en una tabla donde la columna ‘edad’ es mayor que 30, SQL Server utilizará las estadísticas para estimar cuántos registros cumplen con este criterio. Pero, ¿cómo funciona exactamente?

Las estadísticas en SQL Server son objetos que almacenan información sobre la distribución de los valores en una o más columnas de una tabla o vista indexada. Cada objeto de estadísticas está compuesto por un histograma que describe la distribución de los valores, y un vector de densidad que contiene información sobre la correlación de los valores en las columnas.

SQL Server crea y actualiza automáticamente las estadísticas para las columnas indexadas en nuestras tablas y vistas. También podemos crear estadísticas para columnas no indexadas utilizando el comando CREATE STATISTICS, o podemos actualizar las estadísticas existentes utilizando el comando UPDATE STATISTICS.

Es importante tener en cuenta que las estadísticas pueden volverse obsoletas a medida que los datos en nuestras tablas cambian. Cuando esto sucede, las estimaciones de cardinalidad basadas en estas estadísticas pueden ser inexactas.  Esto puede llevar a SQL Server a elegir un plan de ejecución subóptimo, lo que puede resultar en un rendimiento deficiente de la consulta. Otro de los problemas comunes, aunque el plan de ejecución sea el correcto es una asignación de recursos no óptima para la resolución de las consultas lo que puede llevarnos a una profunda degradación de rendimiento.

Planes de Ejecución: El resultado de la estimación de cardinalidad

Un plan de ejecución es, en resumen, una serie de pasos que SQL Server sigue para ejecutar una consulta. Cada paso en el plan de ejecución tiene su propio componente que representa una operación atómica, como un escaneo de tabla, un join, o una operación de ordenación.

El optimizador de consultas de SQL Server utiliza las estadísticas para estimar la cardinalidad y elige el plan de ejecución que tiene el menor costo estimado. El costo de un plan de ejecución se mide en términos de la cantidad de recursos que se espera que consuma, como la CPU, la E/S de disco, y la memoria RAM.

Podemos ver el plan de ejecución de una consulta utilizando la opción SET SHOWPLAN_ALL ON. Esto nos proporcionará una representación gráfica del plan de ejecución, junto con información detallada sobre cada operación en el plan.

No vamos a profundizar mucho más en este sentido pues ya le hemos dedicado a este tema este artículo completo en este blog.

Conclusión

La estimación de cardinalidad es un aspecto esencial en la optimización de consultas en SQL Server. Aunque puede parecer un concepto complejo, entender cómo funciona puede ayudarnos a mejorar significativamente el rendimiento de nuestras bases de datos.

Es importante recordar que las estadísticas, que son la base de la estimación de cardinalidad, deben mantenerse actualizadas para garantizar estimaciones precisas. Como siempre, la clave está en conocer nuestras bases de datos, entender cómo se utilizan y aplicar este conocimiento para optimizar su rendimiento.

En resumen, la estimación de cardinalidad es una herramienta poderosa en nuestras manos. Con un buen entendimiento de cómo funciona, podemos hacer que nuestras bases de datos trabajen de manera más eficiente y efectiva. ¡Sigamos aprendiendo y mejorando juntos!

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios