Roberto Carrancio

Mi nombre es Roberto Carrancio y soy un DBA de SQL server con más de 10 años de experiencia en el sector. Soy el creador del blog soydba.es donde intento publicar varios artículos a la semana (de lunes a viernes que los fines de semana me gusta estar con mi gente y disfrutar de mi moto) Espero que disfrutes leyendo este blog tanto como yo disfruto escribiendo y que te sea de utilidad. Si tienes alguna sugerencia, pregunta o comentario, puedes dejarlo al final de cada entrada o enviarme un correo electrónico. Estaré encantado de leerte y responderte. ¡Gracias por tu visita! Mi principal interés es compartir mi conocimiento sobre bases de datos con todo el que quiera aprenderlo. Me parece un mundo tan apasionante como desconocido. Fuera de lo profesional me encanta la cocina, la moto y disfrutar de tomar una cervecita con amigos.

¿Qué pasa con la inicialización instantánea de ficheros al habilitar TDE?

La inicialización instantánea de ficheros (Instant File Initialization, IFI) es una funcionalidad crucial en SQL Server que reduce significativamente los tiempos de ciertas operaciones, como la creación de bases de datos, la restauración de backups y el crecimiento de archivos. Sin embargo, al activar el cifrado transparente de datos (Transparent Data Encryption, TDE), los beneficios de IFI se pierden debido a los requisitos inherentes de seguridad que impone TDE. En este artículo analizaremos con mayor profundidad cómo interactúan ambas tecnologías, los motivos detrás de esta interacción y las estrategias para gestionar su impacto en entornos de producción.

Entendiendo la inicialización instantánea de ficheros

Cuando SQL Server asigna espacio en disco para bases de datos o archivos de log, el sistema operativo, por defecto, rellena este espacio con ceros. Este proceso garantiza que no queden accesibles datos residuales en los bloques de disco, lo que protege la privacidad de la información eliminada. Sin embargo, este paso puede ralentizar considerablemente ciertas operaciones en SQL Server. La inicialización instantánea de ficheros (IFI) permite omitir este relleno, lo que acelera estas operaciones críticas:

Creación de bases de datos grandes

Al crear una base de datos nueva, SQL Server asigna espacio en disco para los archivos de datos y de log. Si IFI no está habilitado, este espacio debe ser rellenado con ceros antes de que la base de datos esté lista para usarse. En bases de datos grandes, esto puede significar tiempos de espera considerables. Con IFI, el espacio se asigna sin esta inicialización, haciendo que el proceso sea prácticamente inmediato.

Restauración de backups grandes

Restaurar una base de datos desde un backup implica no sólo copiar los datos al sistema de archivos, sino también asignar espacio en disco para los archivos restaurados. Sin IFI, SQL Server debe rellenar con ceros el espacio asignado antes de restaurar los datos, lo que prolonga el tiempo necesario para completar la operación. Esto puede ser crítico en escenarios de recuperación ante desastres, donde cada minuto cuenta.

Crecimiento automático de archivos

SQL Server permite configurar bases de datos y archivos de log con crecimientos automáticos para evitar errores de espacio insuficiente. Cuando un archivo necesita crecer, SQL Server asigna más espacio en disco. Si IFI no está habilitado, este espacio adicional debe inicializarse con ceros antes de que el archivo pueda seguir utilizándose, causando retrasos en operaciones que requieren escribir inmediatamente en el archivo.


La inicialización instantánea de ficheros está diseñada para mitigar estos cuellos de botella. Para habilitar esta funcionalidad, la cuenta de servicio de SQL Server debe tener asignado el privilegio «Perform volume maintenance tasks» en el sistema operativo. Esto permite que SQL Server omita el paso de rellenar el espacio asignado con ceros, mejorando drásticamente el rendimiento de las operaciones mencionadas. Puedes encontrar más información sobre cómo configurar este privilegio y sus beneficios en nuestro artículo dedicado aquí.

¿Qué es TDE y por qué afecta a la inicialización instantánea?

Transparent Data Encryption (TDE) es una tecnología diseñada para cifrar datos en reposo en SQL Server y proteger la información en caso de accesos no autorizados a los archivos físicos de la base de datos. Cuando TDE está habilitado, todos los datos almacenados en los archivos de la base de datos (incluidos los logs de transacciones) se cifran mediante una clave de cifrado jerárquica. Puedes encontrar más detalles en nuestro artículo sobre cifrado en SQL Server y en este video sobre TDE.

El problema al activar TDE es que SQL Server no puede aprovechar la inicialización instantánea de ficheros. En lugar de simplemente asignar espacio en disco, debe escribir datos cifrados en ese espacio para evitar que datos residuales sin cifrar queden expuestos en los bloques del sistema de archivos. Este proceso introduce una sobrecarga significativa, especialmente en operaciones como:

  • Crecimiento de archivos: Tanto los archivos de datos (.mdf, .ndf) como los archivos de log (.ldf) deben inicializarse completamente al ampliarse.
  • Restauración de bases de datos: Requiere cifrar todo el espacio asignado antes de completar el proceso.
  • Creación de bases de datos: Similar a la restauración, el tiempo de inicialización aumenta notablemente.

El impacto de TDE en el rendimiento y cómo gestionarlo

El impacto de la pérdida de IFI en bases de datos con TDE puede ser considerable, especialmente en sistemas con alta actividad transaccional o que manejan bases de datos de gran tamaño. Sin embargo, no todo está perdido. A continuación os dejo una lista de acciones que podemos hacer para mitigar estos daños.

Planificación proactiva del crecimiento de archivos

Configurar tamaños iniciales de archivos y establecer crecimientos manuales y controlados puede reducir la frecuencia de eventos de crecimiento automático. Por ejemplo, asignar bloques grandes de espacio en lugar de pequeños incrementos minimiza la necesidad de inicializaciones frecuentes.

Optimización del almacenamiento

El uso de discos SSD y configuraciones RAID de alto rendimiento puede acelerar las operaciones de escritura asociadas con la inicialización. Además, separar los discos para archivos de datos y de log permite distribuir la carga.

Compresión de backups

La compresión de backups no es que reduzca el tamaño del archivo a restaurar por lo que el tiempo necesario para inicializar el espacio cifrado será el mismo. Sin embargo, esta técnica nos permitirá ganar tiempo a la hora de mover o restaurar estos archivos desde la red. Puedes consultar este video donde comparamos tiempos de copias y restauraciones con y sin comprimir.

Segmentación del uso de TDE

No todas las bases de datos requieren un nivel extremo de seguridad. Analizar qué bases necesitan realmente TDE y aplicar la encriptación sólo en aquellas esenciales puede equilibrar el rendimiento y la seguridad.

Supervisión activa

La monitorización constante del rendimiento puede ayudar a identificar cuellos de botella relacionados con la inicialización de archivos. Herramientas como Extended Events o el Query Store pueden proporcionar visibilidad sobre las operaciones afectadas.

Consideraciones avanzadas con TDE: recuperación y restauración

Uno de los mayores retos al combinar TDE con la pérdida de la inicialización instantánea de ficheros nos lo vamos a encontrar en los tiempos de restauración. Este aspecto es crítico en entornos de alta disponibilidad y recuperación ante desastres. Los administradores de bases de datos debemos tener en cuenta la necesidad de probar y ajustar los procesos de recuperación regularmente para entender el impacto real en tiempos de inactividad.Con esto en mente podremos configurar estrategias de recuperación que incluyan bases de datos en modo Standby o soluciones como Always On Availability Groups para minimizar el tiempo necesario en caso de fallos.

Conclusión: seguridad de TDE vs rendimiento de IFI

La interacción entre la inicialización instantánea de ficheros y el cifrado transparente de datos pone en evidencia el constante balance entre seguridad y rendimiento que enfrentamos como administradores de bases de datos. Aunque IFI es una herramienta valiosa para optimizar operaciones críticas, su incompatibilidad con TDE subraya la importancia de priorizar la seguridad de los datos en entornos sensibles.

Con un enfoque proactivo y la implementación de mejores prácticas, podemos minimizar el impacto de esta limitación y garantizar que nuestras bases de datos sean tanto seguras como eficientes.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!


Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Christmas Power Platform Euskadi 2024: Tecnología Solidaria al Servicio de la Comunidad

Los días 13 y 14 de diciembre de 2024, llega el evento que combina lo mejor de la Power Platform con el espíritu solidario de la Navidad. El Christmas Power Platform Euskadi 2024 se consolida como uno de los eventos más destacados de la comunidad tecnológica este año y será el punto de encuentro virtual para expertos y apasionados de las tecnologías de Microsoft, ofreciendo una agenda cargada de aprendizaje, innovación y propósito social.

Participación Solidaria: Un Evento con Valor

Aunque la convocatoria para ponentes ya ha finalizado, aún puedes ser parte de este evento único como asistente. Para asistir al evento, solo necesitas adquirir tu entrada a través de la plataforma Eventbrite, donde el coste de tu entrada será donado directamente al Banco de Alimentos de Guipúzcoa. De esta manera, no tendrás que realizar la donación por tu cuenta; al comprar tu entrada, estarás contribuyendo automáticamente a esta causa solidaria.

Con un mínimo de 1€, puedes ser parte de esta experiencia transformadora mientras ayudas a quienes más lo necesitan.

SoyDBA: Mi Participación en Christmas Power Platform Euskadi

Tengo el honor de ser uno de los patrocinadores y además ponente en este evento. En mi charla, compartiré conocimientos clave sobre SQL Server y Power BI, abordando estrategias prácticas y consejos para sacar el máximo partido a estas herramientas. Será una excelente oportunidad para conectar contigo y explorar juntos cómo optimizar el rendimiento en proyectos tecnológicos.

Como creador del blog SoyDBA, este Christmas Power Platform Euskadi 2024 me brinda una plataforma para continuar aportando a la comunidad y generar un impacto positivo. Espero verte en mi sesión.

Agenda del Evento: Un Espacio para el Conocimiento

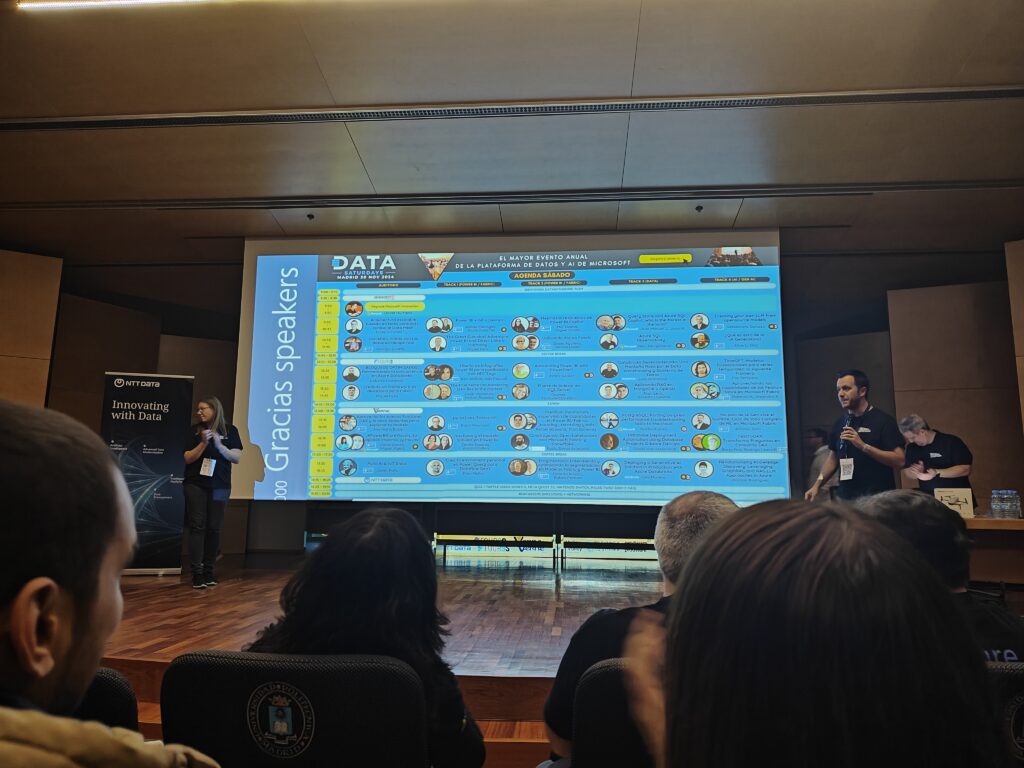
La agenda del evento se ha desvelado parcialmente, como ves en la imagen parte de los ponentes aún son sorpresa. 

Si quieres estar al día de todas las novedades te recomiendo no esperar más y unirte al evento comprando una entrada. Lo que sí te puedo asegurar es que durante los dos días del evento, te esperan:

  • Charlas de Expertos: Descubre las últimas novedades y casos prácticos en Power BI, Power Apps, Power Automate, Power Pages y más.
  • Casos de Éxito Empresariales: Aprende cómo las organizaciones están utilizando Power Platform para transformar sus operaciones.
  • Oportunidades de Networking Virtual: Conéctate con otros asistentes y expande tu red profesional.

Cómo Participar

Para participar es sencillo, lo único que tienes que hacer es adquirir tu entrada en Eventbrite. Esto asegura tu acceso al evento realizando tu donación solidaria mínima de 1€ hasta lo que tu quieras donar. Antes del evento todos los inscritos recibirán en su email los enlaces para la conexión al evento. Simplemente tendrás que esperar y conectarte a alguno de los tracks los días del Evento. Y ya está, ya solo queda disfrutar de todas las sesiones desde la comodidad de tu hogar y aprovechar al máximo esta experiencia.

Bueno no, una cosa más, si te apasiona esta idea tanto como a nosotros por favor, comparte. Cuantos más seamos mejor.

Haz de la Tecnología una Fuerza para el Bien

El Christmas Power Platform Euskadi 2024 no es solo un evento tecnológico, sino también un movimiento que combina innovación y solidaridad. Cada entrada adquirida, cada charla atendida y cada idea compartida contribuyen a hacer una diferencia positiva.

Reserva tu entrada en Eventbrite, marca las fechas en tu calendario y prepárate para ser parte de una Navidad llena de aprendizaje y propósito. ¡Nos vemos el 13 y 14 de diciembre, y no olvides asistir a mi charla! Será un placer compartir este espacio contigo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
 

Publicado por Roberto Carrancio en Cloud, Power BI, SQL Server, 0 comentarios

Los peligros del permiso SHOWPLAN

Cuando administramos bases de datos en SQL Server, no debemos perder el foco en asegurar la confidencialidad, integridad y disponibilidad de los datos. Sin embargo, a veces, centrados en el rendimiento, subestimamos cómo ciertos permisos pueden abrir brechas de seguridad inesperadas. Uno de estos permisos es SHOWPLAN. ¿Alguna vez le has dado permisos de SHOWPLAN en producción a un desarrollador? Puede parecer inofensivo y además es una herramienta poderosa y útil para que los desarrolladores puedan optimizar sus consultas, pero no es tan sencillo. ¿Sabías que puede convertirse en un riesgo significativo si se concede de manera inapropiada? A continuación, te cuento en profundidad qué implica este permiso, sus ventajas legítimas y los riesgos que puede acarrear cuando se utiliza fuera de contexto.

¿Qué es el permiso SHOWPLAN?

El permiso SHOWPLAN en SQL Server permite a los usuarios generar y visualizar los planes de ejecución de las consultas. Esto incluye detalles sobre cómo el motor de base de datos planea ejecutar una consulta SQL, mostrando operaciones como búsquedas en índices, uniones, escaneos de tablas, y predicados de filtro.

Existen dos variantes principales de este permiso, SHOWPLAN_XML y SHOWPLAN_TEXT, que permiten generar una representación del plan de ejecución en formato XML o texto, respectivamente. Además, SHOWPLAN_ALL muestra información completa sobre el plan de ejecución.

Cuando se activa este permiso, SQL Server no ejecuta realmente la consulta, sino que devuelve un «plan estimado», describiendo cómo se procesaría la consulta en términos de operaciones lógicas y físicas.

Ventajas del permiso SHOWPLAN

El permiso SHOWPLAN tiene aplicaciones legítimas y valiosas en el desarrollo y mantenimiento de bases de datos. Entre sus principales beneficios, podríamos destacar los siguientes:

Identificación de problemas de rendimiento

 La principal utilidad del permiso SHOWPLAN es ayudar a identificar cuellos de botella en el rendimiento de las consultas. Tanto los administradores de bases de datos (DBAs) y desarrolladores podemos usar esta información para optimizar consultas, ajustar índices o rediseñar tablas. Por ejemplo, un plan de ejecución puede revelar que una consulta está realizando un «escaneo completo de tabla» (Table Scan) en lugar de usar un índice, lo que indica la necesidad de crear un índice o ajustar el predicado.

Análisis predictivo sin ejecutar consultas 

Con SHOWPLAN, es posible analizar cómo SQL Server ejecutaría una consulta sin necesidad de ejecutarla realmente. Esto es crucial cuando se trabaja con consultas que afectan grandes volúmenes de datos, ya que permite evaluar su impacto sin riesgo de sobrecargar el sistema.

Comparación de estrategias de consulta 

Los desarrolladores pueden usar SHOWPLAN para comparar alternativas de diseño de consultas. Por ejemplo, al evaluar si una subconsulta correlacionada es más eficiente que una JOIN, los planes de ejecución ayudan a elegir la mejor estrategia.

Herramienta educativa y formativa 

En entornos de desarrollo, SHOWPLAN también se usa para enseñar a nuevos DBAs y desarrolladores cómo optimizar consultas y comprender el comportamiento interno de SQL Server. Es una herramienta ideal para profundizar en cómo el optimizador toma decisiones.

Riesgos asociados al permiso SHOWPLAN

Aunque las ventajas de SHOWPLAN son innegables en manos de DBAs y desarrolladores, los riesgos emergen cuando este permiso se concede a usuarios fuera de estos roles o sin las medidas de seguridad adecuadas.

Exposición de datos sensibles 

Una característica poco conocida de SHOWPLAN es que los planes de ejecución pueden revelar los valores exactos de las variables o parámetros utilizados en las consultas. Aunque un usuario no tenga acceso directo a las tablas implicadas, podría deducir información confidencial a través del análisis del plan.

Por ejemplo si ves esta consulta en ejecución:

El plan de ejecución en XML mostrará que @Numero contiene un valor como 1234-5678-9012-3456, exponiendo información sensible. 

Mapeo de la estructura de la base de datos

Los planes de ejecución muestran detalles como nombres de índices, columnas y relaciones entre tablas. Un usuario malintencionado podría utilizar esta información para mapear la estructura de la base de datos y diseñar ataques dirigidos, como inyecciones SQL más efectivas o extracción de datos. 

Imagina que alguien, gracias a técnicas de SQLi es capaz de vulnerar la seguridad de tu app y llegar a la base de datos. Si el usuario de la aplicación tiene más permisos de los estrictamente necesarios el daño puede ser gravísimo.

Ingeniería inversa de estadísticas 

Los planes de ejecución contienen estadísticas sobre cardinalidad y distribución de datos, lo que permite deducir patrones sensibles, como la cantidad de registros que cumplen ciertas condiciones. Esto podría facilitar ataques de análisis estadístico. Sumale a esto los anteriores peligros y tendrás el cóctel perfecto para una fuga inesperada de datos.

Uso en ataques de denegación de servicio (DoS)

Por último, pero no menos importante, un usuario malintencionado con acceso a SHOWPLAN podría diseñar consultas costosas que generen planes de ejecución extremadamente complejos, agotando recursos del servidor.

Mejores prácticas para mitigar los riesgos de SHOWPLAN

Para evitar que el permiso SHOWPLAN se convierta en un vector de ataque, es esencial adoptar un enfoque de seguridad robusto que contemple varias estrategias complementarias. En primer lugar, es imprescindible seguir el principio de menor privilegio, limitando el uso de este permiso exclusivamente a administradores de bases de datos (DBAs) y algunos desarrolladores, y exclusivamente en entornos de desarrollo o pruebas. En producción, el acceso debe ser excepcional y estrictamente controlado.

Cuando se trabaja con bases de datos reales en entornos de prueba, la anonimización o el enmascaramiento de datos son medidas clave para evitar la exposición accidental de información sensible. Esta práctica protege los datos al tiempo que permite un análisis seguro del rendimiento de las consultas.

Además, las auditorías regulares resultan fundamentales para identificar usuarios que dispongan de permisos sensibles como SHOWPLAN. Herramientas nativas como Extended Events en SQL Server pueden facilitar el rastreo y análisis del uso de este permiso, asegurando un monitoreo constante de posibles accesos indebidos.

Por último, la formación continua de los equipos de desarrollo y administración es un pilar esencial. Educar a los responsables sobre los riesgos asociados al uso indebido de permisos sensibles y las mejores prácticas para gestionarlos garantiza que las concesiones innecesarias puedan evitarse de manera efectiva, fortaleciendo así la postura de seguridad general del entorno.

Conclusión

El permiso SHOWPLAN es una gran herramienta para la optimización de consultas y el análisis del rendimiento en SQL Server, pero su mal uso puede comprometer la seguridad de los datos. Concederlo sin restricciones puede exponer datos sensibles, facilitar ataques y comprometer la integridad del sistema.

Para evitar estos riesgos, es esencial adoptar un enfoque de seguridad proactiva, restringiendo su uso a roles específicos, monitoreando su aplicación y utilizando alternativas seguras cuando sea posible. De esta manera, podemos aprovechar las ventajas de SHOWPLAN sin comprometer la seguridad de nuestras bases de datos. Como siempre, en SQL Server, un enfoque basado en “confianza cero» (Zero Trust) es la mejor política.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

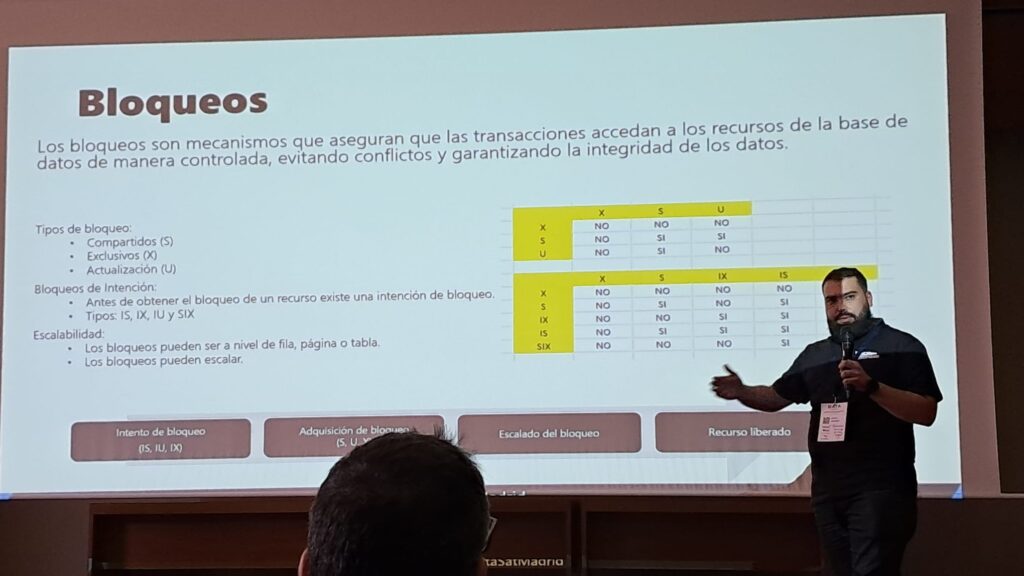
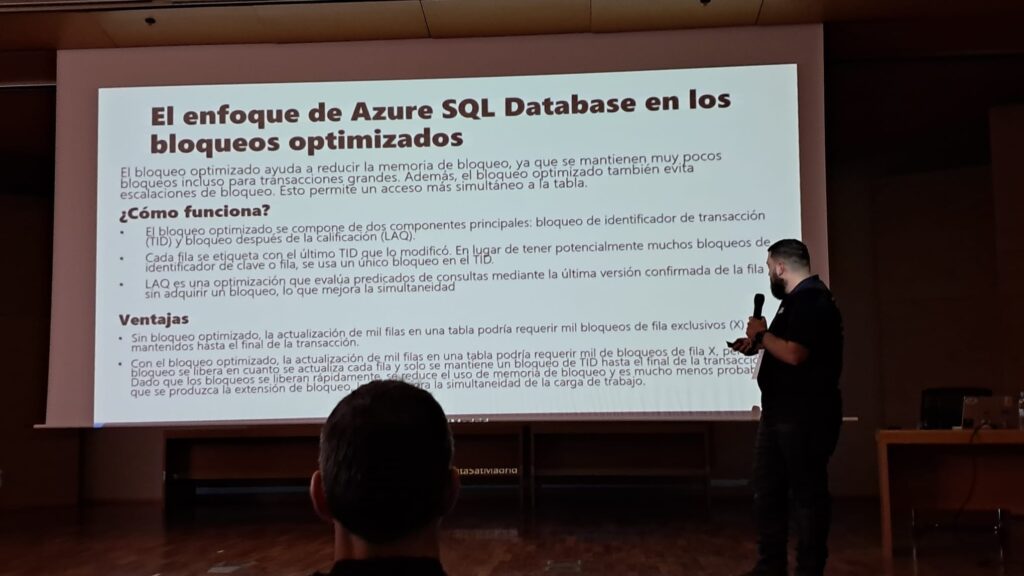
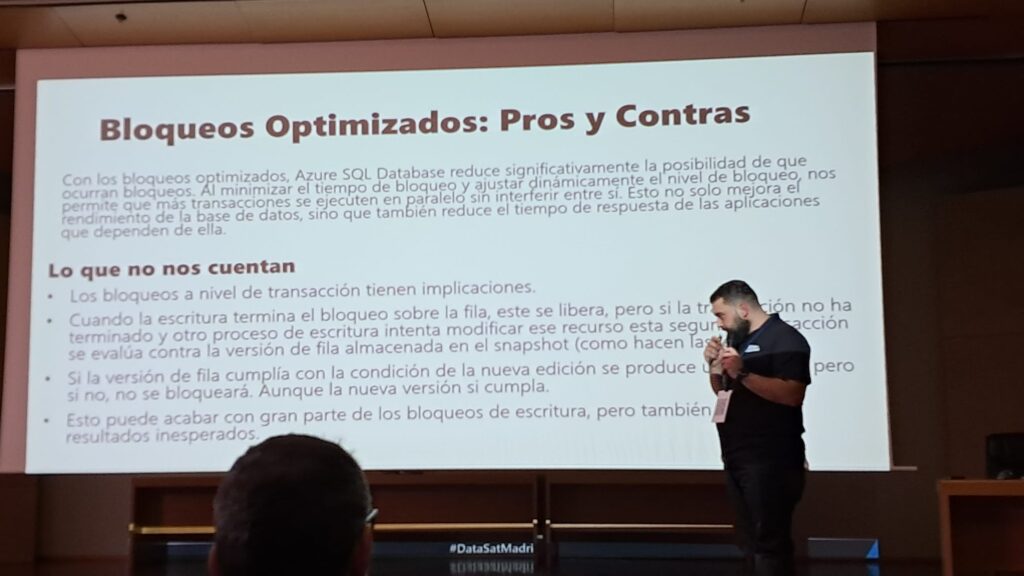
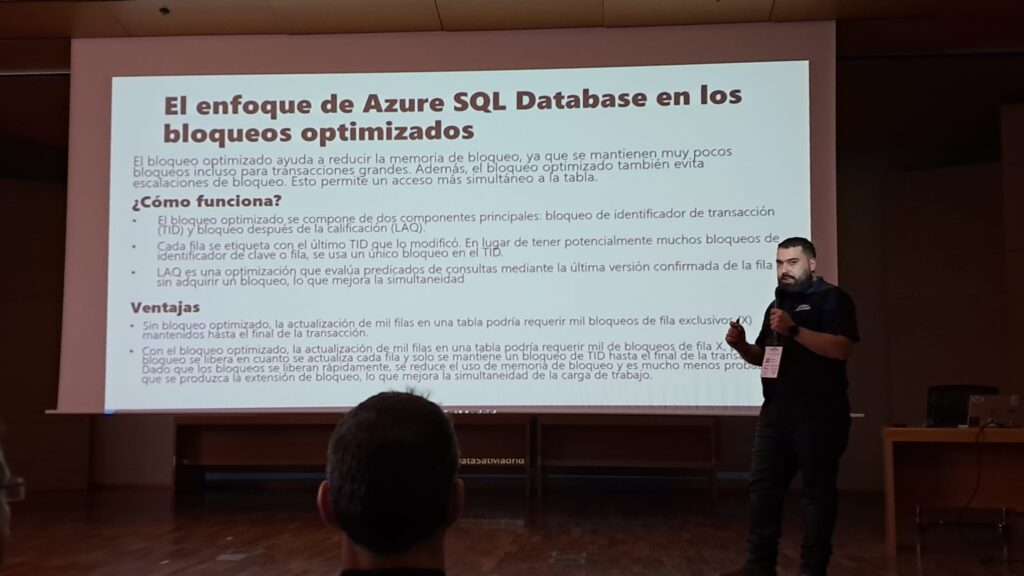
Mi Data Saturday 2024

El Data Saturday Madrid 2024 ha terminado, pero yo aún estoy asimilando todo lo que pasó.

No quería estar nervioso, había trabajado mucho en mi sesión y lo tenía todo preparado. Así confiaba en poder asistir a las distintas sesiones que había marcado en la agenda como imperdibles (spoiler no fue así pero, ahora os cuento más 😅 )

Llegué temprano, a las 8:30am estaba allí, fui directo a la sala de speakers a dejar las cosas y saludar a los compañeros. Tras los abrazos pertinentes, antes de tener que ir al auditorio a la bienvenida y posterior Keynote dedico unos minutos a encender el portátil, probar la conexión wifi de la universidad y primera sorpresa, no consigo conectar con mi base de datos de Azure SQL Database con la que iba a hacer la demo. 😨 No hay tiempo para más, es hora de iniciar el evento en el auditorio, luego solucionaré esto y si no se puede recurriré al plan B (llevaba la demo grabada de casa).

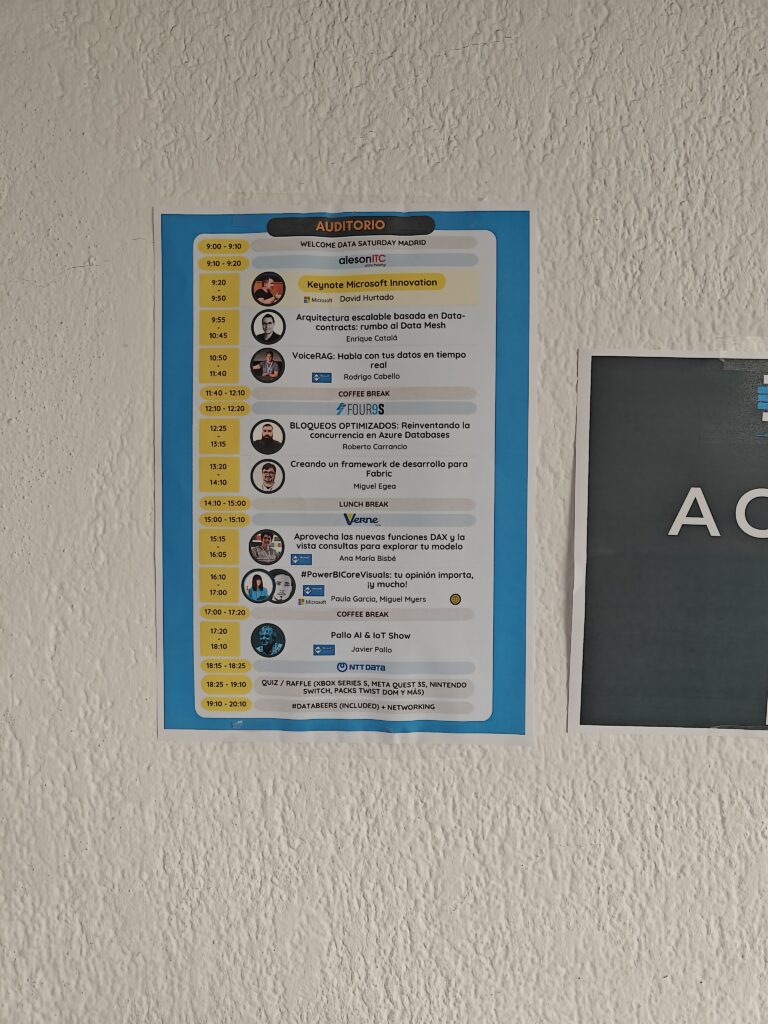
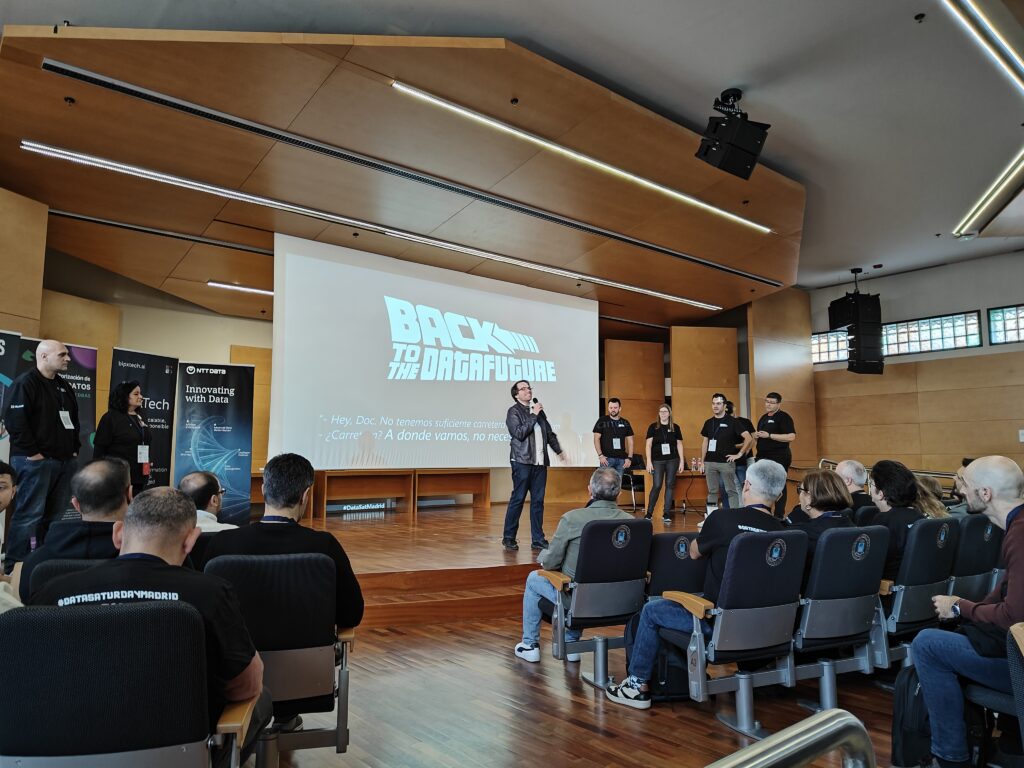
Ya en el auditorio saludo a Héctor, Santiago y Yolanda y tomo asiento para empezar a disfrutar del evento. Ruben Pertusa nos da la bienvenida. No os voy a mentir, ver mi cara en la pantalla junto a todo el resto de speakers, hizo que por un momento me invadiese la emoción y olvidase que en ese momento, tras las pruebas de antes, estaba sin demo. Sin tiempo para levantarnos de nuestros asientos turno para la presentación de uno de los sponsor del evento, Aleson ITC que nos enseñan todas las cosas maravillosas que hacen por y para sus clientes. Todo seguido, a continuación la Keynote de David Hurtado Torán.

Tras esta primera parte mi idea inicial era haber ido a ver a Jose Manuel Jurado Diaz y Juan E. Moreno Romo pero no fue posible, tenía que volver a la sala de speakers a tratar de solucionar mi problema de conexión. Por suerte no fue dificil, era cosa de la conexión de la UPM y con la VPN a casa conectada todo funcionaba a las mil maravillas. Aprovecho el resto del tiempo hasta la siguiente sesión para repasar las notas de mi sesión y a por otra cosa.

Llega el momento de la segunda charla, esta si que no me la pierdo. El gran Niko Neugebauer (Product Manager de Azure SQL MI) nos cuenta todos los secretos sobre la monitorización de Azure SQL Managed Instance en su charla «Azure SQL Observability». Muchas cosas que contar sobre esta charla pero esto requiere de un artículo dedicado en el blog, ya llegará.

En este punto toca el primer descanso, es hora de tomar un café y, junto con Niko, nos dirigimos a la cafetería. Con un vaso de café en la mano toca volver a la sala de speakers y ahora si preparar todo, soy el siguiente. En este punto no me preguntéis que pasó pero todo lo que había funcionado antes ya no va. El portátil no se volvió a conectar a la red de la UPM y ya no hay tiempo, toca compartir los datos del móvil.

Vuelve Niko a la sala de ponentes y comenzamos a charlar sobre mi sesión que va a empezar en apenas 10 minutos, le cuento un poco de lo que voy a hablar y, sorprendido, me pide un poco de tiempo para consultar su documentación sobre el tema, pero por desgracia tengo que irme a mi sesión que ya va a empezar, charlando nos habíamos comido todo el tiempo de la presentación de Four9s y me la he perdido 😖

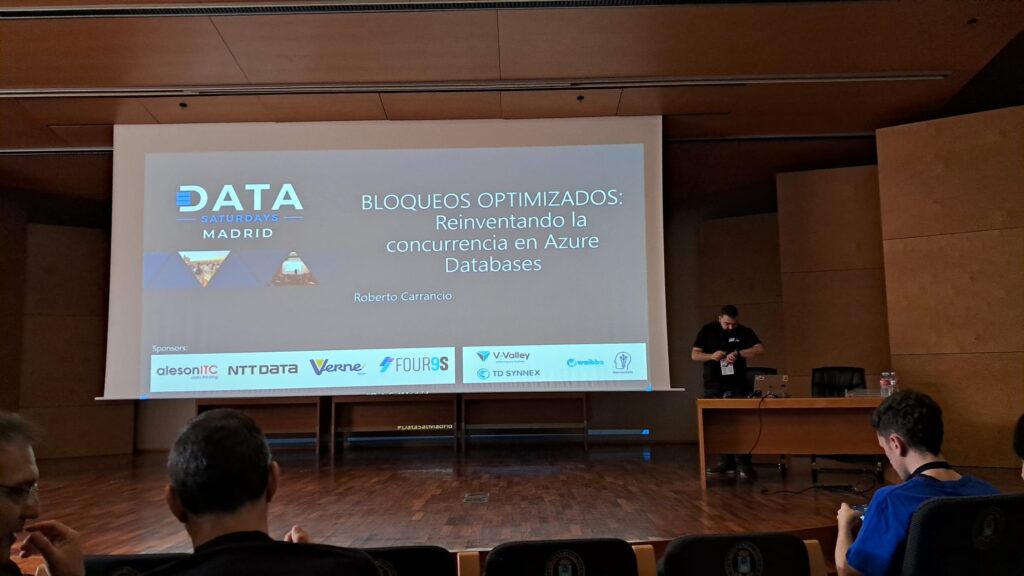
Es mi momento, subo al escenario y busco caras conocidas entre el público, decenas de personas están ya sentadas esperando a que empiece a hablarles. Rápidamente localizo a Hector, Santi y Yolanda que están ahí apoyándome. Localizo otras caras conocidas más de algunos seguidores y eso me da tranquilidad, todo va a salir bien, estamos entre amigos. Aunque tener a Jose Manuel y a Juan de Microsoft en primera fila contrasta un poco con ese sentimiento, la verdad. Tenia mucha presión no os voy a engañar. Esperamos unos minutos, que me parecieron horas, a que termine de llegar la gente y empezamos.

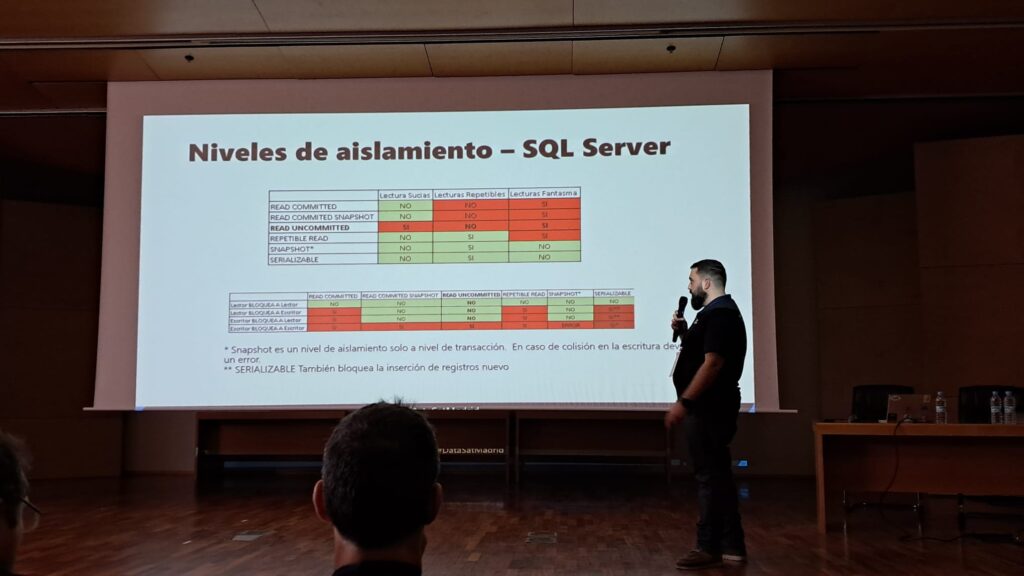
La charla fue perfecta, todo salió bien y las demos funcionaron bien (aunque despacito, lo normal usando la suscripción gratis de Azure, no nos engañemos). Los asistentes estaban sorprendidos con lo que mostraba sobre el escenario y eso siempre gusta. Para terminar varias preguntas de los asistentes y un aplauso que me hizo sentirme una estrella.

A la salida de mi charla Niko estaba esperándome, se me acercó y me dijo «tengo respuestas». Mientras yo daba mi charla, él había contactado con los ingenieros de Azure MI y había consultado toda la documentación interna de Microsoft sobre los bloqueos optimizados para todas las futuras versiones que están por venir (Azure MI y SQL Server 2025). Lo que me contó también los contaré en otro artículo. Por ahora toca esperar. Lo que os puedo contar es que charlamos por más de media hora, prácticamente todo el tiempo de la sesión de Cristina Tarabini-Castellani Ciordia, otra que me perdí (lo siento Cris).

Momento de la comida, ya había pasado mi parte y era hora de disfrutar al 100% del evento sin preocupaciones por mi charla. Durante la comida pude compartir «mesa» y un rato agradable con el gran Javier Menendez Pallo, que, para los que no le conocéis, aparte de un tipo listísimo es muy, pero muy, gracioso. No tengo mucho más que destacar de este rato de la comida, solo agradeceros a todos los que os acercasteis a felicitarme por mi charla y a charlar un rato.

Saliendo de la comida, por los pasillos coincido con Jose Manuel y Juan, los ingenieros de soporte de Microsoft que estaban en mi charla en primera fila. Dediqué unos minutos a una charla maravillosa con ellos sobre lo que había expuesto en mi presentación y a comentar los resultados de las demos que tanto sorprendieron al público. Para mi sorpresa alguna cosilla hasta les sorprendió a ellos.

Del resto del día poco más que contar, dediqué las siguientes horas a charlar con amigos. Me llevo una charla maravillosa con Ricardo Rincón, Francisco Mullor Cabrera, Inés Pascual Iglesias y Rubén Pertusa y el volver a coincidir con Pablo Lozano que hacía años que no nos veíamos. Cerramos el evento con el espectáculo, digo la charla, de Pallo y pasamos al divertido cierre del evento con el quiz y los sorteos de los regalos. Tomamos unas cervezas charlando con unos y con otros y para finalizar el día nos fuimos a cenar. Un cierre a la altura de un día espectacular tomando cervezas con Adrián Alvarez Molina, Frank Geisler y Olivier Van Steenlandt.

Para terminar os dejo unas cuantas fotos del evento.

Publicado por Roberto Carrancio en Otros, 0 comentarios

Fabric Lakehouse vs Warehouse

Comparar Fabric Lakehouse y Fabric Warehouse dentro del ecosistema de Microsoft Fabric nos lleva a analizar dos enfoques arquitectónicos que, aunque comparten una base tecnológica común, se diseñan para resolver problemas muy diferentes. Ambas soluciones surgen como respuesta a la necesidad de gestionar datos en un panorama empresarial cada vez más complejo, pero destacan por sus diferencias en flexibilidad, rendimiento y casos de uso.

Para empezar, debemos saber que Microsoft Fabric utiliza Delta Lake como formato de tabla unificado tanto para los componentes de Lakehouse como para los Warehouses. Las tablas Delta son esencialmente archivos Delta Parquet, un formato de código abierto compatible con la mayoría de las soluciones de otras nubes. Esto permite un acceso sin problemas a los datos en todos los motores de proceso de Microsoft Fabric y también entre diferentes nubes como Google, AWS, IBM, etc.

Por lo tanto, aunque los Warehouses en Microsoft Fabric pueden tener algunas similitudes con las bases de datos SQL tradicionales que tan bien conocemos, también tienen muchas características en común con los Lakehouses, incluyendo el uso de tablas Delta Parquet. Pero, entremos un poco más en detalle.

¿Qué es Fabric Lakehouse?

Fabric Lakehouse es una solución híbrida que combina lo mejor de los data lakes y los data warehouses. Este modelo permite gestionar datos estructurados, semiestructurados y no estructurados en un entorno único y flexible. Su arquitectura está basada en tecnologías de almacenamiento de objetos, como Delta Lake, optimizadas para trabajar con grandes volúmenes de datos en formatos diversos como Parquet, CSV y JSON.

Su enfoque permite a las empresas procesar datos en bruto, realizar análisis exploratorios y aplicar modelos avanzados como machine learning, sin necesidad de transformaciones estrictas previas. Por esta razón, Fabric Lakehouse es ideal para casos en los que se manejan datos históricos, flujos de datos en tiempo real o múltiples fuentes heterogéneas.

Fabric Warehouse: Optimización para consultas estructuradas

Fabric Warehouse, por su parte, representa el enfoque más tradicional de los almacenes de datos. Diseñado para cargas de trabajo analíticas OLAP, este modelo almacena los datos en un formato tabular estructurado que facilita consultas rápidas y eficientes. Su base tecnológica incluye índices columnstore que aceleran significativamente el tiempo de respuesta en análisis complejos.

Fabric Warehouse se destaca en escenarios de reporting empresarial, donde la precisión y la rapidez son fundamentales. Además, su integración nativa con herramientas como Power BI y Excel lo convierte en una elección prioritaria para la generación de informes y dashboards operativos.

Diferencias entre Fabric Lakehouse y Warehouse

Aunque ambos modelos comparten objetivos relacionados con la gestión de datos, presentan diferencias importantes en cuanto a flexibilidad, rendimiento y casos de uso.

Flexibilidad en el manejo de datos

Fabric Lakehouse ofrece un enfoque más versátil, permitiendo trabajar con datos en su estado original sin transformaciones previas. Esto es crucial en proyectos donde los datos cambian constantemente o provienen de múltiples fuentes con formatos variados. Por otro lado, Fabric Warehouse requiere un modelo de datos predefinido y procesos ETL claros para garantizar la eficiencia en el análisis.

Rendimiento en consultas y análisis

En términos de rendimiento, Fabric Warehouse sobresale en escenarios donde se necesitan consultas estructuradas y rápidas sobre datos optimizados. En cambio, Fabric Lakehouse es más adecuado para procesar grandes volúmenes de información y ejecutar análisis avanzados, aunque puede ser menos eficiente para consultas pequeñas.

Integración con herramientas de análisis

Fabric Lakehouse se integra de manera natural con entornos de Big Data y plataformas como Apache Spark, lo que lo hace ideal para análisis exploratorio y aprendizaje automático. Fabric Warehouse, por su parte, está optimizado para herramientas de BI tradicionales, siendo la opción preferida para usuarios de Power BI y Excel.

Endpoints de Fabric. La principal diferencia

Hasta ahora hemos estado viendo las definiciones más comerciales y las diferencias teóricas entre ambos sistemas. Vamos ahora con algo que va a marcar la diferencia entre ambas soluciones, los endpoints o puntos de conexión (me niego a llamarlos puntos finales como me niego a llamar tejido a fabric). Estos endpoints son los extremos finales de nuestros lakehouse y warehouse a los que nos vamos a conectar y vamos a ver que hay 3 tipos principales.

Lakehouse Endpoint para Spark Runtimes/Libraries

Para trabajar con archivos y tablas de Lakehouse, ya sea para análisis, transformaciones o procesamiento usando Spark, nos conectaremos al endpoint del Lakehouse que está separado del endpoint de SQL Analytics. Igual que con los métodos estándar fuera de Fabric para trabajar con archivos y tablas delta, para conectarnos, usaremos la URL, la ruta ABFS o montaremos el Lakehouse directamente en nuestro explorador. El uso de Spark nos permite realizar operaciones de escritura con Scala, PySpark, Spark SQL o R. Sin embargo, si deseamos utilizar T-SQL, deberemos utilizar SQL Analytics Endpoint, donde vamos a ver que solo podemos realizar operaciones de “solo lectura”.

SQL Analytics Endpoint (Lakehouse)

El endpoint SQL Analytics se crea automáticamente cuando creamos un Lakehouse. Cada Lakehouse tiene solo un endpoint SQL y, como cada Workspace o Área de Trabajo de Fabric puede tener más de un Lakehouse, la cantidad de endpoints SQL en un espacio de trabajo coincide con la cantidad de Lakehouses que tengamos.

Estos endpoint nos ofrecen una experiencia SQL para leer tablas Delta. Es importante destacar que este Endpoint es solo lectura y únicamente sirve para las tablas, como es lógico no podremos usar SQL para consultar archivos e información no estructurada. Por algo la S de SQL significa Structured, ¿no? 

Esto no es todo, SQL Analytics Endpoint no solo nos permite analizar las tablas Delta utilizando T-SQL, también vamos a poder guardar funciones, generar vistas y aplicar seguridad a nivel de objetos SQL. Gracias a estas funcionalidades los ingenieros de datos podrán crear una capa relacional sobre los datos físicos en Lakehouse, y exponerlos para que los analistas usen sus a herramientas de informes utilizando una cadena de conexión SQL.

Ya que estos endpoint son solo lectura, la creación/modificación de tablas Delta (y los datos dentro de las tablas Delta) se debe hacer usando Apache Spark. Una vez creadas las tablas Delta con Spark dentro de Lakehouse se podrán ver y leer automáticamente a través del endpoint SQL. ¿Y qué pasa si hay tablas Delta externas creadas con código Spark? Estas tablas no serán visibles desde el endpoint SQL hasta que cree un acceso directo o Shortcut a la tabla Delta externa.

Seguridad en el SQL Endpoint de Fabric Lakehouse

Como hemos visto, podemos configurar la seguridad a nivel de objeto (OLS) para acceder a los datos mediante el punto final de análisis SQL. Sin embargo, es importante destacar que estos permisos solo se aplicarán cuando accedamos a los datos a través endpoint de análisis SQL. Si deseamos asegurar que no se pueda acceder a nuestros datos de otras maneras (a través de diferentes endpoints o directamente), debemos establecer roles y permisos en el Área de Trabajo.

Conexión al SQL Analytics Endpoint

Para esta parte del artículo me voy a basar en este del blog de Microsoft publicado por Marc Bushong y voy a tomar prestadas sus fotos.

Dejadme que antes de nada os enseñe su Área de Trabajo de Fabric. Como veis tiene un Lakehouse llamado “BronzeLakehouse” y, en la imagen, podemos ver el endpoint de SQL Analytics (rojo) y el endpoint de Lakehouse (verde)

Accediendo al endpoint de Lakehouse vemos Files (rojo) y Tables Delta (verde). Si queremos asegurarnos, en la esquina superior derecha veremos un menú desplegable con el endpoint estamos viendo seleccionado.

Si cambiamos la vista al Endpoint de SQL Analytics vais a ver que ya solo podemos ver las tablas:

Antes de pasar al siguiente endpoint tenemos que saber que también podemos conectar al endpoint SQL desde fuera de Fabric con las herramientas que conocemos como SSMS o Azure Data Studio. Simplemente tendremos que poner la autenticación y cadena de conexión del endpoint como si de cualquier otra conexión de servidor SQL se tratara.

Data Warehouse Endpoint

El Data Warehouse Endpoint opera como un DWH SQL en un entorno tradicional. Esto significa que proporciona compatibilidad casi total con T-SQL, de manera similar a una base de datos SQL Server implementada en nuestros servidores. Este endpoint ofrece múltiples ventajas funcionales.

T-SQL de lectura y escritura

Entre estas ventajas funcionales podemos destacar que cuenta con soporte para lectura y escritura en tablas Delta, lo que permite consultar los datos tanto con Spark como con T-SQL. Sin embargo, mientras que en el Lakehouse las operaciones de escritura solo se podían realizar con Spark, en el Warehouse es al revés y únicamente pueden realizarse mediante T-SQL. Además, incluye soporte casi completo para operaciones DML y DDL, lo que abarca la ingesta, el modelado y el desarrollo de datos a través de T-SQL o mediante interfaces gráficas. Esto nos permite un control absoluto sobre la creación de tablas, la carga de datos y las transformaciones, utilizando herramientas como COPY INTO, pipelines, dataflows o métodos de ingesta cruzada entre bases de datos como CREATE TABLE AS SELECT (CTAS), INSERT..SELECT o SELECT..INTO. Solo hay una pega, a día de hoy todavía no es compatible con la sintaxis MERGE.

Soporte ACID

Este endpoint también garantiza el cumplimiento de las propiedades ACID para transacciones aunque trabaje con tablas Delta. Cabe destacar que, aunque Lakehouse ofrece compatibilidad ACID, se limita a las tablas Delta, por lo que los ficheros de un Lakehouse podrían no cumplir con estas propiedades.

Transacciones Multitabla

Otra característica es el soporte para transacciones que abarcan múltiples tablas, lo que facilita flujos de trabajo complejos. Al combinar estas capacidades de lectura/escritura con las herramientas de ingesta entre bases de datos, es posible integrar datos sin complicaciones desde varios Warehouses o Lakehouses. Cuando se ingieren datos en el Warehouse, estos se almacenan automáticamente en formato Delta dentro de OneLake, garantizando una estructura optimizada y unificada.


En la siguiente imagen podemos ver todo lo que hemos comentado hasta ahora en acción, una consulta entre bases de datos para cargar datos en el Warehouse desde el Lakehouse, donde se crea y se carga la tabla de Warehouse «holiday.Warehouse_Holiday_Clean» con los datos de la tabla «Silverlakehouse.dbo.Holiday_Clean» del Lakehouse como origen, y luego se muestran los registros.

Conclusión

Para cerrar esta comparativa, queda claro que tanto Fabric Lakehouse como Fabric Warehouse son piezas fundamentales en el ecosistema de Microsoft Fabric, cada uno respondiendo a diferentes necesidades en el manejo y análisis de datos. A través de su integración en OneLake, ambas soluciones permiten un acceso uniforme y una gestión eficiente de los datos, aprovechando las ventajas de las tablas Delta como formato unificado.

La verdadera innovación radica en cómo Microsoft Fabric ofrece puntos de conexión (endpoints) especializados para cada solución. Estos endpoints no sólo habilitan el acceso a los datos según las necesidades específicas de cada modelo, sino que también permiten combinar diferentes entornos de datos en operaciones cruzadas, como lo demuestra la imagen adjunta. Aquí vemos cómo los endpoints para Lakehouse y Warehouse trabajan en conjunto, integrando datos de manera fluida y demostrando el poder de esta arquitectura unificada.

Este enfoque, que facilita tanto la conexión como el intercambio de datos entre sistemas, posiciona a Microsoft Fabric como una solución robusta y flexible para las necesidades actuales de la analítica empresarial.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Power BI, 0 comentarios

Replicar datos de SQL a Fabric

Mucho hemos hablado en el blog de como pasar datos de SQL Server en local a la nube, o de la nube a local. Sin embargo, siempre nos hemos centrado en el ecosistema de SQL Server y Azure SQL que, con pequeñas diferencias, cubren las mismas necesidades. Pero, ¿qué pasa si lo que necesitamos es pasar nuestros datos de SQL recurrentemente a un servicio SaaS en la nube para ciencia y análisis de datos?. Eso es lo que vamos a ver hoy, cómo pasar nuestros datos de SQL Server a Fabric ya sea a un Lakehouse o a un Datawarehouse.

Fabric lakehouse vs Datawarehouse ¿qué son?

Al hablar de Fabric, uno de los primeros pasos cruciales es entender sus componentes principales para el almacenamiento de los datos, el Lakehouse y el DataWarehouse. Aunque realmente todo lo que almacenemos en Lakehouse o en Datawarehouse va a estar almacenado en el mismo sitio, nuestro Onelake, por encima de esa capa pura de almacenamiento tendremos que decidirnos por una de las dos estrategias anteriores de gestión de los datos. Puede parecer trivial, incluso en muchas ocasiones se confunden o se utilizan indistintamente pero, la realidad es que cada uno tiene características y funciones específicas dentro de un entorno de ciencia de datos y análisis en la nube. Estas particularidades van a ser claves a la hora de trabajar con ellos por lo que es importante que tengamos claro cuál va a ser nuestro destino antes de plantear el método de envío de datos.

Fabric Datawarehouse

Fabric Datawarehouse es una solución de almacenamiento de datos que integra las capacidades de un data warehouse tradicional con la flexibilidad de un data lake. Gracias a esta arquitectura podremos almacenar, procesar y analizar grandes volúmenes de datos estructurados y semiestructurados en un entorno unificado, lo que nos facilitará la gestión y el análisis de la información.

Una característica distintiva de Fabric Datawarehouse es su almacenamiento centrado en el lago de datos (One Lake), basado en el formato abierto Delta Lake. Este enfoque nos permite hacer uso de transacciones ACID y una interoperabilidad fluida con otras cargas de trabajo de Fabric, eliminando la necesidad de múltiples copias de datos y garantizando la consistencia y confiabilidad de la información. Además su punto de conexión SQL nos va a permitir consultar y manipular datos con código T-SQL 

Fabric Lakehouse

Fabric Lakehouse es una arquitectura de datos integrada en Microsoft Fabric que combina las funcionalidades de un data lake con las capacidades de un data warehouse. Esta estructura nos permite almacenar, procesar y analizar grandes volúmenes de datos no estructurados, semiestructurados y estructurados en un solo entorno, simplificandonos la gestión y el análisis de los datos.

El concepto de lakehouse en Fabric fusiona la escalabilidad y flexibilidad de un datalake, donde se puede almacenar información en su formato nativo, con el rendimiento y las capacidades analíticas de un data warehouse, facilitando la ejecución de consultas SQL de lectura directamente sobre los datos sin necesidad de moverlos. Fabric Lakehouse soporta el uso de diversos lenguajes de consulta y herramientas de análisis, como SQL, Spark y Power BI, proporcionando un entorno colaborativo y unificado.

Además, Fabric Lakehouse utiliza Delta Lake, que añade un nivel de transaccionalidad y consistencia a los datos almacenados, algo crucial en entornos de análisis donde la integridad de los datos es prioritaria. Delta Lake permite realizar lecturas y escrituras simultáneas y asegura la disponibilidad de datos limpios y consistentes para el análisis.

Enviar datos de SQL a Fabric

Bien, ahora que ya hemos decidido cual de los sistemas tenemos en destino vamos a ver las posibilidades de sincronización que tenemos para los datos de SQL. Vamos a centrarnos principalmente en dos herramientas, los Dataflows gen 2 y los pipelines.

Dataflows Gen2

Los Dataflows Gen2 son una opción no-code que nos permite llevar a Fabric datos de casi cualquier origen. Son una evolución de los Dataflows de Power BI, con un aspecto similar pero, con una gran diferencia, permiten seleccionar el destino. Gracias a esta funcionalidad vamos a poder usarlos para llevar nuestros datos de SQL o Azure SQL a Fabric, ya usemos Lakehouse o Datawarehouse, sin problema.

Para crearlo, simplemente accederemos a la interfaz de Dataflows Gen2 dentro del menú de Data Factory y, a través de la interfaz gráfica seleccionaremos nuestro origen, ya sea Azure SQL o una puerta de enlace previamente configurada con la conexión a SQL Server. A partir de aquí, podremos seleccionar las tablas o vistas que replicar y aplicar transformaciones, siempre cuidando de no romper el plegado de consultas o lo notaremos en el rendimiento.

Pipelines

Los pipelines son otra alternativa sencilla y no-code para la copia de datos, aunque tienen un inconveniente. Si bien es teóricamente posible usarlo para transferir nuestros datos desde SQL Server hacia Fabrik Lakehouse o Datawarehouse, lo cierto es que hacia este último destino va a requerir de una serie de pasos adicionales que complican el proceso hasta hacer que no sea recomendable, al menos en mi opinión. 

Entonces, si vas a trabajar con Fabric Lakehouse la cosa es simple, abres Pipelines desde la misma ventana de Data Factory que hemos comentado antes y practicamente sigues el asistente. Te va a pedir el origen (tu Azure SQL o tu puerta de enlace con la conexión a SQL Server, igual que antes), la tabla o consulta que se va a replicar y el destino con su tipo de datos para cada columna.

Bonus track: Fabric Mirroring, Shortcuts y Notebooks

Los que conocéis el ecosistema de Fabric sabéis que además de Dataflows Gen2 y Pipelines tenemos disponibles otras herramientas como son los mirroring shortcuts y Notebooks. Veamos qué podemos hacer con ellas.

  • Shorcuts: Igual que los accesos directos a los que estamos acostumbrados en nuestros sistemas operativos de Windows, los shortcuts en Fabric nos permiten leer información de otras fuentes sin tener que copiarlas a nuestro One Lake. Suena bien, ¿verdad? Pues es muy bonito pero, lamentablemente no están implementados ni para SQL Server ni para ninguna solución de SQL en la nube.
  • Notebooks: Los cuadernos (notebooks) son la principal herramienta de integración y manipulación de datos en Fabric. Sin embargo, no son compatibles con orígenes de una puerta de enlace por lo que solo podremos usarlos para copiar datos desde orígenes Azure SQL ya sean Managed Instance o bases de datos sin servidor.
  • Mirroring: He dejado lo mejor para el final. Mirroring es una nueva funcionalidad que promete replicar nuestras bases de datos SQL a Fabric. Sin embargo, aún está en Public Preview y solo para orígenes Azure SQL Database (bbdd sin servidor). Esperemos en un futuro cercano verlo en GA para todos los orígenes SQL Server.

Conclusión

Migrar datos de SQL Server a Microsoft Fabric abre un mundo de posibilidades para el análisis avanzado en la nube. Con herramientas como Dataflows Gen2 y Pipelines, podemos transferir datos de manera eficiente y sin código hacia entornos unificados de Fabric, eligiendo entre el Lakehouse, ideal para datos en formatos variados, y el Data Warehouse, optimizado para consultas estructuradas. Fabric facilita la gestión y transformación de datos en un entorno SaaS seguro, apoyado en OneLake y Delta Lake, que garantizan consistencia y escalabilidad. Así, centralizamos el análisis y optimizamos el rendimiento, aprovechando todo el potencial de nuestros datos en la nube.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Power BI, SQL Server, 0 comentarios

Puertas de Enlace Power BI y Fabric

En el análisis de datos con Power BI o Fabric, las puertas de enlace juegan un papel fundamental. Son el puente que nos permite conectar de forma segura y eficiente los servicios en la nube de Microsoft con los datos locales de nuestra organización. Estas herramientas facilitan la comunicación entre los sistemas internos y Power BI, garantizando que los datos estén siempre actualizados y disponibles para análisis en tiempo real. Sin embargo, las puertas de enlace no solo son esenciales para Power BI; también pueden integrarse con Microsoft Fabric, potenciando los flujos de trabajo avanzados y las capacidades de procesamiento en paralelo. Este artículo se inspira en los artículos de Toni Jurado en explorandodatos.com, quien ha profundizado en las características esenciales y las mejores prácticas de las puertas de enlace en Power BI, y busca añadir una perspectiva integral sobre su uso y consideraciones técnicas. 

¿Qué es una puerta de enlace de Power BI y Microsoft Fabric?

Las puertas de enlace de Power BI y Fabric son un componente de software (programa) que se instala en nuestros servidores locales y que permiten a los servicios en la nube de Microsoft conectarse de manera segura a los datos almacenados en nuestras instalaciones on-premises. Esto es especialmente valioso para las empresas que, por razones de seguridad o privacidad, no desean o no pueden migrar sus datos sensibles a la nube. La puerta de enlace actúa como un intermediario, procesando solicitudes de datos y cifrando la comunicación entre la fuente local y el servicio en la nube, asegurando así la privacidad y protección de la información.

En la práctica, la puerta de enlace permite realizar transformaciones y filtrados de datos en el entorno local, reduciendo el volumen de datos que se envía a la nube. Esto optimiza el uso del ancho de banda de la red y mejora el rendimiento de las consultas en Power BI o Fabric. Sin embargo, este procesamiento requiere recursos en el servidor donde está instalada la puerta de enlace, lo que implica ciertas consideraciones técnicas a la hora de configurarla y mantenerla.

Tipos de puertas de enlace: Personal y Estándar

Existen dos tipos de puertas de enlace y, aunque las dos opciones sirven para enviar nuestros datos de los servidores locales a la nube de Power BI o de Fabric, tienen sus diferencias significativas. Tendremos que elegir una u otra en función de nuestras necesidades.

Puerta de enlace personal

Esta versión está diseñada para un único usuario y es ideal para casos de uso individual o pruebas rápidas. Permite conectar Power BI con fuentes de datos locales, pero está limitada a un solo usuario y no es adecuada para entornos de producción. No es compatible con los servicios de Microsoft Fabric.

Puerta de enlace estándar

Pensada para su uso en entornos de producción, esta puerta de enlace puede ser utilizada por múltiples usuarios y soporta una configuración avanzada para integrarse, además de con Power BI, con otros servicios, como Power Automate, Power Apps y Microsoft Fabric. Es ideal para empresas que manejan grandes volúmenes de datos y requieren análisis en tiempo real.

Es importante tener en cuenta que, aunque las puertas de enlace personales son útiles para usuarios individuales, en entornos de producción o con Microsoft Fabric se recomienda siempre utilizar las puertas de enlace estándar. Esto garantiza el soporte multiusuario, configuraciones avanzadas de balanceo de carga y alta disponibilidad, que son esenciales para entornos de análisis de datos complejos.

Uso de las puertas de enlace: Orígenes de datos compatibles

Una de las grandes ventajas de las puertas de enlace en Power BI y Fabric es su compatibilidad con una amplia variedad de orígenes de datos locales. Esto permite a las organizaciones integrar en sus análisis en la nube prácticamente cualquier sistema interno sin necesidad de migrar los datos a la nube, y manteniendo el control y la seguridad de la información. A continuación, os nombro algunos de los principales orígenes de datos locales que pueden conectarse a través de las puertas de enlace estándar:

Bases de datos relacionales

Entre los sistemas compatibles podemos encontrar SQL Server, Oracle Database, MySQL, PostgreSQL, DB2 y Teradata. Estos sistemas tienen la capacidad de plegar las consultas y nos permiten la conexión en modo DirectQuery, que consulta los datos en tiempo real, o en modo de importación, ideal para escenarios de carga periódica. Ambos modos facilitan el análisis sin necesidad de replicar todos los datos en la nube.

Fuentes de datos de archivos

Las puertas de enlace permiten el acceso a archivos de Excel, CSV, archivos de texto, XML y carpetas compartidas en red. Los datos de estos archivos pueden ser actualizados automáticamente para reflejar la última versión sin intervención manual. Esto es especialmente útil en entornos donde los datos se almacenan en archivos distribuidos en múltiples ubicaciones.

Sistemas de almacenamiento en la nube privada

Las puertas de enlace pueden conectar servicios de almacenamiento en la nube privada alojados dentro del entorno corporativo, incluyendo SAP HANA y SAP BW. Estos sistemas se encuentran en muchas grandes empresas, y la puerta de enlace asegura que los datos permanezcan en la red local mientras están disponibles para análisis en Power BI y Fabric.

Sistemas de información y aplicaciones empresariales

Power BI y Fabric permiten conectarse a sistemas como Microsoft Dynamics 365 on-premises y servicios OData, incluyendo SharePoint on-premises y otros servicios web empresariales. Estas integraciones son clave para empresas que utilizan sistemas empresariales complejos y desean incorporar datos de múltiples fuentes sin comprometer la seguridad.

Sistemas de mensajería y API REST

Las puertas de enlace también son compatibles con servicios que utilizan API REST, lo que permite integrarse con aplicaciones internas que exponen datos mediante servicios web. Esta opción ofrece flexibilidad para conectar sistemas personalizados de la organización.

Configuración de puertas de enlace en entornos de producción

La instalación y configuración de una puerta de enlace requiere ciertos conocimientos técnicos, especialmente en entornos de producción. Para instalar una puerta de enlace, debemos contar con un equipo (idealmente un servidor) que cumpla con los requisitos técnicos de Microsoft y que esté optimizado para manejar el flujo de datos y la carga de procesamiento.

Una vez instalada, la configuración de la puerta de enlace se gestiona desde el portal de administración de Power BI, donde podemos definir permisos de acceso a las fuentes de datos, configurar la autenticación de usuarios y programar las actualizaciones de datos. Las opciones de administración permiten a sus responsables controlar el acceso de los usuarios y gestionar los permisos para asegurar que solo personas autorizadas puedan acceder a los datos a través de la puerta de enlace.

Buenas prácticas para la instalación de puertas de enlace

Existen ciertas buenas prácticas recomendadas para optimizar el rendimiento y la seguridad de las puertas de enlace en entornos corporativos. A continuación, os comparto algunas consideraciones clave a tener en cuenta al instalar una puerta de enlace:

Separación de la puerta de enlace y el servidor de bases de datos

Aunque pueda parecer tentador, no es recomendable instalar la puerta de enlace en el mismo servidor donde reside la base de datos, ya que ambos servicios requieren recursos significativos. Si comparten el mismo servidor, podrían surgir conflictos de recursos en momentos de alta demanda, afectando la estabilidad y el rendimiento de ambos servicios. En su lugar, se recomienda instalar la puerta de enlace en un servidor dedicado que cuente con recursos suficientes para manejar la carga de trabajo de la puerta de enlace.

Ubicación en la misma subred

Para minimizar la latencia y optimizar el rendimiento de las transferencias de datos, es ideal que la puerta de enlace y el servidor de origen de los datos se encuentren en la misma subred. Esto permite una comunicación más rápida y reduce el riesgo de pérdida de paquetes de datos. Cuando la puerta de enlace y la base de datos están en diferentes subredes o ubicaciones, se puede experimentar una mayor latencia, lo cual afecta la eficiencia en el análisis de datos.

Ahora una recomendación personal. El tráfico de datos generado entre la puerta de enlace y un servidor de base de datos puede ser considerable lo que puede afectar al rendimiento de la red y verse afectado por otros usuarios de la red. Para estos casos la solución ideal es una subred aislada entre el servidor de bases de datos y la puerta de enlace. De este modo, nuestro servidor de bases de datos tendrá dos tarjetas de red, cada una en una red, una para el tráfico de los usuarios y otra exclusiva de comunicación con la puerta de enlace. Tampoco es raro encontrarnos en escenarios empresariales con una subred entre servidores aislada de los usuarios. En estos casos, deberéis valorar con los técnicos de redes si la puerta de enlace debe ir en esta red o en una dedicada.

Además, en entornos corporativos complejos, se recomienda aislar el tráfico de la puerta de enlace y la base de datos mediante VLANs independientes. Esta práctica no solo permite gestionar mejor el ancho de banda como acabamos de comentar sino que mejora la seguridad. La segmentación es particularmente importante cuando se trabaja con datos sensibles, ya que ayuda a cumplir con las normativas de privacidad y seguridad.

Balanceo de carga y alta disponibilidad

En organizaciones con grandes volúmenes de datos o con una alta frecuencia de actualizaciones, es recomendable implementar un clúster de puertas de enlace. Esto permite distribuir la carga de trabajo entre varias instancias, garantizando alta disponibilidad. En caso de que una puerta de enlace falle, otra puede asumir su carga, evitando interrupciones. El balanceo de carga es esencial cuando se trabaja con Microsoft Fabric, especialmente cuando usamos procesamiento de datos en tiempo real que requiere una infraestructura robusta y estable. Estos cluster de puertas de enlace solo los podremos hacer con puertas de enlace estándar, las personales no lo permiten.

Monitorización de recursos

Como la puerta de enlace realiza procesamiento de datos local, es importante monitorizar regularmente los recursos del servidor, como CPU, memoria y uso de red. Si detectamos un uso elevado de recursos, podríamos necesitar escalar la capacidad del servidor o migrar la puerta de enlace a un servidor con mayor capacidad para evitar problemas de rendimiento.

Consideraciones especiales para Microsoft Fabric

Con la integración de Microsoft Fabric, las puertas de enlace han ampliado su funcionalidad, permitiendo manejar flujos de datos más complejos y ejecutar análisis en tiempo real. En entornos de Fabric, es fundamental que la puerta de enlace tenga acceso a suficiente capacidad de procesamiento para soportar las demandas adicionales. Esto incluye configuraciones avanzadas para equilibrar la carga de procesamiento y distribuir las solicitudes de datos de forma eficiente. Además, como ya os he mencionado solo las puertas de enlace estándar son compatibles con Fabric, no vamos a poder usar una puerta de enlace personal.

Conclusión

Las puertas de enlace de Power BI y Microsoft Fabric son herramientas indispensables para las organizaciones que necesitan conectar sus datos locales con el servicio en la nube de forma segura y eficiente. Al permitir el procesamiento local de datos, las puertas de enlace optimizan el uso del ancho de banda y aseguran que solo los datos necesarios se transmiten a la nube, reduciendo la carga en la red y mejorando el rendimiento.

Este artículo y las ideas expuestas han sido inspirados en los artículos de Toni Jurado en explorandodatos.com, quien ha compartido valiosos conocimientos sobre el uso de puertas de enlace en Power BI. También os recomiendo el video sobre este tema del Power Quiz presentado por Ricardo Rincón y Diego jurado con Toni Jurado como quiz maker.

Espero que esta guía contribuya a un entendimiento más profundo de estas herramientas y a su implementación eficaz en entornos empresariales. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Power BI, SQL Server, 1 comentario