Rendimiento

Particionado en ReFS vs NTFS para SQL Server

Hace unos días surgió en nuestra comunidad de telegram un debate interesante sobre cual es el mejor particionamiento para SQL Server si NTFS o ReFS. Lo cierto es que al gestionar bases de datos SQL Server, la elección del sistema de archivos adecuado puede tener un impacto significativo en el rendimiento y la fiabilidad. Tradicionalmente, NTFS ha sido la opción por defecto en sistemas Windows, pero la llegada de ReFS (allá por 2012) ha planteado una alternativa interesante. En este artículo, voy a tratar de analizar las diferencias entre ReFS y NTFS para SQL Server, evaluando sus implicaciones en términos de rendimiento, integridad de datos y consumo de recursos.

NTFS: Un sistema probado y compatible

NTFS es el sistema de archivos más utilizado en Windows Server desde hace décadas. Ofrece estabilidad y un amplio soporte para características como la compresión de archivos, encriptación y la gestión eficiente de grandes volúmenes de datos. En el contexto de SQL Server, NTFS ha demostrado ser un sistema fiable y compatible, especialmente en entornos de producción donde se utilizan herramientas y utilidades estándar para la administración de discos y almacenamiento.

A nivel de rendimiento, NTFS puede enfrentar problemas cuando se manejan grandes volúmenes de datos o cuando las operaciones de entrada/salida (E/S) son intensivas. Su estructura jerárquica y los metadatos asociados pueden llegar a ser un cuello de botella en consultas complejas o bases de datos con altas transacciones. Además, NTFS es susceptible a la fragmentación de archivos, un problema que afecta al rendimiento a medida que las bases de datos crecen y se modifican. La desfragmentación, aunque útil, requiere tiempo y recursos adicionales.

ReFS: Ventajas y limitaciones para SQL Server

ReFS (Resilient File System) fue introducido por Microsoft como una alternativa más robusta a NTFS, con la promesa de mejorar la resiliencia ante la corrupción de datos y ofrecer un mejor rendimiento en operaciones de E/S intensivas. En teoría, ReFS presenta varias ventajas sobre NTFS, como la reducción de la fragmentación y una mayor tolerancia a errores, lo que lo convierte en una opción atractiva para gestionar volúmenes de datos grandes y sistemas de almacenamiento avanzado, como Storage Spaces.

Uno de los puntos fuertes de ReFS es su capacidad para gestionar grandes volúmenes de datos y evitar la fragmentación, algo que puede beneficiar significativamente a las bases de datos SQL Server que requieren muchas operaciones de lectura y escritura. Sin embargo, cuando hablamos de bases de datos, no es recomendable aprovechar la característica de integridad de datos automática de ReFS, ya que Microsoft sugiere desactivarla en estos entornos. El motivo es que SQL Server ya gestiona su propia integridad de datos mediante transacciones ACID y checksums, y permitir que ReFS realice correcciones automáticas podría interferir con estos mecanismos. Por tanto, la función de integridad de ReFS, que es una de sus principales fortalezas, no debe utilizarse en bases de datos SQL Server, limitando su aplicación en estos escenarios.

Consumo de recursos en ReFS

Otra consideración importante al usar ReFS es su mayor consumo de recursos en comparación con NTFS. Debido a las funcionalidades avanzadas de corrección de errores y gestión de volúmenes, ReFS tiende a utilizar más CPU y memoria. En entornos de bases de datos con cargas de trabajo intensivas, como es común en SQL Server, este mayor consumo puede reducir el rendimiento general del sistema, especialmente en servidores que ya están bajo una alta carga de procesamiento.

Si bien ReFS ofrece una mejor gestión de volúmenes grandes, debemos sopesar si el mayor uso de recursos del sistema compensa las mejoras en la resistencia y la fragmentación. En muchos casos, NTFS sigue siendo más eficiente, especialmente en servidores donde el hardware no es de última generación o donde el coste de la memoria y CPU es una preocupación.

¿Afecta a SQL Server la deduplicación de datos de ReFS?

La deduplicación de datos es una técnica de almacenamiento que consiste en identificar y eliminar bloques de datos duplicados para reducir el espacio necesario. En lugar de almacenar múltiples copias de la misma información, la deduplicación guarda una única versión de los bloques repetidos y crea referencias a estos desde otros archivos o ubicaciones.

En cuanto a la deduplicación de datos para SQL Server, es importante aclarar que SQL Server no se beneficia directamente de esta funcionalidad. Esto es porque las bases de datos de SQL almacenan información en bloques (páginas) con identificadores únicos, lo que implica que no hay bloques redundantes que puedan ser eliminados sin afectar la integridad de los datos. Por tanto, la deduplicación no se aplica a los archivos de bases de datos.

Sin embargo, es posible que en algunos escenarios se intente utilizar la deduplicación de ReFS para las copias de seguridad de bases de datos. En este contexto, la deduplicación podría ser útil para reducir el espacio de almacenamiento utilizado por las copias de seguridad, pero también introduce riesgos. Un entorno con deduplicación puede generar un único punto de fallo (SPoF), ya que si el mecanismo de deduplicación falla o se corrompe, podríamos perder acceso a múltiples copias de seguridad que dependen de los mismos bloques deduplicados. Por esta razón, no se recomienda utilizar deduplicación en entornos de SQL Server para los archivos de base de datos, y su uso en archivos de copia de seguridad debe evaluarse con cautela.

Comparativa final: NTFS vs ReFS

NTFS sigue siendo una opción sólida para la mayoría de entornos SQL Server, especialmente en servidores que manejan bases de datos de tamaño medio o pequeño. Su menor consumo de recursos, la compatibilidad con un amplio abanico de herramientas de terceros y su fiabilidad hacen que sea preferido en muchos casos. Aunque la fragmentación y la necesidad de mantenimiento son factores a tener en cuenta, NTFS ofrece un equilibrio robusto entre rendimiento y estabilidad, sin requerir un hardware excepcionalmente avanzado.

ReFS, por otro lado, tiene claras ventajas cuando gestionamos grandes volúmenes de datos en sistemas avanzados de almacenamiento, como en configuraciones con Storage Spaces. Su diseño reduce la fragmentación y permite una gestión más eficiente de los datos, lo que es útil en entornos con grandes archivos o volúmenes masivos de información. No obstante, la necesidad de desactivar su función de integridad de datos en bases de datos SQL Server y su mayor consumo de recursos limitan su aplicabilidad en escenarios de bases de datos tradicionales.

Para bases de datos críticas o transaccionales, donde la carga de trabajo y los recursos del servidor ya están optimizados para SQL Server, NTFS sigue siendo la opción preferida. Si bien ReFS puede mejorar el rendimiento en algunos aspectos, su configuración más compleja y mayor uso de CPU y memoria lo convierten en una opción menos atractiva a menos que se trate de un entorno con necesidades específicas de almacenamiento masivo.

Conclusión

La elección entre NTFS y ReFS para SQL Server no tiene una respuesta única, ya que depende de las necesidades de cada entorno. NTFS sigue siendo la opción más estable y eficiente en términos de recursos, y es especialmente recomendable cuando se prioriza la compatibilidad y la menor sobrecarga en el servidor. ReFS, aunque potente en la gestión de grandes volúmenes de datos, requiere una configuración más cuidadosa, especialmente al desactivar sus funciones de integridad de datos, lo que puede reducir algunas de sus ventajas teóricas.

El consumo de recursos de ReFS y su necesidad de ajustes adicionales hacen que, en la mayoría de los escenarios, NTFS siga siendo una opción más práctica para bases de datos de producción en SQL Server. La clave está en evaluar los requisitos de almacenamiento y recursos de cada proyecto y elegir el sistema de archivos que mejor se adapte a nuestras necesidades.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Columnstore vs VertiPaq

Cuando gestionamos grandes volúmenes de datos, hay dos tecnologías de almacenamiento que suelen ser las principales protagonistas: el Columnstore de SQL Server y VertiPaq, el motor de almacenamiento de Power BI. Ambas tecnologías están diseñadas para optimizar el procesamiento de datos en entornos de análisis, pero lo hacen utilizando enfoques y arquitecturas diferentes. En este artículo, veremos en profundidad las similitudes y diferencias entre estas dos tecnologías, considerando aspectos como el rendimiento, la eficiencia en la compresión de datos y las características de uso que determinan su idoneidad para diferentes escenarios.

Antes de iniciar, es de justicia reconocer los méritos y es que, este artículo no habría sido posible sin el whitepaper “Vertipaq vs Columnstore” escrito por Alberto Ferrari de sqlbi que podéis descargar completo desde aquí. Es un documento con más de 12 años de antigüedad y casi 30 páginas dedicado a comparar el rendimiento entre ambas tecnologías del motor xVelocity introducido en  SQL Server 2012 para SQL Server y SSAS.

Columnstore de SQL Server: Desempeño y optimización

Los índices Columnstore en SQL Server son una solución avanzada que almacena datos en columnas en lugar de filas. Esta disposición mejora la compresión y reduce la cantidad de E/S necesaria para ejecutar consultas analíticas, especialmente en entornos de data warehousing. Sin embargo, el rendimiento del Columnstore no es uniforme en todos los escenarios. Por ejemplo, en consultas simples de agregación, SQL Server puede no aprovechar automáticamente los beneficios del índice Columnstore, requiriendo ajustes en las consultas para forzar el uso de este índice y lograr un rendimiento óptimo​.

En términos de tiempo de procesamiento, la reconstrucción completa de un índice Columnstore es significativamente más rápida que el procesamiento de una base de datos en Analysis Services con VertiPaq, lo que puede ser un factor decisivo en entornos donde la velocidad de procesamiento es crítica​.

VertiPaq en Power BI: Un motor de almacenamiento revolucionario

VertiPaq, utilizado por Power BI y SQL Server Analysis Services (SSAS) en su modalidad Tabular, está optimizado para el uso en memoria, ofreciendo una capacidad de respuesta excepcional al ejecutar análisis complejos en tiempo real. Su modelo de compresión en memoria permite cargar grandes volúmenes de datos y mantener una alta eficiencia en la ejecución de consultas. Además, VertiPaq maneja cálculos a nivel de hoja de manera extremadamente eficiente, superando en muchos casos al Columnstore en operaciones como conteos distintos y cálculos ponderados​.

No obstante, VertiPaq requiere que todo el modelo de datos esté en memoria, lo que puede ser una limitación si se trabaja con conjuntos de datos que superan la capacidad de la RAM disponible. En estos casos, SQL Server con Columnstore podría ser más adecuado, ya que SQL puede manejar de manera dinámica los datos en memoria, cargando y descargando información según sea necesario​.

Almacenamiento en columnas vs. almacenamiento en filas

Según acabamos de ver, el almacenamiento en columnas (ya sea en memoria como en VertiPaq o en disco como Columnstore) mejora el rendimiento de las consultas analíticas pero, seguro que os estáis preguntando por qué.

Sin entrar en detalle de bajo nivel que complicarían este artículo más de lo necesario, esta mejora es debida a la manera en que los datos se organizan y se acceden en este tipo de almacenamiento. 

En un sistema de almacenamiento tradicional basado en filas, como el que se utiliza en muchas bases de datos relacionales, los datos de todas las columnas de una fila se almacenan juntos en disco. Esto significa que cuando se realiza una consulta que necesita acceder a una o dos columnas específicas, el sistema tiene que leer la fila completa desde el disco, incluso si solo se necesita un subconjunto de las columnas.

Por el contrario, en un sistema de almacenamiento en columnas, los datos de cada columna se almacenan por separado. Es decir, todas las entradas de una columna se almacenan juntas. Esta estructura permite que las consultas que solo necesitan acceder a ciertas columnas puedan hacerlo de manera más eficiente, leyendo sólo los datos relevantes desde el disco.

Similitudes entre el Columnstore de SQL y VertiPaq de Power BI

Ambas tecnologías comparten un enfoque basado en columnas, lo que permite una compresión eficiente y un uso optimizado del almacenamiento. Además, tanto Columnstore como VertiPaq están diseñados para maximizar el rendimiento en consultas analíticas, lo que los hace ideales para entornos donde se requiere procesar grandes volúmenes de datos rápidamente. En ambos casos, la compresión de datos no solo reduce el espacio de almacenamiento, sino que también mejora la velocidad de las consultas, ya que se reduce la cantidad de datos a procesar​, como ya hemos visto en el apartado anterior.

Diferencias clave entre Columnstore y VertiPaq

A pesar de las similitudes, las diferencias entre Columnstore y VertiPaq son notables en varios aspectos. Por ejemplo, Columnstore se desempeña mejor en escenarios donde se aplican filtros a los datos, lo que le permite superar a VertiPaq en términos de velocidad cuando se trata de consultas que no requieren un escaneo completo de la tabla​.

Por otro lado, VertiPaq sobresale en operaciones que involucran cálculos complejos y conteos distintos, ofreciendo un rendimiento superior en estos casos debido a las optimizaciones inherentes a su motor de cálculo. Además, VertiPaq ofrece una rica capa de metadatos que facilita la creación de modelos de datos complejos y la implementación de medidas calculadas, lo que puede ser un punto decisivo en proyectos donde la facilidad de uso y la integración con herramientas de usuario final son importantes​.

Otra diferencia significativa es cómo cada tecnología maneja las relaciones muchos-a-muchos. VertiPaq maneja estas relaciones de manera extremadamente eficiente, lo que lo convierte en una opción superior en escenarios donde este tipo de relaciones son comunes. Columnstore, aunque también es competente en este aspecto, puede no igualar la velocidad de VertiPaq en todos los casos​.

Consideraciones adicionales

Más allá del rendimiento en consultas, es importante considerar otros factores como el tiempo de procesamiento y el uso de memoria. Como os he mencionado antes, Columnstore ofrece un tiempo de procesamiento significativamente más rápido al reconstruir índices, mientras que VertiPaq requiere que todo el modelo de datos esté en memoria, lo que puede ser una limitación en entornos con recursos de memoria limitados​.

Además, el uso de la caché en VertiPaq mejora significativamente el rendimiento en escenarios donde las mismas consultas se ejecutan repetidamente, ya que los resultados se almacenan en caché y se pueden recuperar rápidamente sin necesidad de volver a ejecutar la consulta completa​. En contraste, SQL Server no almacena en caché los resultados, lo que puede llevar a tiempos de respuesta más largos en consultas repetitivas.

Columnstore o VertiPaq, ¿cuál es mejor?

La elección entre el Columnstore de SQL Server y VertiPaq de Power BI depende en gran medida del entorno y las necesidades específicas de cada proyecto. VertiPaq, con su motor de almacenamiento en columnas altamente optimizado para el análisis en memoria, es ideal para escenarios donde necesitemos un rendimiento elevado en cálculos complejos y agregaciones, y donde los datos puedan ser cargados completamente en memoria. Su capacidad para manejar eficientemente consultas analíticas y ofrecer una rica capa de metadatos lo hace especialmente adecuado para modelos de análisis interactivos y ágiles en Power BI.

Por otro lado, el índice Columnstore de SQL Server brilla en entornos donde los datos no pueden ser completamente cargados en memoria, o donde necesitamos actualizaciones y escrituras frecuentes en grandes volúmenes de datos. Si bien el Columnstore también nos ofrece un almacenamiento basado en columnas, su integración con SQL Server permite un manejo más dinámico de la memoria, lo que es ventajoso en escenarios donde el tamaño del conjunto de datos excede la capacidad de la memoria disponible. Además, su capacidad para filtrar y procesar datos de manera eficiente en consultas específicas lo convierte en una opción poderosa para mejorar el rendimiento en bases de datos relacionales que manejan grandes volúmenes de datos.

En el contexto de Power BI, si bien no podemos usar directamente los índices Columnstore de SQL Server, podemos optar por usar DirectQuery para trabajar con datos en SQL Server y aprovechar esos índices. Sin embargo, esto puede implicar un compromiso en términos de rendimiento, debido a la latencia de la red, y funcionalidad (no todas las funciones DAX están disponibles en DirectQuery) en comparación con un modelo de datos totalmente importado y gestionado por VertiPaq.

Conclusión

En resumen, VertiPaq es la opción preferida cuando se necesita un rendimiento extremo en análisis interactivo y la memoria es suficiente para manejar los datos. El Columnstore de SQL Server, por su parte, es más adecuado en escenarios donde la gestión eficiente de grandes volúmenes de datos en disco es crítica, y se requiere flexibilidad en las operaciones de escritura y actualización. Debemos comprender las fortalezas y limitaciones de cada tecnología es fundamental para que podamos tomar las mejores decisiones informadas y, así, optimizar el rendimiento de nuestras soluciones analíticas en función de los requisitos específicos del proyecto.


Publicado por Roberto Carrancio en Índices, Power BI, Rendimiento, SQL Server, 0 comentarios

Operadores Spool en planes de ejecución

Una de las primeras cosas que hacemos, o por lo menos que deberíamos hacer, cuando estamos analizando el rendimiento de una consulta es mirar su plan de ejecución. En los planes de ejecución vemos paso a paso y gráficamente lo que hace nuestra consulta. Cada uno de estos pasos de los que hablamos está representado gráficamente por un operador y la mayoría son intuitivos y fáciles de comprender pero hay un tipo en concreto que parece que cuesta un poco más. Me refiero como no podía ser de otra manera a los operadores Spool. Estos componentes pueden marcar la diferencia en términos de eficiencia y tiempo de respuesta de las consultas. En este artículo, profundizaremos en los diferentes tipos de Spool, su propósito, cómo funcionan y cuándo deberíamos prestarles atención.

¿Qué es un operador Spool?

Antes de entrar en detalles, es importante entender qué es un operador Spool. Básicamente, son operadores que almacenan temporalmente un conjunto de filas durante la ejecución de una consulta. Este almacenamiento permite que SQL Server reutilice estos datos en lugar de volverlos a calcular o volver a leerlos desde el disco, lo que puede resultar en una mejora significativa del rendimiento en determinadas situaciones. Existen varios tipos de operadores spool en SQL Server y, aunque todos comparten la definición que hemos mencionado, cada uno tiene sus particularidades. 

Table Spool

El «Table Spool» es el tipo de Spool más común en SQL Server. Su objetivo principal es almacenar el resultado de una subconsulta o una parte del plan de ejecución que es probable que se reutilice. Este tipo de operador suele aparecer cuando tenemos consultas que requieren repetir una operación costosa varias veces. Por ejemplo, si una subconsulta se ejecuta en múltiples ocasiones dentro de una misma consulta, SQL Server puede decidir almacenar temporalmente el resultado de esa subconsulta en un Table Spool para evitar esas múltiples ejecuciones.

Un detalle importante a considerar es que, aunque el Table Spool puede reducir el tiempo de ejecución en general, también consume memoria temporal para almacenar los datos, lo que podría impactar en la eficiencia si el tamaño del Spool es considerablemente grande.

Index Spool

El «Index Spool» se utiliza cuando SQL Server anticipa que necesitará un índice temporal para mejorar la búsqueda de datos en una consulta específica. Este operador crea un índice en memoria, que puede ser utilizado para acelerar operaciones como JOINs o búsquedas basadas en condiciones de filtrado. Aunque esta operación añade un paso adicional al plan de ejecución, la creación de un índice temporal puede resultar en un rendimiento significativamente mejorado, especialmente en consultas que trabajan con grandes volúmenes de datos.

La clave para entender el impacto de un Index Spool está en el balance entre el coste de crearlo y los beneficios que aporta en la fase de búsqueda. En escenarios donde se ejecutan varias búsquedas en un conjunto de datos sin un índice adecuado, este operador se convierte en una solución efectiva.

Row Count Spool

El «Row Count Spool» es un tipo de operador que se emplea principalmente para controlar el número de filas que se procesan en una operación. A diferencia de los Spool anteriores, este no almacena datos per se, sino que mantiene un conteo de las filas que pasan a través de él. Este operador suele aparecer en situaciones donde se requiere un número preciso de filas como resultado de una subconsulta, como cuando usamos la cláusula TOP o una condición de filtrado que limita las filas a procesar.

En resumen, este operador actúa como un portero de discoteca que asegura que solo pasen el número exacto de filas necesarias. Es especialmente útil en operaciones que pueden generar un gran número de filas intermedias, pero donde solo se necesita un subconjunto de ellas. Así, el Row Count Spool ayuda a evitar el procesamiento innecesario, optimizando el rendimiento de la consulta.

Window Spool

El «Window Spool» es menos común pero no menos importante. Este tipo de operador se emplea principalmente en consultas que utilizan funciones de ventana, como ROW_NUMBER(), RANK() o LEAD(). El propósito del Window Spool es soportar el cálculo de estas funciones, almacenando temporalmente el conjunto de datos sobre el cual se aplicarán las funciones de ventana.

Las funciones de ventana requieren acceso a un conjunto completo de datos para calcular correctamente sus resultados. El operador Window Spool permite que SQL Server mantenga un «almacén» de estas filas mientras las operaciones de ventana se ejecutan, garantizando así que el resultado sea el esperado. Aunque puede añadir cierta sobrecarga en términos de memoria, su beneficio en la correcta ejecución de funciones analíticas es crucial.

Optimización y uso

Entender cuándo y cómo aparecen los Spool en los planes de ejecución es vital para optimizar el rendimiento de nuestras consultas. Si bien estos operadores pueden mejorar la eficiencia en muchos casos, su uso inadecuado o innecesario puede tener el efecto contrario. Es fundamental analizar los planes de ejecución y evaluar si la presencia de un Spool está realmente justificada en base al coste adicional que implica su utilización.

En algunos casos, podríamos encontrar que la eliminación de un Spool innecesario, ya sea mediante la reescritura de la consulta o ajustando los índices, resulta en un rendimiento superior. También es importante recordar que estos operadores suelen consumir memoria temporal, por lo que su impacto en la carga general del sistema debe ser monitorizado de cerca.

Recursión

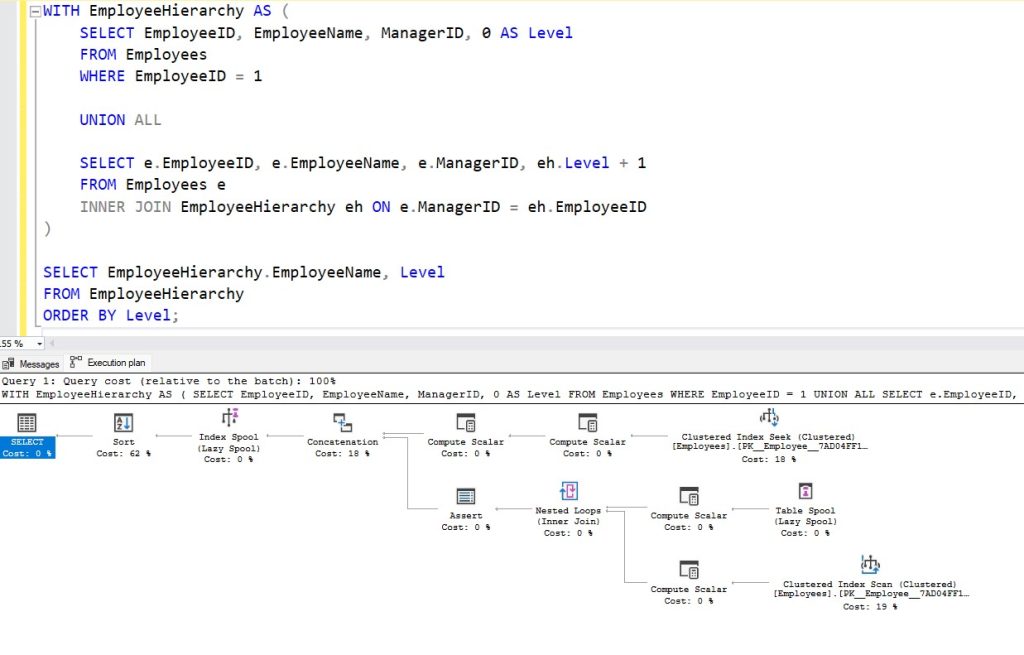
Las consultas recursivas son un ejemplo de la necesidad de operadores Spool. En una consulta recursiva típica, SQL Server tiende a utilizar dos tipos de Spool que resultan esenciales para su correcto funcionamiento y optimización: el Table Spool y el Index Spool.

Spool en recursividad

Table Spool en recursividad

Al principio de una consulta recursiva, SQL Server suele emplear un Table Spool. Este operador, como hemos visto, se utiliza para almacenar el conjunto inicial de filas que formarán la base de la recursión, conocido como la parte ancla en un CTE recursivo. La función principal de este operador es capturar estas filas iniciales para que puedan ser reutilizadas a lo largo de las iteraciones recursivas sin necesidad de recalcular o volver a leer los datos desde el origen.

Este Table Spool es especialmente útil en este contexto porque permite que el proceso recursivo se inicie de manera eficiente, asegurando que las filas base estén disponibles para las iteraciones subsiguientes sin añadir un coste significativo de I/O o de CPU. Este operador se convierte en un «almacén temporal» que facilita la generación de los resultados recursivos de manera escalable.

Index Spool en recursividad

En la fase final de la recursión, cuando se procesan y ordenan los resultados, SQL Server suele introducir un Index Spool. Este operador crea un índice temporal en memoria sobre el conjunto de datos generado durante la recursión. La finalidad de este índice es acelerar la búsqueda y ordenación de los datos, especialmente en consultas que requieren un orden específico o que deben cumplir con condiciones adicionales de filtrado.

El Index Spool optimiza la fase de finalización de la consulta recursiva, permitiendo que SQL Server gestione grandes volúmenes de datos generados por la recursión de manera más eficiente. La creación de este índice temporal puede ser costosa en términos de memoria y CPU, pero su impacto positivo en el rendimiento de la consulta suele justificar su utilización, especialmente en estructuras de datos jerárquicas complejas.

Conclusión

Los operadores Spool en SQL Server son herramientas poderosas que, cuando se utilizan correctamente, pueden mejorar significativamente el rendimiento de nuestras consultas. Desde el Table Spool, que almacena datos para evitar cálculos repetidos, hasta el Window Spool, que soporta funciones analíticas, cada tipo de Spool tiene un propósito específico y un impacto en la forma en que SQL Server procesa las consultas.

Para sacar el máximo provecho de los Spool, es esencial comprender cómo y cuándo aparecen en los planes de ejecución y evaluar su eficacia en cada caso. Aunque estos operadores pueden añadir complejidad al plan de ejecución, su correcta utilización puede ser la clave para lograr un rendimiento óptimo en SQL Server.

En definitiva, los Spool no son solo un detalle técnico, sino una pieza fundamental en la optimización avanzada de consultas. Con el conocimiento adecuado, podemos utilizarlos para transformar consultas lentas en operaciones altamente eficientes, maximizando el rendimiento de nuestras bases de datos.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario

Buenas prácticas en Power BI Report Server (PBIRS)

Continuamos con los artículos sobre Power BI Report Server, ya hemos visto tanto sus características principales como los consejos de implantación y mantenimiento y hoy, y para cerrar esta semana temática, vamos a hablar de buenas prácticas. Lo primero que tenemos que recordar es que Power BI Report Server (PBIRS) está construido sobre la base de SQL Server Reporting Service (SSRS), una herramienta de reporte de BI de Microsoft con más de 15 años en el mercado. Con esto quiero decir que la mayoría de las cosas que vamos a ver ahora os sonarán familiares si ya habéis administrado SSRS pero si no es así no os preocupéis que para eso lo vamos a ver.

Configuración avanzada de Report Server

Cuando instalamos PBIRS tendremos a nuestra disposición una herramienta de configuración calcada a la de SSRS donde podremos realizar las configuraciones más básicas de este servicio. Sin embargo, esto no es todo,habrá aspectos que configuraremos en el propio servicio web y otros, los más avanzados, para los que necesitaremos un SSMS. Y, en concreto, son tres de estas configuraciones de las que vamos a hablar en este apartado. Configuraciones que, para la mayoría de las empresas pueden funcionar pero, para otras igual no tanto.

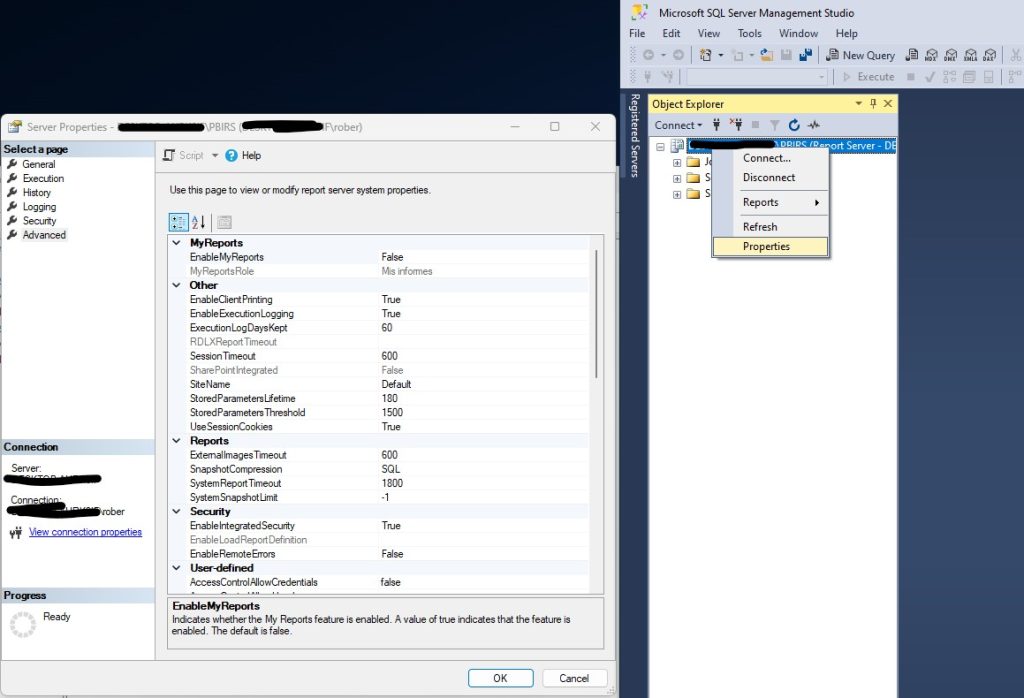
Para acceder a estas configuraciones nos conectaremos a nuestro PBIRS desde nuestro Management Studio (SSMS) usando la opción de conexión a SQL Server Reporting Service (SSRS). Una vez conectados abriremos las propiedades de la instancia y accederemos a las propiedades avanzadas. Aquí, entre otras, podremos encontrar la siguientes configuraciones:

Power BI Report Server Advanced Config

EnableMyReports

La configuración “Enable and disable My Reports» nos permite a los administradores activar o desactivar la funcionalidad de «Mis informes». Esta función, desactivada por defecto, ofrece a los usuarios la posibilidad de crear un espacio personal dentro del servidor donde pueden guardar y gestionar sus propios informes. Esto es similar al concepto Mi espacio de trabajo que tienen los usuarios dentro del servicio Power BI. Habilitar Mis informes es una excelente manera de fomentar la BI de autoservicio y puede ser beneficioso para fomentar la personalización y la autonomía de los usuarios, permitiéndoles trabajar de manera más eficiente sin sobrecargar los espacios compartidos del servidor. No obstante, dejarlo desactivado puede ser preferible en entornos donde la uniformidad y el control sobre los informes es una prioridad.

ExecutionLogDaysKept

ExecutionLogDaysKept es otra configuración importante que define cuántos días se conservan los registros de ejecución de informes en el servidor. Estos logs son fundamentales para el análisis de rendimiento y la solución de problemas, ya que contienen información detallada sobre cada ejecución de informes. Ajustar esta configuración nos permite a los administradores balancear entre la retención de información suficiente para análisis detallados y la gestión eficiente del espacio de almacenamiento. Por defecto esta propiedad está establecida en 60 días, un periodo de retención más largo puede ser útil para auditorías y análisis históricos, sobre todo si tienes informes que se ejecutan sólo una vez al mes o menos. Por otro lado, un periodo más corto puede ayudar a optimizar el rendimiento del servidor. 

EnablePowerBIReportExportUnderlyingData

Por último, la configuración EnablePowerBIReportExportUnderlyingData controla si los usuarios tienen permiso para exportar los datos subyacentes de los informes de Power BI. Esta opción es crucial para mantener la seguridad y privacidad de los datos. Permitir la exportación puede ser necesario para usuarios que requieran analizar la información fuera de la plataforma, pero también puede suponer un riesgo si los datos son sensibles. Por ello, esta configuración debe ser ajustada con cuidado, asegurando que solo los usuarios adecuados tengan acceso a esta funcionalidad y que se cumplan las políticas de seguridad de la organización. 

Si me preguntáis por mi opinión, yo soy totalmente partidario de deshabilitar esta opción. Además, un abuso de la descarga de información en horas de mucha actividad de usuarios puede suponernos un verdadero quebradero de cabeza.

Seguridad a nivel de carpetas en Report Server

Llegamos a una de las principales diferencias entre Power BI Report Server y el servicio en la nube de Power BI. Mientras en el cloud tenemos Workspaces que sirven como entornos aislados colaborativos para que los equipos desarrollen contenido de Power BI al unísono. Después creamos aplicaciones para facilitar la entrega del contenido a los usuarios. Estos conceptos no existen en Power BI Report Server. En PBIRS tendremos que usar carpetas.

Las carpetas dentro de Power BI Report Server (y SSRS) se comportan como carpetas dentro de un sistema de archivos. La seguridad a nivel de carpeta se puede aplicar para restringir el acceso a todo el contenido de la carpeta. Además, al igual que un sistema de archivos, se puede crear una jerarquía de carpetas. Esto es diferente a la naturaleza aplanada de App Workspaces dentro del servicio Power BI. 

Gestión de los permisos

Estemos alojando informes en el servicio o en PBIRS, debemos realizar una planificación cuidadosa desde el principio para proteger adecuadamente su contenido. Normalmente, tiene sentido crear carpetas para diferentes departamentos o equipos de la empresa como, por ejemplo, ventas, contabilidad, marketing, etc…

Aunque en Power BI Report Server (PBIRS), también podemos definir la seguridad en elementos individuales (por ejemplo, un único informe), normalmente no es una práctica. En implementaciones grandes, podemos encontrarnos con decenas o cientos de informes y mantener individualmente los permisos sería una pesadilla. Del mismo modo tenemos que huir de los permisos a usuarios individuales y, siempre que sea posible, utilizar grupos de usuarios. Si llevamos esto a rajatabla, podremos proteger múltiples informes relacionados y habilitar su uso para un subconjunto de usuarios sin complicaciones. 

En la mayoría de los casos, también recomiendo que os ciñais a una estructura de carpetas plana. De este modo, no solo será más fácil proteger las carpetas, también PBIRS coincidirá lógicamente con la estructura plana de Workspaces en el servicio Power BI. Esto nos facilitará la tarea de migración o  transferencia del contenido de Power BI Report Server (PBIRS) al servicio Power BI en la nube si alguna vez queremos hacerlo.

Reutilizar un modelo de datos en Report Server

Una de las limitaciones de Power BI Report Server (PBIRS) frente al servicio de Power BI en la nube es la capacidad de utilizar un mismo modelo de datos para diferentes informes. Así, mientras que en Power BI en la nube todos nuestros informes pueden acceder a un mismo modelo, si tenemos 12 informes que usan el mismo modelo de datos, en Power BI Report Server (PBIRS) tendremos que mantener 12 copias del modelo de datos. Esto, no hace falta que os lo diga, es un problema a la hora de actualizar los modelos y puede generar una discrepancia de datos entre los informes, que, en el mejor de los casos, nos provocará una reprimenda por parte de los usuarios. 

Sin embargo, nosotros que somos DBAs y sabemos de bases de datos y, sobre todo, de servicios de SQL Server, sabemos que podemos aprovecharnos de las capacidades de SQL Server Analysis Services para almacenar nuestras bases de datos dimensionales y, desde los informes de Power BI simplemente acceder a ese único origen de datos compartido para todos los reportes.

Analysis Services es una excelente opción si ya tenemos una inversión en SQL Server y sus componentes de BI, que la tendremos si hemos licenciado PBIRS con la licencia de SQL Server Enterprise. Sin embargo, si estamos implementando Power BI Report Server gracias al licenciamiento de Power BI Premium, también podemos aprovechar los conjuntos de datos que residen en la capacidad Premium como modelos de datos reutilizables.

Podemos establecer una conexión desde nuestros informes de Power BI a un conjunto de datos Premium como si fuera un modelo de Analysis Services. Para ello, debemos asegurarnos de que nuestra capacidad Premium tenga habilitada la lectura en la configuración del extremo XMLA.

Conclusión

En resumen, Power BI Report Server (PBIRS) es una herramienta muy potente, que, si se configura y gestiona adecuadamente, puede convertirse en un pilar fundamental para la inteligencia de negocio en tu organización. Desde la configuración avanzada para habilitar funciones como «Mis informes» o controlar la exportación de datos subyacentes, hasta la gestión cuidadosa de la seguridad a nivel de carpetas y la reutilización de modelos de datos, podemos optimizar cada aspecto de PBIRS para alinearlo con las necesidades y políticas de nuestra empresa. Implementar estas buenas prácticas no solo mejorará el rendimiento y la seguridad de nuestro entorno de reportes, sino que también facilitará futuras migraciones al servicio Power BI en la nube, asegurándonos que nuestra infraestructura de BI está preparada para el crecimiento y el cambio.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Power BI, Rendimiento, 0 comentarios

Despliegue y mantenimiento de PBIRS

Hoy vamos a seguir hablando de PBIRS, si en el pasado artículo vimos sus características, licenciamiento y cómo se compara con el servicio de Power BI en la nube (más bien cómo se complementa) hoy toca el turno de la configuración y mantenimiento del mismo. Lo primero que tenemos que saber es que la instalación de un servidor de Power BI Report Server (PBIRS), como la de cualquier otro servicio de producción, es un proceso que requiere una planificación meticulosa y un mantenimiento continuo para garantizar un rendimiento óptimo y la satisfacción de los usuarios. 

En este artículo, explicaremos algunas de las mejores prácticas que he identificado en mi experiencia con PBIRS, centrándonos en cómo implementarlas eficazmente y en cómo mantener la infraestructura una vez que esté en funcionamiento. La finalidad es maximizar la eficiencia, mejorar la seguridad y garantizar que los informes se ejecuten sin problemas, todo ello sin sacrificar la experiencia del usuario.

Planificando la Implementación de PBIRS

Como ya vimos cuando hablamos del despliegue de un servidor SQL Server, la planificación es un componente crucial en cualquier implementación, por tanto también cuando hablamos de PBIRS. Debemos comenzar con un análisis detallado de los requisitos de negocio y la capacidad técnica del entorno en el que se va a desplegar. Es esencial comprender no solo las necesidades actuales, sino también prever el crecimiento futuro y la escalabilidad de la plataforma.

Dimensionamiento y configuración del Servidor

Uno de los primeros pasos es dimensionar adecuadamente el servidor. La configuración del hardware debe estar alineada con la carga esperada de usuarios y la complejidad de los informes. Por ejemplo, si prevemos un uso intensivo de gráficos complejos o de grandes volúmenes de datos, será necesario disponer de un hardware más potente, con suficiente memoria RAM y capacidad de procesamiento para manejar las demandas sin comprometer el rendimiento.

Es recomendable dividir los recursos en diferentes servidores si el tráfico de usuarios o la carga de trabajo lo justifican, esto es un escalado horizontal. De esta manera, podemos evitar que un único punto de fallo impacte en la disponibilidad del servicio. Por supuesto, no debemos olvidar la importancia de configurar adecuadamente el almacenamiento, utilizando discos rápidos para el almacenamiento de bases de datos y optimizando las rutas de acceso para minimizar latencias.

Seguridad y gobernanza de los datos

A nadie le sorprende si os digo que la seguridad de los datos es primordial. PBIRS no es una excepción, y por ello es crucial establecer políticas de seguridad estrictas desde el inicio. Esto incluye la implementación de medidas como la autenticación segura, la encriptación de datos y la segregación de funciones para evitar accesos no autorizados.

Además, la gobernanza de los datos es otro aspecto que debemos considerar. Normalmente las organizaciones más grandes cuentan con equipos de gobierno del dato con quien deberemos trabajar estrechamente para establecer roles y permisos claros, así como auditar regularmente los accesos y las actividades dentro del servidor, nos ayudará a mantener un entorno seguro y conforme con las normativas vigentes. Es probable que en este proceso también intervenga el equipo de ciberseguridad, tanto en la toma de decisiones como en la monitorización continua de las auditorías.

Buenas Prácticas en PBIRS

Una vez que hemos planificado adecuadamente la implementación, es el momento de poner manos a la obra. Aquí es donde entran en juego las mejores prácticas específicas de implementación que nos permitirán maximizar el rendimiento y la funcionalidad de PBIRS.

Despliegue y Configuración Inicial

Durante el despliegue, es fundamental seguir las guías de instalación recomendadas por Microsoft, asegurándonos de que todas las dependencias están en su lugar y configuradas correctamente. Una vez instalado el servidor, debemos proceder con la configuración inicial, que incluye la creación de la base de datos de reportes, la configuración del servicio web y la aplicación de las políticas de seguridad definidas previamente.

Configuración de HTTPS en PBIRS

Un aspecto clave para la seguridad de PBIRS es el uso de HTTPS en lugar de HTTP para el servidor web. HTTPS asegura que los datos transmitidos entre los clientes y el servidor estén encriptados, lo que protege la información sensible de accesos no autorizados o ataques de intermediarios.

Implementar HTTPS en PBIRS requiere configurar el servidor web para aceptar conexiones seguras. Para ello, es necesario obtener e instalar un certificado SSL/TLS válido emitido por una autoridad de certificación de confianza. Los certificados SSL permiten que el servidor establezca una conexión segura y encriptada con los usuarios, lo que es fundamental para proteger la integridad y confidencialidad de los datos transmitidos.

Una vez que tenemos el certificado, debemos configurarlo en el servidor web de PBIRS. Este proceso generalmente implica asociar el certificado con el puerto 443, que es el puerto estándar para las conexiones HTTPS. Es crucial asegurarse de que todas las páginas y recursos del servidor se sirvan a través de HTTPS, redirigiendo automáticamente cualquier tráfico HTTP para evitar conexiones inseguras.

Mantenimiento Continuo de PBIRS

El mantenimiento es un aspecto que a menudo se subestima, pero es crucial para asegurar que el servidor siga funcionando de manera óptima a lo largo del tiempo. Este mantenimiento no solo incluye las actualizaciones regulares del software, sino también la monitorización proactiva y la gestión del rendimiento.

Monitorización y Rendimiento

Una de las mejores prácticas en el mantenimiento de PBIRS es la monitorización constante del rendimiento. Esto incluye la revisión de los logs de uso para identificar posibles cuellos de botella y la supervisión de los recursos del servidor para detectar cualquier signo de sobrecarga.

Utilizar herramientas de monitorización que permitan visualizar en tiempo real el uso de CPU, memoria y disco es fundamental. Esto nos permitirá anticiparnos a posibles problemas antes de que afecten a los usuarios finales. Además, realizar pruebas de estrés de manera periódica puede ayudarnos a ajustar la configuración del servidor para manejar mejor las cargas pico.

Actualizaciones y Parches

Mantener PBIRS actualizado es una práctica indispensable para asegurar tanto la estabilidad como la seguridad del sistema. Microsoft publica regularmente actualizaciones, normalmente 3 al año, que corrigen errores, mejoran el rendimiento y añaden nuevas funcionalidades. Sin embargo, antes de aplicar cualquier actualización, es recomendable realizar pruebas en un entorno de desarrollo o de preproducción para asegurarnos de que no introducirá nuevos problemas en el entorno de producción.

Además, es importante mantener actualizadas las bases de datos y los sistemas operativos subyacentes, ya que cualquier vulnerabilidad en estos componentes podría comprometer la seguridad y la integridad de los datos.

Gestión de la Capacidad y Escalabilidad

A medida que el uso de PBIRS crece, también lo hará la demanda de recursos. Por ello, es esencial gestionar la capacidad de manera proactiva, añadiendo recursos o distribuyendo la carga cuando sea necesario. Implementar una estrategia de escalabilidad, que incluya tanto la escalabilidad horizontal (añadir más servidores) como la vertical (mejorar los recursos de los servidores existentes), nos permitirá mantener un rendimiento óptimo a medida que crece la base de usuarios y la complejidad de los informes.

Optimización en la entrega de Informes

Para garantizar que los informes se entreguen de manera eficiente, es necesario optimizarlos. Esto implica una revisión continua tanto de consultas DAX como SQL para asegurarnos de que están bien escritas y no consumen recursos innecesarios. También es aconsejable utilizar particiones de datos en modelos grandes y evitar el uso excesivo de gráficos o visualizaciones que puedan ralentizar el rendimiento. 

Otro punto clave es configurar adecuadamente los tiempos de actualización de los informes. Definir horarios de actualización en momentos de baja demanda puede reducir significativamente el impacto en el rendimiento general del servidor.

Renovación de certificados

Por último no se nos debe olvidar que la implementación de HTTPS, de la que hemos hablado antes, no es un proceso único; es necesario que renovemos los certificados periódicamente para mantener la seguridad del sistema. Los certificados SSL tienen una validez limitada (de uno o dos años por norma general), por lo que debemos estar atentos a su fecha de expiración y renovarlos con antelación para evitar interrupciones en el servicio o alertas de seguridad para los usuarios.

Además, es recomendable utilizar certificados de autoridades de certificación reconocidas y evitar los certificados autofirmados en entornos de producción, ya que estos no son confiables por los navegadores modernos y pueden generar advertencias de seguridad para los usuarios.

Conclusión

La implementación y el mantenimiento de Power BI Report Server requieren un enfoque detallado y proactivo para garantizar que el sistema funcione de manera eficiente y segura. Desde la planificación inicial hasta el mantenimiento continuo, cada etapa del proceso ofrece oportunidades para optimizar el rendimiento y mejorar la experiencia del usuario. Al seguir las mejores prácticas descritas en este artículo, estaremos mejor preparados para abordar los desafíos que puedan surgir y asegurar que PBIRS continúe siendo una herramienta valiosa para la organización.

En última instancia, la clave del éxito radica en la planificación cuidadosa, la optimización constante y la monitorización proactiva, lo que nos permitirá maximizar el valor de nuestra inversión en Power BI Report Server y garantizar que sigue cumpliendo con las necesidades de negocio a lo largo del tiempo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, Rendimiento, 0 comentarios

Bloqueos Optimizados

Hoy vamos a hablar de una de las características nuevas que implementan las bases de datos de Azure para maximizar el rendimiento sin comprometer la integridad de los datos. Cuando diseñamos y gestionamos nuestras bases de datos, debemos considerar cómo se gestionan los bloqueos, especialmente en entornos con alta concurrencia. La gestión de bloqueos es crucial para garantizar que múltiples transacciones puedan ejecutarse en paralelo sin conflictos. En este artículo, exploraremos en profundidad los bloqueos optimizados en las Azure Databases, cómo funcionan y cómo pueden ser aprovechados para mejorar el rendimiento de nuestras aplicaciones.

¿Qué son los bloqueos optimizados en Azure SQL Database?

Los bloqueos optimizados son una característica avanzada de Azure SQL Database diseñada para reducir la contención (bloqueos) y, por tanto, mejorar el rendimiento de las transacciones en entornos con alta concurrencia. En esencia, esta característica permite al motor de bases de datos minimizar el tiempo durante el cual las transacciones mantienen bloqueos, reduciendo así la posibilidad de que otras transacciones tengan que esperar para acceder a los mismos recursos. En entornos con alta concurrencia, como los que a menudo manejamos en la nube, esta optimización puede marcar la diferencia entre una aplicación fluida y una plagada de cuellos de botella.

El principio básico detrás de los bloqueos optimizados es el uso eficiente de los recursos del sistema. Las bases de datos tradicionales suelen imponer bloqueos a nivel de fila, página o tabla, lo que puede llevar a que las transacciones se bloqueen entre sí si intentan acceder a los mismos datos. Con los bloqueos optimizados, Azure SQL Database ajusta dinámicamente el nivel de bloqueo, permitiendo que las transacciones adquieran solo los bloqueos necesarios y los liberen lo antes posible. De este modo, se mejora la eficiencia general del sistema.

¿Dónde puedo usar los bloqueos optimizados?

A día de hoy, los bloqueos optimizados son una característica exclusiva de las Azure SQL Databases, no vamos a encontrar esta funcionalidad ni en versiones de SQL Server ni en Azure Managed Instance. Si estamos trabajando con Azure SQL Databases (sea cual sea nuestro nivel de servicio) debemos saber que los bloqueos optimizados están habilitados por defecto y, por tanto, podremos esperar el comportamiento que veremos a continuación siempre y cuando no los deshabilitemos. También es importante mencionar que esta funcionalidad depende de la recuperación acelerada de base de datos (ADR) por lo que si en algún momento deshabilitamos ADR en nuestra base de datos perderemos la funcionalidad de los bloqueos optimizados.

Funcionamiento de los bloqueos optimizados

Para entender cómo los bloqueos optimizados logran mejorar el rendimiento, es imprescindible entender cómo funciona esta gestión a bajo nivel. Cuando una transacción se ejecuta en Azure SQL Database, el motor de la base de datos evalúa el impacto potencial de los bloqueos necesarios. Dependiendo de factores como la naturaleza de la consulta, el nivel de aislamiento de la transacción y la carga actual del sistema, el motor decide si aplicar un bloqueo exclusivo, compartido o, en algunos casos, ninguno en absoluto. De esto ya hemos hablado en nuestro artículo sobre los bloqueos y deadlocks.

Uno de los aspectos clave de esta optimización es la técnica conocida como «lock escalation» o escalado de bloqueos. En lugar de aplicar bloqueos a nivel de fila o página, que pueden ser demasiado restrictivos, el motor de Azure SQL Database puede optar por escalar el bloqueo a un nivel superior (como a nivel de tabla) o utilizar técnicas de versionado de filas (row versioning). Esto permite que múltiples transacciones accedan simultáneamente a diferentes partes de los datos sin interferir entre sí.

Además, los bloqueos optimizados se integran con otras características avanzadas de Azure SQL Database, como las transacciones de larga duración y el procesamiento de consultas en paralelo. El motor de la base de datos tiene la capacidad de ajustar dinámicamente la estrategia de bloqueo según la duración y complejidad de las transacciones, lo que minimiza el impacto en el rendimiento.

TID y LAQ: Las claves para entender esto

Si queremos profundizar en los bloqueos optimizados hay dos conceptos fundamentales que debemos dominar: el Transaction ID (TID) y el Lock Acquisition Queue (LAQ). Estos términos juegan un papel crucial en la forma en que el motor de base de datos gestiona y optimiza los bloqueos, especialmente en entornos con alta concurrencia.

Transaction ID (TID)

El Transaction ID (identificador de transacción) , conocido como TID, es un identificador único asignado por el motor de la base de datos a cada transacción que se inicia en Azure SQL Database. Este identificador es esencial para la gestión de bloqueos, ya que permite al sistema rastrear de manera precisa qué transacción está accediendo a qué recursos en un momento dado. Además, el TID facilita la implementación de estrategias de bloqueo como la escalada de bloqueos y el versionado de filas.

Cuando una transacción se ejecuta en Azure SQL Database, el TID se convierte en la referencia central para todas las operaciones que esa transacción realiza. Cada vez que la transacción intenta leer o modificar un registro, el motor de la base de datos utiliza el TID para determinar si es necesario adquirir un nuevo bloqueo, mantener un bloqueo existente o escalarlo. Esta capacidad de rastreo granular es lo que permite a Azure SQL Database aplicar bloqueos de manera eficiente y minimizar la contención entre transacciones.

El TID también juega un papel fundamental en la resolución de conflictos entre transacciones concurrentes. Si dos transacciones intentan acceder al mismo recurso al mismo tiempo, el motor de la base de datos utilizará los TIDs asociados para decidir cuál transacción obtendrá acceso al recurso y cuál tendrá que esperar o, en casos extremos, finalizará esa transacción y deberá ser reintentada. Este proceso es esencial para mantener la integridad de los datos y evitar condiciones de carrera, donde el resultado de una transacción podría depender del orden en que se completan otras transacciones.

TID en acción

Vamos a ver cómo aplica esto en la práctica con un ejemplo muy sencillo. Para ello partiremos de la siguiente consulta que, como veis, crea una tabla, inserta unos valores y en una transacción actualiza esos registros. Antes de cerrar la transacción consultamos los bloqueos e intentos de bloqueos generados para después cerrar la transacción y borrar la tabla.

Si ejecutamos esto en SQL Server o en una base de datos de una instancia administrada de Azure (Azure Managed Instance) veremos que se generan cuatro registros, tres bloqueos exclusivos a nivel de clave y un intento de bloqueo exclusivo a nivel de página. Os dejo un ejemplo:

No Bloqueos Optimizados TIP

Sin embargo, la misma consulta sobre una base de datos de Azure con bloqueos optimizados solo genera un bloqueo exclusivo a nivel de transacción:

Bloqueos Optimizados TIP

Lock Acquisition Queue (LAQ)

El Lock Acquisition Queue (bloqueo después de la calificación), o LAQ, es otro concepto clave en la gestión de bloqueos optimizados. La LAQ es esencialmente una cola en la que las transacciones esperan para adquirir un bloqueo sobre un recurso determinado. Cuando trabajamos en un entorno de base de datos concurrido, donde múltiples transacciones pueden intentar acceder al mismo recurso simultáneamente, la LAQ nos ayuda a gestionar y organizar estas solicitudes de bloqueo para minimizar el tiempo de espera y evitar conflictos.

Cuando una transacción intenta adquirir un bloqueo sobre un recurso que ya está bloqueado por otra transacción, se coloca en la LAQ correspondiente a ese recurso. A medida que los recursos se van liberando, las transacciones en la LAQ se procesan en orden, lo que garantiza que las transacciones que han estado esperando más tiempo tengan prioridad para acceder al recurso. Este enfoque ayuda a reducir la contención y asegura que las transacciones no se bloqueen indefinidamente, lo que nos podría causar tiempos de espera excesivos y degradación del rendimiento.

La LAQ no solo gestiona el orden en que las transacciones adquieren bloqueos, sino que también juega un papel crucial en la optimización de los bloqueos mismos. En lugar de simplemente otorgar un bloqueo cuando un recurso se libera, el motor de Azure SQL Database utiliza la información en la LAQ para decidir si es necesario escalar el bloqueo a un nivel superior, como a nivel de tabla, o si se puede mantener a un nivel más granular, como a nivel de fila. Esta flexibilidad es clave para maximizar la concurrencia y minimizar la sobrecarga de bloqueo.

LAQ en acción

Si recordáis cuando hablamos de los bloqueos, comentamos que las consultas se evalúan fila a fila para comprobar si se pueden realizar o creando primero un bloqueo compartido de actualización (U). En caso de no haber conflicto ese bloqueo escala a un bloqueo (X) antes de realizar la actualización. Este paradigma cambia cuando tenemos bloqueos optimizados y un nivel de aislamiento Read Committed Snapshot o RCSI (por defecto en las bases de datos de Azure) evaluando ahora las consultas contra la versión confirmada más reciente y en caso de no haber conflicto la transacción adquiere un bloqueo (X) y se completa.

¿Te ha sonado a chino todo esto? No te preocupes que te lo enseño con un ejemplo. Mira esta captura sobre una base de datos de Azure.

Bloqueos Optimizados LAQ 1

En el ejemplo anterior, he creado una tabla en la sesión de la izquierda, introducido tres registros y posteriormente he actualizado el primero dentro de una transacción que no he llegado a confirmar ni revertir la transacción. Mientras tanto, en la sesión de la derecha he actualizado otro de los registros de la tabla sin problema. Esto en SQL Server o en Azure Managed instance generaría un bloqueo y la transacción de la derecha no llegaría a completarse pues, aunque son registros diferentes, la tabla no tiene ningún índice y eso hace que el bloqueo (X) no se realice a nivel de fila. ¿No te lo crees? Te lo demuestro.

No Bloqueos Optimizados LAQ

Beneficios de los Bloqueos Optimizados en entornos de alta concurrencia

Los entornos de alta concurrencia, como en los que solemos trabajar cuando tenemos aplicaciones empresariales críticas, son los que más se benefician de los bloqueos optimizados. En estos escenarios, múltiples usuarios o aplicaciones pueden estar accediendo a la base de datos simultáneamente, realizando lecturas y escrituras en paralelo. Sin una gestión adecuada de los bloqueos, es fácil que se produzcan cuellos de botella, donde una transacción tiene que esperar a que otra libere un recurso.

Con los bloqueos optimizados, Azure SQL Database reduce significativamente la posibilidad de que esto ocurra. Al minimizar el tiempo de bloqueo y ajustar dinámicamente el nivel de bloqueo, nos permite que más transacciones se ejecuten en paralelo sin interferir entre sí. Esto no solo mejora el rendimiento de la base de datos, sino que también reduce el tiempo de respuesta de las aplicaciones que dependen de ella.

Por ejemplo, en una aplicación de comercio electrónico con alta concurrencia de usuarios durante una campaña de ventas, los bloqueos optimizados aseguran que las transacciones de actualización de inventario y procesamiento de pedidos no se bloqueen mutuamente, permitiendo una experiencia de usuario fluida y sin interrupciones.

Inconvenientes de los Bloqueos Optimizados

Aunque los bloqueos optimizados están habilitados por defecto en Azure SQL Database desde Marzo de 2024 y, ahora mismo, no hay manera de deshabilitarlos, es importante que sepamos cómo funciona esta característica para evitar sustos. La clave para ello es entender, tanto la nueva gestión de bloqueos optimizados como el perfil de carga de trabajo de nuestra base de datos. Si bien los bloqueos optimizados son efectivos en la mayoría de los escenarios, ciertos tipos de consultas o transacciones pueden requerir ajustes específicos en la aplicación.

Resultados inesperados 

Acabamos de ver un ejemplo de las bondades de los bloqueos optimizados en combinación con RCSI pero esto tiene más implicaciones. El hecho de que ahora las transacciones de escritura se evalúan contra la versión confirmada almacenada en el snapshot y no se bloqueen nos puede traer resultados inesperados. Por ejemplo suponed que tenemos una tabla con un campo ID de empleado y un campo sueldo. Pongamos que una transacción A quiere actualizar los datos del empleado con ID 1 de 1000 a 1100. Mientras esa transacción no ha terminado, tenemos otra transacción B que quiere actualizar los sueldos mayores que 1001 un 10%. 

En un entorno tradicional de SQL Server la transacción B esperaría al bloqueo de la transacción A y se ejecutaría tras esta, dando un resultado de un sueldo de 1210 para el empleado con ID 1 pues cuando la transacción B se ejecute el update de la transacción A habrá finalizado y el sueldo será de 1100 cumpliendo con la condición de sueldo mayor que 1001. Sin embargo, con los bloqueos optimizados y RCSI la transacción B se evaluaría contra la última versión confirmada (el snapshot de antes de iniciar la transacción A) y, por tanto, el empleado con ID 1 no cumpliría con la condición de la consulta.

Sin bloqueos Optimizados:

NO Bloqueos Optimizados LAQ Issues

Con bloqueos Optimizados:

Bloqueos Optimizados LAQ Issues

¿Podemos hacer algo?

¿Os había dicho que los bloqueos optimizados no se pueden deshabilitar? Vamos a matizarlo. Hemos visto ya que para que funcionen los bloqueos optimizados tenemos que tener habilitado ADR, pues bien esto es como no decir nada pues ADR está habilitado siempre en las bases de datos de Azure sin posibilidad de deshabilitarse. 

Entonces, si no puedo deshabilitar los bloqueos optimizados ni ADR, ¿qué opción tengo? Realmente pocas. Básicamente, nuestra única opción es jugar con los niveles de aislamiento. Por definición esta característica es incompatible con Serializable y con Repeteable Reads por lo que cambiar esta configuración sería nuestra única opción. Y seamos sinceros, esto es una broma de mal gusto, no es viable en una base de datos con alta concurrencia. Aunque, en algunos casos, un nivel de aislamiento más alto puede ser necesario para garantizar la integridad de los datos, esto también incrementa el tiempo de bloqueo, y mucho, haciendo inviable técnicamente esta solución teórica. 

Conclusión

En resumen, los bloqueos optimizados en Azure SQL Database representan un cambio importante en la gestión de concurrencia. Teóricamente para mejorar el rendimiento de nuestras aplicaciones pero, en ocasiones puede ser un problema. En este momento, se hace imprescindible conocer a fondo los conceptos de Transaction ID (TID) y Lock Acquisition Queue (LAQ) para que esta gestión de bloqueos no nos juegue una mala pasada. Podéis pensar que la solución pasa por migrar nuestras bases de datos de Azure a una instancia administrada pero, seamos sinceros ¿Cuanto creeis que tardarán en aplicar este cambio allí también? 

Esto nos genera un debate muy interesante sobre la pérdida de control que hemos sufrido en la nube, especialmente en la infraestructura SAAS. Este caso es especialmente delicado pues un cambio de configuración sin posibilidad de marcha atrás ha cambiado completamente el comportamiento de nuestras aplicaciones pudiendo generar resultados inesperados. Y tú, ¿qué opinas? Te leo en los comentarios.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Mantenimiento imprescindible en SQL Server

El mantenimiento de bases de datos en SQL Server, como en todos los sistemas de bases de datos, es una actividad crítica para garantizar el rendimiento y la estabilidad de las aplicaciones que dependen de ellas. Un enfoque proactivo en la gestión de índices, estadísticas, integridad y copias de seguridad nos permite a los administradores evitar problemas potenciales antes de que se conviertan en fallos costosos. En este artículo, profundizaremos en cada uno de estos aspectos, proporcionando una visión detallada y práctica para mantener nuestras bases de datos en condiciones óptimas.

Mantenimiento de índices para mejorar el rendimiento

Los índices son componentes esenciales en nuestras bases de datos, ya que nos permiten un acceso rápido a los datos y mejoran significativamente el rendimiento de nuestras consultas. Prueba de ello es la cantidad de artículos que les hemos dedicado en el blog. Sin embargo, la eficiencia de los índices puede deteriorarse con el tiempo debido a la fragmentación, que ocurre cuando las páginas de datos se desorganizan. Este fenómeno afecta negativamente la rapidez de las búsquedas y actualizaciones y tenemos que prevenirlo y ponerle solución.

Para mantener un rendimiento óptimo, es crucial que monitoricemos y gestionemos los índices de forma periódica. No vamos a entrar en muchos más detalles pues ya le dedicamos un artículo completo a este tema. Simplemente vamos a ver que tenemos dos opciones de mantenimiento, la reorganización y la reconstrucción. La reorganización de índices es una técnica por la cual el motor de base de datos ajusta los índices sin necesidad de reconstruirlos completamente, lo que es en sí un proceso menos intensivo en recursos. Cuando la fragmentación es alta, la reorganización ya no es tan efectiva y debemos recurrir a la reconstrucción de índices, aunque sea un proceso más costoso en términos de tiempo y recursos. Deberemos planificar estas actividades de mantenimiento durante periodos sin uso o de baja actividad para minimizar el impacto a los usuarios.

Mantenimiento de estadísticas

Las estadísticas en SQL Server proporcionan al optimizador de consultas la información necesaria para decidir cuál es el mejor plan de ejecución posible para nuestra consulta, es decir, cómo ejecutar una consulta de la manera más eficiente posible. Sin datos actualizados, el optimizador puede hacer estimaciones inexactas, lo que lleva a un mal rendimiento.

La actualización regular de las estadísticas es una práctica recomendada para mantener el rendimiento del sistema. SQL Server ofrece opciones de actualización automática, pero en entornos con alta carga de trabajo o donde el rendimiento es crítico, puede ser más efectivo realizar actualizaciones manuales programadas. Esto asegura que las estadísticas reflejen con precisión la distribución actual de los datos, lo que es esencial para que el optimizador pueda generar planes de ejecución óptimos. Además no olvidéis que una actualización de estadísticas fuerza la recopilación de los planes de ejecución por lo que tenemos que buscar el equilibrio para mantenerlas actualizadas sin provocar un exceso de recompilaciones de los planes en caché.

Chequeo de integridad de las bases de datos

La integridad de los datos es un aspecto fundamental en la administración de bases de datos. Gracias a las herramientas de SQL Server, como DBCC CHECKDB, vamos a poder verificar la consistencia física de las bases de datos y de sus datos internos. Esta verificación es crucial para identificar y corregir errores en las estructuras de datos, que pueden surgir por diversas razones, desde fallos del hardware de almacenamiento hasta errores humanos o de consistencia en los datos.

Realizar verificaciones de integridad de manera regular ayuda a detectar problemas antes de que afecten la disponibilidad del sistema o provoquen pérdidas de datos. En caso de encontrarnos con corrupción, deberemos tomar acciones inmediatamente para reparar los daños antes de que puedan ir a más. Para esto intentaremos usar las herramientas disponibles como DBCC CHECKDB y, si no es posible restauraremos los datos desde una copia de seguridad anterior al incidente. 

Una vez resuelta la corrupción tendremos que buscar el origen del problema para evitar que se vuelva a repetir. Las causas más comunes de corrupción son fallos en el almacenamiento o interrupciones inesperadas del servicio (como fallos de alimentación). Es común encontrarse con problemas de corrupción también en instalaciones en sistemas operativos de escritorio que, para ahorrar energía, desconectan la alimentación de los discos duros. Esta configuración debe ser deshabilitada si se instala SQL Server en un sistema operativo de escritorio.

Copias de seguridad como medida de protección esencial

Las copias de seguridad deberían ser la piedra angular de cualquier estrategia de administración de bases de datos. Gracias a estas copias vamos a poder recuperar datos en caso de fallos o desastres, asegurando la continuidad del negocio. Es crucial diseñar un plan de copias de seguridad que considere la frecuencia de los respaldos, la retención y el almacenamiento seguro de los mismos.

Como ya vimos en el artículo que les dedicamos, existen diferentes tipos de copias de seguridad, como completas, diferenciales y de log de transacciones, cada una con su propia función y aplicabilidad. También es vital que realicemos pruebas de restauración periódicas para asegurarnos de que los procedimientos de recuperación funcionarán correctamente cuando sean necesarios. Además, es aconsejable que almacenemos las copias de seguridad en ubicaciones seguras y, si es posible, en lugares distintos geográficamente para protegernos contra desastres locales.

Soluciones de mantenimiento para bases de datos en SQL Server

Para que podamos gestionar eficazmente el mantenimiento de bases de datos en SQL Server podemos contar con herramientas y soluciones que automatizan y optimizan estas tareas. SQL Server ofrece varias herramientas nativas, mientras que otros desarrolladores han creado soluciones adicionales que pueden complementar o incluso superar las capacidades integradas. 

Herramientas nativas de SQL Server para el mantenimiento

SQL Server incluye varias características y herramientas integradas que facilitan la gestión del mantenimiento de bases de datos. Entre ellas, el Mantenimiento de Bases de Datos (Database Maintenance) y el Asistente para Mantenimiento (Maintenance Plan Wizard) son particularmente útiles para automatizar tareas como la reorganización y reconstrucción de índices, la actualización de estadísticas, la verificación de integridad y la realización de copias de seguridad.

Estas herramientas nos permiten a los DBAs configurar trabajos programados (jobs) de manera sencilla, utilizando una interfaz gráfica o scripts Transact-SQL. Sin embargo, aunque son bastante flexibles y suficientes para escenarios no muy complejos, es común encontrarnos con que estas herramientas pueden estar limitadas en cuanto a personalización y control exhaustivo sobre nuestras tareas de mantenimiento.

Soluciones avanzadas de Ola Hallengren

Una de las soluciones más reconocidas y ampliamente utilizadas en la comunidad SQL Server es el conjunto de scripts de mantenimiento desarrollado por Ola Hallengren. Estos scripts son muy configurables y nos proporcionan una solución completa para el mantenimiento de índices, copias de seguridad y verificación de integridad. De esta manera, nos permiten adaptar nuestras tareas de mantenimiento a las necesidades específicas de cada entorno.

Yo siempre recomiendo los scripts de Ola Hallengren ya que destacan por su eficiencia frente a las soluciones nativas. Además tienen una integración con el agente de SQL Server que nos facilita la programación y monitorización de las tareas de mantenimiento. Por último, pero no menos importante, estos scripts son gratuitos y se actualizan regularmente, lo que los convierte en una opción robusta y confiable.

Conclusión

Un mantenimiento adecuado y constante de las bases de datos en SQL Server es esencial para garantizar su rendimiento, disponibilidad y seguridad. La gestión eficiente de índices, la actualización estadísticas, las verificaciones regulares de integridad y una estrategia eficaz de copias de seguridad son pilares fundamentales en esta tarea. Adoptar un enfoque proactivo y planificado nos permite evitar problemas antes de que se conviertan en crisis, asegurando que nuestras bases de datos funcionen de manera óptima y que los datos estén siempre disponibles y protegidos.


Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios
