Empezamos una nueva serie en este video blog sobre como hacer consultas SQL complejas. Uno de los conceptos más importantes y menos conocido del código SQL avanzado es la opción de Pivot y Unpivot para pivotar o despivotar consultas respectivamente.
Gracias a estas opciones de Pivot y Unpivot vamos a poder delegar en el origen SQL agrupaciones avanzadas que, a veces por desconocimiento, estamos haciendo en modelos tabulares con grandes y costosas transformaciones. Como os digo, no son pocas las veces que en informes de Crystal reports o consultas con Power Query tratamos de realizar estas transformaciones no plegables. Con este detalle, haciendo el Pivot en una vista en el origen, podremos optimizar enormemente el rendimiento de nuestros informes.
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Uno de los retos más importantes que vamos a enfrentar cuando trabajamos con datos es la gestión de las fechas y horas. Al igual que nos pasaba con los datos numéricos, elegir el tipo de datos de fecha y/o hora correcto es de vital importancia y no debe ser ignorado. En SQL Server, tenemos a nuestra disposición varios tipos de datos para manejar la fecha y la hora. Pero, ¿sabemos realmente cuándo y cómo utilizar cada uno de ellos? En este artículo, vamos a profundizar en este tema pues no es solo tarea del diseñador de la base de datos sino que, como DBAs tendremos que asesorar al usuario para evitar incidencias con las conversiones de datos en un futuro.
Tipos de Datos de Fecha y Hora
Tanto SQL Server como Azure SQL ofrecen varios tipos de datos para trabajar con fechas y horas: datetime, smalldatetime, date, time, datetime2 y datetimeoffset. Cada uno de ellos tiene unas particularidades y responde a unas necesidades concretas que deberemos conocer para una elección correcta del tipo de dato llegado el momento.
Datetime y SmallDatetime (fecha y hora)
Datetime y SmallDatetime son los tipos de datos más antiguos y existen desde las primeras versiones de SQL Server. Nos van a permitir manejar las fechas y las horas sin demasiada complicación aunque por contra perderemos detalle comparado con otros tipos más modernos. En concreto, Datetime tiene una precisión de hasta 3 milisegundos, mientras que SmallDatetime tiene una precisión de hasta un minuto.
Date y Time (solo fecha y solo hora)
Con la llegada al mercado de SQL Server 2008 se introdujeron los tipos de datos Date y Time. Estos tipos de datos nos permiten almacenar únicamente la fecha o la hora, respectivamente respondiendo así a una necesidad hasta entonces sin cubrir.
Datetime2 (fecha y hora)
Datetime2 es una evolución del tipo de datos datetime que tiene una mayor precisión y un rango de fechas más amplio. Puede tener una precisión de hasta 100 nanosegundos lo que lo convierte en compatible con los estándares ANSI e ISO 8601. Es el tipo de datos que yo te recomendaría usar si estás diseñando una nueva base de datos desde el principio y no te quieres complicar en exceso.
Datetimeoffset (fecha, hora y zona horaria)
Por último, Datetimeoffset es el tipo de datos de fecha y hora más completo que ofrecen SQL Server y Azure SQL. Es similar a datetime2, pero incluye información sobre la zona horaria. Es útil cuando se trabaja con diferentes zonas horarias pero, si no es nuestro caso, este extra de información solo va a conllevar más consumo de espacio y, por tanto, de recursos a la hora de trabajar.
Ejemplos
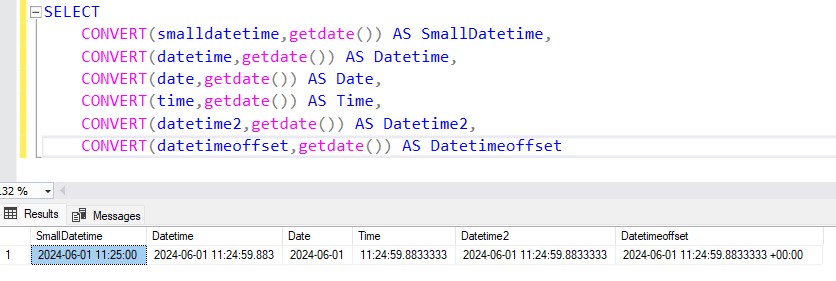
Veamos todos estos tipos de datos en un ejemplo para que se entienda mejor:
Datetime vs Datetime2: Conversiones entre tipos de datos
Como ya hemos visto, Datetime2 es especialmente interesante debido a su gran precisión y rango. Esto, que a priori es una ventaja, puede llevarnos a errores cuando convertimos a Datetime2 desde Datetime. Si os fijáis en la captura del apartado anterior yo he usado la función SYSDATETIME() que devuelve un resultado Datetime2 y no GETDATE() que devuelve Datetime. Veamos el mismo ejemplo con la función GETDATE()
Como veis, al convertir un valor Datetime a Datetime2 no se rellena con 0 la precisión faltante sino que, en este caso, se ha rellenado con un 3 periódico. Si volvéis a leer ahora lo que os he contado de Datetime veréis que os he dicho que la precisión es de hasta 3 milisegundos y en ningún momento os he dicho que tenga una precisión de milisegundos. Es decir, la precisión es de uno entre 300 fracciones de segundo y no de 1/1000 segundos.
Al convertir ese valor Datetime a Datetime2 no tenemos información para completar ese extra de precisión. Además, es imposible representar en un número en base 10 el valor 1/300 por eso vemos ese 333 de manera infinita en los decimales.
Estilos de fecha y hora
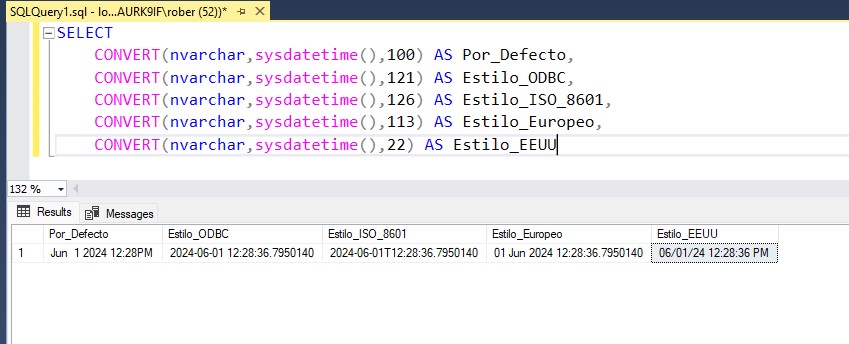
Además de los tipos de datos, un aspecto clave en la representación de las fechas almacenadas en la base de datos es el estilo. Por defecto, se muestra en formato Año, Mes y Dia seguido de la hora en Horas, Minutos, Segundos y Milisegundos. Sin embargo, podremos actuar sobre este comportamiento y elegir el estilo que deseemos con unos valores a la hora de convertir los datos de fecha a texto para su representación.
Manejar correctamente los tipos de datos de fecha y hora en SQL Server o Azure SQL es esencial para mantener la integridad de los datos y realizar cálculos precisos. Aunque puede parecer un tema sencillo al principio es más complejo cuando empiezas a trabajar con ello y a profundizar. Sin embargo, como todo, con un poco de práctica y estudio, se puede dominar. Espero que este artículo te haya ayudado en el dominio de los tipos de datos de fecha en SQL Server y Azure SQL. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Hace aproximadamente un año, Jose Manuel Jurado publicó este artículo en el blog de Microsoft. La verdad es que cuando lo vi me resultó curioso pero no le di mayor importancia, será porque no estaba yo tan enamorado como ahora de las bondades de query store. El caso es que parece que el artículo se me quedó grabado aunque nunca había vuelto a él ni lo había puesto en práctica. Y digo esto porque esta semana, hablando con mis compañeros de trabajo sobre los eventos extendidos y explicándoles cómo xEvents ampliaba con creces las características de SQL Server Profiler, les comenté que podrías crear una sesión que solo capture eventos que desencadenen cierto error.
Esto no es nuevo para vosotros, ya lo vimos aquí. Entonces se me encendió la bombilla y volvió a mi el artículo de José Manuel, ¿y si capturamos con eventos extendidos las consultas con advertencias en sus planes de ejecución?
Por qué xEvents para localizar advertencias
Como os he dicho, la idea de esta solución es una mezcla de curiosidad y mini-reto personal. Sin embargo, se me ocurre que puede ser una solución ideal para varios escenarios gracias a la capacidad de eventos extendidos de activar y desactivar la captura de datos a nuestra voluntad. Esto lo hace ideal para capturar eventos contenidos en el tiempo que nosotros hayamos localizado un problema. Tampoco vamos a necesitar en estos casos el historial de planes de ejecución como nos ofrece Query Store.
Capturando advertencias de conversión con eventos extendidos
Como algunos ya sabéis, un error de conversión de datos puede generar dos tipos de problema: errores de cardinalidad o errores en el plan de búsqueda. Es común que sean ambos pero, vamos a partir de la misma premisa del escenario original y vamos a capturar solo los warning de conversión del tipo “seek plan” o errores en el plan de búsqueda. Además vamos a añadir un par de filtros extra como limitar la captura a sesiones con un session ID mayor de 50 para evitar procesos de usuario y a limitarlo a las bases de datos con un ID mayor que 4 para evitar las bases de datos internas de SQL.
CREATE EVENT SESSION [Convert Warnings] ON SERVER
ADD EVENT sqlserver.plan_affecting_convert(
ACTION(sqlserver.database_name,sqlserver.is_system,sqlserver.sql_text,sqlserver.username)
    WHERE ([package0].[greater_than_uint64]([sqlserver].[session_id],(50)) AND [package0].[equal_uint64]([convert_issue],'Seek Plan') AND [sqlserver].[database_id]>(4)))
ADD TARGET package0.event_file(SET filename=N'Convert Warnings')
WITH (MAX_MEMORY=4096 KB,EVENT_RETENTION_MODE=ALLOW_SINGLE_EVENT_LOSS,MAX_DISPATCH_LATENCY=30 SECONDS,MAX_EVENT_SIZE=0 KB,MEMORY_PARTITION_MODE=NONE,TRACK_CAUSALITY=OFF,STARTUP_STATE=ON)
GO
Y aquí lo podéis ver en funcionamiento:
¿Y el resto de advertencias?
Ahora que hemos visto que mi idea original es viable, ¿por qué quedarnos aquí? Ya vimos en el post sobre planes de ejecución que existen más tipos de advertencias en los planes de ejecución. ¿Y si hacemos una sesión que capture todos esos tipos de alertas? Pues sí mis queridos lectores, claro que os voy a enseñar esto también, ya sabéis que no soy yo de conformarme con poco. Tras indagar un poco en todas las posibles advertencias de planes de ejecución que podemos capturar con xEvents he creado esta sesión que vamos a repasar ahora juntos:
CREATE EVENT SESSION [WARNINGS] ON SERVER
ADD EVENT sqlserver.hash_warning(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.missing_column_statistics(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.missing_join_predicate(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.plan_affecting_convert(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.sort_warning(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.unmatched_filtered_indexes(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4))))
ADD TARGET package0.event_file(SET filename=N'WARNINGS')
WITH (STARTUP_STATE=ON)
GO
Aquí podemos ver varios eventos todos ellos relacionados con advertencias en los planes de ejecución entre los que encontramos:
Hash_warning: Este tipo de advertencia nos indica que la operación hash ha usado más memoria de la disponible y ha tenido que escribir datos en el disco.
Missing_column_statistics: Veremos esta advertencia cuando una consulta accede a una columna que no tiene estadísticas disponibles que podrían haber sido útiles para la optimización de consultas.
Missing_join_predicate: Se produce cuando una consulta ejecutada no tiene un predicado de combinación.
Plan_affecting_convert: Este es el caso que hemos visto en el escenario anterior, hay un error de conversión afectando al plan de ejecución.
Sort_Warning: Indica que la operación de ordenación ha usado más memoria de la disponible y ha tenido que escribir datos en el disco.
Unmatched_filtered_indexes: Este error es causado cuando SQL Server no puede hacer uso de un índice filtrado debido a que la consulta está parametrizada. Y si, esta es una de las limitaciones de SQL Server que más quebraderos de cabeza nos pueden dar.
Además, para cada uno de los eventos se han aplicado los mismos filtros de session ID y Database ID del escenario anterior.
Conclusión
Ya sea con query store como hizo Jose Manuel o con eventos extendidos como hemos visto aquí localizar las consultas con advertencias en sus planes de ejecución para luego arreglar el problema nos ayudará a mejorar el rendimiento de nuestro servidor y a no malgastar recursos. No cometas el error que cometí yo y no esperes un año para ponerte a buscar proactivamente este tipo de problemas. Y si se te ocurre otra forma de conseguir lo mismo dejalo en los comentarios o ponte en contacto conmigo para que te publique un artículo sobre el tema, yo estaré encantado de hacerlo. Somos una comunidad y el objetivo es compartir el conocimiento.
Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Cuando tenemos un SQL Server con licencia standard o enterprise tenemos la opción de comprimir las copias de seguridad. Pero, ¿realmente es buena idea comprimir los backups? ¿se reduce mucho el tamaño? ¿afecta al rendimiento? Eso es justo lo que os trato de demostrar en este video con varias pruebas para que podamos comprobarlo juntos. Si quieres jugar déjame un comentario con lo que crees que va a pasar antes de reproducir el vídeo.
Como has visto, aunque los backups comprimidos van a requerir más recursos de CPU tanto para hacerse como para restaurarse terminan tardando mucho menos. El almacenamiento SIEMPRE es el hardware más lento y por tanto cualquier ahorro en ese recurso se va a notar sobre cualquier otro aspecto. Y esta prueba ha sido con la copia en local, imaginaos que se tiene que llevar por red a un NAS o a la nube dependiendo de nuestra tasa de subida de la conexión a internet, la diferencia sería mucho mayor.
A no ser que tengas problemas de consumo de CPU en tu máquina y el consumo de E/S de disco en el dispositivo de backup no sea un problema para ti mi recomendación es que comprimas los backups.
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Hoy vamos a aprovechar que recientemente se ha liberado SQL 2022 – CU13 para hablar de un proceso a simple vista trivial, pero que requiere de planificación, como es la actualización de SQL Server en los nodos de un grupo de disponibilidad Always On. No es la primera vez que comentamos en el blog la importancia de mantener nuestros SQL Server siempre actualizados para evitar vulnerabilidades graves como la que vimos aquí. En este sentido, nuestros Always On (que además suelen contener la información más crítica) son especialmente delicados. Y es que cualquiera puede ejecutar un parche de actualización y darle a siguiente hasta que termine pero, hacerlo bien, sobre todo en infraestructuras complejas como los Always On, requiere un cariño extra.
¿Qué es un Always On?
Si estás perdido en este punto no te preocupes, vamos a empezar por el principio, los grupos de disponibilidad Always On son una solución de alta disponibilidad que incorpora SQL Server en la que, por medio de un clúster de Windows (WSFC) varios servidores o nodos replican la información de nuestras bases de datos de manera síncrona o asíncrona. Esta es una breve pincelada (más bien un resumen a brocha gorda) de esta complejísima solución, si quieres saber más pásate por el artículo que le dedicamos a este tema.
El proceso de actualización
Cualquier proceso de actualización bien planeado debe constar de 3 fases principales, las pruebas previas (conocidas también como pre-checks), la actualización propiamente dicha y las pruebas finales o post-checks. Cuando hablamos de un Always On esto también va a ser así a grandes rasgos pero va a tener particularidades como pasos previos y posteriores específicos para cada uno de los nodos en función de su rol.
Pasos previos globales para la actualización
Antes de empezar a actualizar nuestros SQL Server del Always On, al igual que en cualquier proceso de actualización, deberemos revisar la documentación de la actualización en busca de errores conocidos o incompatibilidades que puedan hacer que abortemos el proceso antes de iniciarlo.
Una vez que sabemos que la actualización es teóricamente viable, vamos a verificar el entorno, en este punto verificaremos la salud de nuestro Always On (y su quórum) y comprobaremos que hay espacio suficiente en los discos para acometer con éxito el proceso de actualización.
Con todas las comprobaciones finalizadas llega el momento de preparar el entorno, idealmente estaremos en un momento sin ninguna carga de trabajo aunque, en caso de los entornos críticos que requieren de un Always On, esto suele ser inviable. Igualmente nosotros haremos una copia de seguridad de los datos y deshabilitaremos los jobs no críticos para evitar en la medida de lo posible cualquier interferencia en el proceso. En este sentido, también es recomendable deshabilitar el balanceo automático durante todo el proceso.
Actualización paso a paso
Llega el momento de empezar a actualizar, empezaremos siempre por las réplicas secundarias externas de nuestro Always On (en caso de tenerlas) o por las que tengan replicación asíncrona. Estas réplicas tienen la ventaja de no estar sincronizadas en tiempo real con la réplica principal por lo que si algo sale mal el impacto será menor. Empezaremos validando nuevamente el estado de la sincronización (idealmente verificaremos el failover) y deteniendo la replicación de datos para las bases de datos de la réplica a actualizar. Con la replicación detenida aplicaremos el parche de actualización.Una vez aplicado el parche podremos reanudar la sincronización y verificar que todo ha salido bien. Repetiremos estos pasos por todas las réplicas secundarias. Comprobaremos que todas las réplicas tienen los datos actualizados y están sincronizando al finalizar el proceso.
Con todas las réplicas secundarias actualizadas y verificado que no ha habido ningún problema llega el momento más crítico: actualizar el nodo primario. Empezaremos verificando la replicación para garantizar que no haya pérdida de datos y realizando un failover (balanceo) del rol a otro nodo. En este momento el rol principal ya será uno de los actualizados por lo que podremos proceder en este como en los anteriores. Detendremos la replicación, aplicaremos el parche, reanudaremos la sincronización y verificaremos que todo está correcto. En caso de que sea necesario realizaremos otro failover para devolver el rol al nodo principal inicial.
Pasos posteriores a la actualización
Una vez que ya tenemos todos los nodos actualizados es el momento de las comprobaciones finales. Comprobaremos la versión de SQL y que todos los nodos están sincronizando. MUY IMPORTANTE, volveremos a habilitar los jobs que hayamos deshabilitado al inicio y el balanceo automático . Con esto ya habría finalizado el proceso, recuerda que debes prestar especial atención a que las aplicaciones vuelvan a conectar correctamente y al rendimiento global tras la actualización.
¿Por qué detener la sincronización durante la actualización?
Hemos comentado que cuando aplicas un parche a una réplica, ya sea sincrónica o asincrónica, es recomendable parar la replicación de esa réplica durante el proceso de actualización. Os he dicho que antes de aplicar el proceso de actualización de cada nodo debíamos detener la sincronización para habilitarla de nuevo después, justo al terminar ese nodo y antes de empezar con los siguientes. Esto se debe a que la aplicación de un parche puede causar cambios en la base de datos que podrían interrumpir la replicación si ésta sigue activa. Al parar la replicación, te aseguras de que cualquier cambio realizado por el parche no afecte a las otras réplicas hasta que hayas verificado que el parche se ha aplicado correctamente y que la réplica actualizada está funcionando como se espera.
Esto también tiene un punto negativo, cuando detienes la replicación de una base de datos, el nodo principal sigue acumulando los cambios en sus ficheros de log de transacciones por lo que asegúrate de tener suficiente espacio y mantén vigilado en todo momento el crecimiento de los ficheros.
Conclusión
Aplicar un parche de actualización a nuestros servidores siempre es una tarea delicada pero, con una buena planificación y siguiendo los pasos correctos podremos hacerlo sin mayor problema. Recuerda que lo que hemos comentado en este post son una guia de recomendaciones para una actualización perfecta en un entorno ideal, la vida real no siempre es tan idílica y puede que tengamos que prescindir de alguno de los pasos. Sin embargo hay que conocerlos y entender bien el por qué están en esta guía para poder valorar el riesgo de no acometerlos. Y si tienes tus SQL en la nube como bases de datos o instancias administradas de Azure, enhorabuena, te has ahorrado para siempre todos estos pasos.
Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Controlar diariamente el tamaño de nuestras tablas y los ficheros de bases de datos es clave para poder afrontar en el futuro una posible incidencia de espacio en disco. Gracias a esta monitorización en nuestro SQL Server vamos a poder localizar que base de datos y que tabla es la que ha crecido hasta llenar el disco y provocarnos una incidencia. En ocasiones una tabla crece sin control hasta llenar el disco y gracias a esta monitorización del tamaño de las bases de datos y las tablas nos va a ser muy sencillo de localizar. No esperes a que sea tarde y no tengas las herramientas necesarias, monitoriza desde ya tus ficheros.
A continuación te dejo los scripts que he usado para monitorizar el tamaño en el video, recuerda adaptarlos a tu base de datos de monitorización y, en caso de ser necesario, cambiar la verificación de las tablas por un código compatible con tu versión de SQL (pídeme ayuda en los comentarios del video si lo necesitas).
USE [DBA]
GO

/****** Object:  StoredProcedure [dbo].[MonitorTableUsage]    Script Date: 27/05/2024 18:29:26 ******/
SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

-- =============================================
-- Author:		Roberto Carrancio (www.soydba.es)
-- Create date: 04/04/2024
-- Description:	Procedimiento para monitorizar a través del tiempo
-- el crecimiento de las tablas de las BBDD.
-- =============================================
CREATE PROCEDURE [dbo].[MonitorTableUsage]
AS
BEGIN
	-- SET NOCOUNT ON added to prevent extra result sets from
	-- interfering with SELECT statements.
	SET NOCOUNT ON;

IF NOT EXISTS (SELECT 1 FROM sys.tables WHERE name='TableUsage')
BEGIN
	CREATE TABLE TableUsage (
		[Fecha] DATE NOT NULL,
		[BaseDatos] VARCHAR(150) NOT NULL,
		[Esquema]  VARCHAR(150) NOT NULL,
		[Tabla]  VARCHAR(150) NOT NULL,
		[Filas] BIGINT,
		[TamañoTotalMb] FLOAT,
		[EspacioDatosMb] FLOAT,
		[EspacioIndicesMb] FLOAT,
		[EspacioLibreMb] FLOAT,
		CONSTRAINT PK_TableUsage PRIMARY KEY CLUSTERED (Fecha, BaseDatos, Esquema, Tabla)
	)
END

EXEC sp_MSforeachdb 'USE [?]
		IF EXISTS (SELECT 1 FROM sys.databases WHERE is_read_only = 0 and name=''?'')
		BEGIN
		INSERT INTO [DBA].dbo.[TableUsage] ([Fecha], [BaseDatos], [Esquema], [Tabla], [Filas], [TamañoTotalMb], [EspacioDatosMb], [EspacioIndicesMb], [EspacioLibreMb]	)
		SELECT
			GETDATE() Fecha
			,''?'' as BaseDatos
			,a3.name AS SchemaName,
		    a2.name AS TableName,
		    a1.rows as Row_Count,
		    (a1.reserved )* 8.0 / 1024 AS reserved_mb,
		    a1.data * 8.0 / 1024 AS data_mb,
		    (CASE WHEN (a1.used ) > a1.data THEN (a1.used ) - a1.data ELSE 0 END) * 8.0 / 1024 AS index_size_mb,
		    (CASE WHEN (a1.reserved ) > a1.used THEN (a1.reserved ) - a1.used ELSE 0 END) * 8.0 / 1024 AS unused_mb
		FROM    (   SELECT
		            ps.object_id,
		            SUM ( CASE WHEN (ps.index_id < 2) THEN row_count    ELSE 0 END ) AS [rows],
		            SUM (ps.reserved_page_count) AS reserved,
		            SUM (CASE   WHEN (ps.index_id < 2) THEN (ps.in_row_data_page_count + ps.lob_used_page_count + ps.row_overflow_used_page_count)
		                        ELSE (ps.lob_used_page_count + ps.row_overflow_used_page_count) END
		                ) AS data,
		            SUM (ps.used_page_count) AS used
		            FROM sys.dm_db_partition_stats ps
		            GROUP BY ps.object_id
		        ) AS a1
		INNER JOIN sys.all_objects a2  ON ( a1.object_id = a2.object_id )
		INNER JOIN sys.schemas a3 ON (a2.schema_id = a3.schema_id)
		WHERE a2.type <> N''S'' and a2.type <> N''IT''
		option (recompile)
	END'
END
GO

/****** Object:  StoredProcedure [dbo].[Monitorizar_FileGroups]    Script Date: 27/05/2024 18:29:37 ******/
SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO


-- =============================================
-- Author:		Roberto Carrancio (www.soydba.es)
-- Create date: 31/12/2018
-- Description:	Procedimiento para monitorizar a través del tiempo
-- el crecimiento de los ficheros de las BBDD.
-- =============================================
CREATE PROCEDURE [dbo].[Monitorizar_Ficheros]
AS
BEGIN
	-- SET NOCOUNT ON added to prevent extra result sets from
	-- interfering with SELECT statements.
	SET NOCOUNT ON;

IF NOT EXISTS (SELECT 1 FROM sys.tables WHERE name='CRECIMIENTO_FICHEROS')
BEGIN
	CREATE TABLE [dbo].[CRECIMIENTO_FICHEROS](
		[dbname] [nvarchar](128) NULL,
		[Type] [nvarchar](60) NULL,
		[FileName] [nvarchar](128) NULL,
		[FileGroup] [nvarchar](128) NULL,
		[Path] [nvarchar](260) NULL,
		[CurrentSizeMB] [numeric](17, 6) NULL,
		[UsedSpace] [numeric](17, 6) NULL,
		[Fecha] [datetime] NULL
) ON [PRIMARY]
END


EXEC sp_MSforeachdb 'USE [?]
		IF EXISTS (SELECT 1 FROM sys.databases WHERE is_read_only = 0 and name=''?'')
		BEGIN
		INSERT INTO [DBA].dbo.[CRECIMIENTO_FICHEROS]
		([dbname]
		,[Type]
		,[FileName]
		,[FileGroup]
		,[Path]
		,[CurrentSizeMB]
		,[UsedSpace]
		,[Fecha])
		select
		''?''
		,f.type_desc as [Type]
		,f.name as [FileName]
		,fg.name as [FileGroup]
		,f.physical_name as [Path]
		,f.size / 128.0 as [CurrentSizeMB]
		,convert(int,fileproperty(f.name,''SpaceUsed'')) /
			128.0 [UsedSpace]
		,GETDATE() Fecha
	from
		sys.database_files f left outer join
			sys.filegroups fg on
				f.data_space_id = fg.data_space_id
	option (recompile)
	END'
END
GO


USE [msdb]
GO

/****** Object:  Job [MP_Monitor_Crecimiento_Ficheros]    Script Date: 27/05/2024 18:28:50 ******/
BEGIN TRANSACTION
DECLARE @ReturnCode INT
SELECT @ReturnCode = 0
/****** Object:  JobCategory [[Uncategorized (Local)]]    Script Date: 27/05/2024 18:28:51 ******/
IF NOT EXISTS (SELECT name FROM msdb.dbo.syscategories WHERE name=N'[Uncategorized (Local)]' AND category_class=1)
BEGIN
EXEC @ReturnCode = msdb.dbo.sp_add_category @class=N'JOB', @type=N'LOCAL', @name=N'[Uncategorized (Local)]'
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback

END

DECLARE @jobId BINARY(16)
EXEC @ReturnCode =  msdb.dbo.sp_add_job @job_name=N'MP_Monitor_Crecimiento_Ficheros',
		@enabled=1,
		@notify_level_eventlog=0,
		@notify_level_email=0,
		@notify_level_netsend=0,
		@notify_level_page=0,
		@delete_level=0,
		@description=N'No description available.',
		@category_name=N'[Uncategorized (Local)]',
		@owner_login_name=N'sa', @job_id = @jobId OUTPUT
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
/****** Object:  Step [Monitor FileGroups]    Script Date: 27/05/2024 18:28:51 ******/
EXEC @ReturnCode = msdb.dbo.sp_add_jobstep @job_id=@jobId, @step_name=N'Monitor Ficheros',
		@step_id=1,
		@cmdexec_success_code=0,
		@on_success_action=3,
		@on_success_step_id=0,
		@on_fail_action=3,
		@on_fail_step_id=0,
		@retry_attempts=0,
		@retry_interval=0,
		@os_run_priority=0, @subsystem=N'TSQL',
		@command=N'exec dbo.[Monitorizar_Ficheros]',
		@database_name=N'DBA',
		@flags=0
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
/****** Object:  Step [Monitor Tablas]    Script Date: 27/05/2024 18:28:51 ******/
EXEC @ReturnCode = msdb.dbo.sp_add_jobstep @job_id=@jobId, @step_name=N'Monitor Tablas',
		@step_id=2,
		@cmdexec_success_code=0,
		@on_success_action=1,
		@on_success_step_id=0,
		@on_fail_action=2,
		@on_fail_step_id=0,
		@retry_attempts=0,
		@retry_interval=0,
		@os_run_priority=0, @subsystem=N'TSQL',
		@command=N'exec dba.dbo.MonitorTableUsage',
		@database_name=N'DBA',
		@flags=0
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
EXEC @ReturnCode = msdb.dbo.sp_update_job @job_id = @jobId, @start_step_id = 1
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
EXEC @ReturnCode = msdb.dbo.sp_add_jobschedule @job_id=@jobId, @name=N'Daily 23:30',
		@enabled=1,
		@freq_type=4,
		@freq_interval=1,
		@freq_subday_type=1,
		@freq_subday_interval=0,
		@freq_relative_interval=0,
		@freq_recurrence_factor=0,
		@active_start_date=20231017,
		@active_end_date=99991231,
		@active_start_time=233000,
		@active_end_time=235959,
		@schedule_uid=N'15367ccc-1d50-4318-95aa-5c78663dd142'
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
EXEC @ReturnCode = msdb.dbo.sp_add_jobserver @job_id = @jobId, @server_name = N'(local)'
IF (@@ERROR <> 0 OR @ReturnCode <> 0) GOTO QuitWithRollback
COMMIT TRANSACTION
GOTO EndSave
QuitWithRollback:
    IF (@@TRANCOUNT > 0) ROLLBACK TRANSACTION
EndSave:
GO
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Como ya os anuncié la semana pasada, la madrugada del pasado jueves 23 (hora española) tuvo lugar el evento Noches de DBAs en el que, invitado por Alberto de Rossi, pude dar una masterclass sobre niveles de aislamiento en SQL Server para la comunidad Power BI User Group de Lima. Por suerte para todos, esta masterclass está grabada y publicada abiertamente en YouTube. A continuación os comparto la grabación y las diapositivas que vimos en la sesión.
Como sabéis, los niveles de aislamiento y los bloqueos son uno de los temas que más hemos tratado en el blog por lo que a continuación os voy a dejar varios de los artículos en los que podéis profundizar para encontrar más información sobre el tema:
Espero que os haya gustado esta sesión, y que sea la primera de muchas. Dejad vuestro me gusta y comentario para que desde la comunidad nos tengan en cuenta. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Colabora con nosotros
SoyDBA.es es gratis para ti y siempre va a serlo. Sin embargo, a nosotros si que nos cuesta dinero además de mucho esfuerzo. Puedes colaborar con nosotros con un donativo por PayPal o usando nuestros enlaces de afiliado para colaborar sin que te cueste nada. Tenemos enlace de Amazon y de Aliexpress
Para ofrecer las mejores experiencias, utilizamos tecnologías como las cookies para almacenar y/o acceder a la información del dispositivo. El consentimiento de estas tecnologías nos permitirá procesar datos como el comportamiento de navegación o las identificaciones únicas en este sitio. No consentir o retirar el consentimiento, puede afectar negativamente a ciertas características y funciones.
Funcional
Siempre activo
El almacenamiento o acceso técnico es estrictamente necesario para el propósito legítimo de permitir el uso de un servicio específico explícitamente solicitado por el abonado o usuario, o con el único propósito de llevar a cabo la transmisión de una comunicación a través de una red de comunicaciones electrónicas.
Preferencias
El almacenamiento o acceso técnico es necesario para la finalidad legítima de almacenar preferencias no solicitadas por el abonado o usuario.
Estadísticas
El almacenamiento o acceso técnico que es utilizado exclusivamente con fines estadísticos.El almacenamiento o acceso técnico que se utiliza exclusivamente con fines estadísticos anónimos. Sin un requerimiento, el cumplimiento voluntario por parte de tu proveedor de servicios de Internet, o los registros adicionales de un tercero, la información almacenada o recuperada sólo para este propósito no se puede utilizar para identificarte.
Marketing
El almacenamiento o acceso técnico es necesario para crear perfiles de usuario para enviar publicidad, o para rastrear al usuario en una web o en varias web con fines de marketing similares.