cloud

Tipos de dato Fecha y Hora

Uno de los retos más importantes que vamos a enfrentar cuando trabajamos con datos es la gestión de las fechas y horas. Al igual que nos pasaba con los datos numéricos, elegir el tipo de datos de fecha y/o hora correcto es de vital importancia y no debe ser ignorado. En SQL Server, tenemos a nuestra disposición varios tipos de datos para manejar la fecha y la hora. Pero, ¿sabemos realmente cuándo y cómo utilizar cada uno de ellos? En este artículo, vamos a profundizar en este tema pues no es solo tarea del diseñador de la base de datos sino que, como DBAs tendremos que asesorar al usuario para evitar incidencias con las conversiones de datos en un futuro.

Tipos de Datos de Fecha y Hora

Tanto SQL Server como Azure SQL ofrecen varios tipos de datos para trabajar con fechas y horas: datetime, smalldatetime, date, time, datetime2 y datetimeoffset. Cada uno de ellos tiene unas particularidades y responde a unas necesidades concretas que deberemos conocer para una elección correcta del tipo de dato llegado el momento.

Datetime y SmallDatetime (fecha y hora)

Datetime y SmallDatetime son los tipos de datos más antiguos y existen desde las primeras versiones de SQL Server. Nos van a permitir manejar las fechas y las horas sin demasiada complicación aunque por contra perderemos detalle comparado con otros tipos más modernos. En concreto, Datetime tiene una precisión de hasta 3 milisegundos, mientras que SmallDatetime tiene una precisión de hasta un minuto.

Date y Time (solo fecha y solo hora)

Con la llegada al mercado de SQL Server 2008 se introdujeron los tipos de datos Date y Time. Estos tipos de datos nos permiten almacenar únicamente la fecha o la hora, respectivamente respondiendo así a una necesidad hasta entonces sin cubrir.

Datetime2 (fecha y hora)

Datetime2 es una evolución del tipo de datos datetime que tiene una mayor precisión y un rango de fechas más amplio. Puede tener una precisión de hasta 100 nanosegundos lo que lo convierte en compatible con los estándares ANSI e ISO 8601. Es el tipo de datos que yo te recomendaría usar si estás diseñando una nueva base de datos desde el principio y no te quieres complicar en exceso.

Datetimeoffset (fecha, hora y zona horaria)

Por último, Datetimeoffset es el tipo de datos de fecha y hora más completo que ofrecen SQL Server y Azure SQL. Es similar a datetime2, pero incluye información sobre la zona horaria. Es útil cuando se trabaja con diferentes zonas horarias pero, si no es nuestro caso, este extra de información solo va a conllevar más consumo de espacio y, por tanto, de recursos a la hora de trabajar.

Ejemplos

Veamos todos estos tipos de datos en un ejemplo para que se entienda mejor:

FECHA-sysdatetime

Datetime vs Datetime2: Conversiones entre tipos de datos

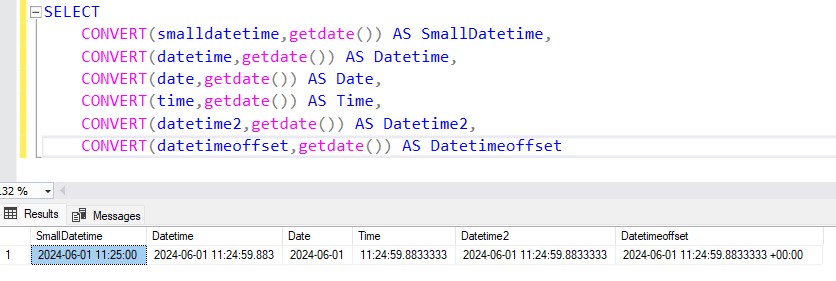
Como ya hemos visto, Datetime2 es especialmente interesante debido a su gran precisión y rango. Esto, que a priori es una ventaja, puede llevarnos a errores cuando convertimos a Datetime2 desde Datetime. Si os fijáis en la captura del apartado anterior yo he usado la función SYSDATETIME() que devuelve un resultado Datetime2 y no GETDATE() que devuelve Datetime. Veamos el mismo ejemplo con la función GETDATE()
FECHA-getdate

Como veis, al convertir un valor Datetime a Datetime2 no se rellena con 0 la precisión faltante sino que, en este caso, se ha rellenado con un 3 periódico. Si volvéis a leer ahora  lo que os he contado de Datetime veréis que os he dicho que la precisión es de hasta 3 milisegundos y en ningún momento os he dicho que tenga una precisión de milisegundos. Es decir, la precisión es de uno entre 300 fracciones de segundo y no de 1/1000 segundos.

Al convertir ese valor Datetime a Datetime2 no tenemos información para completar ese extra de precisión. Además, es imposible representar en un número en base 10 el valor 1/300 por eso vemos ese 333 de manera infinita en los decimales. 

Estilos de fecha y hora

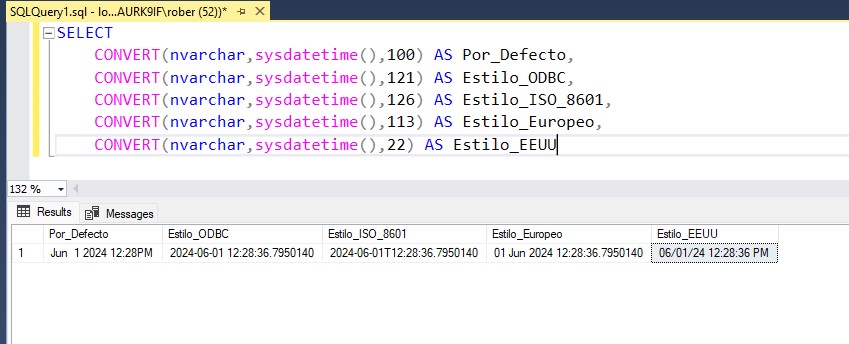
Además de los tipos de datos, un aspecto clave en la representación de las fechas almacenadas en la base de datos es el estilo. Por defecto, se muestra en formato Año, Mes y Dia seguido de la hora en Horas, Minutos, Segundos y Milisegundos. Sin embargo, podremos actuar sobre este comportamiento y elegir el estilo que deseemos con unos valores a la hora de convertir los datos de fecha a texto para su representación.
FECHA-estilos

Podéis encontrar todos los estilos disponibles en esta documentación oficial.

Conclusión

Manejar correctamente los tipos de datos de fecha y hora en SQL Server o Azure SQL es esencial para mantener la integridad de los datos y realizar cálculos precisos. Aunque puede parecer un tema sencillo al principio es más complejo cuando empiezas a trabajar con ello y a profundizar. Sin embargo, como todo, con un poco de práctica y estudio, se puede dominar. Espero que este artículo te haya ayudado en el dominio de los tipos de datos de fecha en SQL Server y Azure SQL. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, 2 comentarios

Localizando advertencias en los planes de ejecución

Hace aproximadamente un año, Jose Manuel Jurado publicó este artículo en el blog de Microsoft. La verdad es que cuando lo vi me resultó curioso pero no le di mayor importancia, será porque no estaba yo tan enamorado como ahora de las bondades de query store. El caso es que parece que el artículo se me quedó grabado aunque nunca había vuelto a él ni lo había puesto en práctica. Y digo esto porque esta semana, hablando con mis compañeros de trabajo sobre los eventos extendidos y explicándoles cómo xEvents ampliaba con creces las características de SQL Server Profiler, les comenté que podrías crear una sesión que solo capture eventos que desencadenen cierto error.

Esto no es nuevo para vosotros, ya lo vimos aquí. Entonces se me encendió la bombilla y volvió a mi el artículo de José Manuel, ¿y si capturamos con eventos extendidos las consultas con advertencias en sus planes de ejecución?

Por qué xEvents para localizar advertencias

Como os he dicho, la idea de esta solución es una mezcla de curiosidad y mini-reto personal. Sin embargo, se me ocurre que puede ser una solución ideal para varios escenarios gracias a la capacidad de eventos extendidos de activar y desactivar la captura de datos a nuestra voluntad. Esto lo hace ideal para capturar eventos contenidos en el tiempo que nosotros hayamos localizado un problema. Tampoco vamos a necesitar en estos casos el historial de planes de ejecución como nos ofrece Query Store. 

Capturando advertencias de conversión con eventos extendidos

Como algunos ya sabéis, un error de conversión de datos puede generar dos tipos de problema: errores de cardinalidad o errores en el plan de búsqueda. Es común que sean ambos pero, vamos a partir de la misma premisa del escenario original y vamos a capturar solo los warning de conversión del tipo “seek plan” o errores en el plan de búsqueda. Además vamos a añadir un par de filtros extra como limitar la captura a sesiones con un session ID mayor de 50 para evitar procesos de usuario y a limitarlo a las bases de datos con un ID mayor que 4 para evitar las bases de datos internas de SQL.

Y aquí lo podéis ver en funcionamiento:

advertencias_xEvents

¿Y el resto de advertencias?

Ahora que hemos visto que mi idea original es viable, ¿por qué quedarnos aquí? Ya vimos en el post sobre planes de ejecución que existen más tipos de advertencias en los planes de ejecución. ¿Y si hacemos una sesión que capture todos esos tipos de alertas? Pues sí mis queridos lectores, claro que os voy a enseñar esto también, ya sabéis que no soy yo de conformarme con poco. Tras indagar un poco en todas las posibles advertencias de planes de ejecución que podemos capturar con xEvents he creado esta sesión que vamos a repasar ahora juntos:

Aquí podemos ver varios eventos todos ellos relacionados con advertencias en los planes de ejecución entre los que encontramos:

  • Hash_warning: Este tipo de advertencia nos  indica que la operación hash ha usado más memoria de la disponible y ha tenido que escribir datos en el disco. 
  • Missing_column_statistics: Veremos esta advertencia cuando una consulta accede a una columna que no tiene estadísticas disponibles que podrían haber sido útiles para la optimización de consultas. 
  • Missing_join_predicate: Se produce cuando una consulta ejecutada no tiene un predicado de combinación.
  • Plan_affecting_convert: Este es el caso que hemos visto en el escenario anterior, hay un error de conversión afectando al plan de ejecución.
  • Sort_Warning: Indica que la operación de ordenación ha usado más memoria de la disponible y ha tenido que escribir datos en el disco. 
  • Unmatched_filtered_indexes: Este error es causado cuando SQL Server no puede hacer uso de un índice filtrado debido a que la consulta está parametrizada. Y si, esta es una de las limitaciones de SQL Server que más quebraderos de cabeza nos pueden dar.

Además, para cada uno de los eventos se han aplicado los mismos filtros de session ID y Database ID del escenario anterior.

Conclusión

Ya sea con query store como hizo Jose Manuel o con eventos extendidos como hemos visto aquí localizar las consultas con advertencias en sus planes de ejecución para luego arreglar el problema nos ayudará a mejorar el rendimiento de nuestro servidor y a no malgastar recursos. No cometas el error que cometí yo y no esperes un año para ponerte a buscar proactivamente este tipo de problemas. Y si se te ocurre otra forma de conseguir lo mismo dejalo en los comentarios o ponte en contacto conmigo para que te publique un artículo sobre el tema, yo estaré encantado de hacerlo. Somos una comunidad y el objetivo es compartir el conocimiento.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

CONTROLAR EL TAMAÑO DE NUESTRAS BASES DE DATOS

Controlar diariamente el tamaño de nuestras tablas y los ficheros de bases de datos es clave para poder afrontar en el futuro una posible incidencia de espacio en disco. Gracias a esta monitorización en nuestro SQL Server vamos a poder localizar que base de datos y que tabla es la que ha crecido hasta llenar el disco y provocarnos una incidencia. En ocasiones una tabla crece sin control hasta llenar el disco y gracias a esta monitorización del tamaño de las bases de datos y las tablas nos va a ser muy sencillo de localizar. No esperes a que sea tarde y no tengas las herramientas necesarias, monitoriza desde ya tus ficheros.

A continuación te dejo los scripts que he usado para monitorizar el tamaño en el video, recuerda adaptarlos a tu base de datos de monitorización y, en caso de ser necesario, cambiar la verificación de las tablas por un código compatible con tu versión de SQL (pídeme ayuda en los comentarios del video si lo necesitas).

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, Videos, 0 comentarios

Masterclass Niveles de Aislamiento en SQL Server

Como ya os anuncié la semana pasada, la madrugada del pasado jueves 23 (hora española) tuvo lugar el evento Noches de DBAs en el que, invitado por Alberto de Rossi, pude dar una masterclass sobre niveles de aislamiento en SQL Server para la comunidad Power BI User Group de Lima. Por suerte para todos, esta masterclass está grabada y publicada abiertamente en YouTube. A continuación os comparto la grabación y las diapositivas que vimos en la sesión.

Como sabéis, los niveles de aislamiento y los bloqueos son uno de los temas que más hemos tratado en el blog por lo que a continuación os voy a dejar varios de los artículos en los que podéis profundizar para encontrar más información sobre el tema:

Espero que os haya gustado esta sesión, y que sea la primera de muchas. Dejad vuestro me gusta y comentario para que desde la comunidad nos tengan en cuenta. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 0 comentarios

Estimación de Cardinalidad en SQL Server

Como DBAs siempre nos encontramos en una constante búsqueda de optimización y mejora del rendimiento de nuestras bases de datos. Esto, antes o después nos lleva a encontrarnos con  un concepto fundamental pero que puede resultar complicado al principio: la estimación de cardinalidad. Este concepto, aunque pueda parecer magia interna de SQL Server, es esencial para entender cómo el motor de base de datos de SQL Server decide el mejor plan de ejecución para ejecutar nuestras consultas. Es decir, es la clave para elegir el camino más óptimo para resolver lo que le hemos pedido.

Estimación de Cardinalidad

Como hemos adelantado ya en la introducción ,la estimación de cardinalidad es el proceso mediante el cual SQL Server trata de predecir el número de filas a las que va a afectar una consulta. No sólo calcula el número total de filas afectadas sino que lo hace con una granularidad total, calculando cuántas filas pasarán por todos y cada uno de los distintos componentes de los planes de ejecución posibles para resolver la consulta. Este número, también conocido como cardinalidad, es crucial para el optimizador de consultas, ya que sin esta información el motor de base de datos no podría elegir el plan de ejecución más eficiente. SQL Server utiliza estadísticas para realizar estas estimaciones de cardinalidad. 

Estadísticas en SQL Server: La base de la cardinalidad

Como acabamos de ver, el optimizador de consultas utiliza las estadísticas para estimar la cardinalidad. Por ejemplo, si estamos buscando registros de en una tabla donde la columna ‘edad’ es mayor que 30, SQL Server utilizará las estadísticas para estimar cuántos registros cumplen con este criterio. Pero, ¿cómo funciona exactamente?

Las estadísticas en SQL Server son objetos que almacenan información sobre la distribución de los valores en una o más columnas de una tabla o vista indexada. Cada objeto de estadísticas está compuesto por un histograma que describe la distribución de los valores, y un vector de densidad que contiene información sobre la correlación de los valores en las columnas.

SQL Server crea y actualiza automáticamente las estadísticas para las columnas indexadas en nuestras tablas y vistas. También podemos crear estadísticas para columnas no indexadas utilizando el comando CREATE STATISTICS, o podemos actualizar las estadísticas existentes utilizando el comando UPDATE STATISTICS.

Es importante tener en cuenta que las estadísticas pueden volverse obsoletas a medida que los datos en nuestras tablas cambian. Cuando esto sucede, las estimaciones de cardinalidad basadas en estas estadísticas pueden ser inexactas.  Esto puede llevar a SQL Server a elegir un plan de ejecución subóptimo, lo que puede resultar en un rendimiento deficiente de la consulta. Otro de los problemas comunes, aunque el plan de ejecución sea el correcto es una asignación de recursos no óptima para la resolución de las consultas lo que puede llevarnos a una profunda degradación de rendimiento.

Planes de Ejecución: El resultado de la estimación de cardinalidad

Un plan de ejecución es, en resumen, una serie de pasos que SQL Server sigue para ejecutar una consulta. Cada paso en el plan de ejecución tiene su propio componente que representa una operación atómica, como un escaneo de tabla, un join, o una operación de ordenación.

El optimizador de consultas de SQL Server utiliza las estadísticas para estimar la cardinalidad y elige el plan de ejecución que tiene el menor costo estimado. El costo de un plan de ejecución se mide en términos de la cantidad de recursos que se espera que consuma, como la CPU, la E/S de disco, y la memoria RAM.

Podemos ver el plan de ejecución de una consulta utilizando la opción SET SHOWPLAN_ALL ON. Esto nos proporcionará una representación gráfica del plan de ejecución, junto con información detallada sobre cada operación en el plan.

No vamos a profundizar mucho más en este sentido pues ya le hemos dedicado a este tema este artículo completo en este blog.

Conclusión

La estimación de cardinalidad es un aspecto esencial en la optimización de consultas en SQL Server. Aunque puede parecer un concepto complejo, entender cómo funciona puede ayudarnos a mejorar significativamente el rendimiento de nuestras bases de datos.

Es importante recordar que las estadísticas, que son la base de la estimación de cardinalidad, deben mantenerse actualizadas para garantizar estimaciones precisas. Como siempre, la clave está en conocer nuestras bases de datos, entender cómo se utilizan y aplicar este conocimiento para optimizar su rendimiento.

En resumen, la estimación de cardinalidad es una herramienta poderosa en nuestras manos. Con un buen entendimiento de cómo funciona, podemos hacer que nuestras bases de datos trabajen de manera más eficiente y efectiva. ¡Sigamos aprendiendo y mejorando juntos!

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

Agenda semanal SoyDBA

Iniciamos una nueva semana con una agenda apasionante, esta semana va a ser muy especial para mí y todo es gracias a vosotros que día a día me apoyáis leyendo y compartiendo mi contenido. Creo que, gracias a vuestro constante apoyo y entusiasmo por aprender cosas nuevas, se está formando una gran comunidad de profesionales alrededor de este blog. Personalmente os estoy profundamente agradecido ya que este apoyo repercute directamente en mi crecimiento personal y desarrollo profesional. ¡GRACIAS POR ACOMPAÑARME EN ESTE MARAVILLOSO PROYECTO!

Ahora, sin más palabrería cursi, me gustaría compartir con vosotros la emocionante agenda de actividades que se nos presenta esta semana esperando que podáis vosotros también participar de ella

Noches de DBAs: primer hito en mi agenda semanal

Como primera actividad de esta semana estaré participando como ponente en el evento Noches de DBAs. Este evento es organizado por Alberto de Rossi para la comunidad de Power BI User Group de Lima en Perú. Es una gran oportunidad para aprender, compartir conocimientos y experiencias con otros profesionales del campo. Nos vamos a enfocar en el lado de la fuente de datos cuando usamos la plataforma de datos Microsoft. Conocer sobre la operación de las fuentes y cómo optimizarlas también es importante para mantener adecuadamente una solución de inteligencia de negocios con Power BI. En esa noche podréis asistir a dos presentaciones a cargo de experimentados DBA. Trataremos los siguientes temas:

  • Niveles de aislamiento en SQL Server y gestión de la concurrencia de los procesos, a cargo de Roberto Carrancio. 
  • Cómo capturar y optimizar los querys ejecutados desde Power BI, a cargo de Alberto De Rossi

Ponentes:

Alberto De Rossi

Alberto es un profesional con más de 20 años de experiencia en tecnologías de la información, dedicado a la consultoría de proyectos relacionados con el diseño, implementación y administración de soluciones de datos e inteligencia de negocios, así como a la capacitación en Azure, Power BI y SQL Server. Cuenta en su haber con el reconocimiento MVP de Microsoft desde hace ya 6 años. Os dejo por aquí su perfil de MVP.

Roberto Carrancio

Roberto, el mismo que escribe estas líneas (y el resto del blog). Como ya sabéis soy DBA de SQL server con más de 10 años de experiencia en el sector. Durante este tiempo he tenido oportunidad de lidiar con proyectos en compañías de todos los tamaños y sectores, desde pymes hasta grandes multinacionales. 

Agenda

Este evento tendrá lugar el Miércoles 22 de Mayo a las 18:30 hora de Perú (GMT-5), lo que en España es el Jueves 23 de Mayo a las 01:30. El evento será online, retransmitido en directo y la asistencia es gratuita, simplemente tenéis que apuntaros aquí para recibir el enlace con la invitación. Una vez concluidas las sesiones, quedarán disponibles abiertamente para su consulta en el canal de Youtube de Power BI User Group Lima. Os dejaré los enlaces en mis redes y posiblemente también en el blog.

Power Platform Madrid 2024 para cerrar la agenda semanal

Después de mi participación en el evento de Lima, asistiré presencialmente al evento Power Platform Madrid 2024 el sábado 25 por la mañana. En esta ocasión, estaré asistiendo como oyente, buscando aprender de otros expertos de la comunidad y mantenerme al día con las últimas tendencias y desarrollos en el sector. Os dejo la descripción del evento en el que podréis encontrar talleres prácticos el viernes 24 y más de 40 ponencias el sábado 25:

Bienvenido a la sesión presencial de Power Platform de Madrid 2024, el evento para profesionales y entusiastas de la tecnología, centrado en la potente herramienta que es Microsoft Power Platform.

Este evento representa una oportunidad única para aquellos que buscan conectar con otros miembros de la comunidad, compartir desafíos y soluciones, y expandir su red de contactos profesionales en un ambiente de colaboración y descubrimiento.

Ya sea que te estés iniciando en estas tecnologías o busques afianzar y expandir tu maestría, este evento está diseñado para inspirar y elevar tus capacidades.

El viernes 24 se celebrarán talleres prácticos dirigidos por grandes profesionales, y el sábado 25 sesiones divulgativas con todo un elenco de ponentes. Puedes consultar todos los detalles en la agenda del evento ¡No te lo pierdas!

Consulta aquí la agenda de talleres y sesiones

Compra aquí tu entrada.

Espero que esta semana llena de nuevas experiencias y aprendizajes para mi os resulte interesante también a vosotros. Me encantaría veros por ahí. Y, por supuesto, estaré aquí para compartir con vosotros todas las novedades y conocimientos adquiridos durante estos eventos. Para terminar, no os preocupéis, el blog va a seguir su programación habitual con artículos y video blogs. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Otros, 0 comentarios

¿Cómo no hacer un DWH? (Parte 2 de 2)

Continuamos donde lo dejamos el otro día en nuestro artículo de ¿cómo no hacer un DWH? y seguimos repasando los errores más comunes a la hora de diseñar un DWH. Si no habéis leído la primera parte os recomiendo hacerlo ahora, antes de este artículo ya que este es la continuación directa de ese primer post. 

Errores del 12 al 7

Antes de empezar con los 6 errores más graves que cometemos a la hora de diseñar un DWH vamos a repasar brevemente los errores que vimos en la primera parte de este artículo.

  • Error 12: Incluir campos de texto en tablas de hechos para filtrar u ordenar
  • Error 11: Escatimar en la información de nuestras dimensiones para ahorrar espacio
  • Error 10: Dividir las jerarquías y en varias dimensiones
  • Error 9: No enfrentar las dimensiones lentamente cambiantes
  • Error 8: No crear foreign keys específicas
  • Error 7: Añadir dimensiones a la tabla de hechos
Banner-Telegram

Errores más graves al crear un DWH

Ahora si, ya conocemos los 6 primeros errores más comunes a la hora de crear nuestro DWH vamos a repasar los 6 que nos quedan, los más graves.

Error 6: Crear el modelo dimensional del DWH a la medida de un informe particular

No hay mucho más que decir, el título lo dice todo. Construir el modelo de datos a medida para los informes que se van a realizar es un grave error que a la larga dificultará mucho el escalado de nuestro DWH y la integración de nuevos reportes. Es común definir primero los objetivos de nuestro DWH y los reportes que los usuarios de negocio van a necesitar previamente antes de la propia arquitectura del modelo, estas definiciones son necesarias pero no pueden ser la base del DWH de fondo. Como arquitectos de datos debemos pensar en todo y dejar el modelo preparado para futuros requisitos. 

Este error es común sobre todo cuando se delega la creación en equipos externos y se definen como objetivos la entrega de unos informes predefinidos. Mucho cuidado con los términos de tu contrato de externalización.

Error 5: Compartir una tabla de hechos para hechos de distinta granularidad

Como sabes, las tablas de hechos pueden acumular miles de millones de registros a lo largo del tiempo y eso hace que operaciones pesadas como agregaciones para, por ejemplo, calcular el total de ventas por meses puedan llevar mucho tiempo y recursos. Una buena solución para eso es persistir ese dato ya agrupado en otra tabla para disponer de él de una manera mucho más rápida. Sin embargo, aunque estemos hablando de los mismos hechos (las ventas en este caso), el detalle y los agregados no tienen la misma granularidad por lo que no deben compartir la misma tabla o a la larga podremos caer en errores de incoherencia de datos.

Error 4: No añadir todo el detalle a la última capa del DWH

Tradicionalmente, los DWH se han dividido en capas, tenemos una primera capa de staging donde cargamos en bruto la información de los sistemas operacionales, una segunda capa relacional (normalmente en un modelo copo de nieve) donde ya la información ha sido integrada y se han añadido las relaciones y una última capa dimensional que será nuestro modelo de estrella con las tablas de agregados adaptadas a nuestros KPIs que consumirán las herramientas de reportes. En la actualidad, esta nomenclatura se está reemplazando por bronce, plata y oro pero sigue respondiendo a los mismos términos.

Podemos pensar que es una buena idea no llevar información que no se va a consumir al modelo de estrella para aligerar el modelo y que las consultas puedan ir más rápido pero, sin embargo, lo que vamos a terminar consiguiendo es que cuando el usuario final necesite esa información tenga que atacar al modelo relacional o en su defecto un extra de trabajo para los equipos de desarrollo BI. En este sentido es mejor opción detallar al máximo la capa dimensional y que sea el usuario desde la herramienta de reporte quien decida qué información mostrar.

Error 3: No usar tablas de agregados

Cuando nos enfrentamos a un problema de rendimiento de nuestro DWH (lo haremos, todos rinden mal) podemos caer en la tentación de añadir más recursos de CPU y RAM cuando lo que normalmente solucionará el problema es crear tablas de agregados para evitar ese recálculo continuo a la hora de mostrar los informes. Las tablas de agregados son un objeto más a mantener y puede parecer que el esfuerzo no merece la pena pero realmente es lo que va a descargar de trabajo a nuestro servidor. Además, para evitar esto, podemos hacer uso de vistas materializadas o vistas indexadas siempre que nuestro gestor de base de datos lo permita.

Error 2: No unificar los hechos entre distintas tablas de hechos de nuestro DWH

En el artículo de ayer, cuando definimos un DWH dijimos que era un sistema donde la información de diferentes orígenes se encuentra integrada. Esto es un verdadero reto a la hora de modelar un DWH y en ocasiones, por necesidades de negocio optamos por separar la información de diferentes orígenes en tablas diferentes para una explotación individual. Esto no tiene nada de malo pero tenemos que tener cuidado y no caer en el error de no unificar los criterios. Aunque la información se encuentre en distintas tablas de hechos debe responder a las mismas dimensiones y tener los mismos criterios para permitir agregaciones entre sí.

Y el mayor error….

Error 1: No ajustar las dimensiones entre tablas de hechos

Cuando modelamos un DWH es común encontrarnos con información duplicada entre diferentes orígenes. Esto se puede ver con mayor frecuencia en los maestros de personas. En ocasiones una misma persona puede ser cliente y proveedor o cliente y empleado. O cliente en dos aplicaciones distintas como la tienda web y la tienda física. Muchas veces, por falta de tiempo, recursos o una mezcla de ambas se cargan los maestros tal cual sin identificar estas dimensiones duplicadas. Esto nos va a llevar a errores a la hora de aplicar agregaciones y filtrados por lo que debemos prestar especial atención a estos casos y dedicar el tiempo y los recursos que sean necesarios para solventarlos. De lo contrario nuestro DWH no cumplirá su función principal de tener la información integrada y unificada.

Conclusión

En esta serie de dos artículos hemos podido ver los errores más comunes a la hora de plantearse la arquitectura de un nuevo DWH. Espero que gracias a estos post no caigáis en estos errores o seáis capaces de subsanarlos a tiempo en caso contrario. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

PD: El artículo original de Kimball fue borrado ya pero por suerte nada escapa del archivo de internet. Podéis encontrarlo aquí.

Publicado por Roberto Carrancio en Rendimiento, 0 comentarios