Rendimiento

DBA vs IA: Fight! La prueba de si la IA te va a quitar el trabajo

Los avances en inteligencia artificial son imparables, eso está claro. Además está claro que son la tendencia en el mercado, parece que términos como big data, cloud o blockchain son cosa del pasado y ahora lo moderno es tener IA hasta en el inodoro. Todas las empresas compiten por añadir IA a sus productos a la par que apuestan por integrar asistentes como ChatGPT o Copilot a sus procesos para facilitar la vida de los trabajadores. Y ojo que a mi me parece muy bien el avance de la IA pero no debemos olvidarnos de nuestra propia inteligencia natural. Por lo menos hasta que esto avance un poco más y vivamos en un mundo donde trabajen robots con IA y nosotros podamos dedicarnos a la holganza más absoluta. No me enrollo más, que lo que os vengo a contar hoy es muy interesante, una prueba más de cómo está ahora la IA en el ámbito de la administración de base de datos. Que cada uno saque sus conclusiones de si puede o no abandonarse a la vida contemplativa gracias a que una máquina complete sus tareas.

Definiendo la prueba 

Os pongo en situación, me encontraba yo desempeñando mis labores diarias, por las que me pagan no estas tareas del blog que lo hago por amor al arte. En ese momento estaba empezando a tomar el control de una nueva instancia de SQL, en concreto una instancia administrada en Azure. Se trata de una instancia compartida por varios microservicios donde cada uno de ellos tiene su base de datos, en principio, totalmente independiente a las demás. Por lo que he podido ver en el resumen de consumo de recursos del portal web de Azure, el uso de CPU es elevado en esta instancia y, por desgracia, ahí se queda todo lo que puedes ver en esta ventana. Igual que cuando miras el activity monitor de un SQL en local la verdad.

Como es un servidor compartido y hay varias bases de datos debo priorizar por lo que lo lógico es empezar por la que mayor consumo hace de los recursos. Partimos de una gran ventaja, al ser Azure Query Store está habilitado por defecto en todas las bases de datos recolectando datos sin que yo haya tenido que decírselo pero, esta es una solución que muestra datos a nivel base de datos y no de instancia. No me sirve de primeras. Necesito otra solución y me parece una buena oportunidad de poner a prueba a la IA antes de tirar de mi navaja suiza de scripts. Como estamos hablando de Azure vamos a hacer que todo quede en casa y preguntar a Copilot.

Será Copilot un buen DBA, pongámoslo a prueba

Os dejo con lo que estáis todos esperando, la conversación íntegra con Copilot. Luego al final os daré mis conclusiones.

Round 1

Roberto:

Tengo una instancia administrada de sql en azure con una docena de bases de datos. Necesito saber cual de las bases de datos tiene un mayor consumo de recursos. ¿Cómo puedo hacerlo?

Copilot:

Para monitorear el consumo de recursos de las bases de datos en una instancia administrada de SQL en Azure, puedes utilizar el servicio de Azure SQL Analytics en Azure Monitor. Aquí te dejo los pasos generales para hacerlo:
Habilita la supervisión de diagnóstico para tu instancia administrada de SQL Server en Azure. Esto se hace en la sección de “Diagnóstico” en la configuración de tu instancia en el portal de Azure.

  1. Configura la exportación de registros a un espacio de trabajo de Log Analytics. Durante la configuración del diagnóstico, puedes elegir enviar los datos a un espacio de trabajo de Log Analytics existente o crear uno nuevo.
  2. Instala la solución de Azure SQL Analytics desde la galería de soluciones en tu espacio de trabajo de Log Analytics.
  3. Una vez que la solución esté instalada y los datos comiencen a fluir, puedes ver los paneles de Azure SQL Analytics para obtener detalles sobre el consumo de recursos. Hay un panel específico llamado “SQL Managed Instance Resource Usage” que proporciona detalles sobre el uso de recursos a nivel de base de datos.

Recuerda que puede llevar algún tiempo hasta que los datos estén disponibles en los paneles después de habilitar la supervisión de diagnóstico.

Espero que esto te ayude a identificar la base de datos que consume más recursos. Si tienes más preguntas, no dudes en preguntar. 😊

Round 2

Roberto:

¿Hay manera de hacerlo desde las herramientas nativas de SQL en SSMS?

Copilot

Sí, puedes usar las herramientas nativas de SQL Server Management Studio (SSMS) para monitorear el consumo de recursos de las bases de datos en una instancia administrada de SQL en Azure. Aquí te dejo los pasos generales para hacerlo:

  1. Conéctate a tu instancia administrada de SQL Server en Azure usando SSMS.
  2. Abre una nueva consulta en la base de datos que deseas monitorear.
  3. Ejecuta una consulta de DMV (Dynamic Management View) para obtener información sobre el consumo de recursos. Por ejemplo, puedes usar la vista sys.dm_db_resource_stats para obtener estadísticas de uso de recursos a nivel de base de datos. Aquí tienes un ejemplo de cómo podría ser esta consulta:

SELECT 

    database_name, 

    avg_cpu_percent, 

    avg_data_io_percent, 

    avg_log_write_percent

FROM 

    sys.dm_db_resource_stats

ORDER BY 

    avg_cpu_percent DESC;

Esta consulta te dará el porcentaje promedio de CPU, I/O de datos y escritura de log utilizados por cada base de datos, ordenados por el uso de CPU.

Por favor, ten en cuenta que estas vistas de gestión dinámica solo mantienen datos de las últimas 2 horas, por lo que si necesitas un seguimiento a largo plazo, te recomendaría utilizar Azure SQL Analytics como mencioné anteriormente.

Espero que esto te ayude a identificar la base de datos que consume más recursos. Si tienes más preguntas, no dudes en preguntar. 😊

Round 3

Roberto:

Esa DMV no tiene database_name

Copilot:

Tienes razón, lamento el error. La vista de gestión dinámica sys.dm_db_resource_stats no incluye el nombre de la base de datos. En su lugar, puedes usar la vista sys.resource_stats para obtener estadísticas de uso de recursos a nivel de base de datos en una instancia administrada de SQL Server en Azure. Aquí tienes un ejemplo de cómo podría ser esta consulta:

SELECT 

    database_name, 

    avg_cpu_percent, 

    avg_data_io_percent, 

    avg_log_write_percent

FROM 

    sys.resource_stats

ORDER BY 

    avg_cpu_percent DESC;

Esta consulta te dará el porcentaje promedio de CPU, I/O de datos y escritura de log utilizados por cada base de datos, ordenados por el uso de CPU.

Por favor, ten en cuenta que sys.resource_stats solo mantiene datos de las últimas 14 días.

Espero que esto te ayude a identificar la base de datos que consume más recursos. Si tienes más preguntas, no dudes en preguntar. 😊

Round 4

Roberto:

El objeto sys.resource_stats al que haces referencia no existe ni en Azure MI ni en SQL Server

Copilot:

Mis disculpas por el error anterior. En las instancias administradas de Azure SQL, no se dispone directamente de una vista de gestión dinámica (DMV) que proporcione el uso de recursos a nivel de base de datos.

Sin embargo, puedes obtener información sobre el uso de recursos a nivel de instancia utilizando la DMV sys.dm_instance_resource_governor_workloads. Aunque esta DMV no desglosa el uso de recursos por base de datos, puede darte una idea del uso total de recursos de tu instancia administrada.

Si necesitas un desglose del uso de recursos a nivel de base de datos, te recomendaría considerar el uso de Azure SQL Insights, que es una característica de Azure Monitor. SQL Insights proporciona una visión más detallada del rendimiento y el uso de recursos a nivel de base de datos.

Lamento cualquier confusión causada y agradezco tu paciencia. Si tienes más preguntas o necesitas más ayuda, no dudes en preguntar. 😊

Round 5: KO

Roberto:

Yo creo que sí que se puede hacer usando esta consulta, ¿es cierto?

SELECT 

        [Database],

        CONVERT (DECIMAL (6, 3), [CPUTimeInMiliSeconds] * 1.0 / 

        SUM ([CPUTimeInMiliSeconds]) OVER () * 100.0) AS [CPUTimeAsPercentage]

     FROM 

      (SELECT 

          dm_execplanattr.DatabaseID,

          DB_Name(dm_execplanattr.DatabaseID) AS [Database],

          SUM (dm_execquerystats.total_worker_time) AS CPUTimeInMiliSeconds

       FROM sys.dm_exec_query_stats dm_execquerystats

       CROSS APPLY 

        (SELECT 

            CONVERT (INT, value) AS [DatabaseID]

         FROM sys.dm_exec_plan_attributes(dm_execquerystats.plan_handle)

         WHERE attribute = N’dbid’

        ) dm_execplanattr

       GROUP BY dm_execplanattr.DatabaseID

      ) AS CPUPerDb

Copilot:

Sí, tienes razón. La consulta que has proporcionado utiliza las vistas de gestión dinámica sys.dm_exec_query_stats y sys.dm_exec_plan_attributes para obtener el tiempo total de CPU utilizado por cada consulta, agrupado por base de datos.

La parte interna de la consulta suma el tiempo de CPU para cada base de datos. La parte externa de la consulta convierte ese tiempo en un porcentaje del tiempo total de CPU.

Por lo tanto, esta consulta te dará una idea de qué bases de datos están consumiendo más tiempo de CPU en tu instancia administrada de SQL Server en Azure.

Gracias por compartir esta consulta, es un buen ejemplo de cómo se pueden utilizar las vistas de gestión dinámica para obtener información detallada sobre el uso de recursos. 😊

Conclusiones de esta prueba

Tontuna natural 1 – Inteligencia Artificial 0. 

Y digo tontuna natural porque he perdido mi tiempo hablando con una máquina cuando ya tenía la respuesta antes de empezar. Y peor aún, he hecho el intento de decirle como lo tiene que hacer como si estos modelos se alimentasen del feedback de los usuarios. Pero bueno, quedémonos con que por lo menos, la prueba me ha servido para llenar un artículo y entreteneros con esta lectura ligera.

Analizando los resultados lo que saco en claro es que Copilot me ha dado más caritas sonrientes que respuestas correctas y, al menos esta es mi impresión, esta es la tónica habitual en cuanto las preguntas se especializan y requieren de experiencia profesional. Y no solo lo digo yo, hablando con más gente el otro día todos comentaban como en fórmulas DAX por ejemplo, Copilot falla más que acierta cuando pasas de preguntas básicas y le exiges un poco. La IA es un gran aliado en tareas repetitivas o sencillas y yo la uso mucho pero siempre hay que tener claras sus limitaciones y supervisar todo lo que nos dice. No estamos aún en situación de poner en producción código generado por IA sin mirarlo y retocarlo.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

SQL vs DAX ¿Quién es más rápido?

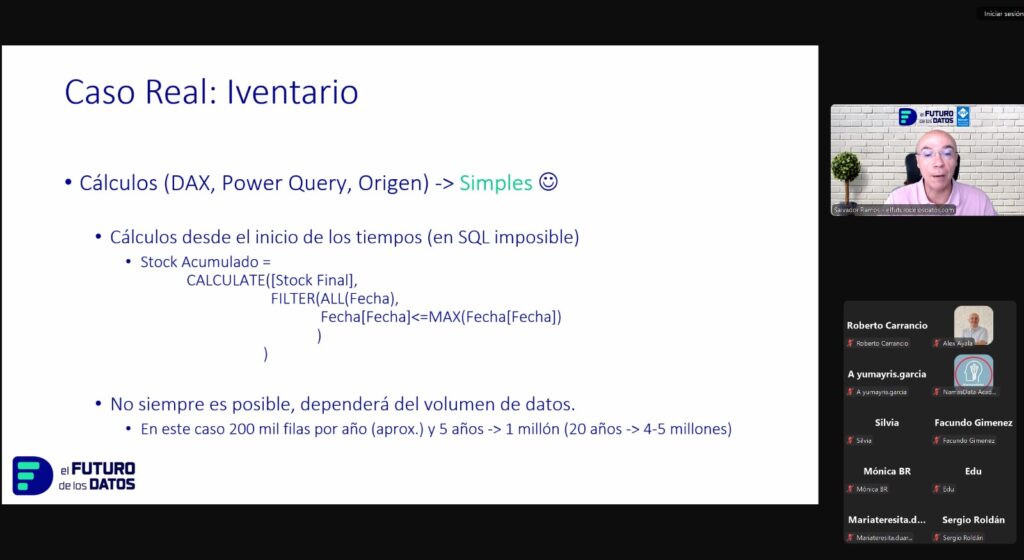
El pasado viernes andaba yo absorto en la masterclass de Salvador Ramos en Nasmasdata cuando, de repente, una diapositiva salvaje apareció. Salva nos hablaba de un cálculo de stock acumulado con su fórmula en DAX porque según ponía en SQL era un cálculo imposible. ¿IMPOSIBLE? Eso era un reto para mí, así que, raudo tomé una captura de pantalla y acepté ese reto. No hubo que esperar mucho, hoy sábado, de buena mañana me he sentado delante del ordenador, he creado una tabla con los datos necesarios para la prueba y me he puesto manos a la obra. No sin antes contactar a Salva e informarle de lo que estaba aconteciendo porque sí amigos, Salva sabe de la existencia de este artículo días antes que vosotros, para la próxima que el reto venga de vosotros y estaréis informados antes. 

SQL-vs-DAX_1

Entendiendo el reto en DAX

Lo primero que tenemos que entender es lo que nos propone el reto, la medida DAX que se ve en la imagen es esta:

Por un lado CALCULATE es una función que cambia una expresión en un contexto de filtro modificado. Como parámetros le hemos pasado [Stock Final] que es una medida o una calculada que nos sumariza los movimientos de stock. Para el segundo parámetro hemos pasado la función FILTER con dos parámetros más, el resultado es que filtra la tabla Fecha para incluir solo las filas donde la fecha es menor o igual a la fecha máxima en el contexto actual.

Convirtiendo el DAX a T-SQL

Ahora que ya sabemos lo que tenemos que obtener vamos a ver como debemos hacerlo en SQL Server, a ver si realmente era imposible o no. He de deciros que mi tabla solo tiene dos columnas fecha y stock. Podriamos haber complicado el escenario añadiendo artículos pero para la demo nos vale sin eso, supongamos que tenemos solo uno. Como luego vamos a llevarnos estas tablas a Power BI tal como están en SQL no hay problema, en DAX vamos a jugar en las mismas condiciones.

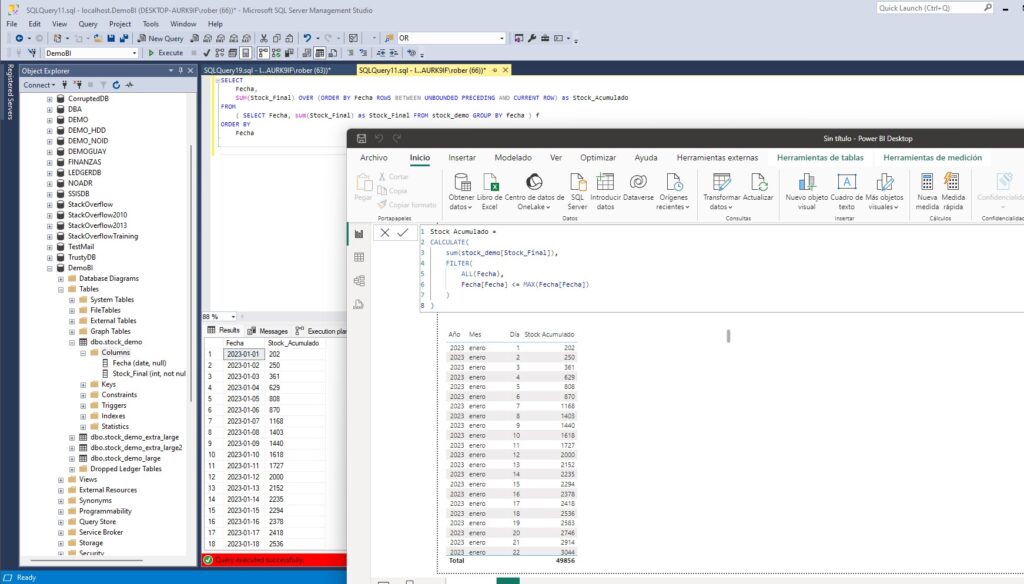
Para empezar vamos a tener que totalizar por dias para saber cuantos movimientos hemos tenido ese día. Luego tenemos que hacer una suma de los valores desde la primera fecha hasta la fecha actual. Eso lo podremos lograr con una función de ventana. Esta sería la consulta imposible:

Vamos a verla paso a paso. En lo primero que nos tenemos que fijar es en la subconsulta del FROM. Es justo lo que comentábamos antes, la suma de los movimientos de stock agrupados por día. Luego, en la consulta principal, estamos utilizando una función de ventana para calcular el Stock_Acumulado. Esta función de ventana SUM() OVER (ORDER BY Fecha ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) suma los valores de Stock_Final en todas las filas desde el inicio de la tabla (UNBOUNDED PRECEDING) hasta la fila actual (CURRENT ROW), ordenadas por Fecha. Esto da como resultado un total acumulativo de Stock_Final hasta la fecha actual.

SQL-vs-DAX_2

Ya lo tenemos, no era imposible. Sin embargo, a lo que Salva se refería era los inconvenientes de realizar los cálculos en SQL por tiempos. Y realmente este es un pensamiento muy extendido en el sector. DAX es más rápido realizando cálculos que SQL Server. Pero, ¿realmente es cierto? Vamos a verlo.

Comparativas de rendimiento DAX vs SQL

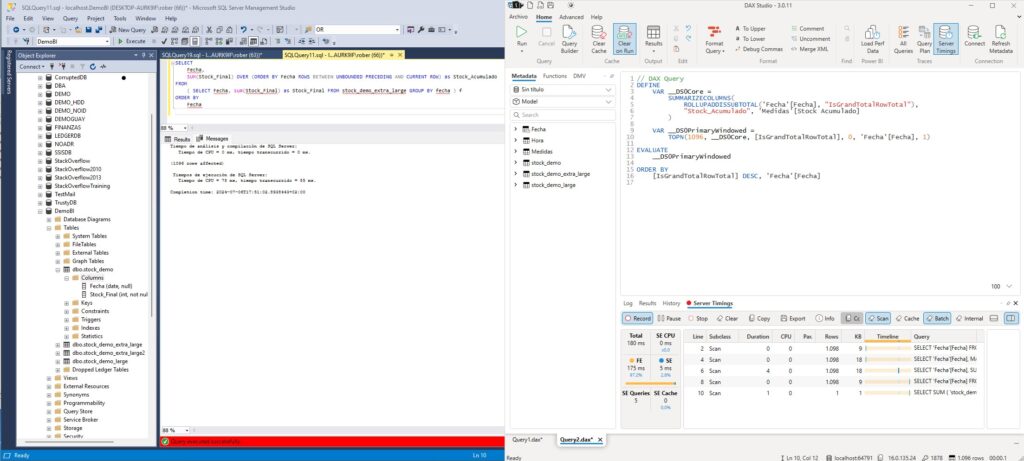
Para que los resultados puedan ser representativos, vamos a hacer las pruebas sobre una tabla con algo más de 1 millón de registros, algo normal en una empresa pequeña. Vamos a analizar dos años de datos de movimientos de stock. Para medir los tiempos de la consulta DAX he sacado la consulta de la tabla y la he llevado a DAX Studio. En SQL vamos a usar las estadísticas de tiempo que podemos sacar con SET STATISTICS TIME ON.

SQL-vs-DAX_3

Como vemos los resultados son demoledores y para nada lo esperado. Analizando 1.010.000 registros repartidos en 1096 fechas distintas SQL Server se ha demorado 85 milisegundos de los cuales 78 ms han sido CPU. En DAX Studio podemos ver que la fórmula DAX para la tabla ha tardado 180 milisegundos, repartidos entre 175 ms del motor de fórmulas (FE) y 5 ms del motor de almacenamiento (SE). 

Complicando el escenario

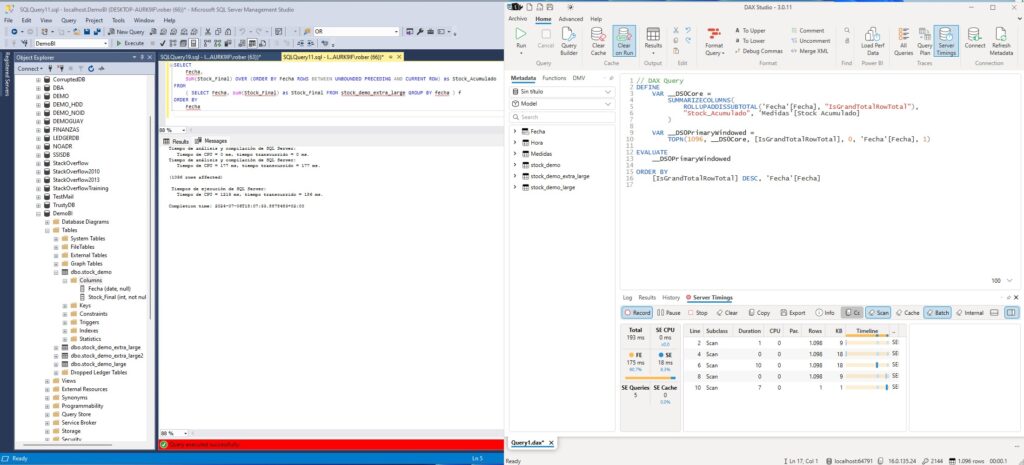
Vamos a pasar de 1 millón a 15 millones de registros a ver si los resultados son distintos. Todos sabemos que el fuerte de Power BI reside en su motor Vertipaq y su gran capacidad de trabajar con grandes cantidades de datos.

SQL-vs-DAX_4

Ahora sí que vemos la gran diferencia de tiempos de la que todo el mundo habla en DAX y Power BI. Con 15 millones de registros los tiempos en SQL Server se han disparado a 1219 milisegundos de CPU aunque paralelizando la consulta se ha resulto en 186 ms. En DAX tenemos un tiempo total de 193 milisegundos repartidos en 175 ms del motor de fórmulas (FE) y 18 ms del motor de almacenamiento (SE). Aunque los tiempos de DAX son mayores a los de SQL no hay tanta diferencia y teniendo en cuenta el paralelismo de SQL podemos deducir un mayor consumo de recursos si ejecutamos los cálculos en origen.

Mejorando los tiempos de SQL

Ya sabemos el objetivo a batir en DAX 193 ms. Veamos qué podemos hacer en SQL. Para empezar vamos a probar con un índice columnar sobre la tabla, al fin y al cabo los índices columnares son la misma tecnología que el motor vertipaq de Power BI.

SQL-vs-DAX_5

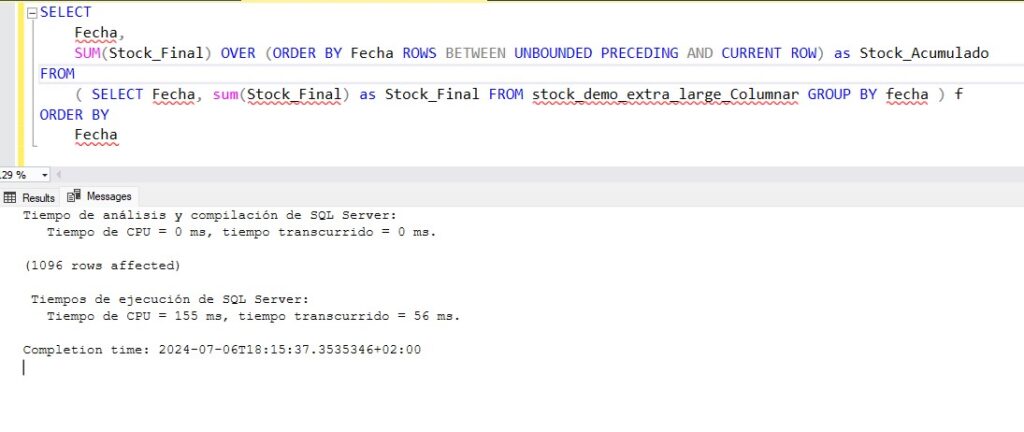
Ahí lo tenemos, ahora sí. Nuestra consulta sobre la tabla con índices columnares ha tardado 155 milisegundos de CPU y solo 56 ms totales al paralelizar. Aun así esto todavía se puede mejorar, ¿recordáis las vistas indexadas? Vamos a probarlo.

SQL-vs-DAX_6

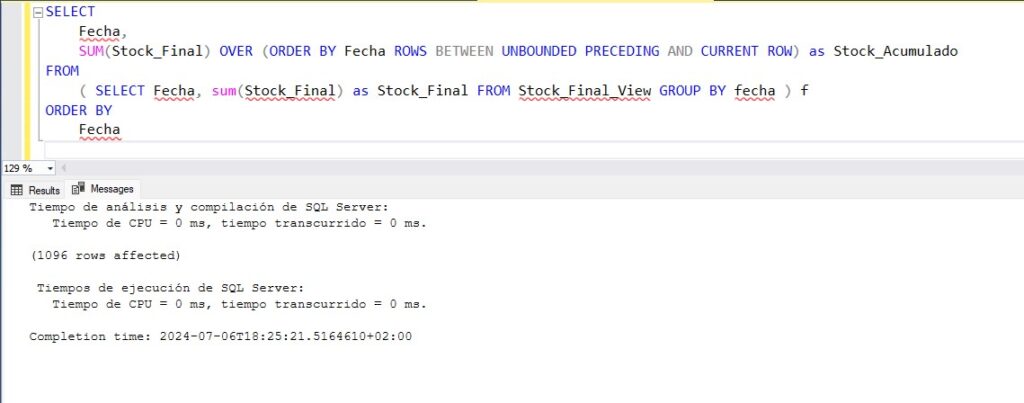
¿Qué os parece el resultado? ¿Os lo esperabais? Con la combinación de índice columnar más vista indexada hemos podido ejecutar la consulta pesada sobre 15 millones de registros en menos de un milisegundo. A mi me ha sorprendido la verdad. No esperaba tanta mejoría.

Es importante destacar que esto es una prueba de concepto en un entorno de laboratorio sin carga de trabajo donde puedo hacer todos los cambios que quiero sobre el SQL sin afectar a ningún otro proceso. Esto es un escenario muy simplificado para la DEMO sin ningún parecido con una base de datos de un ERP de producción. Como siempre digo, primero válida en tus servidores de pruebas y luego, si ves que va bien y no da problemas, piensa en aplicarlo en producción.

Conclusión

SQL sigue más vivo que nunca. Es verdad que DAX es muy potente y seguro que tiene un montón más de optimizaciones de las que yo he sido capaz de aplicar. Os diré que para las pruebas estaba la inteligencia de tiempos desactivada y como dimensión de tiempos estaba usando la plantilla que Salva proporciona gratuitamente en su web que entiendo que es la que usa él. 

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
PD.: Salva, no me importa el resultado de estas pruebas, tu sigues siendo un referente para mi 🙂.

Publicado por Roberto Carrancio en Cloud, Power BI, Rendimiento, SQL Server, 0 comentarios

Anti-Patterns : Nuestro mayor enemigo.

Como DBAs, lo más normal va a ser encontrarnos con consultas que, aunque devuelven el resultado esperado, no están optimizadas y pueden llevar a problemas de rendimiento muy serios. Estos patrones de diseño ineficaces son conocidos como «Query Anti-Patterns» y por muy bien diseñada y optimizada que esté tu base de datos van a dilapidar su rendimiento. Vamos a explorar algunos de los Anti-Patterns más comunes y cómo evitarlos para asegurarnos de que nuestras consultas SQL sean lo más eficientes posible.

Anti-Patterns Comunes y Cómo Evitarlos

La optimización de consultas SQL es una mezcla de arte y ciencia. La habilidad para identificar y corregir anti-patterns en nuestras consultas puede marcar la diferencia entre una base de datos que funciona sin problemas y una que causa dolores de cabeza constantes. Aunque algunos anti-patterns pueden parecer inofensivos a primera vista, su impacto acumulativo, cuando se repiten mucho o se solapan puede ser devastador. En este artículo, vamos a ver varios de estos anti-patterns con ejemplos concretos y soluciones prácticas.

El más común: Select *

Uno de los anti-patterns más comunes y dañinos es el uso de SELECT *. Al seleccionar todas las columnas de una tabla, no solo estamos recuperando datos innecesarios, sino que también podemos estar comprometiendo la seguridad y el rendimiento de nuestra consulta. Este problema se agrava si estamos ante una tabla de un modelo tabular optimizada con índices columnares pues perderemos su gran potencial propio de su diseño, la capacidad de leer solo las columnas necesarias.

Ejemplo:

Solución:

Especificar sólo las columnas necesarias, de esta manera, reducimos la cantidad de datos transferidos y hacemos que nuestra consulta sea más clara y manejable. Además podremos aprovecharnos de índices que cubran completamente nuestras consultas.

Funciones en las Columnas

Usar funciones en las columnas dentro de las cláusulas WHERE es otro anti-pattern que puede degradar significativamente el rendimiento. Las funciones en las columnas evitan que SQL Server use índices, resultando en escaneos de tabla completos. Es lo que se conoce como problemas de sargabilidad de los índices, y consiste en que, al usar un filtro de búsqueda que no se puede aplicar a todos los niveles de la estructura B-tree (árbol invertido), el motor de base de datos tiene que recorrer completamente el nivel hoja buscando coincidencias.

Ejemplo:

Solución:

Reescribir la consulta para evitar la función en la columna. Con esta modificación, permitimos que SQL Server utilice índices sobre OrderDate, mejorando notablemente el rendimiento.

Subconsultas Correlacionadas en el WHERE

Las subconsultas correlacionadas dentro de una cláusula WHERE pueden ser extremadamente costosas, ya que la subconsulta se ejecuta una vez por cada fila en la tabla externa.

Ejemplo:

Solución:

Utilizar un JOIN o CROSS APPLY para evitar la subconsulta correlacionada. Aunque puede haber excepciones en función del tamaño de las tablas, esta aproximación es generalmente más eficiente, ya que la subconsulta se ejecuta una sola vez y los resultados se unen a la tabla principal reduciendo drásticamente el número de lecturas en disco.

Subconsultas en el SELECT

Las subconsultas en la cláusula SELECT pueden causar problemas similares a las subconsultas en WHERE, ya que se ejecutan por cada fila de la tabla principal.

Ejemplo:

Solución:

Usar un JOIN para incluir la información necesaria. De esta forma, la subconsulta se elimina y la consulta puede beneficiarse de una menor cantidad de lecturas.

UNION en Lugar de UNION ALL

El uso de UNION en lugar de UNION ALL puede resultar en un rendimiento deficiente, ya que UNION elimina duplicados, lo cual requiere una operación adicional de ordenación y comparación para lo que es necesario cargar todos los datos en memoria. Es común encontrarse con consultas con UNION por pereza y no escribir los 4 carácteres extra pero, si no es estrictamente necesario nunca es una buena idea.

Ejemplo:

Solución:

Si estamos seguros de que no hay duplicados, usar UNION ALL. De esta manera, evitamos el trabajo adicional de eliminar duplicados y mejoramos la eficiencia de la consulta.

Conversiones Implícitas

Las conversiones implícitas ocurren cuando SQL Server necesita convertir los tipos de datos de una columna o variable para que coincidan. Esto puede tener un impacto negativo en el rendimiento, especialmente cuando involucra columnas indexadas, ya que puede evitar que los índices se utilicen de manera eficiente.

Ejemplo:

En este ejemplo, si OrderID es un entero y estamos comparándolo con una cadena, SQL Server tendrá que convertir OrderID a una cadena para realizar la comparación, lo que puede evitar el uso de índices.

Solución:

Asegurarse de que los tipos de datos coincidan. De esta manera, evitamos la conversión implícita y permitimos que SQL Server utilice los índices de manera eficiente.

Localizando Anti-Patterns con X-Events (ojo, esto ya es muy friki)

Los eventos extendidos son una herramienta muy poderosa en nuestra búsqueda de problemas. Gracias a su capacidad de capturar, en tiempo real, consultas que cumplan unos requisitos establecidos y, a una novedad introducida en SQL Server 2022 como es el evento query_antipattern, nos van a permitir localizar estas consultas mal diseñadas de una manera sencilla. O eso dice la teoría. Os dejo por aquí el script que he usado yo para generar esta sesión de x-events:

Probando los Anti-Patterns X-Events

Ahora que ya hemos visto la teoría vamos a volver al mundo real. Podemos localizar los anti-patterns detectados por este evento extendido si miramos en la DMV sys.dm_xe_map_values que registra los distintos tipos de eventos.

xevents-anti-patterns

Como ves, hay 5 antipatrones, el quinto es el único que coincide con alguno de los que hemos visto nosotros en este artículo. Sobre el resto no hay más documentación, Microsoft ha decidido sacar esta novedad en X-Events pero no lo ha documentado. 

En mis pruebas, he conseguido generar una consulta que active el primero de los tipos de antipatrón, el LargeIn, pero os voy a ser sinceros, no ha sido fácil. Para lograrlo he escrito una consulta con un filtro where CustomerID IN y a continuación le he pasado 2500 parámetros separados por comas. Con menos parámetros no he conseguido hacer saltar la alerta. El antipatrón de conversiones que impiden el Seek sí que es relativamente sencillo verlo y salta ante cualquier consulta con un error de conversión. 

xevents-anti-patterns_2

Sobre el resto no os puedo decir más, llevo más de una semana con este artículo escrito, buscando información y haciendo pruebas pero no lo he conseguido ver. En algún sitio he visto que han conseguido el fallo por un antipatrón LargeNumberOfOrInPredicate con las pruebas que a mi me han dado el LargeIn pero yo no lo he podido reproducir. Igual que ellos no pudieron reproducir el LargeIn. Sobre el resto de tipos de Anti-Patterns no he conseguido más información. No sé qué significa Max en este contexto. En el caso de NonOptimalOrLogic he llegado a pensar que es un problema con las lógicas OR pero no he conseguido reproducirlo ni con 21.500 OR en una misma consulta. Es más, ni con 21.500 OR en una misma consulta mostró ninguno de los otros Anti-Patterns.

Conclusión

Identificar, resolver y evitar estos anti-patterns en nuestras consultas T-SQL puede suponer una mejora significativa en el rendimiento de nuestras bases de datos. Es crucial siempre revisar y optimizar las consultas en ejecución, especialmente en sistemas críticos donde el rendimiento es esencial.Al aplicar buenas prácticas y evitar estos anti-patterns, no solo mejoramos la eficiencia de nuestras consultas, sino que también contribuimos a la estabilidad a largo plazo de nuestras aplicaciones. 

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

MERGE: Una instrucción para dominar a todas (T-SQL Avanzado)

Hoy os he creado un video tutorial detallado sobre cómo usar la función MERGE en T-SQL. He intentado que el video sea una buena herramienta tanto para los principiantes que buscáis entender los fundamentos de MERGE, como para profesionales de SQL que deseen refrescar sus conocimientos.

En este video, desgloso los conceptos fundamentales de la función MERGE y te muestro cómo puedes utilizarla para combinar datos de dos tablas en SQL Server. Aprenderás a realizar operaciones de inserción, actualización y eliminación en una sola instrucción, lo que te permitirá manejar tus datos de manera más eficiente.

Merge

Casos de uso de MERGE

Además de enseñarte cómo usar MERGE, déjame contarte algunos escenarios comunes en los que la función MERGE puede serte especialmente útil. Principalmente la vas a usar para sincronización de tablas (como hemos visto en el video), actualización de datos basada en condiciones específicas o la combinación de datos de múltiples fuentes. Al entender estos casos de uso, podrás ver el verdadero poder de MERGE y cómo puede facilitar tu trabajo con SQL Server con un código más limpio y más eficiente.

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si quieres ver más videos como este puedes encontrarlos todos aquí. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en SQL Server, Videos, 1 comentario

Reducir el tamaño de bases de datos SQL

En esta ocasión vengo a explicaros como puedes hacer para reducir el espacio que ocupan nuestras bases de datos liberando el espacio libre que hay en los ficheros. Para ello, tendremos que hacer un Shrink de los ficheros de base de datos. Tendrás que hacerlo tanto en el ficheros de datos como en el de log (o en el que sepamos que existe un problema).

Evita siempre que puedas la operación de reducir de ficheros, sobre todo en los ficheros de datos, ya que consume muchos recursos del servidor y además va a empeorar el rendimiento de nuestra base de datos. Si no queda más remedio o si has eliminado tanta información que merezca la pena hacerlo, ten la precaución de programarlo fuera de horas de trabajo y de reconstruir los índices fragmentados una vez termines.

En los ficheros de log, como en los de TempDB no vas a tener los problemas de fragmentación pero si de consumo de recursos por lo que aunque no tengamos que ser tan estrictos si debemos intervenir con la debida precaución.

Puedes encontrar los script que he usado en el video aquí. Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, SQL Server, Videos, 0 comentarios

Detectando BLOQUEOS en SQL Server y Azure SQL

Cuando trabajamos con bases de datos SQL Server, los bloqueos pueden ser una de las características de implementación que más dolores de cabeza nos pueden dar como DBAs. A los usuarios también, por supuesto, pero ellos trasladarán sus quejas a nosotros.

Por esto, en el vídeo de hoy, te enseño a detectar bloqueos en SQL Server o Azure SQL. Gracias a procedimientos integrados de sistema como sp_who o sp_who2 podremos verlo de una forma muy básica. Si queremos más nivel de detalle podremos recurrir a procedimientos de terceros como sp_who3, sp_whoisactive o sp_BlitzWho.

Si queremos detectar un bloqueo de una forma rápida y ligera, los procedimientos de sistema sp_who y sp_who2 son un gran aliado. Sin embargo, la información que nos van a mostrar es más bien justa. Si tenemos ocasión, siempre será recomendable de recurrir a procedimientos más completos como los citados en el vídeo.

También podremos hacer uso del siguiente script que nos muestra los procesos con bloqueos:

Como ves, el script hace uso de las vistas de administración dinámica de sistema sys.dm_exec_request y sys.sysprocesses para localizar los bloqueos. Además de la función sys.dm_exec_sql_text para devolver el texto de la consulta que está ejecutando esa sesión. En determinadas ocasiones, dependiendo del bloqueo, es posible que este script no resuelva debido a la función. En esos casos comenta esa parte del código para por lo menos localizar los bloqueos.

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 0 comentarios

Plegado de consultas en Power BI

Si ya has trabajado alguna vez con Power BI, sobre todo si te has interesado por su rendimiento, te sonará el concepto plegado de consultas (query folding en inglés). Este concepto es clave en el rendimiento de power BI y sin embargo a mucha gente se le escapa o no lo comprende muy bien. Hoy, voy a intentar arrojar algo de luz sobre este tema de manera sencilla y para todos los públicos aunque, ya os adelanto que el tema da para mucho y si os interesa al final del artículo os dejo alguna recomendación extra para continuar aprendiendo. 

¿Qué es el plegado de consultas?

Empecemos por el principio, el plegado de consultas, o “Query Folding”, es un proceso por el cual el motor de Power Query (mashup engine) intenta llevar a cabo la mayor cantidad de transformaciones de datos posible en los sistemas de origen origen, en lugar de hacerlo después de que los datos se hayan cargado en la memoria. Esto puede resultar en una mejora significativa del rendimiento de Power BI, especialmente cuando se trabaja con grandes volúmenes de datos.

¿Qué es Power Query?

¡Quieto Roberto! A más de uno le acaba de volar la cabeza con el párrafo anterior. He introducido el concepto Power Query sin explicaros lo que es, perdonadme. Power Query es una característica de Power BI que cumple las funciones de ETL (extraer, transformar y cargar datos). Gracias al motor mashup engine es capaz de extraer datos de varios orígenes, transformar lo que sea necesario y por último cargarlos en un destino. Principalmente vamos a poder encontrar esta función en Power BI, en los flujos de datos de Power BI (dataflows) y en Microsoft Excel 2016 o superiores. Adicionalmente vamos a poder usar Power Query en Excel 2010 y 2013 si descargamos e instalamos manualmente el componente.

¿Cómo funciona el plegado de consultas?

Cuando creamos una consulta con lenguaje M en Power Query, estamos definiendo una serie de pasos para obtener y transformar nuestros datos. Estos pasos pueden incluir filtrado, agrupación, unión de tablas, entre otros. Idealmente, queremos que estos pasos se realicen en el origen de los datos. Esto es lo que se conoce como plegado de consultas y se podrá llevar a cabo en la mayoría de los casos si los orígenes admiten lenguaje SQL y, siempre y cuando, la instrucción M se traduzca en una sola select con funciones que existan en el lenguaje SQL.

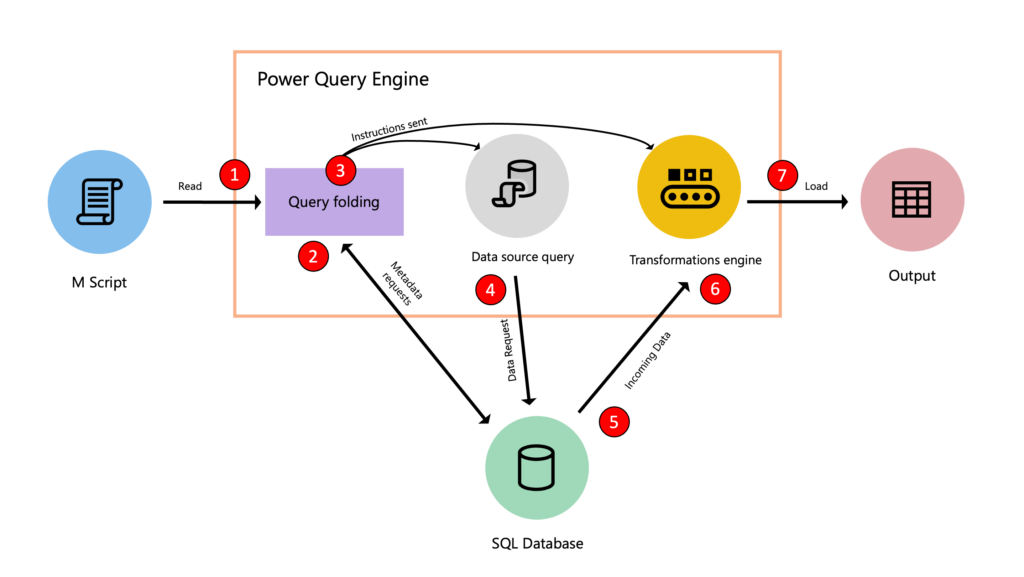
El siguiente diagrama de la documentación oficial de microsoft explica el proceso paso a paso:

Diagrama-plegado-consultas
  1. Power Query recibe el script en código M desde el editor avanzado.
  2. El mecanismo de plegado de consultas envía una consulta de metadatos al origen de datos para evaluar sus características.
  3. El mecanismo de plegado de consultas determina qué información extraer del origen de datos y qué conjunto de transformaciones deben producirse dentro del motor de Power Query. 
  4. Power Query consulta el origen de datos mediante una consulta nativa.
  5. El origen de datos devuelve los datos al motor de Power Query.
  6. Una vez que los datos están en Power Query, el motor de transformación de Power Query (también conocido como motor de mashup) realizará las transformaciones que no se pudieron plegar ni descargar en el origen de datos.
  7. Carga en el modelo de Power BI (o en excel) de los datos extraídos y transformados.

¿Por qué es importante?

El plegado de consultas es especialmente útil cuando trabajamos con grandes conjuntos de datos. Al realizar las transformaciones en el origen de los datos, reducimos la cantidad de datos que necesitamos cargar en la memoria, lo que puede resultar en un rendimiento significativamente mejorado. Si por ejemplo solo necesitamos unas pocas filas y columnas de la tabla de origen, gracias al plegado de consultas no vamos a tener que traer todos los datos para luego filtrarlos. Igualmente si, podemos realizar las uniones entre tablas, agregaciones y ordenados en el origen (que está optimizado para ello) es trabajo que le quitamos a nuestro Power BI.

Tiene otras ventajas, como que Power BI optimizará en gran medida las cargas incrementales de los datos cuando las consultas son 100% plegables ya que si no habría que leer todo el origen y cargarlo en memoria para que el mashup engine cribe las filas nuevas de las ya existentes.

¿Cómo saber si se está realizando el plegado de consultas?

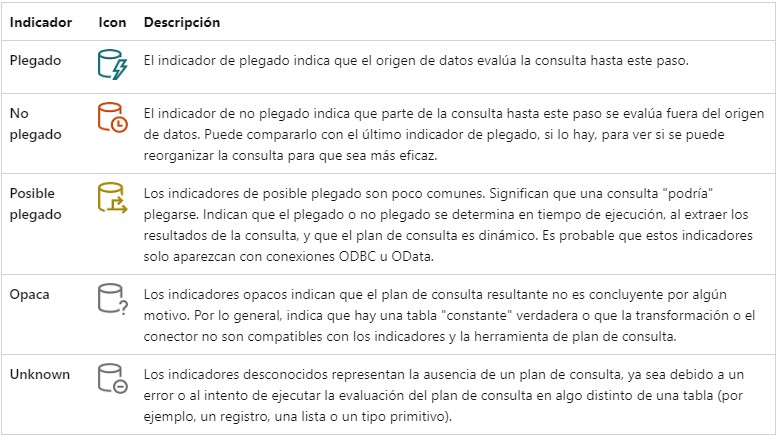
Power Query Dataflows proporciona indicadores visuales que nos permiten saber si se está realizando el plegado de consultas. Estos indicadores se encuentran en la ventana de Power Query y nos muestran qué pasos se están plegando a través de iconos. Esto está muy bien resumido en la documentación oficial así que os dejo directamente el extracto.

Plegado-de-consultas

En Power BI Desktop no va a ser tan sencillo verlo como mirar los iconos al lado de los pasos de la transformación, sin embargo, eso no significa que no podamos verlo. Simplemente con hacer clic derecho sobre el paso y verificar si nos está ofreciendo ver la consulta nativa podremos saber si se mantiene o no el plegado de consultas.

Andrés en nuestro grupo de Telegram añade: «Otra de las formas de saber si el plegado se mantiene, es con la función Value.Metadata (tabla). Devuelve información sobre si existe o no el plegado. Del mismo modo, podemos usar una instrucción para mantener el plegado, es con la función Value.NativeQuery() y con el parámetro EnableFolding=true. Esto nos permitirá enviar una consulta directa a SQL Server, mantener el plegado y poder seguir realizando pasos que mantengan el plegado. El problema es que cuando escribes directamente la consulta desde el conector a SQL Server, la consulta ya no seguirá plegando de ahí en adelante. Por suerte, la función Value.NativeQuery(…), si nos permite esto.«

Niveles de plegado de consulta

Como hemos visto a lo largo de este artículo, existen ciertas operaciones de transformación de datos incompatibles con el plegado de consultas. A esto se le llama romper el plegado de consultas y deberemos evitarlo en la medida de lo posible. Aun así, esto no quiere decir que la consulta ya no se vaya a plegar por tener un paso incompatible, la optimización del motor de Power Query sabrá plegar todos los pasos posibles y solo efectuar en el motor de transformaciones lo estrictamente necesario. En este sentido, nos vamos a encontrar con tres niveles de plegado de consultas:

  • Plegado de consultas completo: Todas las transformaciones de consulta se delegan en el origen de datos. El motor de Power Query realiza un procesamiento mínimo y muy eficiente.
  • Plegado parcial de consultas: Una parte de las transformaciones de la consulta, y no todas, se pueden delegar en el origen de datos. En este caso, una parte de las transformaciones las realiza el origen de datos y el resto se producen en el motor de transformaciones de Power Query.
  • Sin plegado de consultas: La consulta no se puede plegar. Normalmente contiene transformaciones que no se pueden traducir al lenguaje de consulta nativo del origen de datos, ya sea porque las transformaciones no son compatibles o porque el conector no admite el plegado de consultas. En este caso, Power Query obtiene los datos sin procesar del origen de datos y utiliza el motor de Power Query para lograr los datos deseados mediante el procesamiento de las transformaciones necesarias a nivel del motor de Power Query.

Conclusión

El plegado de consultas es un concepto complejo pero crucial para el rendimiento en Power BI. Si trabajas a menudo con Power Query dedica tiempo a entender en profundidad esta funcionalidad y así mejorar considerablemente tus resultados. Por mi parte no me queda más que, como os había prometido al inicio, recomendaros el libro “Power BI Dataflows” de Francisco Mullor para convertiros en unos verdaderos maestros de la herramienta. Si solo os interesa este tema que hemos tratado hoy o si queréis usarlo como aproximación al libro, Fran ha publicado el capítulo dedicado al plegado de consultas de manera que está accesible de manera gratuita aquí. También podéis pasar por la academia virtual de Alex Ayala donde encontraréis cursos de Power BI de gran calidad.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Power BI, Rendimiento, 0 comentarios