Continuamos con los videos de T-SQL avanzado con los modificadores WITH CUBE y WITH ROLLUP. Estos son modificadores de la cláusula GROUP BY. Gracias a WITH CUBE vamos a poder totalizar nuestras agrupaciones junto a los resultados de nuestras consultas y con WITH ROLLUP podremos ver solo totales agrupados por varios campos.
Al igual que comentamos en nuestro anterior video de T_SQL Avanzado el uso de este tipo de consultas en vistas que luego se consumirán desde Power BI nos va a evitar caer en el error de romper el plegado de consultas. También vamos a conseguir con una sola consulta los resultados que, de otra manera, necesitaríamos por lo menos dos consultas, con el doble de lecturas sobre los datos y, por tanto, con mayor consumo de recursos.
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Os voy a contar un caso real. Hace años, trabajando yo en un cliente, empezamos a notar una degradación de rendimiento en determinadas operaciones sobre la base de datos. Pero solo pasaba con las consultas que se ejecutaban desde determinados paquetes SQL Server Integration Services (SSIS). Antes de que podáis pensar que esas consultas no estaban optimizadas os diré que lo estaban, las mismas consultas ejecutadas directamente contra la base de datos funcionaban. Entonces, el problema tenía que estar en SSIS.
La siguiente prueba fue validar la ejecución de un paquete manualmente desde visual estudio y uno ya desplegado en el catálogo.El primero de ellos funcionaba como se esperaba mientras que el ya desplegado tardaba mucho más. ¿Qué estaba pasando? Pues no me enrollo más.
El problema era el mantenimiento (concretamente la falta de mantenimiento) en la base de datos del catálogo SSIS, la SSISDB. Además todo esto se agravaba debido a una mala elección en el nivel de detalle de los logs que deja el catálogo de SSIS.
¿Qué es la SSISDB?
Como hemos dicho, la SSISDB es la base de datos del catálogo de SQL Server Integration Services. En ella se van a desplegar los paquetes, va a almacenar todos sus metadatos (proyectos, entornos, parámetros, etc…) y, además, todo el historial de ejecuciones.
¿Qué mantenimiento necesita la SSISDB?
Como toda base de datos en SQL Server, las tablas sufren variaciones que conlleva fragmentación de los índices. Por este motivo, como cualquier otra base de datos, vamos a tener que implementar un mantenimiento de índices y de estadísticas de las tablas. Además, aunque algunos datos son fácilmente recuperables desplegando de nuevo los proyectos, por seguridad debemos programar chequeos de integridad y copias de seguridad frecuentes.
Mantenimientos específicos de SSISDB
Vale, la SSISDB necesita el mismo mantenimiento que el resto de mis bases de datos pero, además de los mantenimientos de una base de datos normal, existen una serie de consideraciones específicas que debemos tener en cuenta. Como hemos visto, entre otras cosas esta base de datos almacena el historial de ejecuciones de nuestros paquetes y, como todas las tablas de log, estas deben ser purgadas regularmente.
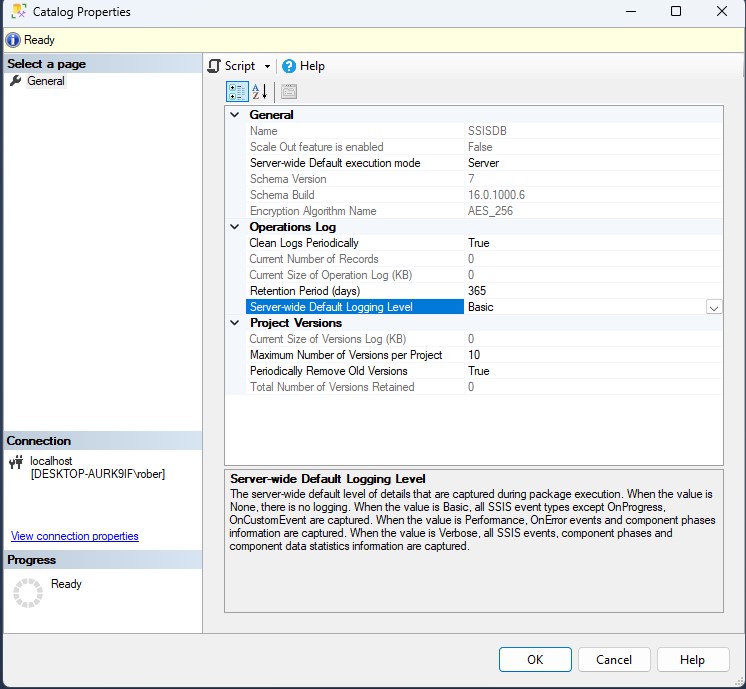
Si accedemos a las propiedades de nuestro catálogo de SSIS vamos a ver que por defecto está habilitada la limpieza de registros antiguos de log con un periodo de retención de un año. Pero, ¿realmente necesitamos un año de log? Para mi la respuesta es no. Y es que yo siempre hablo con mis clientes y nunca hemos considerado necesario más de una semana o un mes a lo sumo. Otra de las opciones que vamos a encontrar en este apartado es el nivel de log que se va a almacenar pero, esto es más extenso y luego volvemos sobre ello.
Antes de meternos de lleno con el nivel de log vamos a ver otra de las opciones de purgado de datos que podemos encontrar en las propiedades del catálogo, el número de versiones de los proyectos. El catálogo de SSIS por defecto almacena un máximo de 10 versiones por proyecto y va limpiando las anteriores. Esta cantidad puede ser correcta o no para ti, valora con el equipo de desarrolladores de los paquetes y ten en cuenta si ya existe otro control de versiones a nivel de desarrollo como un Git.
Nivel de log de SSIS
Como hemos visto antes, el nivel de registro de SSIS es una característica que nos permite a los administradores de bases de datos elegir el nivel de verbosidad del log de ejecuciones de los paquetes SSIS almacenados en el catálogo de integration services. Por defecto consta de cuatro niveles que son Ninguno, Básico, Rendimiento y Detallado.
Ninguno: Como su nombre indica, este nivel no registra ninguna información. Es útil cuando se tiene confianza en el rendimiento del paquete y no se requiere seguimiento.
Básico:Este es el nivel predeterminado y proporciona suficiente información para entender el flujo de ejecución y solucionar problemas comunes.
Rendimiento: Este nivel está diseñado para registrar información que ayuda a solucionar problemas de rendimiento. Registra sólo los eventos necesarios para proporcionar información sobre el rendimiento.
Detallado: Este nivel registra información detallada sobre la ejecución del paquete. Aunque puede ser útil para solucionar problemas complejos, también puede generar una gran cantidad de datos de registro.
Bajo mi punto de vista, y siendo totalmente sincero con vosotros, ninguno de estos 4 niveles se adapta a las necesidades reales de un entorno de producción. No registrar eventos es un peligro y no seríamos capaces de depurar un error, el nivel básico (el predeterminado) almacena demasiada información inutil (he visto hasta reportes de cientos de hojas para una única ejecución de un paquete). Lo mismo me pasa con el nivel de rendimiento que, me da datos que no necesito en mi dia a dia de un servidor productivo. El detallado es para ni plantearselo, para mi, solamente tiene sentido en un servidor de pruebas si estás depurando la ejecución de los paquetes.
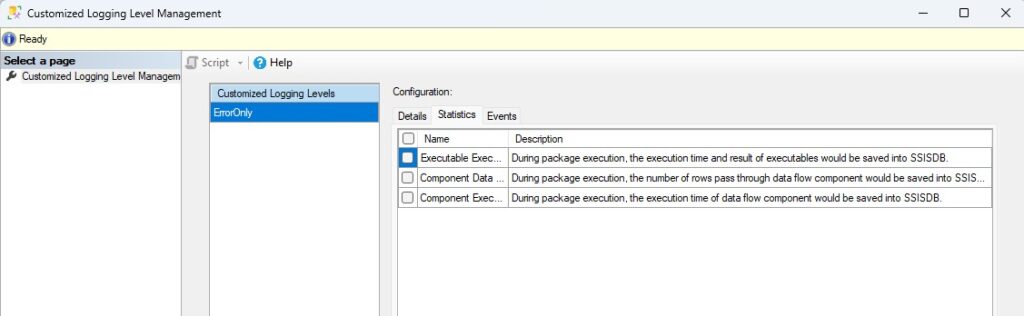
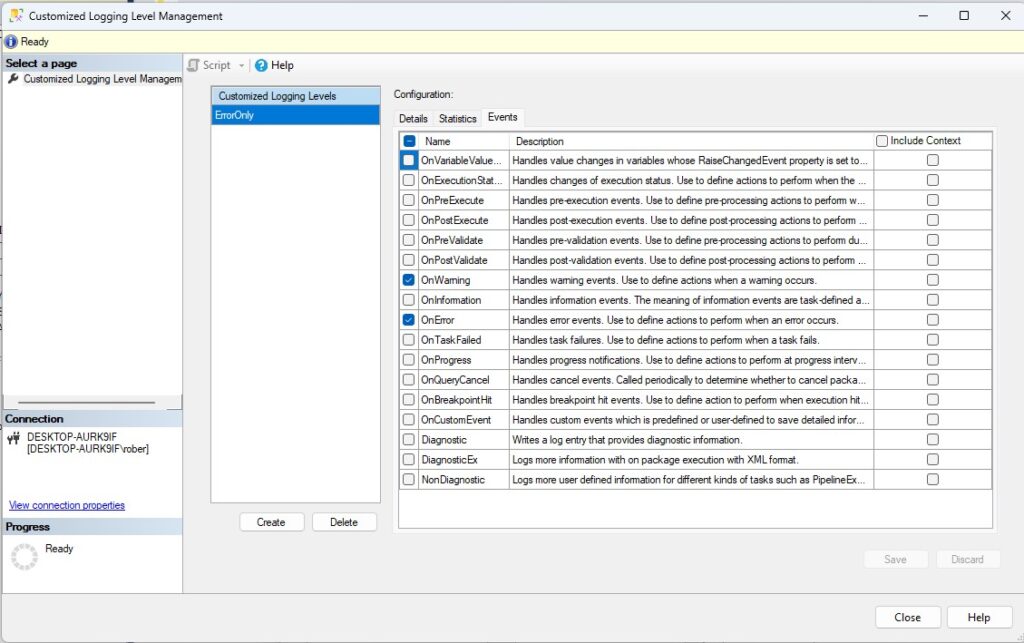
Por suerte para nosotros, existe la posibilidad de crear un nivel de registro personalizado solo con los eventos y las estadísticas que queramos ver. En mi caso, acostumbro a crear un nivel “Solo Errores” que es lo único que me interesa en la mayoría de los casos.
Niveles de log personalizados en SSIS
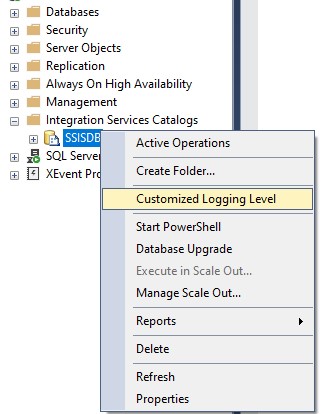
Para crear un nivel de log personalizado lo primero que haremos será acceder a la opción dedicada a este fin en el menú contextual que se abre al hacer clic derecho sobre nuestro catálogo. En la ventana que se nos abrirá podremos crear uno o varios niveles personalizados. En las imágenes os muestro como lo suelo hacer yo.
Una vez creado el nivel personalizado, iremos a las propiedades del catálogo y lo configuraremos como nivel por defecto. Esto hará que todos los nuevos jobs que creemos para ejecutar los paquetes o todas las nuevas ejecuciones manuales de este paquete se hagan bajo este nivel de registro. Sin embargo, todos los jobs que ya existieran antes de cambiar el nivel de log seguirán con el antiguo nivel por defecto (básico si no lo habíais cambiado) por lo que habrá que cambiarlos a mano.
Cambiar el nivel de log para los jobs de SSIS existentes
Uno que ya es perro viejo pero sobre todo es vago, no suele estar por la labor de cambiar cosas a mano en todos los jobs. Sobre todo en entornos donde la cantidad de paquetes es elevada por este motivo tengo una manera de proceder para automatizar el proceso. Os detallo los pasos.
Elijo un paso de un job de ejemplo.
Localizo el paso seleccionado en la tabla msdb.dbo.sysjobstesps y copio el campo command.
Cambio a mano el nivel de log para ese paso.
Vuelvo a la tabla msdb.dbo.sysjobstesps y copio nuevamente el campo command.
Creo un script para reemplazar en todos los pasos tipo ‘SSIS’ los cambios que he observado en el campo.
Por ejemplo:
UPDATE msdb.dbo.sysjobsteps
SET command = REPLACE(command, '$ServerOption::LOGGING_LEVEL(Int16)\"";1 ','$ServerOption::LOGGING_LEVEL(Int16)\"";100 /Par "\"$ServerOption::CUSTOMIZED_LOGGING_LEVEL\"";ErrorOnly ')
WHERE subsystem='SSIS'
Conclusión
Una buena gestión y administración de nuestro catálogo SSIS es crucial para su futuro rendimiento. Dedica el tiempo que necesites a estas optimizaciones, los usuarios lo van a agradecer. Por otro lado, puede ser interesante configurar niveles con más detalle de log en tus servidores de pruebas para facilitar el debugueado a los desarrolladores. Solo tu conoces tu entorno, comentalo con los usuarios y, seguro, conseguirás el equilibrio perfecto.
Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Hace aproximadamente un año, Jose Manuel Jurado publicó este artículo en el blog de Microsoft. La verdad es que cuando lo vi me resultó curioso pero no le di mayor importancia, será porque no estaba yo tan enamorado como ahora de las bondades de query store. El caso es que parece que el artículo se me quedó grabado aunque nunca había vuelto a él ni lo había puesto en práctica. Y digo esto porque esta semana, hablando con mis compañeros de trabajo sobre los eventos extendidos y explicándoles cómo xEvents ampliaba con creces las características de SQL Server Profiler, les comenté que podrías crear una sesión que solo capture eventos que desencadenen cierto error.
Esto no es nuevo para vosotros, ya lo vimos aquí. Entonces se me encendió la bombilla y volvió a mi el artículo de José Manuel, ¿y si capturamos con eventos extendidos las consultas con advertencias en sus planes de ejecución?
Por qué xEvents para localizar advertencias
Como os he dicho, la idea de esta solución es una mezcla de curiosidad y mini-reto personal. Sin embargo, se me ocurre que puede ser una solución ideal para varios escenarios gracias a la capacidad de eventos extendidos de activar y desactivar la captura de datos a nuestra voluntad. Esto lo hace ideal para capturar eventos contenidos en el tiempo que nosotros hayamos localizado un problema. Tampoco vamos a necesitar en estos casos el historial de planes de ejecución como nos ofrece Query Store.
Capturando advertencias de conversión con eventos extendidos
Como algunos ya sabéis, un error de conversión de datos puede generar dos tipos de problema: errores de cardinalidad o errores en el plan de búsqueda. Es común que sean ambos pero, vamos a partir de la misma premisa del escenario original y vamos a capturar solo los warning de conversión del tipo “seek plan” o errores en el plan de búsqueda. Además vamos a añadir un par de filtros extra como limitar la captura a sesiones con un session ID mayor de 50 para evitar procesos de usuario y a limitarlo a las bases de datos con un ID mayor que 4 para evitar las bases de datos internas de SQL.
CREATE EVENT SESSION [Convert Warnings] ON SERVER
ADD EVENT sqlserver.plan_affecting_convert(
ACTION(sqlserver.database_name,sqlserver.is_system,sqlserver.sql_text,sqlserver.username)
    WHERE ([package0].[greater_than_uint64]([sqlserver].[session_id],(50)) AND [package0].[equal_uint64]([convert_issue],'Seek Plan') AND [sqlserver].[database_id]>(4)))
ADD TARGET package0.event_file(SET filename=N'Convert Warnings')
WITH (MAX_MEMORY=4096 KB,EVENT_RETENTION_MODE=ALLOW_SINGLE_EVENT_LOSS,MAX_DISPATCH_LATENCY=30 SECONDS,MAX_EVENT_SIZE=0 KB,MEMORY_PARTITION_MODE=NONE,TRACK_CAUSALITY=OFF,STARTUP_STATE=ON)
GO
Y aquí lo podéis ver en funcionamiento:
¿Y el resto de advertencias?
Ahora que hemos visto que mi idea original es viable, ¿por qué quedarnos aquí? Ya vimos en el post sobre planes de ejecución que existen más tipos de advertencias en los planes de ejecución. ¿Y si hacemos una sesión que capture todos esos tipos de alertas? Pues sí mis queridos lectores, claro que os voy a enseñar esto también, ya sabéis que no soy yo de conformarme con poco. Tras indagar un poco en todas las posibles advertencias de planes de ejecución que podemos capturar con xEvents he creado esta sesión que vamos a repasar ahora juntos:
CREATE EVENT SESSION [WARNINGS] ON SERVER
ADD EVENT sqlserver.hash_warning(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.missing_column_statistics(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.missing_join_predicate(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.plan_affecting_convert(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.sort_warning(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4)))),
ADD EVENT sqlserver.unmatched_filtered_indexes(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE (([sqlserver].[session_id]>(50)) AND ([sqlserver].[database_id]>(4))))
ADD TARGET package0.event_file(SET filename=N'WARNINGS')
WITH (STARTUP_STATE=ON)
GO
Aquí podemos ver varios eventos todos ellos relacionados con advertencias en los planes de ejecución entre los que encontramos:
Hash_warning: Este tipo de advertencia nos indica que la operación hash ha usado más memoria de la disponible y ha tenido que escribir datos en el disco.
Missing_column_statistics: Veremos esta advertencia cuando una consulta accede a una columna que no tiene estadísticas disponibles que podrían haber sido útiles para la optimización de consultas.
Missing_join_predicate: Se produce cuando una consulta ejecutada no tiene un predicado de combinación.
Plan_affecting_convert: Este es el caso que hemos visto en el escenario anterior, hay un error de conversión afectando al plan de ejecución.
Sort_Warning: Indica que la operación de ordenación ha usado más memoria de la disponible y ha tenido que escribir datos en el disco.
Unmatched_filtered_indexes: Este error es causado cuando SQL Server no puede hacer uso de un índice filtrado debido a que la consulta está parametrizada. Y si, esta es una de las limitaciones de SQL Server que más quebraderos de cabeza nos pueden dar.
Además, para cada uno de los eventos se han aplicado los mismos filtros de session ID y Database ID del escenario anterior.
Conclusión
Ya sea con query store como hizo Jose Manuel o con eventos extendidos como hemos visto aquí localizar las consultas con advertencias en sus planes de ejecución para luego arreglar el problema nos ayudará a mejorar el rendimiento de nuestro servidor y a no malgastar recursos. No cometas el error que cometí yo y no esperes un año para ponerte a buscar proactivamente este tipo de problemas. Y si se te ocurre otra forma de conseguir lo mismo dejalo en los comentarios o ponte en contacto conmigo para que te publique un artículo sobre el tema, yo estaré encantado de hacerlo. Somos una comunidad y el objetivo es compartir el conocimiento.
Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Cuando tenemos un SQL Server con licencia standard o enterprise tenemos la opción de comprimir las copias de seguridad. Pero, ¿realmente es buena idea comprimir los backups? ¿se reduce mucho el tamaño? ¿afecta al rendimiento? Eso es justo lo que os trato de demostrar en este video con varias pruebas para que podamos comprobarlo juntos. Si quieres jugar déjame un comentario con lo que crees que va a pasar antes de reproducir el vídeo.
Como has visto, aunque los backups comprimidos van a requerir más recursos de CPU tanto para hacerse como para restaurarse terminan tardando mucho menos. El almacenamiento SIEMPRE es el hardware más lento y por tanto cualquier ahorro en ese recurso se va a notar sobre cualquier otro aspecto. Y esta prueba ha sido con la copia en local, imaginaos que se tiene que llevar por red a un NAS o a la nube dependiendo de nuestra tasa de subida de la conexión a internet, la diferencia sería mucho mayor.
A no ser que tengas problemas de consumo de CPU en tu máquina y el consumo de E/S de disco en el dispositivo de backup no sea un problema para ti mi recomendación es que comprimas los backups.
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Como ya os anuncié la semana pasada, la madrugada del pasado jueves 23 (hora española) tuvo lugar el evento Noches de DBAs en el que, invitado por Alberto de Rossi, pude dar una masterclass sobre niveles de aislamiento en SQL Server para la comunidad Power BI User Group de Lima. Por suerte para todos, esta masterclass está grabada y publicada abiertamente en YouTube. A continuación os comparto la grabación y las diapositivas que vimos en la sesión.
Como sabéis, los niveles de aislamiento y los bloqueos son uno de los temas que más hemos tratado en el blog por lo que a continuación os voy a dejar varios de los artículos en los que podéis profundizar para encontrar más información sobre el tema:
Espero que os haya gustado esta sesión, y que sea la primera de muchas. Dejad vuestro me gusta y comentario para que desde la comunidad nos tengan en cuenta. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
En ocasiones podemos pensar en un nivel de aislamiento read uncommitted o en el uso de la clausula NoLOCK como la solución a nuestros problemas de bloqueos. Si a ti también te ha pasado este video es para ti. Vamos a ver como su uso tiene muchos riegos y hay resultados inesperados que, para mi, hacen que no sea la mejor de la soluciones.
Espero que te haya gustado esta demostración rápida de los problemas a los que nos podemos enfrentar por usar NoLOCK. Ahora que ya conoces los riegos te recomiendo valorar una solución como Read Committed Snapshot para tus transacciones. Si quieres saber más de niveles de aislamiento te recomiendo nuestros post sobre niveles de aislamiento, niveles de aislaminto – casos prácticos y el uso de nolock.
Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!
Como DBAs siempre nos encontramos en una constante búsqueda de optimización y mejora del rendimiento de nuestras bases de datos. Esto, antes o después nos lleva a encontrarnos con un concepto fundamental pero que puede resultar complicado al principio: la estimación de cardinalidad. Este concepto, aunque pueda parecer magia interna de SQL Server, es esencial para entender cómo el motor de base de datos de SQL Server decide el mejor plan de ejecución para ejecutar nuestras consultas. Es decir, es la clave para elegir el camino más óptimo para resolver lo que le hemos pedido.
Estimación de Cardinalidad
Como hemos adelantado ya en la introducción ,la estimación de cardinalidad es el proceso mediante el cual SQL Server trata de predecir el número de filas a las que va a afectar una consulta. No sólo calcula el número total de filas afectadas sino que lo hace con una granularidad total, calculando cuántas filas pasarán por todos y cada uno de los distintos componentes de los planes de ejecución posibles para resolver la consulta. Este número, también conocido como cardinalidad, es crucial para el optimizador de consultas, ya que sin esta información el motor de base de datos no podría elegir el plan de ejecución más eficiente. SQL Server utiliza estadísticas para realizar estas estimaciones de cardinalidad.
Estadísticas en SQL Server: La base de la cardinalidad
Como acabamos de ver, el optimizador de consultas utiliza las estadísticas para estimar la cardinalidad. Por ejemplo, si estamos buscando registros de en una tabla donde la columna ‘edad’ es mayor que 30, SQL Server utilizará las estadísticas para estimar cuántos registros cumplen con este criterio. Pero, ¿cómo funciona exactamente?
Las estadísticas en SQL Server son objetos que almacenan información sobre la distribución de los valores en una o más columnas de una tabla o vista indexada. Cada objeto de estadísticas está compuesto por un histograma que describe la distribución de los valores, y un vector de densidad que contiene información sobre la correlación de los valores en las columnas.
SQL Server crea y actualiza automáticamente las estadísticas para las columnas indexadas en nuestras tablas y vistas. También podemos crear estadísticas para columnas no indexadas utilizando el comando CREATE STATISTICS, o podemos actualizar las estadísticas existentes utilizando el comando UPDATE STATISTICS.
Es importante tener en cuenta que las estadísticas pueden volverse obsoletas a medida que los datos en nuestras tablas cambian. Cuando esto sucede, las estimaciones de cardinalidad basadas en estas estadísticas pueden ser inexactas. Esto puede llevar a SQL Server a elegir un plan de ejecución subóptimo, lo que puede resultar en un rendimiento deficiente de la consulta. Otro de los problemas comunes, aunque el plan de ejecución sea el correcto es una asignación de recursos no óptima para la resolución de las consultas lo que puede llevarnos a una profunda degradación de rendimiento.
Planes de Ejecución: El resultado de la estimación de cardinalidad
Un plan de ejecución es, en resumen, una serie de pasos que SQL Server sigue para ejecutar una consulta. Cada paso en el plan de ejecución tiene su propio componente que representa una operación atómica, como un escaneo de tabla, un join, o una operación de ordenación.
El optimizador de consultas de SQL Server utiliza las estadísticas para estimar la cardinalidad y elige el plan de ejecución que tiene el menor costo estimado. El costo de un plan de ejecución se mide en términos de la cantidad de recursos que se espera que consuma, como la CPU, la E/S de disco, y la memoria RAM.
Podemos ver el plan de ejecución de una consulta utilizando la opción SET SHOWPLAN_ALL ON. Esto nos proporcionará una representación gráfica del plan de ejecución, junto con información detallada sobre cada operación en el plan.
No vamos a profundizar mucho más en este sentido pues ya le hemos dedicado a este tema este artículo completo en este blog.
Conclusión
La estimación de cardinalidad es un aspecto esencial en la optimización de consultas en SQL Server. Aunque puede parecer un concepto complejo, entender cómo funciona puede ayudarnos a mejorar significativamente el rendimiento de nuestras bases de datos.
Es importante recordar que las estadísticas, que son la base de la estimación de cardinalidad, deben mantenerse actualizadas para garantizar estimaciones precisas. Como siempre, la clave está en conocer nuestras bases de datos, entender cómo se utilizan y aplicar este conocimiento para optimizar su rendimiento.
En resumen, la estimación de cardinalidad es una herramienta poderosa en nuestras manos. Con un buen entendimiento de cómo funciona, podemos hacer que nuestras bases de datos trabajen de manera más eficiente y efectiva. ¡Sigamos aprendiendo y mejorando juntos!
Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
SoyDBA.es es gratis para ti y siempre va a serlo. Sin embargo, a nosotros si que nos cuesta dinero además de mucho esfuerzo. Puedes colaborar con nosotros con un donativo por PayPal o usando nuestros enlaces de afiliado para colaborar sin que te cueste nada. Tenemos enlace de Amazon y de Aliexpress
Para ofrecer las mejores experiencias, utilizamos tecnologías como las cookies para almacenar y/o acceder a la información del dispositivo. El consentimiento de estas tecnologías nos permitirá procesar datos como el comportamiento de navegación o las identificaciones únicas en este sitio. No consentir o retirar el consentimiento, puede afectar negativamente a ciertas características y funciones.
Funcional
Siempre activo
El almacenamiento o acceso técnico es estrictamente necesario para el propósito legítimo de permitir el uso de un servicio específico explícitamente solicitado por el abonado o usuario, o con el único propósito de llevar a cabo la transmisión de una comunicación a través de una red de comunicaciones electrónicas.
Preferencias
El almacenamiento o acceso técnico es necesario para la finalidad legítima de almacenar preferencias no solicitadas por el abonado o usuario.
Estadísticas
El almacenamiento o acceso técnico que es utilizado exclusivamente con fines estadísticos.El almacenamiento o acceso técnico que se utiliza exclusivamente con fines estadísticos anónimos. Sin un requerimiento, el cumplimiento voluntario por parte de tu proveedor de servicios de Internet, o los registros adicionales de un tercero, la información almacenada o recuperada sólo para este propósito no se puede utilizar para identificarte.
Marketing
El almacenamiento o acceso técnico es necesario para crear perfiles de usuario para enviar publicidad, o para rastrear al usuario en una web o en varias web con fines de marketing similares.