Rendimiento

¿Cómo no hacer un DWH? (Parte 2 de 2)

Continuamos donde lo dejamos el otro día en nuestro artículo de ¿cómo no hacer un DWH? y seguimos repasando los errores más comunes a la hora de diseñar un DWH. Si no habéis leído la primera parte os recomiendo hacerlo ahora, antes de este artículo ya que este es la continuación directa de ese primer post. 

Errores del 12 al 7

Antes de empezar con los 6 errores más graves que cometemos a la hora de diseñar un DWH vamos a repasar brevemente los errores que vimos en la primera parte de este artículo.

  • Error 12: Incluir campos de texto en tablas de hechos para filtrar u ordenar
  • Error 11: Escatimar en la información de nuestras dimensiones para ahorrar espacio
  • Error 10: Dividir las jerarquías y en varias dimensiones
  • Error 9: No enfrentar las dimensiones lentamente cambiantes
  • Error 8: No crear foreign keys específicas
  • Error 7: Añadir dimensiones a la tabla de hechos
Banner-Telegram

Errores más graves al crear un DWH

Ahora si, ya conocemos los 6 primeros errores más comunes a la hora de crear nuestro DWH vamos a repasar los 6 que nos quedan, los más graves.

Error 6: Crear el modelo dimensional del DWH a la medida de un informe particular

No hay mucho más que decir, el título lo dice todo. Construir el modelo de datos a medida para los informes que se van a realizar es un grave error que a la larga dificultará mucho el escalado de nuestro DWH y la integración de nuevos reportes. Es común definir primero los objetivos de nuestro DWH y los reportes que los usuarios de negocio van a necesitar previamente antes de la propia arquitectura del modelo, estas definiciones son necesarias pero no pueden ser la base del DWH de fondo. Como arquitectos de datos debemos pensar en todo y dejar el modelo preparado para futuros requisitos. 

Este error es común sobre todo cuando se delega la creación en equipos externos y se definen como objetivos la entrega de unos informes predefinidos. Mucho cuidado con los términos de tu contrato de externalización.

Error 5: Compartir una tabla de hechos para hechos de distinta granularidad

Como sabes, las tablas de hechos pueden acumular miles de millones de registros a lo largo del tiempo y eso hace que operaciones pesadas como agregaciones para, por ejemplo, calcular el total de ventas por meses puedan llevar mucho tiempo y recursos. Una buena solución para eso es persistir ese dato ya agrupado en otra tabla para disponer de él de una manera mucho más rápida. Sin embargo, aunque estemos hablando de los mismos hechos (las ventas en este caso), el detalle y los agregados no tienen la misma granularidad por lo que no deben compartir la misma tabla o a la larga podremos caer en errores de incoherencia de datos.

Error 4: No añadir todo el detalle a la última capa del DWH

Tradicionalmente, los DWH se han dividido en capas, tenemos una primera capa de staging donde cargamos en bruto la información de los sistemas operacionales, una segunda capa relacional (normalmente en un modelo copo de nieve) donde ya la información ha sido integrada y se han añadido las relaciones y una última capa dimensional que será nuestro modelo de estrella con las tablas de agregados adaptadas a nuestros KPIs que consumirán las herramientas de reportes. En la actualidad, esta nomenclatura se está reemplazando por bronce, plata y oro pero sigue respondiendo a los mismos términos.

Podemos pensar que es una buena idea no llevar información que no se va a consumir al modelo de estrella para aligerar el modelo y que las consultas puedan ir más rápido pero, sin embargo, lo que vamos a terminar consiguiendo es que cuando el usuario final necesite esa información tenga que atacar al modelo relacional o en su defecto un extra de trabajo para los equipos de desarrollo BI. En este sentido es mejor opción detallar al máximo la capa dimensional y que sea el usuario desde la herramienta de reporte quien decida qué información mostrar.

Error 3: No usar tablas de agregados

Cuando nos enfrentamos a un problema de rendimiento de nuestro DWH (lo haremos, todos rinden mal) podemos caer en la tentación de añadir más recursos de CPU y RAM cuando lo que normalmente solucionará el problema es crear tablas de agregados para evitar ese recálculo continuo a la hora de mostrar los informes. Las tablas de agregados son un objeto más a mantener y puede parecer que el esfuerzo no merece la pena pero realmente es lo que va a descargar de trabajo a nuestro servidor. Además, para evitar esto, podemos hacer uso de vistas materializadas o vistas indexadas siempre que nuestro gestor de base de datos lo permita.

Error 2: No unificar los hechos entre distintas tablas de hechos de nuestro DWH

En el artículo de ayer, cuando definimos un DWH dijimos que era un sistema donde la información de diferentes orígenes se encuentra integrada. Esto es un verdadero reto a la hora de modelar un DWH y en ocasiones, por necesidades de negocio optamos por separar la información de diferentes orígenes en tablas diferentes para una explotación individual. Esto no tiene nada de malo pero tenemos que tener cuidado y no caer en el error de no unificar los criterios. Aunque la información se encuentre en distintas tablas de hechos debe responder a las mismas dimensiones y tener los mismos criterios para permitir agregaciones entre sí.

Y el mayor error….

Error 1: No ajustar las dimensiones entre tablas de hechos

Cuando modelamos un DWH es común encontrarnos con información duplicada entre diferentes orígenes. Esto se puede ver con mayor frecuencia en los maestros de personas. En ocasiones una misma persona puede ser cliente y proveedor o cliente y empleado. O cliente en dos aplicaciones distintas como la tienda web y la tienda física. Muchas veces, por falta de tiempo, recursos o una mezcla de ambas se cargan los maestros tal cual sin identificar estas dimensiones duplicadas. Esto nos va a llevar a errores a la hora de aplicar agregaciones y filtrados por lo que debemos prestar especial atención a estos casos y dedicar el tiempo y los recursos que sean necesarios para solventarlos. De lo contrario nuestro DWH no cumplirá su función principal de tener la información integrada y unificada.

Conclusión

En esta serie de dos artículos hemos podido ver los errores más comunes a la hora de plantearse la arquitectura de un nuevo DWH. Espero que gracias a estos post no caigáis en estos errores o seáis capaces de subsanarlos a tiempo en caso contrario. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

PD: El artículo original de Kimball fue borrado ya pero por suerte nada escapa del archivo de internet. Podéis encontrarlo aquí.

Publicado por Roberto Carrancio en Rendimiento, 0 comentarios

¿Cómo no hacer un DWH? (Parte 1 de 2)

Hoy vamos a viajar al pasado para recuperar un artículo de Ralph Kimball escrito en 2001 pero que aún, 23 años después, sigue estando muy presente. El artículo recoge los 12 errores más comunes (y más perjudiciales) que se cometen a la hora de diseñar un DataWareHouse (DWH). Si ya tienes experiencia en este tipo de entornos vas a notar que son errores que a menudo podemos cometer pero que necesariamente tenemos que corregir al poco tiempo. En estos entornos no valen las cosas a medias, para un buen rendimiento es necesario hacer las cosas bien desde el principio o la bola crecerá tanto que será ingestionable.

¿Qué es un DWH?

Empecemos por el principio, un almacén de datos, datawarehouse o DWH es un sistema diseñado para almacenar y, posteriormente, analizar datos. No es un sistema cualquiera y tiene sus particularidades ya que en él, vamos a integrar todos los datos de los distintos orígenes de nuestra organización, incluso de orígenes externos. Por ejemplo, en nuestro DWH tendremos los datos de nuestra aplicación de ventas, contabilidad, tienda web y, en ocasiones, incluso la base de datos de artículos de nuestros proveedores.

Banner-Telegram

Los DWH se caracterizan por contener grandes cantidades de información histórica permitiendo a los analistas de datos realizar análisis temporales y crear predicciones de tendencias a futuro. Como podrás imaginar, para que todo esto funcione, tiene que estar todo muy organizado, estructurado y optimizado para el acceso y análisis rápido de la información. Gracias a procesos ETL (extracción, transformación y carga por sus siglas en inglés) vamos a cargar las tablas de dimensiones y de hechos del modelo de estrella de nuestro DWH,

Errores comunes cuando creamos un DWH

Ahora si, después de esta pequeña introducción vamos al lío, estos son los doce errores más comunes definidos por Kimball.

Error 12: Incluir campos de texto en tablas de hechos para filtrar u ordenar

En un modelo dimensional, las tablas de hecho y de dimensiones se diferencian por contener indicadores numéricos y atributos respectivamente. A veces, la clasificación de un dato puede ser ambigua, como la hora de una venta o el nombre del transportista que nos entrega un pedido. En caso de duda, os recomiendo evitar textos largos en las tablas de hecho para optimizar el espacio y el rendimiento, y considerar como dimensión cualquier dato compartido entre varias tablas de hecho. Al fin y al cabo el almacenamiento es barato en precio pero costoso a la hora de leerlo, las tablas de hechos pueden llegar a tener millones de registros y debemos evitar poner en ellas cualquier texto que pueda ser común a varias tablas o registros. Eso será siempre una dimensión.

Error 11: Escatimar en la información de nuestras dimensiones para ahorrar espacio.

La información es poder y aunque en este momento podamos pensar que no necesitamos ciertos datos y que podemos prescindir de ellos siempre es importante guardarlos por si en un futuro los necesitamos. Esa es la idea detrás de las primeras capas bronce de los data lakes pero, llevado al caso que nos ocupa, en nuestro DWH es una buena idea almacenar esa información si se refiere a dimensiones. El tamaño de las tablas de dimensiones con cientos o pocos miles de registros será despreciable al lado de las grandes tablas de hechos con millones de registros por lo que no debemos preocuparnos por ese aspecto. Otra cosa será que saquemos los datos en la capa de presentación si no se nos solicita pero tenerlo siempre será una buena idea.

Error 10: Dividir las jerarquías y en varias dimensiones

Las dimensiones se agrupan en jerarquías que tienen una relación de uno a muchos. En un país existen muchas provincias y en cada una de esas provincias muchas poblaciones. Cada población a su vez tiene muchos clientes. Podemos pensar en que es una buena idea tener las tablas normalizadas como nos enseñaron en la universidad y crear una tabla por cada una de esas dimensiones.

Eso es lo idea para un modelo transaccional pero cuando hablamos de un DWH donde las lecturas priman sobre las escrituras y el almacenamiento, en la última capa de nuestro DWH el modelo debe ser puramente de estrella y no de copo de nieve por lo que en una sola tabla para esa jerarquía. Es importante aquí destacar de esta última frase la referencia a esa última capa que consumen los reportes ya que nuestro DWH tendrá otras capas inferiores donde sí tendremos normalizados los datos.

Error 9: No enfrentar las dimensiones lentamente cambiantes

Ya explicamos en nuestro artículo sobre el modelo de estrella lo que es una dimensión de variación lenta o lentamente cambiante. Es importante que anticipemos estos cambios desde el inicio del diseño de nuestro modelo o en un futuro tendremos problemas. Por ejemplo, no os imagináis el caos que se me montó una vez a mi cuando un NIE de un cliente extranjero cambió a DNI al obtener la nacionalidad y yo no había pensado que ese dato era cambiante. 

Error 8: No crear foreign keys específicas en tu DWH

En ocasiones podemos pensar que un valor intrínseco de nuestras dimensiones puede actuar como clave y cometemos el error de no crear una clave dedicada para esos registros. Sin embargo, a la larga eso puede llegar a ser un problema y para evitarlo es aconsejable crear nuestros propios identificadores numéricos para los registros de nuestras dimensiones y enlazar con ellos las tablas de hechos. Pensad en el ejemplo del error anterior, el NIE o DNI puede parecer un identificador personal válido pero cuando no lo es puede ser un verdadero quebradero de cabeza. 

Error 7: Añadir dimensiones a la tabla de hechos del DWH

Esto puede parecer básico, pero si ya os habéis enfrentado a varios modelos de DWH sabréis que es más común de lo que parece. En un modelo de estrella todas las dimensiones deben estar en sus tablas de dimensiones y las tablas de hechos solo deben tener relación con esas dimensiones o jerarquía. Caer en este error nos llevará a un mayor tamaño de nuestra tabla de hechos lo que repercutirá directamente en el consumo de E/S de nuestras consultas y empeorará el rendimiento.  

Conclusión

Hemos visto la mitad de los errores más comunes descritos por Kimball, como el artículo si no iba a quedar muy grande vamos a dejar los 6 siguientes errores (y los más graves) para una segunda parte. Espero que os esté gustando, que os sea de utilidad y por supuesto que a partir de ahora no caigáis en estos errores. Si al leer esto has pensado en algo que tienes mal en tu DWH solucionalo antes de que sea tarde, vas a ver que, a la larga, la ganancia es sustancial. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, 1 comentario

Perform volume maintenance tasks

Muchos me habéis preguntado por el permiso “Perform volume maintenance tasks” o “Realizar tareas de mantenimiento del equipo” por el que pregunta SQL Server al instalarse. Hay quien me ha dicho que siempre lo marca, otros que nunca pero en general existe cierto desconocimiento sobre sus pros y sus contras y lo que es más importante sobre lo que hace o no este permiso de Windows. En el artículo de hoy vamos a tratar de responder estas dudas.

Inicialización de archivos de base de datos

Seguramente te suene este concepto, la inicialización de archivos de base de datos es el proceso por el que SQL Server crea y dimensiona los archivos de bases de datos y logs ya sea de manera manual o con el crecimiento automático. Desde los inicios del SQL moderno que conocemos hoy en día (SQL 2005) esto implica crear o redimensionar los ficheros para reservar ese espacio para la base de datos. Durante este proceso SQL Server pone a 0 todos los sectores del disco duro a nivel físico para posteriormente ir rellenandolos con datos. Esto es un proceso lento y pesado que demora las operaciones de escritura, por eso las buenas prácticas siempre recomiendan tener todos los ficheros dimensionados previamente a la hora de trabajar para evitar el crecimiento automático.

Banner-Telegram

Ahora bien, existe una excepción que nos permitirá saltarnos este paso y dimensionar los ficheros de datos sin tener que modificar los sectores del disco para establecerlos a 0 y es lo que se conoce como inicialización instantánea de base de datos gracias al privilegio “perform volume maintenance task”. Esto también afecta a los archivos de base de datos de Analysis Service. Esta configuración también se aplica en los ficheros de log desde SQL Server 2022 y está disponible también en las bases de datos y en las instancias administradas de Azure. 

Perform volume maintenance tasks

Este permiso, asignado por directiva de windows por defecto a los usuarios administradores del equipo, permite realizar las tareas de mantenimiento típicas sobre los discos duros tales como desfragmentar, crear y modificar nuevos volúmenes o ejecutar el asistente de limpieza. Esto es lo que dice la teoría, pero como hemos visto, a nosotros como DBAs nos interesa porque es lo que nos va a permitir la inicialización instantánea de los archivos de bases de datos.

Consideraciones de seguridad

Como hemos visto, esta política por defecto otorga el permiso a los administradores del equipo, sin embargo, vosotros que sois buenos DBAs, sabréis que no es conveniente que la cuenta de servicio de SQL Server sea administradora local. O eso dicen las buenas prácticas de seguridad. 

Además, ten en cuenta que, gracias a este permiso es posible ver el valor de los sectores de disco y recuperar información eliminada, lo que también puede ser un problema de seguridad. En este sentido, tendremos que valorar junto con el equipo de ciberseguridad de nuestra empresa, la ganancia que vamos a sacar de este privilegio frente a los posibles riesgos de seguridad.

Por un lado, si tenemos bien dimensionados los archivos de datos para nuestro crecimiento y podemos hacer redimensionamiento manuales en ventanas de mantenimiento fuera de las horas de mayor carga de trabajo es probable que no sea necesario. Si esto no es así y tenemos muchos crecimientos automáticos sin, además, tener este privilegio concedido, podremos experimentar grandes caídas del rendimiento e incluso encontrarnos en el log de errores de SQL los errores 5144 y 5145 de timeout al redimensionar los ficheros. En estos casos será recomendable conceder el permiso siempre reduciendo al mínimo los riesgos de seguridad, por ejemplo, usando para SQL Server cuentas de servicio administradas gMSA.

Como asignar el permiso Perform volume maintenance tasks

Ahora que ya sabes lo que implica la asignación de este privilegio de Windows vamos a ver como concederlo. Como ya hemos visto, durante la instalación tenemos un check que nos lo asignará automáticamente pero, si no lo hemos hecho, o si hemos cambiado la cuenta de servicio de SQL Server, será necesario hacerlo manualmente. Hemos visto que se otorga a través de las directivas de windows por lo que, lo primero que necesitaremos será abrir la consola gpedit.msc. Una vez en el editor de directivas nos iremos a Configuración del equipo – Configuración de Windows – Configuración de seguridad – Directivas locales – Asignación de derechos de usuario. En este apartado encontraremos el permiso “Realizar tareas de mantenimiento del equipo” al que añadiremos nuestra cuenta de servicio de SQL Server. Una vez cambiado esto será necesario reiniciar el servicio de SQL Server para aplicar los cambios.

Perform-volume-maintenance-tasks

Pruebas de rendimiento

Para terminar quiero compartir con vosotros una prueba de rendimiento que he hecho en mi equipo. Para la prueba, sin haber asignado el permiso a la cuenta de SQL, he creado unas bases de datos de 10 Gb de tamaño inicial en 3 discos duros, un M2, un SSD y un HDD. Luego he realizado la misma prueba pero con el privilegio otorgado. Estos son los resultados: 

 M2SSDHDD
CON Inicialización instantánea86 ms127ms852 ms
SIN Inicialización instantánea88 ms174 ms1118 ms

Conclusión

Configurar el permiso para realizar tareas de mantenimiento sobre los volúmenes puede tener mejoras sustanciales en la creación o redimensionamiento de los ficheros de bases de datos. Sin embargo, tiene implicaciones de seguridad que es necesario conocer y valorar previamente. Además, aunque la mejora de rendimiento sea notable, sigue sin ser recomendable confiar en el crecimiento automático, siendo necesario dimensionar previamente los ficheros para evitar problemas. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 1 comentario

Optimización de Consultas con OPTION RECOMPILE

Cuando hablamos de consultas sobre las bases de datos, la eficiencia es clave. Como DBAs siempre buscamos formas de mejorar el rendimiento de las consultas. Pero no solo nosotros, los DBAs, nos vemos en esta necesidad, cualquier desarrollador que trabaje con bases de datos también debe perseguir el mismo objetivo. En este contexto, a veces, la solución puede ser tan simple como usar la sugerencia de consulta OPTION RECOMPILE. Pero, ¿qué es exactamente y cómo puede ayudarnos en SQL Server y Azure SQL? ¿Realmente es una solución mágica que podemos usar siempre como una carta comodín? Durante estas líneas voy a tratar de dar respuesta a estas preguntas.

¿Qué es OPTION RECOMPILE?

OPTION RECOMPILE es una directiva que podemos agregar al final de nuestras consultas en SQL Server para indicar que queremos que se recompile el plan de ejecución cada vez que se ejecuta la consulta. Esto puede ser útil en situaciones donde los datos subyacentes cambian con frecuencia y queremos asegurarnos de que estamos utilizando el plan de ejecución más eficiente posible.

Banner-Telegram

¿Cómo funciona OPTION RECOMPILE?

Para entender este concepto, es importante recordar algunos de los conceptos que hemos discutido en artículos anteriores. En concreto hablo de los planes de ejecución de las consultas y de la caché de planes de ejecución.

Planes de ejecución

En nuestro artículo sobre planes de ejecución, exploramos cómo SQL Server y Azure SQL crean y utilizan estos planes para llevar a cabo las consultas de manera eficiente. Estos planes son esenciales para entender cómo OPTION RECOMPILE puede mejorar el rendimiento de nuestras consultas.

Caché de planes de ejecución

Además, en nuestro artículo sobre la caché de planes, vimos cómo SQL Server y Azure SQL almacenan los planes de ejecución para su reutilización. Este almacenamiento en caché puede ser muy eficiente, pero también puede llevar a problemas si los datos subyacentes cambian con frecuencia, lo que nos lleva de nuevo a la utilidad de OPTION RECOMPILE.

Option Recompile

Ahora sí, vamos a dar respuesta a la pregunta ¿cómo funciona OPTION RECOMPILE?

Ya sabemos que la primera vez que ejecutamos una consulta en SQL Server o Azure SQL, el motor de la base de datos crea un plan de ejecución. Este plan es básicamente una serie de pasos que la base de datos seguirá para recuperar los datos solicitados. Una vez que se ha creado un plan, además de usarse para la consulta en curso, se almacena en caché para su uso en futuras ejecuciones de la misma consulta. 

Sin embargo, esto que la mayoría de las veces es una ventaja, puede no serlo si los datos subyacentes cambian significativamente. En estos casos el plan almacenado en caché puede no ser el más eficiente. También puede pasar que las estadísticas de la tabla no estuvieran bien actualizadas al momento de compilar el primer plan de ejecución y no este sea del todo correcto. Aquí es donde entra en juego OPTION RECOMPILE. Al agregar esta directiva a nuestra consulta, le estamos diciendo al motor de base de datos de SQL Server que ignore cualquier plan almacenado en caché y genere uno nuevo. 

Esto no quiere decir que se vaya a usar un plan de ejecución distinto, simplemente el motor de base de datos va a analizar todas las opciones posibles para resolver la consulta y a elegir el que le parezca más óptimo. Puede ser que vuelva a elegir el mismo, sobre todo si tenemos un problema con las estadísticas.

¿Cuándo deberíamos usar OPTION RECOMPILE?

Aunque OPTION RECOMPILE puede ser una herramienta poderosa, no siempre es la mejor opción. La recompilación de un plan de ejecución tiene un coste en términos de recursos, en concreto en consumo de CPU, por lo que si una consulta se ejecuta con mucha frecuencia, el coste de la recompilación puede superar cualquier beneficio de rendimiento que obtengamos.

Por lo tanto, OPTION RECOMPILE es más adecuado para consultas que se ejecutan con poca frecuencia, pero que son críticas para el rendimiento, o para consultas donde los datos subyacentes cambian con tanta frecuencia que un plan almacenado en caché se vuelve ineficiente rápidamente. En esta línea, otro posible escenario son las consultas de procedimientos almacenados que interactúan con datos con gran variación entre un parámetro y otro. Para estos casos de gran desigualdad en los volúmenes de datos puede ser una gran alternativa a la utilización tradicional de planes en caché.

Personalmente también me gusta mucho utilizar esta opción de consulta cuando me enfrento a un problema de rendimiento de una consulta. En estas situaciones puede ser de gran ayuda, localizar a tiempo que el problema está en un plan de ejecución no óptimo cacheado puede ahorrarnos mucho tiempo y esfuerzo en la optimización.

Conclusión

En resumen, OPTION RECOMPILE es un truco muy potente y valioso en nuestra caja de herramientas de optimización de consultas. Aunque no es una solución para todos los problemas de rendimiento, y hay que medir muy bien su uso para no caer en problemas mayores, puede ser extremadamente útil en las circunstancias adecuadas. Como siempre, la clave es entender cómo funciona y cuándo usarlo. Y como digo siempre, solo plantéate este tipo de soluciones si realmente tienes un problema, las soluciones “por si acaso” nunca suelen ser una buena idea.  Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Uso de vistas y más buenas prácticas en Power BI

Iniciamos esta semana como terminamos la pasada, con otro artículo sobre análisis de datos e inteligencia de negocio. En concreto vamos a seguir hablando de buenas prácticas en Power BI. Si en nuestro último artículo hablábamos de la importancia de usar un modelo de estrella en Power BI hoy vamos a repasar el resto de buenas prácticas también muy importantes en esto del modelado de datos.

Antes de seguir quiero hacer un inciso (“Disclaimer cero” que diría el gran motero Isaac Feliú) todas las recomendaciones descritas en este artículo aplicadas a Power BI también son válidas para modelos tabulares como Power Pivot, Analisys Services y otros. Aun así, esto no quiere decir que tengamos que tomarnos estas buenas prácticas como los diez mandamientos escritos en piedra e inamovibles, son unas recomendaciones y no todas van a ser aplicables al 100% para todos los modelos. 

Uso de vistas en Power BI

Las vistas son consultas almacenadas en la base de datos que generan un conjunto de resultados al ser invocadas. Podríamos decir que son tablas virtualizadas que se basan en el resultado de una consulta SQL y “no almacenan los datos” así entre unas comillas muy grandes. Cuando hablamos de modelado de datos, las vistas juegan un papel crucial. En Power BI, las vistas pueden ser una herramienta poderosa para simplificar y optimizar nuestros modelos de datos. Vamos ahora a ver estas ventajas:

Abstracción del modelo

Gracias al uso de vistas, cuando importamos datos desde entornos de bases de datos relacionales como SQL Server o Azure SQL vamos a poder abstraer nuestro modelo de datos del modelo original de las aplicaciones transaccionales. Esto que puede no parecer importante realmente es clave, ya que los modelos de datos suelen ser entidades vivas cambiantes con cada actualización de las aplicaciones. Gracias al uso de vistas, vamos a poder salvar este inconveniente, y en caso de cambios en el nombre de una columna, por ejemplo, vamos a poder corregirlo en un solo sitio sin tener que cambiarlo en todos los informes.

Simplificación del modelo de datos de Power BI

Las vistas pueden ayudar a simplificar nuestros modelos de datos en Power BI. Al encapsular la lógica de las consultas en una vista, podemos reducir la complejidad de nuestro modelo de datos y hacerlo más fácil de entender y mantener. En otras palabras, podremos aprovechar estas vistas para simplificar lo más posible el modelo de datos, eliminando de las consultas de la vista todas aquellas columnas que no necesitamos en el modelo analítico.

Mejora el rendimiento de Power BI

Las vistas también pueden contribuir a mejorar el rendimiento de nuestros informes de Power BI. Al utilizar vistas, podemos minimizar la cantidad de datos que necesitamos cargar en Power BI, lo que puede resultar en informes más rápidos y eficientes. También, gracias al uso de vistas indexadas, que ya vimos hace meses en este blog, podemos mejorar el rendimiento de manera sustancial, hasta pasando de horas de procesamiento de la consulta a segundos en los casos más extremos.

Seguridad de los Datos

Las vistas nos permiten implementar una capa adicional de seguridad en nuestros datos. Podemos utilizar vistas para restringir el acceso a ciertos datos, asegurando que sólo los usuarios autorizados puedan ver la información sensible. 

Banner-Telegram

Buenas prácticas en el uso de vistas

Ya hemos visto que el uso de vistas para alimentar nuestro modelo es una buena práctica en sí misma pero esto no queda ahí, existen unas buenas prácticas para la buena práctica de crear vistas. Gracias a estas “meta buenas prácticas” vamos a poder sacar todo el partido de las ventajas del uso de vistas que ya os he comentado. Vais a ver cómo, a medida que las vayamos viendo vamos a poder enlazarlo claramente con todo lo ya mencionado arriba.

Uso de esquemas

Crear un esquema dedicado a las vistas que se van a utilizar para alimentar el modelo de Power BI no solo sirve para mantener la organización, también nos va a ayudar a poder centralizar los permisos. Podemos incluso crear varios esquemas si tenemos varios grupos de informes o reportes en Power BI para tener más control sobre su seguridad y organización. A la hora de importar las tablas al modelo de Power BI no hay ningún problema en eliminar el nombre del esquema y dejar solo el de la vista.

Crear vistas por tabla de Power BI

Otra de las mejores recomendaciones que podemos encontrar sobre este aspecto es la creación de vistas independientes por cada tabla del modelo de Power BI y no por cada tabla del modelo relacional original. De esta manera podemos aprovechar la potencia de SQL Server o el SGBD relacional que usemos y sus índices para las uniones entre tablas y que se presenten a Power BI como una tabla plana.

Limitar el número de columnas

Otra de las ventajas del uso de vistas era optimizar el rendimiento reduciendo la lectura de datos que no van a ser explotados por el modelo de Power BI, esto lo lograremos declarando los campos necesarios en el select de la vista en lugar de un carácter *. De esta manera además podremos ver de una manera fácil en SQL Server que datos se están explotando en Power BI y los DBAs tendremos más fácil localizar las actuaciones del modelo relacional que pueden afectar al modelo analítico.

Otras buenas prácticas para Power BI

No solo de modelos en estrella y vistas vive un buen modelador de datos, existen además ciertas recomendaciones que también tendremos que tener en cuenta al diseñar nuestro modelo en Power BI. Vamos a repasar las más significativas:

Utiliza nombres significativos

Esto es de primero de modelador de datos, no solo para modelos analíticos, sin embargo, es común encontrarnos con situaciones en las que no se aplica, ya sea por desconocimiento, indiferencia o una mezcla de las dos (el típico ni lo sé ni me importa). Un nombre descriptivo a la hora de definir las columnas de las vistas que van a alimentar nuestro modelo en Power BI nos ayudará luego a crear los reportes con menos trabajo. Por supuesto evita repetir los mismos nombres para distintas columnas a no ser que sea en distintas tablas y esas columnas sean las claves por las que vas a relacionar las tablas. En ese caso un nombre común te ayudará a localizar las relaciones. Piensa que al usar vistas has perdido la capacidad de consultar las relaciones establecidas en las tablas de la base de datos por medio de claves foráneas. 

Separa fechas y horas

En los sistemas de bases de datos relacionales es común el uso de tipos de datos que incluyen la fecha y la hora, incluso con presiones de microsegundos o más, por ejemplo en SQL Server el tipo de datos datetime2 tiene una precisión de 7 dígitos (hasta 100 nanosegundos). Esta precisión puede que sea clave para una aplicación pero, os aseguro, que al gerente que está visualizando un informe como mucho le importan los segundos, el resto de precisión suele ser despreciable. Cuando trasladamos estos datos a Power BI seguramente no necesitamos esa precisión, valora separar estos campos en un campo date y otro time y ajustar la precisión a los valores que vayan a necesitar los consumidores de tus reportes.

Mantén los modelos de Power BI sencillos

El título lo dice todo, no hay mucho más que añadir. Aunque Power BI puede manejar modelos de datos complejos, es mejor mantener los modelos lo más sencillos posible. Un modelo simple es más fácil de entender, mantener y optimizar.

Utiliza columnas calculadas y medidas de manera eficiente

Las columnas calculadas y las medidas son dos características poderosas de Power BI. Debemos utilizarlas de manera efectiva para mejorar el rendimiento y la funcionalidad de nuestros informes y valorar cuándo nos va a dar mejor rendimiento un cálculo en el motor de base de datos implementado en la propia vista y cuándo será mejor delegar ese trabajo en Power BI.

Marca las tablas de fecha de Power BI

En los inicios de Power BI, las tablas de dimensiones de fechas eran una tabla más, como todas las demás solo que almacenaban fechas. Sin embargo, desde la actualización de 2018 de Power BI, existe una marca para catalogar las tablas que contienen datos de fecha y hora como tablas de fechas. Esto optimizará el rendimiento y mejorará la experiencia de los usuarios.

Optimiza el Rendimiento

Para terminar, no es que sea una buena práctica como tal pero sí es importante remarcar que debemos revisar continuamente el rendimiento. Nuestro modelo va a crecer con el tiempo y puede que algunas soluciones que en un principio parecían aceptables ahora no lo sean. También podemos encontrarnos con casos como el anterior en el que una actualización de Power BI nos habilita una nueva funcionalidad para optimizar nuestro modelo. El rendimiento es un aspecto crítico del modelado de datos. Debemos tener en cuenta factores como el tamaño de los datos, la complejidad de las consultas y la capacidad de la máquina al diseñar y mantener nuestros modelos.

Conclusión

El modelado de datos es una ciencia y un arte a partes iguales. Conocer las buenas prácticas, y aplicarlas siempre que sea posible, nos ayudará a diseñar reportes optimizados que mejoren la experiencia de los usuarios finales. Espero que gracias a estos artículos estés más cerca de ese objetivo. Y ya sabes, si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, Rendimiento, 0 comentarios

La importancia de un modelo de estrella en Power BI

El artículo de hoy va para mis amigos analistas de datos, desarrolladores de BI y DBAs centrados en entornos datawarehouse aunque espero que sea también interesante para todos los demás. Hoy vamos a hablar del modelado en Power BI, existen muchas maneras de hacerlo pero al final, si el modelo va a tomar cierta envergadura, todo lo que no sea un modelo puro de estrella va a terminar dando mal rendimiento.  

¿Qué es Power BI?

Empecemos por el principio, seguramente si eres analista de datos o desarrollador BI si sabes de lo que estoy hablando pero, permíteme un paréntesis, para que toda esa gente que está leyendo esto y no sabe muy bien de lo que hablamos parta desde el mismo punto. Al fin y al cabo este es un blog de DBAs.

Power BI es un software de Microsoft para inteligencia de negocio (de ahí su nombre) capaz de convertir datos de casi cualquier fuente en informes interactivos muy atractivos visualmente. Esta información que puede venir de cualquier fuente puede ser desde un fichero de texto plano separado hasta una potente base de datos relacional como SQL Server o las bases de datos SQL de Azure. 

Banner-Telegram

El flujo de trabajo de Power BI

A grandes rasgos, para empezar a trabajar en Power BI, debemos usar Power BI Desktop para conectar la información de las fuentes, modelarla en la propia aplicación y después, preparar los informes visuales.

Una vez generado el informe se puede almacenar en un archivo pbix para consumir con la aplicación Power BI Desktop en el equipo local o publicarla en Power BI Service que no es más que un SQL Server Reporting Service adaptado. Si habéis administrado este servicio anteriormente vais a ver que es prácticamente igual, solo cambia el origen de los reportes. 

¿Qué es un modelo de estrella?

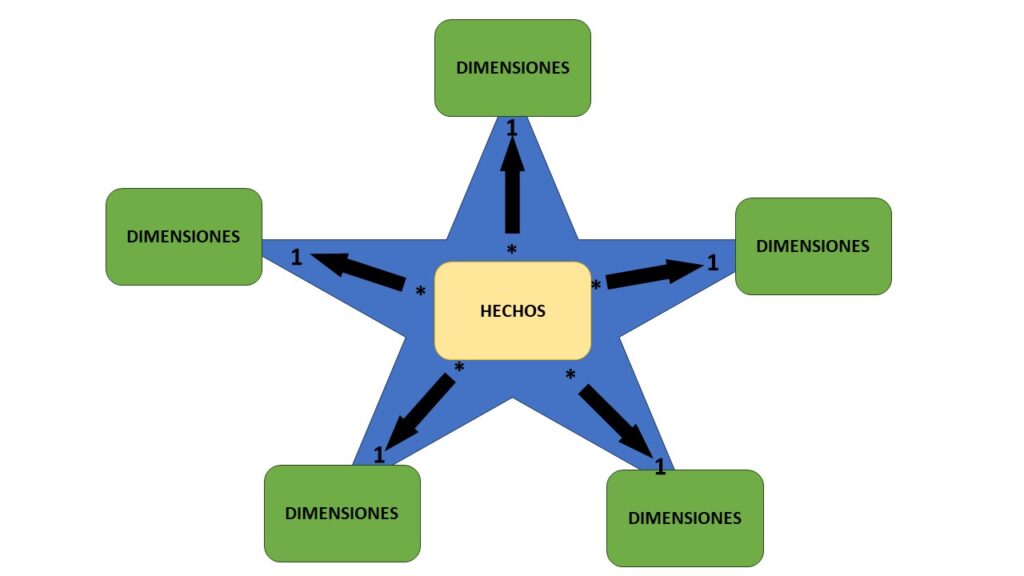
No es la primera vez que hablamos en el blog sobre los modelos de estrella, ya le dedicamos este artículo completo hace unos meses. Para refrescar las ideas, el modelo de estrella es una forma de organizar nuestros datos en base a una tabla central de hechos relacionada con varias tablas de dimensiones. Tener toda la información relevante en una misma tabla central lo convierte en un modelo optimizado para consultas de agrupaciones, justo lo que buscamos cuando elaboramos informes de BI. En este sentido, no es raro encontrarnos con tablas desnormalizadas, primando el rendimiento máximo de este tipo de lecturas sobre el ahorro de espacio y el rendimiento de escrituras.

Por qué usar un modelo de estrella en Power BI

Como ya hemos dicho, la mejor manera de modelar los datos en Power BI es con un modelo de estrella. Esto es así porque todos y cada uno de los objetos visuales que van a terminar componiendo los reportes van a realizar consultas contra el modelo de datos almacenado en la aplicación. Esas consultas además no tienen nada que ver con las consultas de selección de información a las que estamos acostumbrados a ver en una base de datos relacional, son consultas mucho más pesadas de filtrado, agregación, resumen y ordenación de los datos del modelo. Gracias a usar un modelo en estrella, las tablas de dimensiones admitirán el filtrado y la agregación mientras que sobre la tabla de hechos recaerá el resumen. 

Es importante destacar que la tabla de hechos y las de dimensiones no se establecen como tal por ninguna propiedad que asigne el modelador de datos, simplemente son tablas normales que al aplicar las relaciones correctas terminan componiendo este modelo. Si seguimos a rajatabla los cánones y buenas prácticas, todas las relaciones serán de uno a muchos, siendo siempre uno en la tabla de dimensión y muchos en la de hechos.

Modelo-de-estrella_Power BI

Un diseño bien modelado tendrá este aspecto que vemos en la imagen, con una tabla central de hechos relacionada con tantas tablas de dimensiones como sean necesarias y sin mezclar en una misma tabla dimensiones con hechos (Si estás perdido en este punto y no sabes la diferencia entre una tabla de hechos y una tabla de relaciones pásate por nuestro artículo sobre el modelo de estrella para descubrirlo). 

Conceptos clave del modelo de estrella en Power BI

Ahora que ya conocemos la estructura ideal del modelo de estrella en Power BI vamos a tratar de entender los conceptos clave necesarios para una correcta implementación del mismo.

Medidas

Normalmente, cuando hablamos de un modelo de estrella, una medida es la columna de la tabla de hechos que almacena información que se va a resumir. Cuando llevamos esta implementación del modelo de estrella a Power BI, esta medida va a ser una fórmula escrita en DAX que permita resumir la información. Lo más normal será encontrarnos con fórmulas MAX, MIN o AVG para generar un valor que consumir. Estos valores nunca se almacenan en el modelo. En Power BI, existen además una serie de medidas automáticas llamadas medidas implícitas para consumirse en el informe visual llamadas medidas implícitas. 

Claves suplentes

Son el identificador único de las tablas de dimensiones, lo que en base de datos conocemos como clave primaria. Estas claves en Power BI tienen la particularidad de no poder ser compuestas, tienen que ser una única columna. Es común tener que generar una columna con los datos de otras concatenados para que actúe como clave suplente aunque la mejor idea es agregar un identificador único a la tabla ya que de esa manera las relaciones con la tabla de hechos serán más fluidas.

Tablas de hechos sin hechos

En ocasiones es posible encontrarnos con la necesidad de crear una tabla de hechos que realmente no almacene ningún hecho. Por ejemplo una tabla de log de logins donde almacenamos una fecha de inicio de sesión donde el hecho realmente será el conteo de filas correspondiente a los inicios de sesión de los usuarios. Otra opción para utilizar este tipo de tabla es la típica tabla que almacena relaciones con las claves de otras dos tablas, tabla que es necesaria muchas veces para tener el modelo normalizado. 

Dimensiones especiales en Power BI

Ya vimos en nuestro artículo sobre el modelo de estrella lo que eran las dimensiones, también llevamos todas estas líneas hablando sobre ellas. Sin embargo, en el mundo del análisis de datos y en concreto en Power BI existen unos tipos especiales de dimensiones que debemos conocer.

Dimensiones de copo de nieve

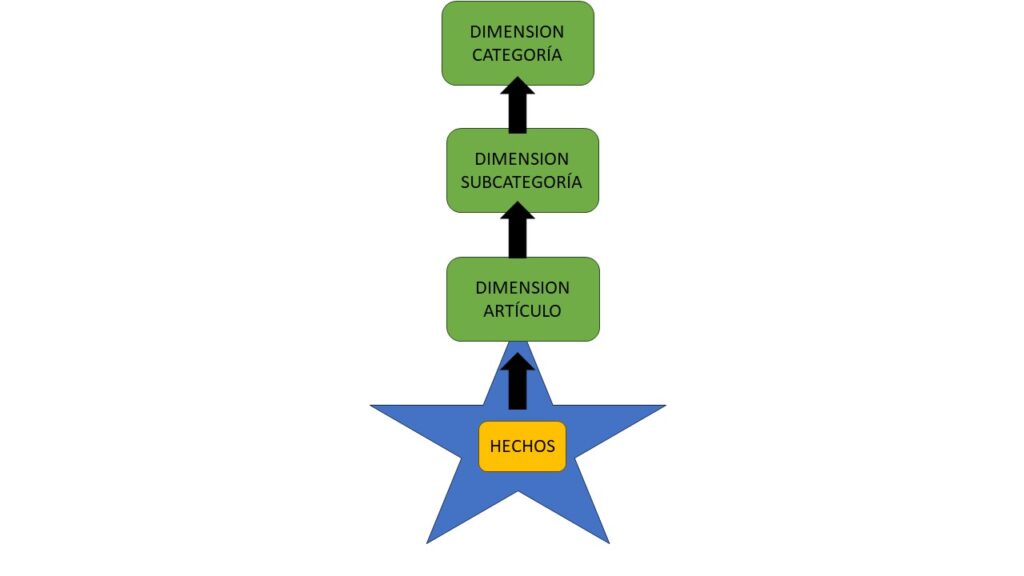
Las dimensiones de copo de nieve son conjuntos de tablas normalizadas que representan una única entidad de negocio o propiedad de un objeto. Por ejemplo, en la mayoría de ERP y software de gestión de almacén y ventas es común encontrar las propiedades categoría y subcategoría para los artículos. Esta idea, trasladada a un modelo normalizado, nos mostrará tres tablas, la de categorías, la de subcategorías y la de productos o artículos. 

Copo_de_nieve_Power BI

Si optamos por imitar el modelo de origen en Power BI en vez de desnormalizar el modelo y almacenar una única tabla de dimensiones no será lo más óptimo ya que deberemos cargar más tablas y más columnas clave. Además las fórmulas para definir las relaciones serán más largas y complejas complicando la propagación de filtros entre las tablas. Esto se traduce en un mayor número de campos en el panel para diseñar el informe visual, lo que también puede complicar la experiencia. Aunque parezca una buena idea a fin de tener el modelo normalizado y ahorrar espacio, a la larga, nos va a generar problemas debido a la limitación de Power BI de crear una jerarquía que abarque todas las tablas.

Dimensiones de variación lenta

Las dimensiones de variación lenta o dimensiones lentamente cambiantes (SCD por sus siglas en inglés) son aquellas que administran correctamente el cambio a lo largo del tiempo. Las SCD pueden admitir cambios de tipo 1, de tipo 2 o ambos a la vez.

El cambio tipo 1 es aquel que al producirse modifica todo el historial pasado, no nos interesa el histórico y solo queremos saber el valor actual. Sin embargo un cambio tipo 2 se almacena en un nuevo registro, sin sustituir el anterior. Por ejemplo, imaginad que tenemos una tienda de pulseras y nuestro principal cliente son hombres casados que compran regalos a sus esposas. Nuestra tabla de clientes es una dimensión, en esta tabla tenemos datos como el correo electrónico o el teléfono para enviarles promociones. Si estos datos cambian, no nos interesa almacenar el historial, con tener el dato actualizado es suficiente. Esto es un cambio tipo 1.

Sin embargo, hay otro campo de la dimensión clientes que es el estado civil y, en ese, si que necesitamos un historial. Saber cuántas veces pasan nuestros clientes de soltero a casado o casado a soltero y cuánto tiempo pasa de media entre cada etapa puede ser de gran ayuda para nuestros analistas de datos y sus modelos de predicción de ventas.

Podríamos tener otro tipo de dimensión cambiante como el precio de nuestros artículos de venta pero, si estos cambian rápidamente, lo mejor será almacenar esa información en la tabla de hechos.

Dimensiones realizadoras de roles

Existen dimensiones que, por sus características, pueden filtrar los hechos de maneras diferentes. Por ejemplo, imagina nuestro ejemplo anterior donde teníamos una tienda de pulseras, la dimensión fecha es capaz de realizar filtros por fecha de pedido, fecha de envío, fecha de cobro o incluso por fecha de alta de un cliente. 

En Power BI podríamos definir varias relaciones entre nuestra dimensión fecha y la tabla con los hechos, sin embargo, solo una de las relaciones puede estar activa. Tener una única relación activa implicará la propagación de filtros sobre la dimensión a la tabla de hechos. Técnicamente es posible usar relaciones inactivas pero para ello el desarrollador del informe tendrá que usar la función DAX USERELATIONSHIP. Esto puede resultar complicado tanto por el uso de código extra como por la cantidad de campos generados en el panel de construcción de reportes. 

Un enfoque común para superar estas limitaciones es, al modelar, crear varias tablas de dimensiones con la misma información duplicada de manera que cada una de ellas tenga una instancia realizadora de roles (filtrados). Es un precio menor a pagar ya que, por lo general ( y por definición), las tablas de dimensiones son relativamente pequeñas en comparación con los hechos.

Dimensiones no deseadas

Al trasladar datos de un modelo origen a nuestro modelo de Power BI es común encontrarnos con dimensiones no deseadas. Una dimensión no deseada puede ser útil cuando las dimensiones constan de pocos atributos y a su vez estos de pocos valores. En estos casos, puede ser una buena idea realizar un producto cartesiano de ambas dimensiones en una sola. Por ejemplo, volvamos a nuestra tienda, tenemos una dimensión que almacena un único atributo que es el estado de los pedidos y los valores que acepta son pedido recibido, pedido recibido y pedido completado. A su vez, tenemos otra dimensión con otro único atributo que es el estado de envío del pedido y admite los valores no enviado, enviado y entregado. En este caso, podríamos combinar ambas dimensiones del origen en una sola en nuestro modelo de estrella.

Dimensiones degeneradas

Una dimensión degenerada en el modelado de Power BI se refiere a un atributo de datos que funciona como una dimensión, pero que en realidad se almacena en la tabla de hechos, en lugar de en su propia tabla de dimensión separada. Es una excepción a la regla de oro que hemos comentado al principio de no mezclar hechos y dimensiones en una sola tabla. En otras palabras, es una clave de dimensión que se almacena en una tabla de hechos y no se une a una tabla de dimensiones correspondiente porque todos sus atributos ya se han colocado en otras dimensiones. Esto elimina la necesidad de unir otra tabla de dimensiones.

Conclusión

¿Aún sigues leyendo a estas alturas? ¿Después de casi 2000 palabras? Si es así y no has saltado directamente a este apartado gracias. Como habrás podido ver el modelado en power BI pasa por un modelo de estrella estricto para obtener un buen rendimiento. Sin embargo, esto de la ciencia de datos tiene mucho de arte también y son los analistas, científicos y arquitectos de datos los que van a modelar los datos a medida para el mejor rendimiento de sus informes. De la teoría a la práctica ya sabes que hay un mundo y eso solo te lo da la experiencia y haber hecho muchas pruebas. Como hemos visto en el artículo, sobre todo en esta última parte, hay excepciones incluso para el primer mandamiento del modelador de no mezclar hechos con dimensiones. Espero que hayas aprendido los fundamentos básicos de esta ciencia.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Power BI, Rendimiento, 3 comentarios

Usar PERFMON para detectar problemas de rendimiento de SQL

En este quinto video blog vamos a aprender a usar el monitor de rendimiento de Windows (PERFMON) para medir el rendimiento de SQL Server y poder detectar cuando hay algún problema. Es importante conocer previamente el estado normal de nuestros servidores para ser capaces de identificar cuando estamos ante un problema de rendimiento.

En el video hemos visto como usar en perfmon las métricas de uso de CPU combinadas con los lotes por segundo que procesa SQL Server así como la velocidad de lectura y escritura de los discos. Además de estas métricas también podemos revisar las compilaciones y recompilaciones de nuestro SQL Server cuyo valor ideal será un 10% o menos del total de lotes por segundo.

Espero que te haya gustado el video, si es así por favor, deja tu me gusta y suscríbete al canal que nos ayuda mucho. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram al que te puede unir. En este grupo estamos creando una comunidad de usuarios y administradores de SQL Server donde cualquiera pueda preguntar sus dudas y compartir sus casos prácticos para que todos seamos mejores profesionales. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, Videos, 0 comentarios