Rendimiento

TempDB SQL Server ¿Qué es y para qué sirve?

Hoy vamos a hablar de un tema muy interesante y relevante para los DBA: la TempDB de SQL Server. En este artículo vamos a intentar explicar qué es la TempDB, para qué sirve, cómo optimizarla y qué recomendaciones hay seguir para gestionarla correctamente.

¿Qué es la TempDB de SQL Server?

La TempDB es una base de datos especial que SQL Server utiliza para almacenar datos temporales, como tablas temporales, variables de tabla, cursores, versiones de filas, resultados intermedios de consultas, etc. Esta base de datos se crea cada vez que se inicia el servicio de SQL Server y se borra al apagarlo. Por lo tanto, no es necesario hacer copias de seguridad ni restauraciones de ella

¿Por qué es importante la TempDB para el rendimiento de SQL Server?

La TempDB es muy importante para el rendimiento y la estabilidad de SQL Server, ya que se usa en casi todas las operaciones que realiza el motor de base de datos. Si está mal configurada o tiene problemas de contención, puede afectar negativamente a todo el sistema. Por eso, es fundamental seguir las mejores prácticas que proporciona Microsoft en su documentación. Muchas veces hemos hablado de estas buenas prácticas en otros artículos pero hoy vamos a profundizar un poco más sobre ellas.

¿Por qué se llena la TempDB?

Como hemos dicho, es una base de datos que interviene en la mayoría de operaciones de SQL Server. Es lógico pensar que es de las bases de datos con más uso entonces, pero hay varias razones que pueden hacer que crezca en exceso. Veámoslo:

  • El uso excesivo de datos temporales por parte de las aplicaciones o los usuarios. Esto puede generar un gran número de objetos temporales que ocupan espacio en la TempDB hasta que se eliminan o se desconecta la sesión que los creó.
  • El uso de características que requieren versiones de fila, como el aislamiento de instantáneas o el aislamiento mediante versiones de fila. Esto puede generar un gran volumen de versiones de fila que se almacenan en el almacén de versiones de la TempDB hasta que se liberan o se desencadenan.
  • El uso de la TempDB como espacio de intercambio cuando se llena la memoria RAM del servidor. Esto puede ocurrir cuando se realizan operaciones que generan grandes volúmenes de datos intermedios o finales que no caben en memoria y tienen que ser escritos en disco.

Cuando la TempDB se llena, puede provocar errores en las operaciones que dependen de ella y afectar al rendimiento general del sistema. Por eso, es importante monitorizar el uso y el crecimiento de la TempDB y tomar medidas preventivas o correctivas para evitar que se llene.

Uso de la TempDB como espacio de intercambio

Otro aspecto a considerar es el uso de la TempDB como espacio de intercambio cuando se llena la memoria RAM del servidor. SQL Server puede usar la TempDB para almacenar los resultados intermedios o finales que no caben en memoria y que tienen que ser escritos en disco. Esto puede ocurrir cuando se realizan operaciones como ordenaciones, combinaciones hash o agregados hash. Este uso puede aumentar considerablemente el tamaño y la actividad de la TempDB y afectar al rendimiento general del sistema. Cuando esto pase veremos un aviso de alerta en los planes de ejecución de las consultas. Para evitarlo o minimizarlo, se recomienda lo siguiente:

  • Aumentar la memoria RAM del servidor para que pueda albergar más datos en memoria y reducir la necesidad de usar la TempDB como espacio de intercambio si es necesario.
  • Optimizar las consultas que generan grandes volúmenes de datos temporales, usando índices adecuados, estadísticas actualizadas, planes de ejecución óptimos y técnicas de programación eficientes.
  • Monitorizar el uso de la TempDB como espacio de intercambio, usando el monitor de rendimiento o los DMV sys.dm_db_task_space_usage (devuelve la actividad de asignación y desasignación de páginas por tarea de la base de datos) y sys.dm_db_session_space_usage (devuelve el número de páginas asignadas y desasignadas por cada sesión en la base de datos).

¿Cómo optimizar la TempDB de SQL Server?

Para optimizar la TempDB de SQL Server, hay que tener en cuenta varios aspectos, como el tamaño, el número de archivos, la ubicación, la caché y el uso de datos temporales. A continuación, os damos algunas recomendaciones que podéis aplicar para mejorar el funcionamiento de la TempDB.

Tamaño de la TempDB

Asignar un tamaño adecuado a la TempDB para evitar el crecimiento automático, que puede causar fragmentación y pérdida de rendimiento. Se puede usar el monitor de rendimiento o el DMV sys.dm_db_file_space_usage (devuelve información de uso del espacio para cada archivo de datos de la base de datos) para estimar el espacio necesario. La TempDB se llena cuando los datos temporales ocupan todo el espacio asignado y no hay más espacio disponible en el disco. Para evitar esto, se debe monitorizar el uso de la TempDB y ampliar su tamaño si es necesario.

Número de archivos de la TempDB

Crear varios archivos de datos para la TempDB, uno por cada núcleo del procesador, hasta un máximo de 8. Los archivos deben tener el mismo tamaño y el mismo factor de crecimiento, hasta SQL 2016 debiamos activar la traza  -T1117 en el arranque para que todos los ficheros crezcan simultáneamente pero en las nuevas versiones ya no es necesario. Esto ayuda a reducir la contención en las estructuras internas de la base de datos, como los PFS, GAM y SGAM por lo que mejora el rendimiento. Los PFS son las páginas que almacenan los bits que indican si una página está libre o usada. Los GAM son las páginas que almacenan los bits que indican si un intervalo de páginas está libre o usado. Los SGAM son las páginas que almacenan los bits que indican si un intervalo de páginas tiene al menos una página libre.

Ubicación de la TempDB

Colocar la TempDB en una unidad de disco diferente a las demás bases de datos, preferiblemente en un disco SSD o en una SAN con alto rendimiento y baja latencia. Esto mejora la velocidad de lectura y escritura de los datos temporales.

Caché de planes de ejecución

Habilitar la opción «optimize for ad hoc workloads» en las propiedades del servidor, para evitar que se almacenen en la caché los planes de ejecución de consultas que solo se usan una vez.

Uso de datos temporales

Evitar el uso excesivo de tablas temporales, variables de tabla y cursores, y usar alternativas como tablas derivadas, CTE o funciones escalares. Esto reduce la carga de trabajo sobre la TempDB y mejora la eficiencia de las consultas.

¿Cómo vaciar la TempDB?

En algunos casos, puede ser necesario vaciar la TempDB para liberar espacio en disco o resolver problemas de contención o corrupción. Para ello, se pueden usar los siguientes métodos:

– Usar el comando DBCC SHRINKDATABASE o DBCC SHRINKFILE. Estos comandos permiten reducir el tamaño de la TempDB o de sus archivos individuales, liberando el espacio no usado. Estos comandos se pueden ejecutar mientras el servidor está en funcionamiento, pero pueden causar bloqueos, interbloqueos o pérdida de rendimiento. Además, no garantizan que se pueda reducir el tamaño deseado, ya que dependen del uso y la distribución de los datos temporales. Podemos usar este script:

– Reiniciar el servicio de SQL Server. Esto hará que se vuelva a crear la TempDB con el tamaño configurado y se eliminen todos los datos temporales que había en ella. Este método es el más sencillo, pero requiere detener el servidor y afecta a todas las bases de datos y conexiones. Será nuestro último recurso y lo evitaremos siempre que sea posible.

Conclusión

Esperamos que este artículo os haya sido útil y os animamos a seguir aprendiendo sobre SQL Server con nosotros. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 2 comentarios

¿Qué es Target Recovery Time y cómo configurarlo en SQL?

En este artículo vamos a hablar de una configuración muy importante para el rendimiento y la recuperación de nuestras bases de datos en SQL Server: el Target Recovery Time. Esta configuración nos permite especificar el tiempo máximo que queremos que tarde SQL Server en recuperar una base de datos después de un fallo o un reinicio. ¿Por qué es importante esto? Porque afecta directamente a la frecuencia y el tamaño de los checkpoints que se realizan en la base de datos, y por tanto, al uso de los recursos de disco y memoria.

¿Qué son los checkpoints y cómo funcionan?

Los checkpoints son operaciones que escriben las páginas modificadas en memoria (dirty pages) al disco, para mantener la consistencia entre el buffer pool y los archivos de datos. Como ya vimos en nuestro artículo sobre Checkpoints en SQL Server, los checkpoints se pueden realizar por diferentes motivos: porque el sistema lo decide automáticamente, porque lo forzamos manualmente, porque hacemos un backup, porque cambiamos el estado de la base de datos, etc. Cada checkpoint tiene un impacto en el rendimiento, ya que consume recursos de E/S y puede generar contención con otras operaciones. Además, cada checkpoint determina el punto de inicio de la recuperación de la base de datos, ya que SQL Server solo tiene que rehacer o deshacer las transacciones que ocurrieron después del último checkpoint.

¿Qué es el Recovery Interval y cómo se usa?

Por defecto, SQL Server usa un algoritmo llamado Automatic Checkpoint para decidir cuándo hacer un checkpoint. Este algoritmo se basa en el Recovery Interval, que es un valor global para todas las bases de datos que indica el tiempo aproximado que queremos que tarde la recuperación. El valor por defecto del Recovery Interval es 0, lo que significa que SQL Server intentará que la recuperación tarde menos de un minuto. Para conseguir esto, SQL Server estima cuántas transacciones puede recuperar en un minuto, y hace un checkpoint cuando se alcanza ese número. Sin embargo, este algoritmo tiene algunos inconvenientes: no tiene en cuenta el tamaño o la duración de las transacciones, ni el impacto que tienen los checkpoints en el rendimiento. Además, el Recovery Interval es un valor aproximado, no una garantía, y solo se aplica a las bases de datos que usan el modelo de recuperación Simple o Bulk-Logged.

¿Qué es el Target Recovery Time y cómo se usa?

Para solucionar estos problemas, SQL Server introdujo una nueva opción a partir de la versión 2012: el Target Recovery Time. Esta opción nos permite especificar el tiempo máximo de recuperación para cada base de datos individualmente, independientemente del modelo de recuperación que use. El valor por defecto del Target Recovery Time es 0 para las versiones anteriores a 2016, y 60 para las versiones 2016 o posteriores. Esto significa que si usamos una versión anterior a 2016, se usa el algoritmo del Recovery Interval por defecto, pero si usamos una versión 2016 o posterior, se usa el algoritmo Indirect Checkpoint por defecto con un tiempo máximo de recuperación de 60 segundos. Pero si le damos un valor distinto de 0 (en versiones anteriores a 2016) o distinto de 60 (en versiones 2016 o posteriores), SQL Server usará el algoritmo Indirect Checkpoint con el valor especificado. Este algoritmo hace checkpoints más frecuentes y más pequeños, para asegurar que el tiempo de recuperación no supere el valor especificado. Además, este algoritmo tiene en cuenta el tamaño de las transacciones y el impacto de los checkpoints en el rendimiento, y ajusta la frecuencia y el tamaño de los checkpoints dinámicamente.

¿Qué ventajas e inconvenientes tiene usar el Target Recovery Time?

¿Qué ventajas tiene usar el Target Recovery Time y el Indirect Checkpoint? Pues varias:

  • Podemos tener un control más fino sobre el tiempo de recuperación de cada base de datos, y ajustarlo según nuestras necesidades.
  • Podemos reducir el tiempo de recuperación y mejorar la disponibilidad de nuestras bases de datos.
  • Podemos reducir el impacto de los checkpoints en el rendimiento, ya que se hacen más pequeños y más frecuentes.
  • Podemos reducir la presión sobre el buffer pool, ya que se liberan más rápidamente las páginas modificadas.
  • Podemos mejorar la compatibilidad con las nuevas características de SQL Server, como Accelerated Database Recovery (ADR), que requiere usar Indirect Checkpoint para funcionar correctamente.

¿Y qué inconvenientes tiene? Pues también algunos:

  • Podemos aumentar el consumo de recursos de disco, ya que se hacen más escrituras al hacer más checkpoints.
  • Podemos aumentar la fragmentación interna y externa de los archivos de datos, ya que se escriben más páginas en diferentes posiciones.
  • Podemos aumentar el riesgo de corrupción de datos, si hay algún problema con el hardware o con el sistema operativo durante los checkpoints.
  • Podemos tener problemas con algunas operaciones que requieren un checkpoint completo, como cambiar el estado o el modelo de recuperación de la base de datos.

¿Cómo cambiar el Target Recovery Time y el Recovery Interval?

Como vemos, no hay una respuesta única sobre si debemos usar o no el Target Recovery Time y el Indirect Checkpoint. Depende de cada caso, de las características de nuestras bases de datos, de nuestros requisitos de rendimiento y disponibilidad, y de los recursos que tengamos disponibles. Lo que sí podemos hacer es probar y medir el efecto que tiene esta configuración en nuestros entornos, y tomar una decisión informada.

Para cambiar el valor del Target Recovery Time de una base de datos, podemos usar el siguiente comando:

También podemos cambiarlo desde el Management Studio, en las propiedades de la base de datos, en la sección Options. Además del Target Recovery Time, también podemos cambiar el Recovery Interval de las instancias SQL Server, que es el valor global que se usa cuando el Target Recovery Time es 0.

Conclusión

Como hemos visto, podemos usar Recovery Interval y Target Recovery Time para tener mayor control sobre los checkpoints de nuestras bases de datos SQL Server. Con esto no solo conseguimos optimizar el uso de disco duro al reducir los requerimientos de E/S sino que además, controlamos el tiempo de recuperación tras un fallo del sistema. Recuerda siempre hacer las pruebas en un entorno dedicado antes de aplicar en producción. Y como siempre digo, si no es para resolver un problema, piensa si realmente merece la pena el riesgo.

Espero que este artículo te haya resultado útil e interesante. Si tienes alguna duda o comentario, no dudes en contactarnos en Twitter o por mail o dejarnos un mensaje en los comentarios de aquí abajo. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Checkpoints en SQL Server

Si recordáis, en el pasado artículo sobre la recuperación acelerada de base de datos hablamos de los Checkpoints. Como no lo habíamos explicado en profundidad y ya que son importantes para entender el comportamiento de nuestro SQL Server, les vamos a dedicar el post de hoy. Entender estos conceptos es clave para poder ajustar correctamente varias de las configuraciones de rendimiento que implementa SQL Server.

¿Qué son los Checkpoints?

Un checkpoint o punto de control de base de datos es, como su nombre indica, un punto conocido correcto sobre el que SQL Server aplicará los cambios del log durante la recuperación ante un error. 

Cuando ejecutamos una transacción de escritura (INSERT, UPDATE o DELETE), esta empezará a modificar datos pero, mientras no se confirme los cambios no serán definitivos. Esta es la teoría pero, la realidad difiere un poco. Por motivos de rendimiento, SQL Server carga las páginas de disco en memoria, escribe las modificaciones en las páginas en memoria y cada cierto tiempo, vuelca esas páginas modificadas en memoria (llamadas páginas desfasadas) al disco y al el log de transacciones. Esto es lo que llamamos checkpoint.

Tipos de Checkpoints

SQL Server tiene varios tipos de checkpoints en función de cómo y cuándo se ejecutan. Para entenderlo tenemos que conocer las opciones de configuración target recovery time de base de datos y la opción de instancia recovery interval de las que hablaremos más adelante.

Checkpoints Automáticos

Cuando la opción target recovery time de una base de datos está establecida en 0 se producirán checkpoints automáticos en segundo plano. Habrá un checkpoint cada vez que se alcance el número de páginas que SQL calcula que puede procesar en el tiempo establecido en la opción recovery interval (si está en 0 el tiempo será de 1 minuto).

El tiempo entre checkpoints puede variar en función del uso de las bases de datos, siendo mayor cuantas más transacciones de escritura se procesen. 

Si nuestras bases de datos están en modo simple, cuando el log de transacciones se llene al 70% de su tamaño máximo se detendrá el proceso de checkpoints. Sin embargo, a no ser que el log no se vacíe por algún otro motivo (replicaciones pendientes por ejemplo) el checkpoint automático truncará el log. 

Cuando ocurre un problema y SQL se detiene bruscamente, el tiempo de recuperación de nuestras bases de datos dependerá de la capacidad de E/S de nuestros discos para rehacer las páginas desfasadas al momento del bloqueo. La opción recovery interval tampoco afecta al tiempo para deshacer una transacción de larga duración. Esto hace que no se pueda calcular previamente el tiempo de inactividad en estos casos.

Checkpoints Indirectos

Con la llegada de SQL 2012 se presentaron los checkpoints indirectos gracias a la configuración de base de datos target recovery time. En un principio establecida a 0 por defecto hasta SQL 2016, donde se establece en 60 segundos por defecto para todas las nuevas bases de datos (las creadas previamente o restauradas de una versión anterior permanecerán en 0 por defecto). Esta configuración cambia el paradigma y, con ella, pasamos de contar el número de transacciones como pasaba con los checkpoints automáticos a contar el número de páginas desfasadas para calcular el tiempo de recuperación.

Con los checkpoint indirectos habilitados cualquier operación DML en la base de datos puede provocar un checkpoint en segundo plano para que el tiempo de recuperación se mantenga dentro de los límites establecidos. Esto que parece una buena opción puede no serlo tanto en entornos con muchas transacciones donde el incremento de E/S puede generarnos un cuello de botella en los discos duros. Por otro lado, reducir el tiempo de recuperación y por tanto aumentar la frecuencia de los checkpoints puede reducir los picos de consumo de E/S.

Gracias a estos puntos de control indirectos logramos un mayor control sobre los tiempos de recuperación de las bases de datos, siempre y cuando una transacción prolongada no provoque un tiempo de rollback elevado.

Checkpoint Manual

Estos son los checkpoints que podemos invocar nosotros mismos mediante la ejecución del comando CHECKPOINT situados en una base de datos en concreto. 

Checkpoints Internos

Los checkpoints internos se provocan porque una operación de SQL Server lo necesita. Entre estas operaciones que provocan un checkpoint interno podemos encontrar:

  • Modificar los archivos de base de datos mediante ALTER DATABASE.
  • Copias de seguridad.
  • Instantáneas de base de datos.
  • Parada de la base de datos automática porque Auto_Close está habilitado o porque un cambio de configuración requiere reiniciarla.
  • Paradas del servicio de SQL Server

Conclusión

Como hemos visto, los checkpoints son clave para el rendimiento de nuestro servidor. Tenemos que tener claro qué tipos de checkpoint están haciendo nuestras bases de datos y probar distintas configuraciones para lograr el menor consumo de E/S y optimizar al máximo el rendimiento de nuestro servidor. Sin embargo, se trata de una configuración crítica, si tienes un servidor de pruebas te aconsejo empezar a cambiar en él y siempre modificando los valores de pocos en pocos segundos. 

Espero que este artículo te haya resultado útil e interesante. Si tienes alguna duda o comentario, no dudes en contactarnos en Twitter o por mail o dejarnos un mensaje en los comentarios de aquí abajo. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 2 comentarios

Accelerated Database Recovery

En este artículo vamos a hablar de una de las novedades más interesantes que trajo SQL Server 2019: el Accelerated Database Recovery (ADR). Se trata de una característica que mejora el rendimiento y la disponibilidad de las bases de datos al reducir el tiempo de recuperación ante fallos o transacciones largas. ¿Quieres saber cómo funciona y cómo activarlo? ¡Sigue leyendo!

¿Qué es el Accelerated Database Recovery?

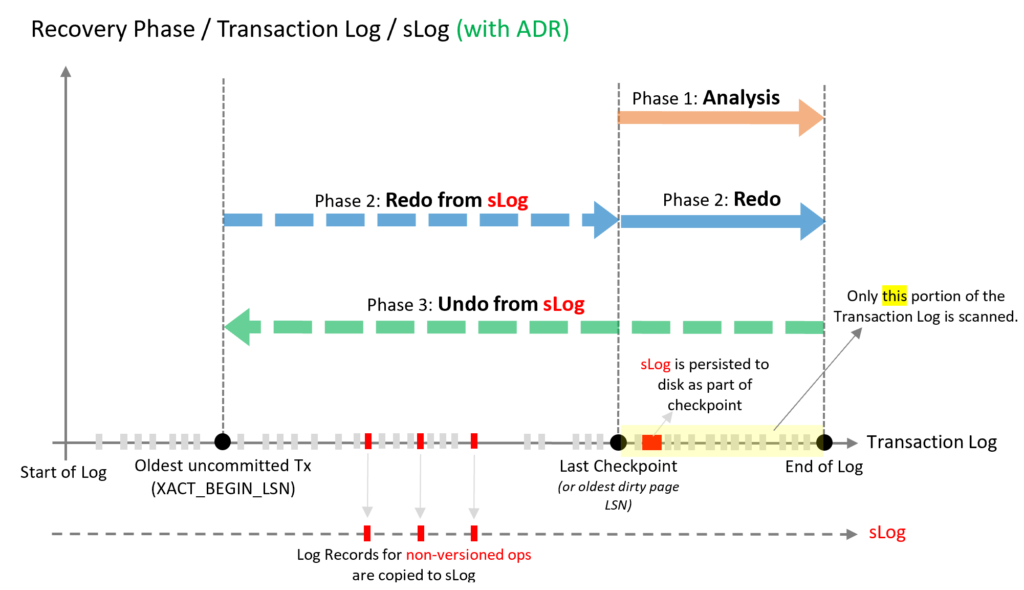
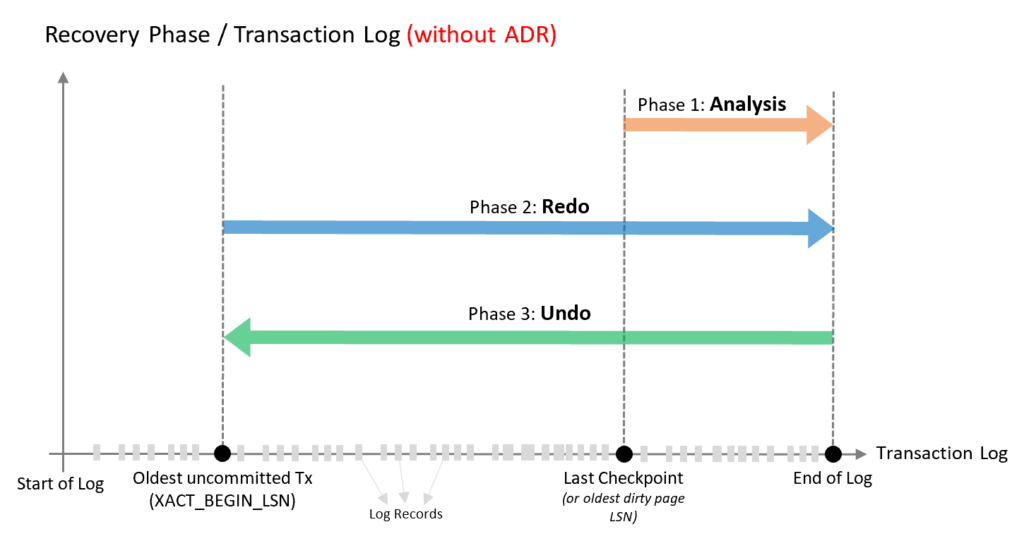
El Accelerated Database Recovery (ADR) es una funcionalidad que cambia la forma en que SQL Server gestiona el registro de transacciones y el proceso de recuperación. Con ADR, SQL Server utiliza una estructura de datos llamada Persistent Version Store (PVS) que almacena las versiones de las filas modificadas por las transacciones en curso. De esta forma, cuando se produce un rollback o un fallo del sistema, SQL Server no tiene que deshacer las modificaciones una por una, sino que simplemente recupera las versiones anteriores de las filas desde el PVS. Esto hace que el tiempo de recuperación sea mucho más rápido y predecible, independientemente del tamaño o la duración de las transacciones.

Además, el ADR también elimina el problema de los bloqueos por transacciones activas que consumen todo el espacio del log. Con ADR, SQL Server puede truncar el log sin esperar a que se completen las transacciones activas, ya que las versiones de las filas están en el PVS y no en el log. Esto evita que el log se llene y cause problemas de rendimiento o disponibilidad.

¿Qué ventajas tiene el Accelerated Database Recovery?

El Accelerated Database Recovery tiene varias ventajas para los administradores y desarrolladores de bases de datos:

  • Reduce el tiempo de recuperación ante fallos o cancelaciones de transacciones. Con ADR, el tiempo de recuperación es constante y no depende del número o tamaño de las transacciones. Esto mejora la disponibilidad y la continuidad del negocio.
  • Reduce el consumo de espacio del log. Con ADR, SQL Server puede truncar el log más frecuentemente y liberar espacio para nuevas transacciones. Esto reduce la necesidad de ampliar el log o hacer backups frecuentes.
  • Reduce los bloqueos por transacciones activas. Con ADR, SQL Server no tiene que esperar a que se terminen las transacciones activas para truncar el log. Esto evita los bloqueos por falta de espacio en el log y mejora el rendimiento y la concurrencia.
  • Facilita la gestión de transacciones largas o complejas. Con ADR, los desarrolladores pueden usar transacciones largas o complejas sin temor a que afecten al rendimiento o la disponibilidad de la base de datos. Esto permite implementar procesos de negocio más sofisticados y flexibles.

Una cosa más que debes saber sobre el ADR es que también afecta al funcionamiento de los checkpoints. Los checkpoints son procesos que escriben las páginas modificadas en memoria al disco para facilitar la recuperación. Con ADR, los checkpoints son más rápidos y eficientes, ya que solo escriben las páginas que han sido modificadas desde el último checkpoint y no dependen del estado de las transacciones. Esto también reduce la carga de E/S y mejora el rendimiento de la base de datos.

¿Cómo activar el Accelerated Database Recovery?

El Accelerated Database Recovery se activa a nivel de base de datos con el siguiente comando:

Es importante tener en cuenta que para activar el ADR, la base de datos debe estar en modo de compatibilidad 150 o superior (SQL Server 2019 o Azure SQL Database). Además, se recomienda tener suficiente espacio libre en el disco donde se almacena el PVS, ya que este puede crecer según la actividad de las transacciones. PVS se almacena en TempDB

Práctica

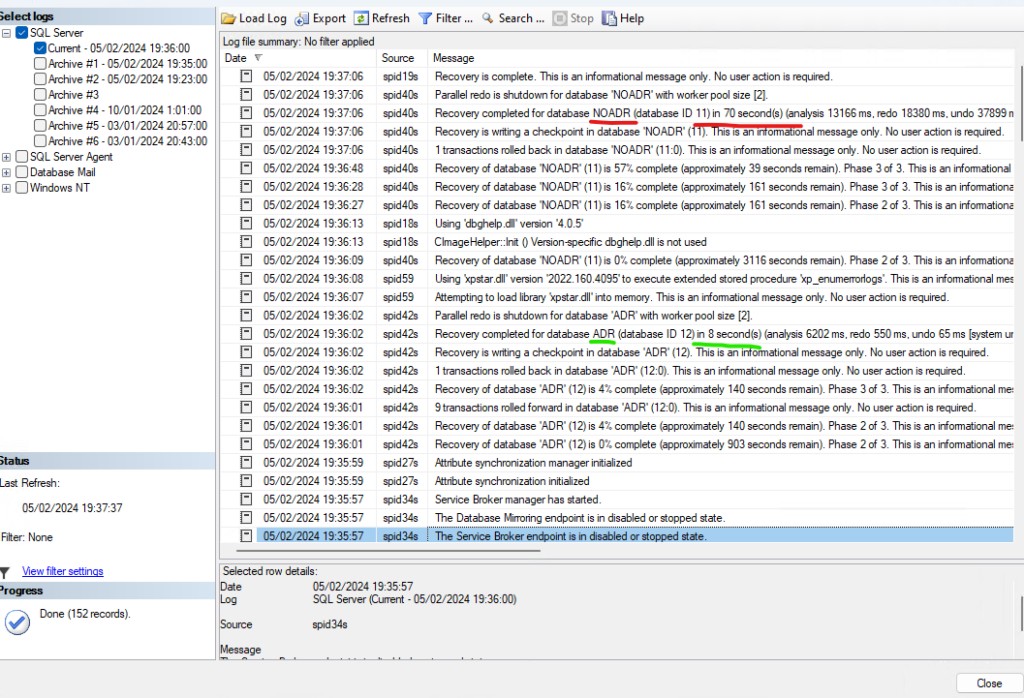
En la teoría todo es muy bonito, ahora vamos a verlo en la práctica a ver si es cierto. Para ello crearemos dos bases de datos, una con ADR activado y otra sin ello. Vamos a ejecutar sobre ellas unas consultas pesadas que se inicien justo a la vez y antes de que terminen vamos a forzar un apagado del servicio de SQL Server. Para terminar levantaremos de nuevo el servicio y veremos en el Log de SQL Server cuánto han tardado en estar disponibles:

Para crear las bases de datos he usado este script:

Lugo he ejecutado estos scripts en dos ventanas separadas (fijaos que se inician exactamente a la misma hora):

WAITFOR TIME '19:30:30';
USE NOADR;
GO
DROP TABLE IF EXISTS dbo.t1, dbo.t2, dbo.t3;
SELECT o1.* INTO dbo.t1 FROM sys.all_columns c1 CROSS JOIN sys.all_objects o1
SELECT o2.* INTO dbo.t2 FROM sys.all_columns c2 CROSS JOIN sys.all_objects o2
SELECT o3.* INTO dbo.t3 FROM sys.all_columns c3 CROSS JOIN sys.all_objects o3

En una tercera ventana he ejecutado este script para detener el servicio justo 5 minutos después de iniciar los anteriores:

Este que podéis ver ha sido el resultado, el rollback y por tanto la recuperación de la base de datos baja de 70 segundos sin ADR a 8 segundos con ADR activado: 

Esto creo que sobra decirlo pero, POR LO QUE MÁS QUERÁIS, NO HAGÁIS ESTA PRUEBA EN PRODUCCIÓN. Estamos probando a detener el servicio de SQL Server de manera forzada.

Conclusión

El Accelerated Database Recovery es una característica muy útil que mejora el rendimiento y la disponibilidad de las bases de datos en SQL Server 2019. Con ADR, se reduce el tiempo de recuperación ante fallos o cancelaciones de transacciones, se reduce el consumo de espacio del log, se reducen los bloqueos por transacciones activas y se facilita la gestión de transacciones largas o complejas. Si quieres aprovechar estas ventajas, te animamos a probar el ADR en tus bases de datos y a compartir tus experiencias con nosotros.

Espero que este artículo te haya resultado útil e interesante. Si tienes alguna duda o comentario, no dudes en contactarnos en Twitter o por mail o dejarnos un mensaje en los comentarios de aquí abajo. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 4 comentarios

Bloqueos y Deadlocks en SQL Server

Entender la concurrencia de nuestros procesos es muy importante para los DBAs que queremos optimizar el rendimiento de nuestras bases de datos. En este sentido, muchas veces hemos nombrado en el blog los bloqueos. Sin embargo, en este artículo vamos a profundizar en el tema y vamos a tratar de llevar nuestros conocimientos sobre el tema al siguiente nivel.

 ¿Qué es un bloqueo y por qué se produce?

Un bloqueo es un mecanismo que SQL Server utiliza para garantizar la integridad de los datos cuando hay transacciones concurrentes que acceden a los mismos recursos. Un recurso puede ser una fila, una página, una tabla, una base de datos o cualquier otro objeto de SQL Server. Una transacción es una secuencia de operaciones que se ejecutan como una unidad lógica y que deben cumplir las propiedades ACID (atomicidad, consistencia, aislamiento y durabilidad). Cuando una transacción accede a un recurso, solicita un bloqueo sobre él, que puede ser de varios tipos y modos, dependiendo de la operación que realiza y del nivel de aislamiento que tiene.

Por ejemplo, una transacción que lee un recurso solicita un bloqueo compartido (S), que permite que otras transacciones también puedan leer el mismo recurso, pero no modificarlo. Una transacción que modifica un recurso solicita un bloqueo exclusivo (X), que impide que otras transacciones puedan acceder al mismo recurso, ya sea para leerlo o modificarlo.

Tipos de bloqueos

Acabamos de nombrar los bloqueos compartidos (S) y los exclusivos (X) pero, estos no son los únicos tipos de bloqueos en SQL Server. Además de los bloqueos compartidos (S) y los exclusivos (X) nos podemos encontrar con bloqueos de actualización (U) que, son parecidos a los exclusivos pero más flexibles. En estos casos si un recurso tiene un bloqueo compartido el bloqueo de actualización generará otro bloqueo compartido hasta que pueda generar el bloqueo exclusivo. 

Para terminar tenemos los llamados bloqueos de intención o propósito (I), estos se dan cuando SQL Server sabe que va a necesitar uno de los bloqueos anteriores. De esta manera, SQL se garantiza poder obtenerlo cuando lo necesite. Nos podemos encontrar con 3 tipos de bloqueos de intenciones generales: IS, IX o IU en función de si el bloqueo que va a necesitar es compartido, exclusivo o de actualización.
Para terminar con los bloqueos de intención tenemos los bloqueos de intención de conversión y también tenemos 3 tipos. El primero de ellos es el bloqueo SIX que se da cuando SQL va a necesitar un bloqueo compartido (S) sobre una serie de recursos que va a leer y posteriormente tiene intención (I) de generar un bloqueo exclusivo (X) sobre unos pocos de esos recursos que va a actualizar. Del mismo modo tenemos los bloqueos SIU si un bloqueo compartido (S) se va a convertir en uno de actualización (U) y los UIX cuando un bloqueo de actualización (U) se va a convertir en un bloqueo exclusivo (X).

Otros tipos de bloqueos

Por otro lado, SQL Server implementa también bloqueos a nivel de esquema Sch-M y Sch-S. El primero se da cuando ejecutamos una operación DDL que modifica el esquema y es exclusivo mientras que el segundo es compartido y lo veremos cuando una consulta dependa de un esquema. 

Para terminar tenemos los bloqueos BU de carga masiva que se producen al cargar una tabla con Bulk Insert y la opción TABLOCK. Estas cargas no permitirán el acceso a la tabla mientras estén en curso.

Jerarquía de los bloqueos.

Otro aspecto que debemos tener en cuenta es el nivel de granularidad de los bloqueos, es decir, el tamaño de las unidades de datos que se bloquean. SQL Server puede utilizar cuatro niveles de granularidad: base de datos, tabla, página o fila. El primero de ellos nos garantiza por ejemplo que una base de datos no se puede eliminar o restaurar mientras está en uso por alguna consulta. Cualquier operación sobre un objeto de base de datos genera un bloqueo compartido en la propia base de datos.

Los otros tres nos los podremos encontrar en nuestras consultas. El nivel de granularidad afecta al rendimiento y a la contención. Por un lado, un nivel más fino (fila) reduce la probabilidad de que dos transacciones accedan al mismo recurso, pero aumenta el número de bloqueos y el consumo de memoria. Por otro lado, un nivel más grueso (tabla) reduce el número de bloqueos y el consumo de memoria, pero aumenta la probabilidad de contención y tiempo de espera. SQL Server utiliza un algoritmo dinámico para elegir el nivel de granularidad más adecuado para cada caso, pero también podemos influir en esta decisión mediante las opciones de índice o las sugerencias de tabla.

Cómo funcionan los bloqueos

Si habéis llegado hasta este punto con el cerebro como un yogurt es normal. Esto no es fácil de entender, vamos a verlo con un ejemplo simple para entenderlo. Supongamos que en nuestra base de datos Animalitos tenemos un esquema MascotasAdorables y en ella una tabla Gatetes. Cuando nosotros queramos leer una fila de nuestra tabla, SQL Server generará un bloqueo compartido (S) sobre la fila de la tabla que vamos a leer, pero a la vez generará un intento de bloqueo compartido (IS) sobre la página que contiene esa fila y sobre la tabla MascotasAdorables y otro bloqueo (S) sobre la base de datos Animalitos.

Los dos bloqueos compartidos (S) están claros, como hemos dicho SQL siempre genera un bloqueo sobre la base de datos y al ser un select genera otro sobre la fila que estamos leyendo. Los bloqueos de intención compartidos (IS) nos garantizan que se podrán escalar a un bloqueo compartido (S) si alguien intenta borrar o modificar nuestra tabla o la página mientras estamos leyendo. 

Compatibilidad de los bloqueos

Como hemos visto, un recurso puede tener varios bloqueos compartidos simultáneos y sin embargo solo uno exclusivo (por eso sus nombres, tampoco se mataron pensando aquí). Ahora vamos a ver como de compatibles son los bloqueos entre ellos.

Deadlocks

Los deadlocks, en español interbloqueos o bloqueos permanentes, se producen cuando dos o más transacciones se bloquean mutuamente, impidiendo que ninguna de ellas pueda avanzar. 

Imagina que tenemos dos transacciones la A y la B. Nuestro proceso A ha leído una fila de la tabla gatetes y quiere escribirla en la tabla felinos. Es decir ha generado un bloqueo compartido (S) en la tabla gatetes y tiene que generar un bloqueo exclusivo (X) en la tabla felinos. Cuando va a generar este bloqueo se encuentra con que el proceso B ya ha leído de la tabla felinos y tiene sobre ella un bloqueo compartido (S) por lo que se tiene que esperar a que termine (según la tabla anterior S y X no son compatibles). Sin embargo el proceso B no va a terminar nunca porque está esperando a escribir en la tabla gatetes lo que ha leído. Esa escritura es un bloqueo compartido (X) que no puede hacerse porque ya hay un bloqueo compartido sobre esa tabla. 

SQL Server detecta estos escenarios y elige una de las transacciones como víctima, matándola y liberando los recursos que tenía bloqueados. Esto puede causar errores y pérdidas de datos en las aplicaciones que no están preparadas para manejar estos casos. 

¿Cómo podemos evitar o reducir los bloqueos e interbloqueos en SQL Server? 

Hay varias estrategias que podemos aplicar, dependiendo del contexto y el tipo de operaciones que realizamos. Algunas de estas estrategias son:

  • Diseñar índices adecuados que permitan acceder a los datos con el menor número de lecturas y escrituras posibles.
  • Utilizar transacciones cortas y simples que minimicen el tiempo que mantienen los bloqueos sobre los recursos.
  • Elegir el nivel de aislamiento apropiado para cada transacción, teniendo en cuenta el equilibrio entre la consistencia de los datos y el rendimiento. En anteriores artículos hemos hablado de los diferentes niveles de aislamiento que ofrece SQL Server y cómo afectan a los bloqueos y a la visibilidad de los datos.
  • Evitar el uso indiscriminado de la opción NOLOCK, que puede provocar lecturas sucias, perdidas o duplicadas. En este artículo explicamos los problemas del uso de NOLOCK.
  • Monitorizar los bloqueos e interbloqueos que se producen en nuestras bases de datos, utilizando las herramientas y vistas que SQL Server nos proporciona. De esta forma podremos identificar las causas y las soluciones más adecuadas para cada caso.

¿Cómo podemos identificar los bloqueos e interbloqueos que se producen en nuestras bases de datos?

SQL Server nos ofrece varias herramientas y vistas para monitorizar y analizar estos fenómenos. Algunas de estas herramientas y vistas son:

  • El Monitor de actividad, que nos permite ver en tiempo real las sesiones, procesos, bloqueos e interbloqueos que se están produciendo en nuestra instancia.
  • La vista sys.dm_tran_locks, que nos muestra información detallada sobre los bloqueos actuales, como el tipo, el modo, el recurso, la sesión y la transacción asociados.
  • La vista sys.dm_exec_requests, que nos muestra información sobre las solicitudes en ejecución, como el estado, el tiempo transcurrido, el tiempo esperado y la causa del tiempo de espera.
  • La vista sys.dm_os_waiting_tasks, que nos muestra información sobre las tareas en espera, como la sesión, la solicitud, la duración y el tipo del tiempo de espera.
  • El evento extendido deadlock graph, que nos muestra información sobre los interbloqueos ocurridos, como las transacciones involucradas, los recursos implicados y la víctima elegida.

Conclusión

Los bloqueos e interbloqueos son aspectos inevitables en cualquier sistema de gestión de bases de datos relacionales, pero no por ello debemos resignarnos a sufrir sus consecuencias negativas. Con un buen diseño, una correcta elección del nivel de aislamiento y una constante monitorización podremos mejorar el rendimiento y la fiabilidad de nuestras bases de datos. Esperamos que este artículo os haya sido útil y os animamos a compartir vuestras experiencias y dudas con nosotros en los comentarios.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 3 comentarios

Optimizando el rendimiento de nuestras consultas SQL Server

En este artículo vamos a hablar de las causas más comunes de mal rendimiento en consultas de SQL Server y cómo optimizarlas. Sabemos que el rendimiento es un aspecto crítico para cualquier aplicación que utilice una base de datos, y que SQL Server es uno de los sistemas de gestión de bases de datos relacionales más populares y potentes del mercado. Sin embargo, también sabemos que no basta con instalar SQL Server y esperar que todo funcione a la perfección. Hay que tener en cuenta una serie de factores que pueden afectar al rendimiento de las consultas, tanto a nivel de diseño como de implementación y mantenimiento.

Problemas de rendimiento por malas consultas

La forma en la que obtenemos los datos marca directamente el rendimiento de nuestros procesos, dos consultas pueden devolver exactamente el mismo resultado pero una con menos consumo de recursos que la otra. A esto es a lo que vamos a llamar optimizar una consulta. Reescribiremos la consulta evitando las siguientes prácticas en la medida de lo posible: 

Funciones 

Las funciones son un objeto de base de datos que nos permite encapsular código en un objeto para utilizarlo después simplemente llamando a ese objeto. Sin embargo, de cara al rendimiento pueden generarnos problemas. 

Por un lado tenemos las funciones escalares, estas son las más inofensivas en cuanto a rendimiento pero cuidado con usarlas dentro de un filtro del WHERE. Estas funciones impiden que el optimizador de consultas utilice índices y obligan a realizar escaneos completos de las tablas, lo que consume más recursos y tiempo.

El otro tipo de funciones que tenemos en SQL son las funciones de tabla. Las funciones de tabla son objetos que devuelven un conjunto de filas como resultado de una consulta o una expresión. Aunque pueden ser útiles para resolver ciertos problemas complejos o integrar datos heterogéneos, también pueden afectar al rendimiento si no se usan correctamente. Por ejemplo, una función de tabla puede generar una estimación errónea del número de filas devueltas. Además, necesitan ser cargadas completamente en memoria antes de poderse ejecutar. Esto nos puede provocar un plan subóptimo o un desbordamiento de memoria. Y, aun en el caso de que la función se pueda cargar en memoria, la consulta deberá esperar a que se resuelva completamente la consulta antes de seguir con otros componentes.

Cursores o bucles para procesar datos. 

Estas técnicas son propias de la programación estructurada y no aprovechan la naturaleza en bloques de SQL Server. Además, generan un mayor número de accesos a disco y bloqueos, lo que reduce el rendimiento y la concurrencia. Para evitarlo, se recomienda utilizar consultas que operen sobre conjuntos de datos en lugar de sobre filas individuales.

Subconsultas

El uso de subconsultas en ocasiones es imprescindible, sin embargo, usarlas en el SELECT o en el WHERE tienen un impacto negativo en el rendimiento. Las subconsultas son consultas anidadas dentro de otras consultas, que pueden devolver uno o varios valores. Aunque pueden ser útiles para resolver ciertos problemas complejos, también pueden afectar al rendimiento si no se usan correctamente. Por ejemplo, una subconsulta correlacionada es aquella que depende del valor devuelto por la consulta principal, lo que implica que se tenga que ejecutar tantas veces como filas devuelva la consulta principal. Esto puede generar un gran consumo de recursos y tiempo. Para evitarlo, se recomienda reescribir la consulta para utilizar JOINs.

Servidores vinculados 

Los servidores vinculados son objetos que permiten acceder a datos almacenados en otros servidores mediante consultas distribuidas. Un servidor vinculado puede generar una latencia adicional al tener que comunicarse con otro servidor, lo que puede ralentizar la ejecución de la consulta. Además, nuestro SQL Server desconocerá la estimación de resultados que van a llegarnos del servidor remoto por lo que podemos tener los mismos problemas de memoria que hemos visto con las funciones de tabla. Se recomienda utilizar servidores vinculados únicamente cuando sea necesario y con criterios restrictivos para minimizar el volumen de datos transferidos.

Problemas de rendimiento por diseño y arquitectura

En ocasiones aunque nuestra consulta esté optimizada sigue rindiendo mal, y esto puede ser debido, entre otras cosas, a un mal diseño de las soluciones de bases de datos. Veamos ahora los principales problemas de diseño:

Consultas dinámicas o ad hoc

Estas consultas se construyen en tiempo de ejecución y no se almacenan en el caché del plan de ejecución, lo que implica que el optimizador tenga que generar un nuevo plan cada vez que se ejecutan. Esto consume más recursos y tiempo, y puede provocar planes subóptimos. Para evitarlo, se recomienda utilizar procedimientos almacenados o consultas parametrizadas, que se almacenan en el caché y se reutilizan cuando se ejecutan con los mismos parámetros. A este tema le dedicamos ya un artículo hace unos días. 

Problemas de rendimiento de índices

Los índices son estructuras que facilitan la localización y el acceso a los datos, y son esenciales para mejorar el rendimiento de las consultas. Sin embargo, hay que tener cuidado con el tipo, el número y la definición de los índices, ya que pueden tener efectos negativos si no se usan correctamente. Por ejemplo, un índice demasiado grande o con muchas columnas puede ralentizar las operaciones de inserción, actualización o borrado, o consumir demasiado espacio en disco. Un índice mal diseñado o no utilizado puede generar escaneos innecesarios o planes ineficientes. Un índice faltante puede obligar a realizar escaneos completos o búsquedas secuenciales.
Para evitarlo, se recomienda analizar las consultas más frecuentes o críticas y crear índices adecuados para ellas, teniendo en cuenta las columnas usadas en los predicados WHERE, JOIN, ORDER BY y GROUP BY, así como la cardinalidad y la selectividad de los datos. En este blog le hemos dedicado a los índices más de media docena de artículos que os recomiendo leer.

Estadísticas desactualizadas

Las estadísticas son objetos que almacenan información sobre la distribución y la frecuencia de los valores en las columnas de las tablas e índices. El optimizador de consultas utiliza esta información para estimar el coste y elegir el mejor plan de ejecución posible. Sin embargo, si las estadísticas no reflejan la realidad de los datos, el optimizador puede generar planes subóptimos o erróneos, lo que afecta al rendimiento. Para evitarlo, se recomienda mantener las estadísticas actualizadas mediante trabajos programados como los que vimos aquí. 

Problemas de rendimiento por tipos de datos inadecuados

Los tipos de datos son los que definen el formato, el tamaño y el rango de los valores que se almacenan en las columnas de las tablas e índices. Elegir el tipo de dato adecuado para cada columna es fundamental para optimizar el rendimiento de las consultas, ya que influye en el espacio ocupado, la velocidad de acceso, la precisión y la compatibilidad. Por ejemplo, un tipo de dato demasiado grande o con una precisión innecesaria puede consumir más espacio en disco y memoria, lo que ralentiza las operaciones y aumenta el riesgo de desbordamiento. Un tipo de dato incompatible con el valor esperado puede generar errores o conversiones implícitas, lo que afecta a la calidad y la eficiencia de los datos.
Para evitarlo, se recomienda elegir el tipo de dato más apropiado para cada columna, teniendo en cuenta el valor máximo, mínimo y medio que se espera almacenar, así como el uso que se le va a dar. 

Es importante usar el mismo tipo de datos a la hora de escribir la consulta que el que hay en las tablas ya que una conversión obligará a SQL Server escanear completamente las tablas e índices y no poder beneficiarse de las características de árbol B.

Problemas de rendimiento por el servidor

Para terminar, vamos a ver el último factor posible en la degradación del rendimiento, el servidor. En ocasiones nos vamos a encontrar con diseños de bases de datos y consultas optimizadas y sin embargo un mal rendimiento. La principal causa de problemas con el rendimiento del servidor está relacionada con el consumo de recursos. Y es que cuando esto pasa, normalmente tendremos otro proceso ajeno al nuestro consumiendo todos los recursos del servidor. Aunque es cierto que optimizando nuestras consultas y modelos de datos necesitaremos nosotros menos recursos y seremos más resilientes ante este tipo de escenarios, en ocasiones no será suficiente y veremos como la ruedecita de abajo a la izquierda de nuestra pantalla no deja de dar vueltas y nuestra consulta no termina.

En estas ocasiones yo tiro de recursos como los procedimientos sp_who3 y sp_whoisactive para ver qué más hay en ejecución en SQL Server y ver si lo puedo detener o tengo que ir a dar una colleja a alguien. 

Bloqueos

Otro posible problema que detecto con esos procedimientos son los bloqueos. Los bloqueos son mecanismos que garantizan la integridad y la consistencia de los datos cuando se realizan operaciones concurrentes sobre la base de datos. Sin embargo, también pueden afectar al rendimiento si no se gestionan correctamente. Por ejemplo, un bloqueo excesivo o innecesario puede impedir o retrasar el acceso a los datos por parte de otras transacciones, lo que reduce la concurrencia y genera esperas. Un bloqueo insuficiente o incorrecto puede provocar problemas de integridad o consistencia, como lecturas sucias o pérdidas. Para evitarlo, se recomienda utilizar el nivel de aislamiento adecuado para cada transacción, teniendo en cuenta el grado de consistencia y concurrencia que se requiere. Hablamos de niveles de aislamiento aquí.

Problemas ajenos a SQL

Si esto no devuelve nada esclarecedor es posible que el proceso que esté consumiendo los recursos sea ajeno a SQL Server y tendremos que mirar los procesos en ejecución del sistema operativo. En una ocasión me he encontrado con un caso peor, la cabina de discos estaba saturada y aunque mi servidor estaba rascándose el ombligo no había manera de que terminaran las consultas. Esto si que es un verdadero expediente X difícil de encontrar y ojalá no tengáis que lidiar nunca con una situación tan compleja. 

Conclusión

Estas son solo algunas de las causas más comunes de mal rendimiento en consultas de SQL Server, pero hay muchas más que pueden influir en el comportamiento del sistema. Te invitamos a revisar los artículos que he enlazado a este si quieres profundizar más en estos temas.

Espero que este artículo te haya resultado útil e interesante. Si tienes alguna duda o comentario, no dudes en contactarnos en Twitter o por mail o dejarnos un mensaje en los comentarios de aquí abajo. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Optimizando SQL Server para BizTalk

Durante los anteriores post hemos comentado las recomendaciones de instalación de SQL para SharePoint y sus configuraciones recomendadas, como ha tenido muy buena acogida vamos a continuar con esta línea esta vez hablando de las buenas prácticas de SQL Server para BizTalk. 

Existen varios factores que tenemos que tener en cuenta en nuestro SQL Server para BizTalk. En este artículo vamos a intentar ver los más importantes no solo para configurar nuestro SQL sino para mantenerlo y solucionar los problemas que nos puedan surgir.

¿Qué es BizTalk?

Empecemos por el principio, BizTalk es un producto de Microsoft que facilita la comunicación entre sistemas heterogéneos, tanto dentro como fuera de la organización. BizTalk permite crear flujos de trabajo (orquestaciones) que definen la lógica y las reglas de negocio para procesar los mensajes que se intercambian entre los sistemas. Además, también ofrece herramientas para transformar, enrutar, monitorizar y auditar los mensajes, así como para gestionar las excepciones y errores que puedan ocurrir.

BizTalk se basa en una arquitectura distribuida que consta de varios componentes, entre los que se encuentra SQL Server. SQL Server es el encargado de almacenar la información relativa a las configuraciones, las instancias, las suscripciones, el seguimiento y el archivado de los mensajes. Por tanto, el rendimiento y la disponibilidad de SQL Server son fundamentales para el correcto funcionamiento de BizTalk.

Bases de datos de BizTalk

BizTalk usa varias bases de datos y es importante que las conozcamos pues no todas van a requerir las mismas medidas por nuestra parte. Las principales bases de datos que debemos conocer son: BizTalkMgmtDb (base de datos de administración), BizTalkMsgBoxDb (base de datos del buzón), BizTalkDTADb (base de datos del seguimiento), SSO (base de datos del servicio de configuración) y BAM (base de datos del análisis de negocio).

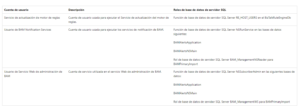
Usuarios de BizTalk

Además de las bases de datos BizTalk creará una serie de inicios de sesión y roles en nuestro SQL Server. Podemos verlo en la siguiente tabla que proporciona Microsoft (haz click sobre la imagen para ampliar).

Configuraciones de SQL Server ideales para BizTalk

Con estos conocimientos previos en mente ya podemos entrar en materia sobre la configuración de SQL Server específica para BizTalk. Vais a ver que algunas son similares a las que vimos para SharePoint. 

Configuraciones de SQL Server

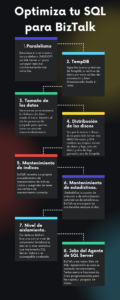
Es importante que establezcamos el nivel de paralelismo a 1, ya que BizTalk genera muchas (muchísimas) consultas aunque muy ligeras. Con esto nos aseguraremos de poder dar salida a las máximas consultas posibles de manera simultánea.

En cuanto al Fill Factor, la documentación oficial no hace mención a un valor concreto sin embargo sí que nos habla de que la mayoría de los índices son clustered y con identificadores únicos basados en GUID por lo que no es recomendable poner un Fill Factor del 100%. Mi consejo es dejar el parámetro por defecto ya que no se especifica otra cosa. Más adelante volveremos al tema de los índices porque va a ser un dolor de cabeza.

Configuración de TempDB

Aunque este es un consejo general para todos los SQL Server, en el caso de BizTalk tiene mucha importancia porque ejecuta cantidades impensables de transacciones. Dividiremos nuestra base de datos en tantos ficheros como núcleos tenga nuestra CPU (hasta un máximo de 8) a fin de que varios hilos puedan acceder al recurso sin bloqueos de páginas. Todos los ficheros tendrán el mismo tamaño inicial y si usamos un SQL inferior a 2016 habilitaremos la traza  -T1117 en el arranque para que todos los ficheros crezcan simultáneamente. Sin embargo, debemos anticipar el tamaño de la TempDB y dimensionarla previamente para evitar el extra de tiempo del crecimiento de los archivos.

Tamaños de las bases de datos de BizTalk

Al igual que con la TempDB es importante que establezcamos un tamaño inicial y un crecimiento a los ficheros de las bases de datos de la aplicación para optimizar el rendimiento. En entornos pequeños y medianos podemos usar el siguiente script:

Utilizaremos estos parámetros para entornos standalone y pequeños. En un entorno BizTalk de alto rendimiento, deberemos considerar dividir la BizTalkMsgBoxDb en 8 archivos de datos, cada uno con un tamaño de archivo de 2 GB con 100 MB de crecimiento y un archivo de registro de 20 GB con 100 MB de crecimiento. Debido a que las bases de datos BizTalk MessageBox son las más activas, colocaremos los archivos de datos y los archivos de log de transacciones en unidades dedicadas para reducir la probabilidad de problemas de E/S de disco, como vamos a ver ahora.

Configuración de discos duros de SQL Server para BizTalk

Entramos, sin duda, en el apartado más importante para el futuro rendimiento de nuestras aplicaciones BizTalk, de esto va a depender que nuestra aplicación siga funcionando como al principio cuando empiece a tener un tamaño considerable. Por eso es el apartado en el que más nos vamos a extender hoy.

Por defecto, BizTalk coloca la base de datos MessageBox en un único archivo en el grupo de archivos predeterminado. Y por defecto, los datos y logs de transacciones para todas las bases de datos también se colocan en la misma unidad y ruta. Esto se hace para poder funcionar en sistemas con un único disco. Sin embargo, esta configuración de un único archivo, grupo de archivos y disco no es óptima en un entorno de producción. Para un rendimiento óptimo, los archivos de datos y los archivos de log deben colocarse en discos separados.

Otra cosa que debemos tener en cuenta, especialmente para entornos de alto volumen, y de nuevo, porque las bases de datos MessageBox y Tracking son las más activas, es colocar los archivos de datos y los logs de transacciones de estas dos bases de datos en unidades dedicadas para reducir la probabilidad de problemas de E/S de disco.

Por tanto para un rendimiento óptimo nuestro SQL Server deberá tener por lo menos 7 discos duros de datos:

  1. Archivo(s) de datos MessageBox
  2. Archivo(s) de log de transacciones de MessageBox
  3. Archivo(s) de datos de BizTalk Tracking (DTA)
  4. Archivo(s) de log de transacciones de BizTalk Tracking (DTA)
  5. Otros archivos de datos de bases de datos BizTalk
  6. Otros archivos de registro de transacciones de bases de datos BizTalk
  7. TEMPDB

Buscando la perfección en el reparto de discos

Esta técnica descrita anteriormente será familiar para cualquiera que haya creado una instalación grande y multiservidor de BizTalk Server. Además, es preferible que la base de datos de seguimiento (DTA) se sitúe en un servidor separado (o clúster en un entorno de alta disponibilidad) del buzón de mensajes.
Otra de las mejores optimizaciones de rendimiento que podemos hacer es repartir las tablas de las bases de datos de BizTalk entre varios grupos de archivos. Cada grupo de archivos añade un hilo de E/S que, junto con el archivo de datos en un LUN separado, mejorará enormemente el rendimiento (con ganancias del 100-1000%, dependiendo de las características de carga del sistema). No sólo moveremos los datos de la tabla a grupos de archivos separados, sino también los datos LOB y los índices no agrupados. Esto maximiza el paralelismo entre consultas y otras operaciones de base de datos. Haremos esto si nuestra base de datos MessageBox es cercana o mayor a 15 GB. 

En entornos pequeños o medianos sin una gran cantidad de mensajes, no es necesario tener tanta separación en discos. Sin embargo, es muy recomendable que al menos tengamos unidades dedicadas para los archivos de datos y de logs (para permitir que la actividad de E/S se produzca al mismo tiempo para los archivos de datos y de log) y una unidad dedicada para TEMPDB.

Índices y estadísticas en las bases de datos de BizTalk

BizTalk hace su propia gestión de los índices y estadísticas de las bases de datos por lo que tendremos que asegurarnos de que todas las bases de datos de la aplicación tengan tanto la creación como la actualización automática de estadísticas deshabilitadas.

El tema de los índices es más delicado, ya que un mal mantenimiento nos llevará a un escenario insostenible de continuos bloqueos que harán perder la paciencia a los usuarios. Para complicarnos aún más las cosas BizTalk no admite un mantenimiento estándar de índices, es decir no podremos programar nuestros habituales planes de mantenimiento nativos o de Ola Hallengren, o bloquearemos por completo la aplicación.

El único método admitido para mantenimiento de índices en la base de datos BizTalkMsgBoxDb es ejecutar el procedimiento almacenado bts_RebuildIndexes. En BizTalk Server 2006 y versiones posteriores, tenemos también el procedimiento almacenado dtasp_RebuildIndexes para en la base de datos BizTalkDTADb. Por si te parece poco, estos procedimientos solo se pueden ejecutar cuando la aplicación no tiene carga, es decir cuando no está procesando mensajes por lo que es vital acordar con el administrador de la aplicación una ventana de mantenimiento para ejecutarlo. Para poder ejecutar el mantenimiento de índices todas las instancias de BizTalk y el Agente de SQL deben estar detenidos.

Niveles de aislamiento

El valor predeterminado de Transaction Isolation Level es Serializable para el adaptador de BizTalk WCF-SQL tanto para las operaciones entrantes y salientes. Esto provoca gran cantidad de bloqueos, que aunque no deberían ser un problema en entornos pequeños y con poca carga de trabajo puede que nos de problemas en cuanto el volumen de peticiones se incremente. Por suerte el administrador de BizTalk podrá cambiar esta configuración. Revisa nuestro articulo de niveles de aislamiento para entender mejor este tema.

Agente de SQL Server

Por último, pero no menos importante, como se suele decir, tenemos que prestar atención a los jobs de SQL Server que genera BizTalk. Dependiendo de la versión de BizTalk se generarán 12 o 13 jobs, la mayoría realizan procesos internos de la aplicación que, como DBAs, no hace falta conocer. Sin embargo es muy importante que si atendamos a dos de ellos que se llaman «Backup BizTalk Server» y  «DTA Purge and Archive». Estos dos jobs son críticos y por defecto nos vienen programados por lo que tendremos que hacerlo nosotros. El primero de ellos, como habréis adivinado por el nombre, se encarga de las copias de seguridad de las bases de datos siguiendo las buenas prácticas de Microsoft para ello. El segundo, es el encargado de purgar y archivar la información de la base de datos de seguimiento y, eso es lo principal para no tener degradaciones del rendimiento.

Conclusión

En este artículo he compartido con vosotros algunas buenas prácticas de configuración de SQL Server para BizTalk, que os pueden ayudar a mejorar el rendimiento, la escalabilidad y la seguridad de vuestra plataforma de integración. Espero que os hayan resultado útiles y que las pongáis en práctica. Si tenéis alguna duda o comentario, podéis dejarlo abajo, en mi Twitter o por mail. 

PD: Si esto os ha parecido poco podéis ampliar toda esta información el la guía de documentación de Microsoft aquí.

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios