Rendimiento

Azure Arc para SQL Server

Desde hace años, en cada evento, webinar o presentación de infraestructura de Microsoft se repite como un mantra: el futuro es híbrido. Y aunque muchos se limitan a asentir mientras piensan en cómo sobrevivir al próximo reinicio inesperado del servidor de producción, lo cierto es que algo de razón tienen. Especialmente cuando aparece una herramienta que, por una vez, parece estar pensada para los que aún tenemos servidores físicos, clústeres que no caben en una suscripción y dolores de cabeza por políticas de compliance que cambian más que los nombres de productos en Microsoft. Hablemos claro: Azure Arc para SQL Server on-premises no es la panacea, pero sí un paso sensato hacia un control centralizado sin obligarnos a renunciar al datacenter de toda la vida.

¿Qué demonios es Azure Arc (y por qué debería importarnos)?

Empecemos por el principio, ¿qué es Azure Arc? En resumen es la forma en que Microsoft intenta convencernos de que Azure no es solo «la nube», sino «la plataforma de gestión» para todos nuestros recursos, estén donde estén. Y eso incluye nuestros SQL Server instalados con sudor y lágrimas en máquinas físicas, clústeres locales o VM que jamás verán una IP pública.

Azure Arc extiende la gestión de Azure a recursos externos como servidores, Kubernetes, y por supuesto, SQL Server. Pero aquí viene la parte jugosa: Azure Arc para SQL Server no instala una nueva base de datos ni te obliga a migrar nada. Lo que hace es registrar tu instancia on-premises en Azure, otorgándole una especie de identidad en el portal.

Una vez enlazada, puedes aplicar políticas, ver inventario, tener visibilidad de cumplimiento de licencias (sí, esa parte duele), activar extensiones como Defender for SQL o habilitar seguimiento de seguridad desde el Azure Security Center. Todo sin tocar la base de datos. Bueno, casi.

Cómo funciona realmente Azure Arc (no la versión edulcorada del marketing)

Cuando conectamos una instancia de SQL Server a Azure Arc, lo que instalamos es un agente: el Azure Connected Machine Agent, junto con una extensión específica para SQL. Este agente se comunica con Azure a través de HTTPS, informa de configuraciones, recopila datos de diagnóstico y permite acciones remotas de configuración.

Para que funcione, necesitas tener SQL Server 2012 o superior, y una conexión de red desde el servidor hacia Internet (no hace falta conexión entrante, lo cual es un alivio). Lo ideal es tener SQL autenticado con Active Directory para poder controlar mejor el acceso, pero se puede hacer también con SQL Auth si quieres vivir al límite.

Una vez conectado, la instancia aparece en el portal de Azure como un recurso más. Desde ahí podemos aplicar políticas, revisar vulnerabilidades de seguridad, controlar el uso de features según la edición (lo cual es útil para evitar sorpresas desagradables con licencias), monitorizar comportamiento con Azure Monitor o, incluso, balancear nuestro Always On. Todo ello sin abrir el Management Studio… aunque claro, a veces sigue siendo necesario.

Casos reales donde Azure Arc tiene sentido (y donde no)

Supongamos que gestionamos un parque de 40 servidores SQL distribuidos entre varios centros de datos. Algunos son máquinas virtuales, otros físicos con clústeres Always On que llevan más tiempo activos que algunos desarrolladores del equipo. Sin Azure Arc, revisar políticas, aplicar auditorías o simplemente saber qué versión exacta está instalada en cada nodo puede convertirse en una gymkhana de RDPs.

Con Azure Arc, podemos tener una visión centralizada de todas las instancias, aplicar políticas uniformes, activar auditorías y obtener insights de seguridad con Defender sin tener que desplegar scripts o agentes por separado. Además, podemos detectar desviaciones de configuración o uso de features que podrían tener impacto en licencias.

Pero no todo es oro. Azure Arc no es una herramienta de administración del motor de SQL. No vas a hacer restores desde el portal ni crear índices con drag & drop. Tampoco es un sustituto de tus herramientas de backup, ni tiene visibilidad real sobre el rendimiento más allá de lo que Azure Monitor pueda recoger (que no es poco, pero tampoco es SentryOne).

Y lo más importante: si no tienes una estrategia clara de seguridad, gestión de red y control de agentes, puedes acabar con más puntos de fallo que beneficios. Porque, no nos olvidemos, instalar agentes y abrir tráfico a Internet en servidores productivos sin pensar en segmentación ni proxies es una receta para el desastre.

El control de licencias en Azure ARC: la parte que nadie quiere mirar

Una de las funcionalidades más interesantes (y más ignoradas) de Azure Arc para SQL Server es el control de licencias. Cuando registramos una instancia, podemos indicar si está licenciada por núcleo o por servidor + CAL. Esto, combinado con el escaneo de features activas, nos permite detectar incoherencias: como esa instancia Standard Edition que «accidentalmente» tiene particionamiento activo (Si, cuando el particionamiento era exclusivo de Enterprise en SQL 2012 esto se podía conseguir). Este control es especialmente útil en entornos con auditorías frecuentes o donde se aplican acuerdos Enterprise Agreement.

¿Y la seguridad? ¿Me estoy exponiendo a algo?

Buena pregunta. Azure Arc requiere ciertos permisos en el servidor, y abre un canal de comunicación constante con Azure. Esto plantea varias consideraciones. Primero, necesitas validar que el tráfico esté cifrado, que el agente esté actualizado, y que el acceso al servidor esté controlado. Segundo, si vas a permitir que ciertas acciones se realicen desde el portal (como cambiar configuraciones o aplicar actualizaciones), más vale que tengas RBAC bien definido en Azure.

La buena noticia es que puedes integrar todo con Azure Policy, Defender, y Log Analytics. La mala es que si no lo haces bien, estarás delegando más poder del que quieres. Y ya sabemos cómo acaba eso.
Azure Arc es gratis… hasta que abres Log Analytics

Una de las verdades menos comentadas de Azure Arc es que registrar tu instancia de SQL Server no cuesta nada. Literalmente: añadir un servidor, instalar el agente de Connected Machine y habilitar la extensión de SQL puede hacerse sin pasar por caja. Microsoft lo promueve como “coste cero” porque, en efecto, el recurso en sí no genera facturación directa.

Pero, siempre hay un pero, en cuanto queremos algo más que ver el nombre del servidor en el portal, empezamos a tirar de servicios que sí cuestan dinero. El más obvio es Log Analytics, que es el backend de todo lo que huela a monitorización seria en Azure. Activar monitorización de rendimiento, auditoría, logs extendidos, o integrar con Defender for SQL pasa irremediablemente por conectar a Log Analytics.

Y aquí viene el truco de magia inverso: el volumen de datos ingeridos, el tipo de consultas (KQL, por supuesto), y el tiempo de retención, todo suma en la factura. No es que Log Analytics sea especialmente caro, pero si estás monitorizando muchas instancias, con métricas detalladas y sin control de retención, la broma puede escalar.

Para tenerlo claro, Azure Arc proporciona el marco, pero no la observabilidad avanzada. Esa vive en Log Analytics, que sí factura. Y lo hace por cada giga ingerido. Si además activas Defender, tienes otro coste adicional por nodo protegido.

¿Merece la pena? 

Esta es la pregunta clave que debes hacerte, si tu entorno tiene requisitos serios de auditoría, cumplimiento, o simplemente quieres centralizar trazabilidad sin herramientas externas, probablemente sí. Pero conviene dimensionarlo bien, ajustar las retenciones, y entender qué datos necesitas realmente antes de abrir el grifo

Este modelo freemium no es nuevo, pero conviene recordarlo: Azure Arc para SQL Server es gratis solo si lo usas como un cartel informativo. Si quieres que hable, escuches y analices, tendrás que pasar por caja.

Conclusión

Azure Arc para SQL Server on-premises es una de esas herramientas que, bien usada, puede marcar una diferencia seria en entornos complejos. Centralizar visibilidad, aplicar políticas, y tener un inventario completo con insights de seguridad no es poca cosa. Pero, como siempre, depende de cómo se implemente.

Si ya tienes una infraestructura ordenada, con buenas prácticas de seguridad, y buscas unificar la gestión sin perder el control, Arc es una opción potente. Si tu entorno es un castillo de naipes sostenido por scripts heredados y manuales en PDF de 2009, lo mejor es empezar por ahí antes de añadir más complejidad.

Porque sí, el futuro puede ser híbrido. Pero nosotros queremos que lo sea con cabeza, no con más capas de problemas. Azure Arc no es magia, pero tampoco es humo. Y eso, hoy en día, ya es mucho decir.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

¿Qué es CLR y por qué deberías limitar su uso?

Hay tecnologías en SQL Server que parecen diseñadas por y para gente que odia SQL. Una de ellas es CLR (Common Language Runtime). Si alguna vez has pensado “¿y si meto C# dentro de una base de datos?”, enhorabuena: acabas de invocar al diablo del rendimiento. Pero, como todo en este mundo, si se usa con criterio y sentido común (sí, eso que tan poca gente aplica), puede aportar soluciones que de otro modo serían infernales de implementar en T-SQL.

¿Qué demonios es CLR y por qué está dentro de SQL Server?

CLR es un motor de ejecución de .NET. Desde SQL Server 2005 tenemos la opción de crear procedimientos almacenados, funciones, triggers y tipos definidos por el usuario usando lenguajes .NET como C# o VB.NET. Esto permite extender la funcionalidad de T-SQL cuando éste se queda corto. Y sí, hay que reconocerlo, T-SQL se queda corto en ciertas áreas, como el procesamiento intensivo de texto, operaciones matemáticas complejas o manipulación avanzada de estructuras de datos.

Ahora bien, que algo se pueda hacer no significa que deba hacerse. De hecho, habilitar CLR en una instancia es como abrir una puerta lateral en un castillo: puede estar bien si sabes quién entra y sale, pero si la dejas abierta, prepárate para las sorpresas.

Activar CLR: el primer pecado

Por defecto, CLR viene deshabilitado. Hay que habilitarlo explícitamente:

Hasta aquí todo bien. Pero luego llega la decisión importante: ¿qué nivel de seguridad vamos a aplicar? Aquí es donde muchos pecan por ignorancia o por prisa. SQL Server permite establecer niveles de seguridad en los ensamblados: SAFE, EXTERNAL_ACCESS y UNSAFE.

  • SAFE es la opción por defecto y la más limitada. Permite usar solo código seguro dentro del sandbox de SQL Server. Vamos, que no puedes acceder al sistema de archivos ni hacer llamadas a red.
  • EXTERNAL_ACCESS permite acceso al sistema, como archivos o recursos de red. Requiere permisos adicionales en la base de datos y en el servidor.
  • UNSAFE es exactamente lo que parece: la carta blanca para que alguien con tiempo libre y ganas de destruir te monte un agujero de seguridad monumental. Desde abrir un puerto TCP hasta modificar binarios en disco. Y si el servidor ejecuta SQL Server con permisos de sistema, el daño potencial es ilimitado.

El resumen es simple: si usas EXTERNAL_ACCESS o UNSAFE y no sabes exactamente lo que estás haciendo, ya puedes ir llamando al responsable de seguridad para una charla “interesante”.

¿Y por qué usar CLR? ¿Realmente aporta algo?

En ocasiones, sí. Hay escenarios donde CLR no solo tiene sentido, sino que puede ser la solución óptima. Por ejemplo:

  • Procesamiento de texto complejo: Las expresiones regulares en T-SQL son una promesa aún. Mientras que estamos empezando a verlas en las previews de Azure SQL y SQL Server 2025, en C# puedes usarlas sin volverte loco. Una función CLR que use Regex.Match puede reemplazar cientos de líneas de T-SQL feo y lento.
  • Cálculos matemáticos avanzados: ¿Has intentado hacer operaciones trigonométricas complejas o cálculos estadísticos avanzados con T-SQL? No, ¿verdad? Pues eso. CLR te permite usar librerías de .NET que hacen esto sin romperte la cabeza. Aunque, pensándolo bien, ¿no preferirías usar python o R para estas cosas?
  • Manejo de estructuras como arrays o diccionarios: Aunque con SQL Server 2022 y sus mejoras en JSON y XML estas necesidades han bajado, aún hay casos donde un buen Dictionary<string, List<int>> en C# resuelve en milisegundos lo que en T-SQL requeriría un máster.
  • Performance en funciones escalares: Una función escalar en T-SQL puede ser un veneno para el rendimiento si se ejecuta por cada fila de una tabla grande. En CLR, ese impacto puede reducirse significativamente.

Eso sí, si el único motivo para usar CLR es que “yo sé C# y no me gusta T-SQL”, lo que necesitas no es un CLR, es un cambio de trabajo.

Cómo crear un ensamblado CLR sin invocar a Satán

Veamos el proceso básico:

Primero escribes el código en C# (en Visual Studio o lo que uses). Luego compilas el ensamblado (DLL) y lo subes a SQL Server con CREATE ASSEMBLY. Por último creas la función o procedimiento que lo expone. Un ejemplo sencillo:

Código C#:

Compilas esto como DLL y lo subes:

Y voilà. Ya puedes usar dbo.ReverseString(‘hola’).

¿Dónde rompe CLR las cosas y por qué?

Ahora hablemos de los pecados originales del CLR. El primero es la dificultad de mantenimiento. El código está fuera del ámbito natural del DBA. Si mañana hay que parchear un bug en ese ensamblado, necesitas recompilar, volver a subirlo y cruzar los dedos para que no tengas dependencias rotas. Además, muchas veces ni siquiera se versionan correctamente. Y sí, lo hemos visto en producción. Más veces de las que nos gustaría.

Segundo, el tema de la seguridad. Un ensamblado con UNSAFE puede hacer cualquier cosa en el sistema operativo. Y cuando decimos cualquier cosa, es cualquier cosa. ¿Quieres que tu base de datos escanee el disco C:? Puedes hacerlo. ¿Deberías hacerlo? No. Nunca.

Tercero, el rendimiento. Aunque en algunos escenarios el CLR escala mejor que T-SQL (especialmente en funciones escalares y algoritmos complejos), introducir CLR sin medir su impacto real es como poner un turbo a un coche sin frenos. Necesitas pruebas serias, monitorización con Extended Events o Profiler, y entender bien los contextos de ejecución y memoria.

CLR y los entornos modernos

¿Sigue teniendo sentido usar CLR en 2025? Depende. SQL Server ha mejorado mucho en áreas como funciones en línea, JSON, XML, y hasta integración con Python y R vía Machine Learning Services. Muchas cosas que antes requerían CLR ahora se pueden hacer dentro del propio SQL Server sin salir del ecosistema T-SQL.

Pero aún hay casos de uso válidos: si necesitas lógica reutilizable, validaciones complejas, o consumir recursos externos con control, puede ser una herramienta útil. Eso sí, no abuses. Lo que empieza como una solución elegante puede acabar como un infierno de dependencias, DLLs perdidas y bugs imposibles de depurar.

Conclusión

El CLR no es el enemigo. El enemigo es usar herramientas que no entendemos solo porque «molan» o porque «así lo hacemos en .NET». SQL Server permite muchas cosas, pero no todas son recomendables. Si vas a meter CLR en tu arquitectura, hazlo con cabeza, documentación, versiones bien gestionadas y, por supuesto, tests.

Y si estás usando funciones CLR porque no sabías cómo hacerlo en T-SQL… mejor sigue leyendo el blog. Tenemos artículos sobre expresiones regulares y otras maravillas menos propensas a prenderle fuego a tu entorno productivo.

Porque sí, puedes meter C# en SQL Server, y también puedes meter un gato en una lavadora. Pero no deberías.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

LINQ y SQL Server: consulta tú, que ya lloro yo

Si eres developer y trabajas con .NET, lo más probable es que en algún momento hayas caído rendido ante LINQ. Lo entiendo, es tentador cual canto de sirena. Tiene lo suyo: expresividad, fluidez, integración total con C#… es cómodo. Pero si trabajas con SQL Server como motor de datos, más te vale saber qué está haciendo LINQ por detrás. Porque aquí, en las profundidades del motor, no nos tragamos la excusa de «yo sólo puse un .Where()».

Este artículo no es para demonizar LINQ. Es para que entiendas, desde el punto de vista del DBA que va a recibir tus consultas, por qué usar LINQ sin saber cómo funciona es como lanzar T-SQL con los ojos cerrados y esperar que salga rápido. Alerta spoiler: no lo hace.

LINQ: el ORM moderno que no siempre sabe lo que hace

A ti LINQ te permite escribir consultas con tipos, IntelliSense, lambdas y toda la fantasía moderna del desarrollo elegante. A nosotros nos llega una consulta SQL que ha generado un ORM sin ningún sentido del rendimiento, de los índices ni del plan de ejecución.

Tú ves:

Nosotros vemos: joins sin sentido, LEFT OUTER JOIN innecesarios, condiciones que no usan índices, y a veces hasta SELECT TOP 1000000 porque alguien no quería paginar como es debido. Lo que para ti es una consulta sencilla, para nosotros puede ser una fiesta de bloqueos, CPU y discos saturados.

LINQ no es malo. Pero no sabe optimizar. Y su traductor a SQL (ya sea EF, LINQ to SQL o el flavor de turno) sólo tiene una misión: funcionar. No rendir. Eso, amigos, es responsabilidad vuestra.

SQL Server no es una caja negra

Si has trabajado toda tu vida con Entity Framework sin mirar lo que genera por debajo, te estás perdiendo la mitad de la película. Y no la buena. SQL Server es un motor potente, flexible y bastante generoso… pero sólo cuando le das instrucciones claras.

Cuando llega una consulta LINQ traducida automáticamente, SQL Server hace lo que puede. Pero si la estructura de la consulta es compleja, el uso de joins es arbitrario y los filtros se aplican después del .ToList(), entonces no hay milagros. Hay “table scans”, “sort warnings”, “hash matches” no deseados y todo lo que un DBA no quiere ver en el plan de ejecución.

Lo que tú ves como un .Include() para cargar relaciones, nosotros lo vemos como una máquina de hacer JOINs sin control. Y cuando eso se hace en producción con datos reales, hay que estar muy seguro de que se entiende lo que se está mandando.

IEnumerable, IQueryable y el horror que no ves en LINQ

Hay un detalle que seguimos viendo incluso en equipos senior: no distinguir IEnumerable de IQueryable a la hora de consultar.

Cuando usas IQueryable, la consulta se traduce a SQL y se ejecuta en la base de datos. Bien. Pero cuando haces .ToList() antes de aplicar más filtros, estás trayendo todo a memoria y filtrando en .NET. Eso está bien si tienes diez registros. Si tienes diez millones, acabas de llenar el servidor de aplicaciones con datos que no necesitabas.

El ORM no sabe optimizar. Tú sí deberías.

Así que cuando alguien hace esto:

Y luego se pregunta por qué la aplicación va lenta, la respuesta es clara: no es la base de datos, es tu código. LINQ puede ser declarativo, pero no mágico.

Los casos en que LINQ hace llorar al optimizador

¿Sabes lo que pasa cuando encadenas tres .Include()s, haces un .SelectMany() y luego aplicas una condición que sólo puede evaluarse en cliente? Que el SQL resultante se convierte en un engendro. Y a nosotros nos llega una consulta de 150 líneas con subconsultas, columnas que no se usan y JOINs en cascada que anulan los índices.

Esto no es una exageración. Lo he visto con mis propios ojos. Y no una vez. Las herramientas modernas de desarrollo facilitan mucho la creación de consultas… que nadie ha revisado. Y luego cuando llegan las quejas de rendimiento, el culpable nunca es el ORM. Siempre es “la base de datos que no escala”.

No. La base de datos escala. Lo que no escala es traducir expresiones lambda como si fueran instrucciones optimizadas para un motor relacional.

Cómo hacer las paces: consejos para developers (sí, es por vuestro bien)

Lo primero: aprende a ver el SQL que estás generando. EF Core permite interceptar y registrar el SQL generado. Úsalo. Lee ese SQL. Míralo con ojos críticos. Si ves que tiene 10 joins, 30 columnas innecesarias y ninguna cláusula WHERE, no lo envíes a producción. Mándalo al infierno de staging, a ver cuánto tarda.

Segundo: si una consulta es crítica, escribe SQL tú mismo. Usa FromSqlRaw() o, mejor aún,  procedimientos almacenados dentro de SQL Server. No pasa nada. No es “menos elegante”, es más responsable.

Tercero: si tienes dudas, habla con el DBA. No somos ogros. Bueno, algunos sí. Pero en general, preferimos una conversación a tener que cazar queries con el SQL Profiler porque ha saltado una incidencia de rendimiento a las 3 de la mañana.

Cuarto: entiende el modelo de ejecución diferida de LINQ. Y si tienes que filtrar, hazlo antes del .ToList(). Siempre.

Y por último: no abuses del azúcar sintáctico. LINQ puede ser cómodo, pero no sustituye al conocimiento. No saber lo que está pasando en SQL Server es como conducir un coche sin saber si vas en primera o en tercera.

¿Cuándo sí usar LINQ?

LINQ brilla en consultas simples. En operaciones sobre colecciones en memoria. En proyecciones pequeñas y bien definidas. Si tu consulta es trivial y los datos están bien indexados, no hay problema. Pero si estás construyendo un informe complejo, una API con cientos de miles de registros o una consulta crítica para el negocio, deja de lado la comodidad.

Y si usas LINQPad, mejor. Ahí sí puedes ver lo que pasa y ajustar con cabeza. Porque en el fondo, LINQ no es el problema. El problema es no saber cuándo dejar de usarlo.

Conclusión: hay vida más allá de LINQ

No hay escapatoria. Si trabajas en un proyecto con SQL Server, y usas un ORM o LINQ, el rendimiento de tus consultas depende de ti. No vale decir “eso es cosa del DBA” o “es que eso lo hace el ORM solo”. Porque cuando la aplicación se arrastra, da igual de quién sea la culpa: hay que arreglarlo y ni todo el hardware del mundo arregla depende que consultas.

Así que la próxima vez que escribas una consulta LINQ, pregúntate: ¿qué SQL va a salir de aquí? ¿Lo he mirado? ¿Lo he probado con datos reales? ¿Estoy filtrando bien? ¿Estoy trayendo sólo lo que necesito?

Y si no puedes responder a eso con seguridad, tal vez lo mejor sea bajarse al T-SQL y escribir como los mayores.

Porque aquí no se trata de gustos. Se trata de no matar al servidor con buenas intenciones y malas queries.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 0 comentarios

ZSTD en SQL Server 2025: la compresión que por fin tiene sentido

Con SQL Server 2025, Microsoft ha decidido que ya era hora de dejar atrás el vetusto algoritmo MS_XPRESS para la compresión de backups y nos presenta a su nuevo juguete: Zstandard, o ZSTD para los amigos. No se trata de una mejora menor ni de un simple lavado de cara. Estamos ante un cambio real, tangible y, lo más importante, medible. Porque ya está bien de hacer backups comprimidos que no se sabe si salvan espacio o lo rellenan de aire.

En este artículo nos meteremos de lleno en las pruebas reales de rendimiento y compresión usando este nuevo algoritmo en la versión preliminar de SQL Server 2025 (17.x). Y sí, he hecho los deberes: mismo entorno, misma base de datos, mismas condiciones. Porque si vamos a hablar de rendimiento, hay que hacerlo como profesionales, no como vendedores de humo.

Un poco de contexto en esto de la compresión (pero solo el justo)

Hasta ahora, la compresión de backups en SQL Server se basaba principalmente en MS_XPRESS, ese algoritmo que venía con SQL Server y que, siendo honestos, cumplía. Pero cumplía como un coche de hace 20 años: te lleva, pero consume más de lo que debería y no gana ninguna carrera.

SQL Server 2025 introduce ZSTD como nuevo algoritmo de compresión, y según la propia documentación oficial, se trata de un método más rápido y más eficaz. No es marketing barato: ZSTD lleva años siendo la niña bonita del mundo open source, utilizado en proyectos como Facebook, zfs o Kubernetes. Y ahora por fin aterriza en SQL Server.

Escenario de pruebas: sin cuentos

He estado leyendo e intercambiando opiniones con otros compañeros MVPs de Microsoft y algunas pruebas les arrojaban reducciones de tiempo de hasta un 50%. Yo tenía que probarlo, y además he utilizado la base de datos StackOverflow2013 para las pruebas. Una base de datos con más de seis millones de páginas de datos (más de 50Gb) suficiente para ver diferencias significativas. Además con campos de texto grandes y pocos valores nulos o repetidos, cosas que siempre han puesto en aprietos a la compresión de SQL Server. Todo un reto para el nuevo algoritmo.

Todas las pruebas las he ejecutado en la misma instancia de SQL Server 2025 CTP 2.0, con la base de datos restaurada entre cada backup para mantener la consistencia. Ni trucos, ni trampa, ni memoria caché jugando sucio.

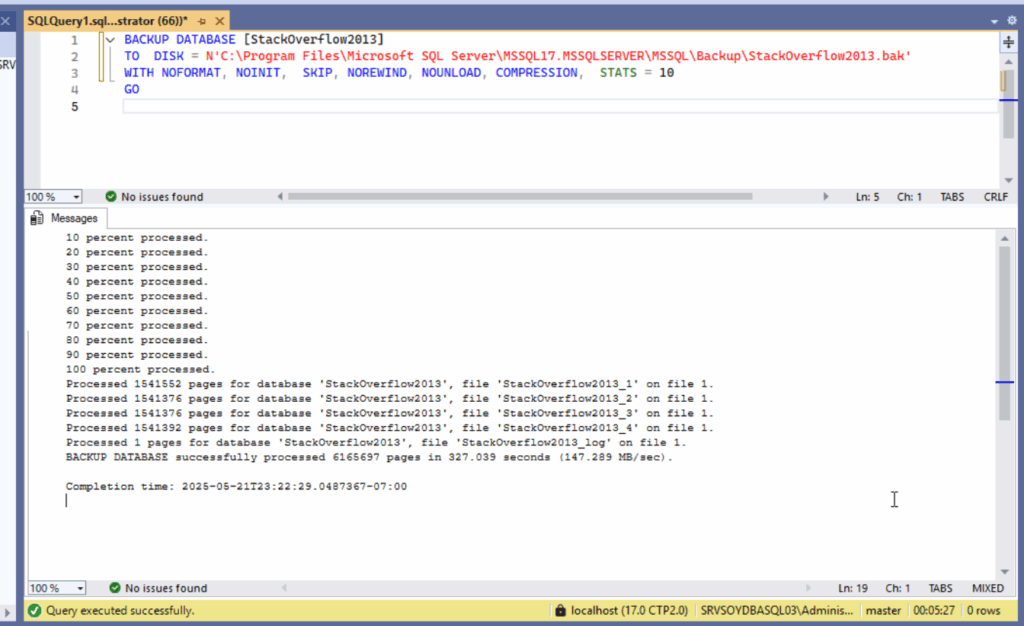
Backup tradicional con compresión MS_XPRESS

Para esta primera prueba vamos a realizar un backup con la comprensión tradicional de SQL Server para saber contra qué estamos comparándonos.

Resultados:

  • Tiempo total: 327 segundos
  • Velocidad media: 147.289 MB/seg
  • Tamaño comprimido: 14.84 GB

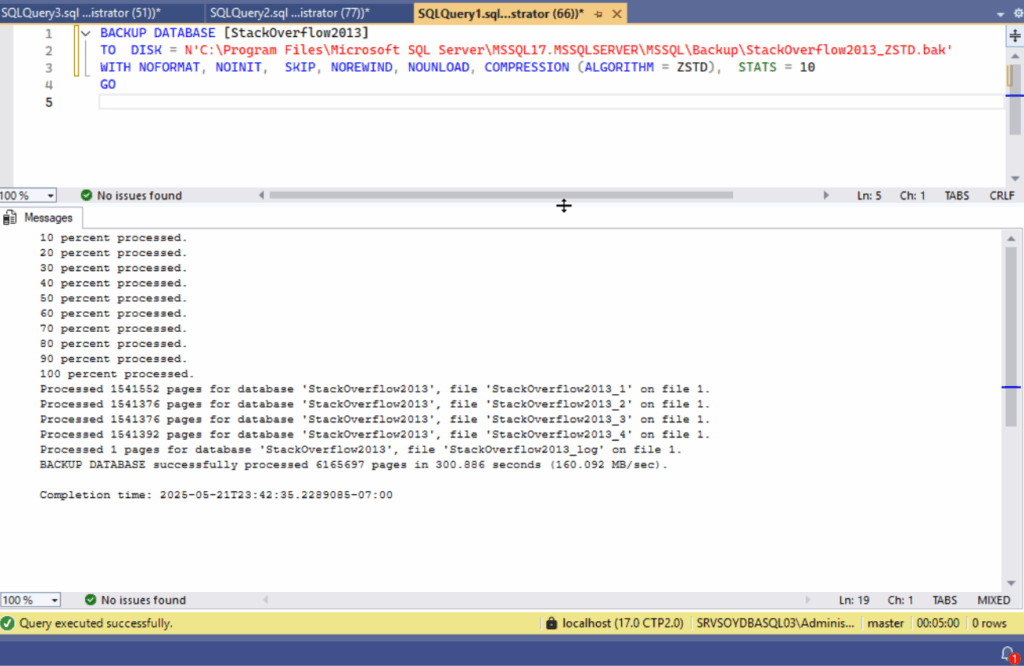
Backup nuevo con compresión ZSTD

Llega el momento de la verdad, ahora que ya tenemos una base sobre la que mejorar vamos a probar con el nuevo algoritmo de compresión de backups ZSTD.

Resultados:

  • Tiempo total: 300 segundos
  • Velocidad media: 160.092 MB/seg
  • Tamaño comprimido: 14.51 GB

Sí, has leído bien: más rápido y más comprimido. Porque para eso se inventan los algoritmos modernos, no para rellenar documentación técnica.

¿Y el espacio en disco? ¿Realmente hay más compresión?

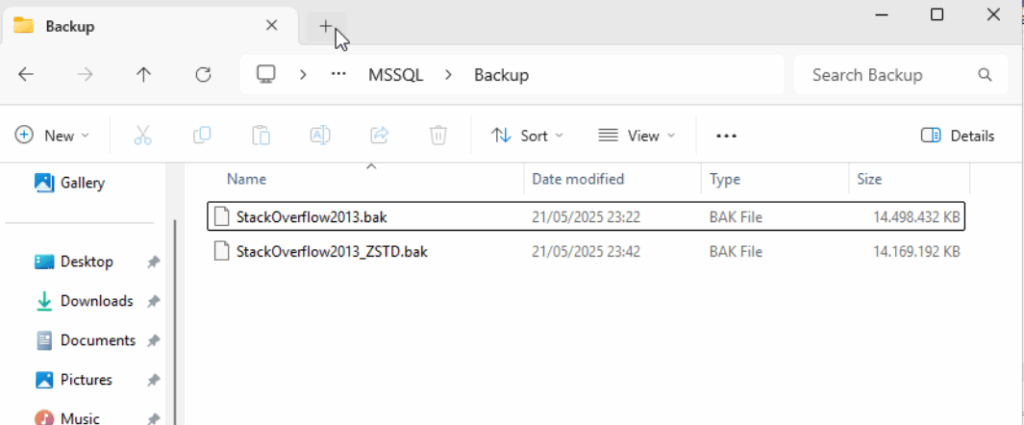
Aquí no hay opiniones: hay archivos .bak. Si miramos los tamaños de las copias que acabamos de hacer estos son los datos:

  • MS_XPRESS: 14.498.432 KB
  • ZSTD: 14.169.192 KB

En torno a 329 MB menos por backup. Insisto: suma eso en entornos de alta frecuencia y multiinstancia, y deja que el almacenamiento te dé las gracias.

Restauraciones

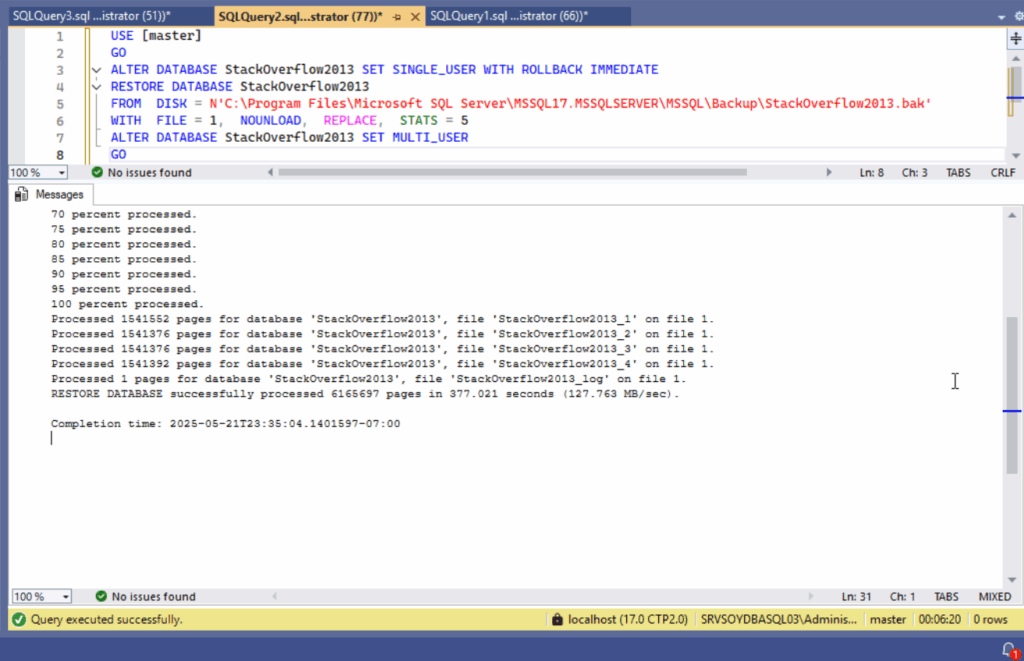
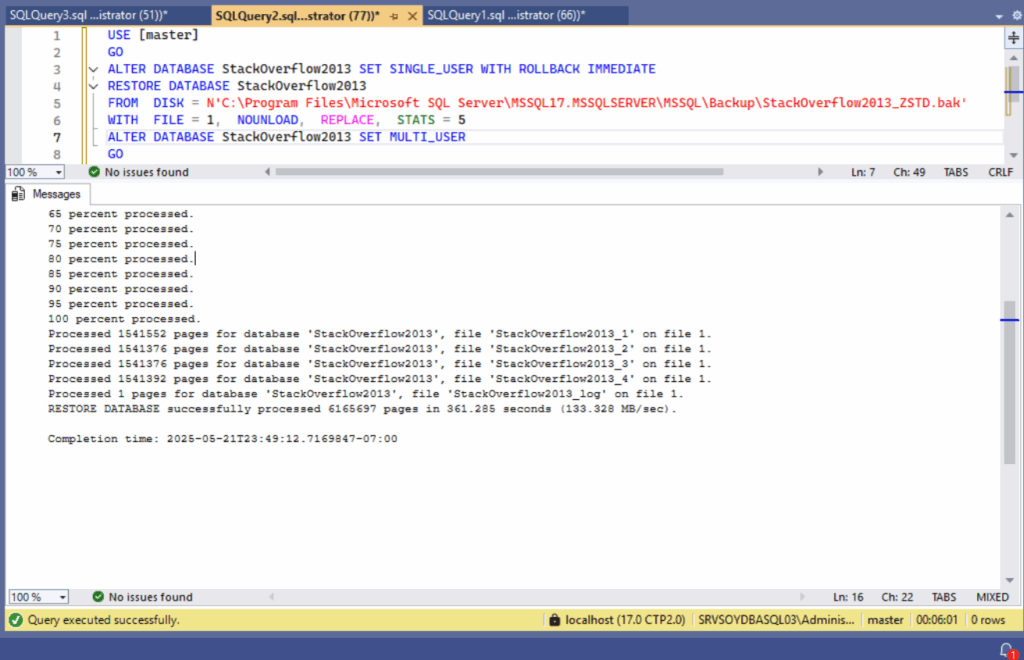
También he restaurado ambas copias para verificar si hay diferencias apreciables en el proceso inverso. Al fin y al cabo, para eso hacemos backups. Y normalmente, cuando restauramos una copia de seguridad lo hacemos con prisa, no me preguntes por qué.

En este sentido, la copia con el algoritmo de compresión tradicional MS_XPRESS ha tardado 377 segundos, restaurando a 127.763 MB/seg. Por su parte, la copia con el nuevo algoritmo ZSTD se ha restaurado en 361 segundos a una media de 133.328 MB/seg. 

Una diferencia de rendimiento modesta, pero constante, a favor de ZSTD. No rompe récords, pero definitivamente no es humo. 

Relación de compresión

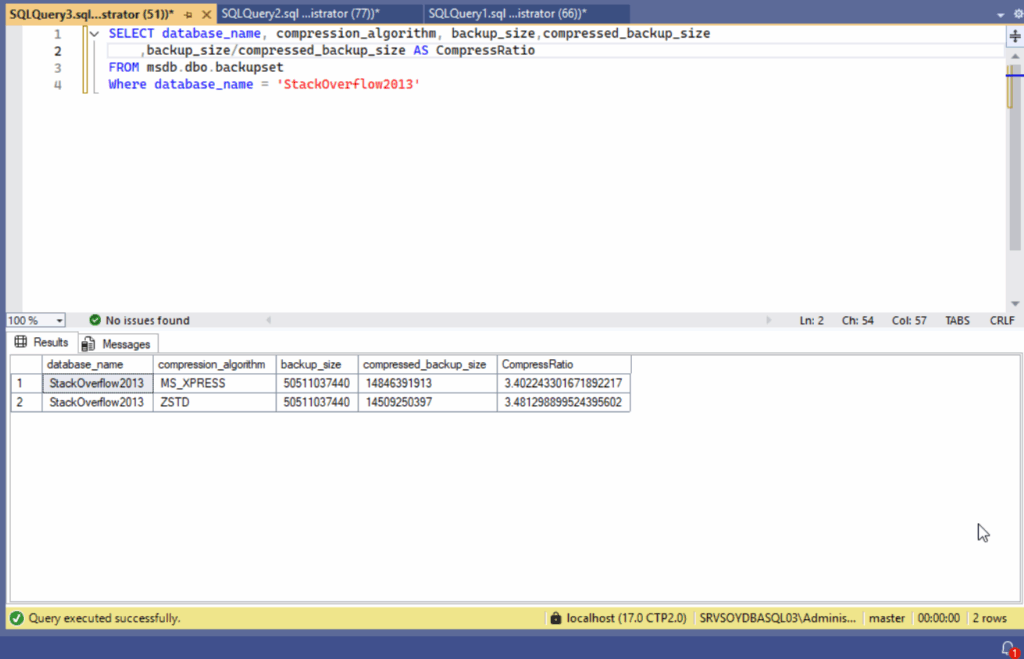
Veamos por último la relación de compresión de nuestras copias. Esto podemos verlo directamente de msdb.dbo.backupset con una sencilla consulta.

Tampoco estamos ante un milagro, pero la mejora es real. Y si alguien piensa que medio punto en ratio de compresión no importa, que multiplique eso por 500 bases de datos diarias y hablamos. Además, recuerda, el ejemplo que he usado es de los menos favorables para una compresión.

Cómo habilitar la compresión ZSTD (cuando funcione bien)

ZSTD se puede usar de dos formas, la forma explícita que acabamos de ver, indicando el algoritmo en el comando BACKUP WITH COMPRESSION (ALGORITHM = ZSTD) o bien configurando el servidor para usarlo como valor predeterminado. Para eso lo definiremos en la configuración con este comando:

Ahora bien, aquí viene la parte divertida (léase con sarcasmo): actualmente hay un bug conocido en la configuración global. Es decir, puedes especificarlo manualmente sin problema, pero si intentas poner ZSTD como predeterminado a través del sp_configure, el sistema puede ignorar olímpicamente. No lo decimos nosotros, lo dice la propia documentación oficial de Microsoft en letras púrpuras. Nada grave sabiendo que aun es una versión preliminar.

Así que por ahora, mejor dejar ese WITH COMPRESSION (ALGORITHM = ZSTD) bien escrito en los scripts de mantenimiento y olvidarse de configuraciones globales hasta que alguien en Redmond se acuerde de arreglarlo antes de la disponibilidad general del producto.

Conclusión

ZSTD ha llegado a SQL Server y no como un simple añadido, sino como una alternativa seria al clásico MS_XPRESS. Mejora el rendimiento, reduce el tamaño y lo hace sin pedir permiso ni romper nada. ¿Es perfecto? No. ¿Está listo para producción? Aún no, está en preview. ¿Vale la pena probarlo? Sin duda.

En mis pruebas ha demostrado ser más eficiente, más rápido y ligeramente más eficaz en términos de compresión. Y si Microsoft arregla ese problemilla con la configuración global, puede convertirse en el nuevo estándar para backup en SQL Server.

Así que, si estás probando SQL Server 2025, ya estás tardando en incluir ZSTD en tus scripts. Y si aún sigues con backups sin compresión porque “es más seguro así”, quizás también sigas usando cintas magnéticas. En fin.

Yo por mi parte, ya lo tengo apuntado en el check de “cosas que sí merecen la pena en esta versión”. Habrá que ver si termina estando disponible en SQL Server Standard o solo en las versiones Enterprise.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en SQL Server, 0 comentarios

Antivirus en servidores SQL Server: ni sin él, ni contra él

Cuando hablamos de proteger un entorno SQL Server, lo primero que nos viene a la cabeza suelen ser los backups, la alta disponibilidad, los roles de seguridad, incluso el cifrado. Pero curiosamente, uno de los elementos más básicos de la protección –el antivirus– sigue siendo tratado como un accesorio molesto, o lo que es peor, como una amenaza potencial para el rendimiento. Y claro, en ese dilema entre seguridad y rendimiento, muchas veces se acaba apostando por el camino más cómodo: desactivar o ignorar.
No vamos a defender aquí que el antivirus es la piedra angular de la seguridad (no lo es), pero tampoco podemos dejar que el miedo a una caída de rendimiento justifique decisiones negligentes. Lo que necesitamos es un enfoque racional: configurar el antivirus de forma que proteja sin interferir con la operación normal del motor de base de datos. *Spoiler*: se puede. Lo difícil es que alguien lo haga bien.

¿Qué hace el antivirus y por qué molesta (si lo dejamos)?

El trabajo del antivirus es inspeccionar archivos y procesos en busca de patrones maliciosos. Nada nuevo. Lo que sí suele pasarse por alto es *cómo* lo hace: analiza archivos al abrirse, al modificarse, y en ocasiones al cerrarse. También puede inspeccionar procesos en memoria, acceder a redes compartidas, lanzar escaneos programados… y todo eso suena bastante normal hasta que lo dejas funcionando en un servidor SQL Server con una carga seria.
Porque claro, cuando el antivirus decide inspeccionar `tempdb.mdf` mientras el motor está haciendo un `HASH JOIN` como si no hubiera un mañana, empieza la fiesta: bloqueos, ralentizaciones, timeouts y, si tenemos suerte, algún bonito `IO_COMPLETION` en el error log. Y no olvidemos el momento en que el antivirus escanea los archivos `.ldf` en pleno `checkpoint`. Porque sí, todo archivo es sospechoso, incluso los que cambian cien veces por segundo.
El problema no es el antivirus. El problema es no configurarlo.

Archivos y procesos que debemos excluir

Vamos al grano. Hay una serie de rutas, extensiones y procesos que deben quedar fuera del radar del antivirus si queremos mantener la estabilidad y el rendimiento del servidor SQL Server. No es opcional. No es debatible. Está documentado por Microsoft, y si no lo aplicas, estás jugando a la ruleta rusa con discos girando.
Empezamos por los archivos:
– Las bases de datos, claro: archivos `.mdf`, `.ndf` y `.ldf`. Eso incluye todas las rutas donde se ubiquen, incluyendo `tempdb`. Da igual si están en discos SSD, en cabinas SAN o en la nube: fuera del antivirus.
– Los archivos de backup: `.bak`, `.trn`, `.sqb`, `.dif`, etc. Si el antivirus decide escanear un `.bak` de 500 GB en pleno restore, luego no nos preguntemos por qué tarda 2 horas más de lo previsto.
– Los archivos de trace, log y dumps generados por SQL Server (`.xel`, `.trc`, `.dmp`). Algunos de ellos se escriben en caliente, y otros pueden ser enormes.
– Las rutas de instalación de SQL Server y sus binarios (`sqlservr.exe`, `sqlagent.exe`, etc.). Los procesos de SQL no deberían ser intervenidos por el antivirus, especialmente durante eventos como reinicios o cambios de configuración.
También conviene excluir herramientas relacionadas que trabajen cerca del metal, como agentes de backup de terceros (Veeam, Commvault, etc.), soluciones de monitorización, y carpetas temporales utilizadas en procesos ETL, especialmente si están en el mismo servidor.
Y por supuesto: nada de escaneos programados sobre las unidades donde residen estos archivos. ¿Queremos una caída de rendimiento nocturna «espontánea»? Pues eso.

El antivirus SI tiene cabida en un servidor SQL

Llegados a este punto, alguien siempre pregunta: «¿Y si directamente no pongo antivirus?». Bueno, también puedes dejar la puerta del CPD abierta por si alguien quiere entrar a ver qué hay. Todo es cuestión de prioridades.
Un servidor SQL Server, aunque no navegue por Internet, puede estar expuesto a amenazas reales. Las vías de entrada son múltiples: conexiones RDP inseguras, accesos compartidos, usuarios que suben archivos, integraciones con sistemas vulnerables, incluso malwares que viajan dentro de backups. Y no olvidemos el ransomware, que no necesita un navegador para hacer su trabajo. Lo único que necesita es una puerta entreabierta.
Así que sí, el antivirus es necesario. Pero como con cualquier otra herramienta, hay que usarla con cabeza.

Buenas prácticas de configuración del antivirus

Ya sabemos qué excluir, pero ¿qué más podemos hacer para convivir con el antivirus sin odiarlo?
Lo primero, usar soluciones corporativas que permitan configurar políticas centralizadas. Nada de versiones domésticas ni «freemium» que prometen IA mágica y acaban con el 30% de tu CPU. Necesitamos un antivirus que permita gestionar exclusiones, programar escaneos fuera del horario de carga, y monitorizar actividad sin interferir con los procesos críticos.
Lo segundo, documentar las exclusiones. Es increíble la cantidad de veces que se instala un nuevo motor, se configura bien, y meses después alguien cambia el antivirus o actualiza políticas sin revisar nada. Resultado, el rendimiento se degrada, y nadie sabe por qué. Tener un documento claro con las rutas y configuraciones esenciales debería ser parte del estándar de despliegue.
Tercero, coordinar con el equipo de seguridad. Sí, esos que mandan correos con gráficos de amenazas que nadie entiende. Hablad con ellos. Enseñadles los KB de Microsoft. Explicad por qué hay que excluir ciertos archivos. Si lo hacéis bien, es posible que incluso lo agradezcan. Al final, todos queremos lo mismo, que el sistema esté seguro y funcione bien.
Y por último, revisar con cada parche o actualización. Las rutas cambian, las versiones cambian, y lo que funcionaba en SQL Server 2016 puede no ser igual en 2022. La tecnología cambia más deprisa que las excusas para no leer la documentación.

Recursos recomendados (y válidos)

Si alguien necesitas pruebas documentales para convencer al comité de seguridad, que tire de lo oficial. Microsoft tiene un artículo actualizado con las exclusiones recomendadas para SQL Server que puedes encontrar aquí.
También hay buenas prácticas en la documentación de cada solución antivirus empresarial. Lo importante es no quedarse en lo básico: si hay un `.exe` que escanea un `.mdf`, eso es un problema.

Conclusión

El antivirus en un servidor SQL Server no es el enemigo. El enemigo es la ignorancia operativa. Dejar un antivirus sin configurar es tan irresponsable como dejar que todo el mundo sea `sysadmin`. Y no, no exageramos.
Podemos tener rendimiento y seguridad. Pero como casi todo en esta vida (excepto los planes de licenciamiento de Microsoft), requiere esfuerzo. Excluir bien, revisar políticas, hablar entre equipos y no asumir que las cosas «ya vienen bien puestas».
Si seguimos confiando en que el antivirus «sabrá lo que hace», luego no nos sorprendamos si decide escanear `master.mdf` en mitad de un failover. Porque ya lo hemos dicho antes: el antivirus no es malo. Lo malo es dejarlo pensar por sí mismo.
Y no, no vamos a acabar este artículo diciendo que “la seguridad empieza por uno mismo”. La seguridad empieza por no meter la pata.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 1 comentario

SQL Server 2025: IA dentro del motor, T-SQL como interfaz para modelos, y SSMS 21

Por fin tenemos motivos sólidos para decir que esta versión no es otra iteración sin alma. SQL Server 2025 no se limita a una lista de mejoras de rendimiento, ni a tres nuevos tipos de índice que nadie usará hasta dentro de tres años. Aquí estamos ante un cambio de paradigma: el motor se vuelve semánticamente inteligente, el T-SQL habla con modelos de IA, y SSMS deja de vivir anclado en 2012. Todo esto sin que tengamos que reescribir la mitad de nuestra lógica de negocio. Milagro.

Buscando con IA, sin sacar los datos de la base

Hasta ahora, hacer vector search implicaba montar un servicio aparte, duplicar datos, sincronizar embeddings y cruzar los dedos para que todo estuviera alineado. Bien, pues eso se ha acabado. SQL Server 2025 incorpora búsqueda vectorial directamente en el motor, usando como base el algoritmo DiskANN (Disk Approximate Nearest Neighbor) para encontrar similitudes de forma eficiente.

Y no solo eso: el motor genera embeddings y fragmenta texto (chunking) como parte de T-SQL. Nada de pipelines raros ni servicios auxiliares. El motor habla semánticamente, y por fin podemos dejar de fingir que los LIKE ‘%palabra%’ son soluciones de búsqueda.

Imagina buscar documentos similares, tickets de soporte parecidos o patrones repetidos en logs… sin tener que montar un Frankenstein con Python, Redis y una esperanza. Aquí, directamente desde SQL Server.

T-SQL como orquestador de modelos

Otra joya que han metido: los modelos de IA se definen y consumen desde T-SQL, y se accede a ellos mediante REST. Esto permite conectar con Azure OpenAI, Azure AI Foundry, Ollama, HuggingFace o cualquier servicio que hable HTTP.

Pero la parte realmente interesante es que puedes probar distintos modelos sin cambiar el código T-SQL, simplemente apuntando a otro endpoint. Es decir: pruebas, evalúas, decides… y el código sigue funcionando como si nada. Esto convierte a SQL Server en un auténtico hub de orquestación para IA aplicada a los datos.

Sí, a esto lo han llamado “AI integration”, pero no es humo de marketing: esto es infraestructura real para desarrolladores y DBAs que no tienen tiempo para montar castillos de arena en cada nuevo proyecto.

RAG con sentido: integración nativa con LangChain y Semantic Kernel

Otra novedad clave: SQL Server 2025 incluye soporte nativo para patrones de RAG (Retrieval-Augmented Generation). Lo que antes requería montar conectores desde LangChain, ahora se hace con integración directa. Embeddings, índices vectoriales, chunking… todo desde el motor. LangChain y Semantic Kernel pueden consumir directamente los datos sin malabares.

Esto significa que puedes montar aplicaciones conversacionales, asistentes internos o flujos inteligentes que consulten tus datos empresariales sin tener que exportarlos a ninguna otra base. Tus datos siguen seguros, tu rendimiento también, y tu aplicación parece inteligente.

SSMS 21:  Git, Copilot y 64 bits… y no es broma

SQL Server Management Studio 21 ha salido del túnel del tiempo. Basado en Visual Studio 2022, ahora es una aplicación nativa de 64 bits (ya era hora), con actualizaciones automáticas (gracias, por fin) y soporte directo para Git.

Y lo mejor: Copilot ya está integrado (en preview). Lo puedes instalar como workload adicional, y te ayuda a:

  • Escribir y corregir T-SQL con lenguaje natural.
  • Generar scripts de mantenimiento.
  • Explicar consultas y sugerir optimizaciones.
  • Administrar configuraciones complejas con algo de contexto real.

¿Sustituye a un DBA con criterio? Ni de lejos. Pero es una ayuda decente que, usada con cabeza, puede acelerar muchas tareas del día a día. O al menos, evitar que tengamos que explicar por enésima vez qué hace un LEFT JOIN.

Python, JSON y expresiones regulares: tres cosas que ya no dan vergüenza

Se ha anunciado también un nuevo driver Python open source, desde cero, eficiente, moderno y mantenido por Microsoft. Olvida los hacks sobre ODBC: esto es serio, y se instala con pip install.

Y sí, JSON ahora se soporta de forma nativa en T-SQL. Ya era hora. Por fin podemos trabajar con documentos sin castings ni funciones intermedias. Lo mismo con RegEx: expresiones regulares nativas, sin tener que invocar CLR ni enviar los datos a PowerShell.

Esto desbloquea muchos escenarios de enriquecimiento de datos, validación y transformación dinámica, sin salir del entorno SQL.

Change Event Streaming: eventos sin CDC (ni drama)

Una joya más: Change Event Streaming permite emitir eventos directamente desde el transaction log a Azure Event Hubs, sin usar CDC. Esto no solo reduce la sobrecarga de I/O, sino que habilita arquitecturas reactivas mucho más limpias.

Puedes montar sistemas en tiempo real, agentes inteligentes que reaccionan a eventos de negocio, y todo con trazabilidad real. Y sin romperte la cabeza con triggers que nadie quiere mantener.

Rendimiento, disponibilidad y seguridad: seguimos afinando el motor

SQL Server 2025 incluye más de 50 mejoras en el motor, muchas de ellas en HADR, Columnstore, y procesamiento inteligente. Entre ellas:

  • Optimized Locking con TID Locking y Lock After Qualification, para reducir consumo de memoria y minimizar bloqueos.
  • Query Store disponible en secundarios de solo lectura, algo que llevábamos pidiendo años.
  • Mejoras en Intelligent Query Processing que aportan rendimiento sin tocar el código (veremos si los milagros existen o no).
  • Compatibilidad total con Microsoft Entra ID, para usar identidades gestionadas de forma segura y sin líos.

Y sí, sigue siendo la base de datos más segura según NIST. Ya no hace falta decirlo, pero está bien recordarlo por si alguien pregunta.

Fabric y la analítica sin ETL (casi)

SQL Server 2025 soportará database mirroring en Microsoft Fabric, permitiendo que los datos operacionales estén disponibles para análisis en tiempo casi real sin mover una sola tabla. No es exactamente magia, pero se le parece. Un puente directo entre operaciones y analítica, sin romper nada.

Developer Edition Standard: pruebas con realismo

Una novedad muy práctica: nueva Developer Edition Standard, gratuita pero limitada a las capacidades de la edición Standard. Ideal para probar comportamientos y validar configuraciones sin necesidad de recurrir a hacks ni entornos de “prueba/producción camuflada”.

Conclusión

SQL Server 2025 no es un service pack disfrazado. Es un cambio real, tanto en cómo usamos el motor como en cómo lo extendemos. La IA no es un complemento, es parte del core. Y eso nos obliga a entenderla, usarla y evaluarla con el mismo rigor con el que optimizamos un índice o afinamos una transacción.

Copilot ayuda, pero no sustituye. Las búsquedas vectoriales abren un nuevo paradigma, pero siguen requiriendo estructura y lógica de negocio. Y SSMS 21… bueno, al menos ya no se siente como una aplicación de otra década.

¿Vamos a activar todo esto en producción mañana? No. ¿Vale la pena empezar a probarlo y adaptarse? Sin duda. Y si queréis ver ejemplos reales, scripts de prueba y escenarios que no salen en las demos de marketing, os espero por aquí. Como siempre, alguien tiene que hacer las pruebas que importan.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 
Publicado por Roberto Carrancio en Cloud, SQL Server, 0 comentarios

Versiones de SQL Server en Amazon AWS

Cuando hablamos de SQL Server en AWS, lo primero que debemos hacer es dejar atrás esa idea ingenua de que “en la nube todo es más fácil”. No, no lo es. Solo es diferente, y en muchos casos, más complejo. Porque cuando mezclamos la gestión de SQL Server con la selva de servicios de AWS, las posibilidades se multiplican… junto con los puntos de fallo. Así que vamos a desgranar, con precisión quirúrgica y sin evangelismos nublados por el marketing, qué opciones reales tenemos cuando queremos desplegar SQL Server en Amazon Web Services.

SQL Server en AWS: más allá del “lift and shift”

Hay dos grandes formas de ejecutar SQL Server en AWS: usar máquinas virtuales (EC2) o servicios gestionados (principalmente RDS). Y sí, hay matices, capas y excepciones, pero si no entendemos esta dicotomía básica, mejor volvemos a estudiar para el examen de certificación.

En esencia, EC2 nos da el control total (y la responsabilidad completa). RDS nos quita dolores de cabeza, pero también libertad. ¿Queremos hacer magia negra con xp_cmdshell, afinar a mano el maxdop, o aplicar un Service Pack que aún no ha salido oficialmente? Entonces EC2. ¿Preferimos que AWS se encargue de los backups, los parches y la alta disponibilidad con solo marcar unas casillas? RDS es nuestro nuevo amigo.

Amazon AWS EC2 con SQL Server: libertad para vivir al límite

Al desplegar SQL Server en instancias EC2, estamos hablando de IaaS de libro. Tú eliges el sistema operativo (Windows, claro, porque hablamos de SQL Server), tú instalas SQL Server, tú configuras todo. También tú lo rompes y lo arreglas.

La ventaja evidente es que puedes usar cualquier edición de SQL Server: Express, Web, Standard o Enterprise. Puedes traer tu propia licencia (BYOL, Bring Your Own License) o usar las licencias incluidas en la AMI (Amazon Machine Image) oficial con licencia de pago por uso.

Esta opción brilla en entornos que necesitan configuraciones exóticas o donde el cumplimiento normativo exige control absoluto sobre el sistema. También en arquitecturas donde SQL Server no está solo, sino embebido en un sistema complejo que se despliega como un todo.

¿El coste? Altísimo si no controlamos los recursos. Sí, puedes tener una r6i.16xlarge para presumir, pero luego no te quejes cuando el informe mensual de AWS te haga llorar más que un RAISERROR con severidad 25.

Amazon AWS RDS para SQL Server: el camino del zen (limitado)

RDS (Relational Database Service) ofrece SQL Server como servicio gestionado. Lo eliges desde la consola, eliges la edición, el tamaño, las opciones de almacenamiento, y listo: tienes una instancia SQL Server “as a service”.

Aquí puedes elegir entre las ediciones Web, Standard y Enterprise. Express solo está disponible en RDS para desarrollo y pruebas muy básicas. Las versiones van desde SQL Server 2012 hasta 2022, aunque las más antiguas ya huelen a rancio y deberían estar fuera de toda conversación seria.

AWS se encarga del parcheo, los backups automáticos, la monitorización con CloudWatch, la alta disponibilidad con Multi-AZ, y hasta de restaurarte una base de datos si te la cargas (dentro del periodo de retención). Muy cómodo, sí. Pero el precio de esa comodidad es la limitación.

Por ejemplo, no puedes usar funciones como FILESTREAM, SQL Server Agent personalizado, CLR Unsafe, xp_cmdshell, ni muchos otros elementos avanzados. Tampoco puedes instalar software adicional en el sistema operativo ni afinar el motor a nivel de sistema. ¿Es suficiente para la mayoría de los casos de uso? Sí. ¿Es frustrante cuando necesitas hacer algo fuera del guión? También.

¿Qué ediciones están disponibles en AWS y cuándo usarlas?

Aquí es donde las diferencias entre EC2 y RDS se hacen más evidentes. En EC2 puedes instalar lo que quieras, como si estuvieras en tu CPD de toda la vida. RDS, en cambio, restringe la elección a ediciones licenciadas por AWS.

  • SQL Server Express: limitada hasta el absurdo. Solo útil en pruebas o en ese ERP vintage que aún cabe en 10 GB. Está disponible en EC2 y en RDS.
  • SQL Server Web Edition: solo para aplicaciones web y bajo ciertas condiciones. Más barata que Standard, pero con muchas limitaciones. Solo disponible en RDS si tu contrato lo permite.
  • SQL Server Standard: el caballo de batalla. Lo suficientemente potente para la mayoría de workloads OLTP, con soporte de hasta 128 GB de RAM y sin las florituras de Enterprise. Disponible tanto en EC2 como en RDS.
  • SQL Server Enterprise: para cuando ya no hablamos de bases de datos, sino de feudos de datos. Requiere justificar su coste, pero habilita funciones como Always On, compresión de datos, particionamiento, y el Query Store decente (no el recortado de Standard). También disponible en ambas opciones.

Versiones disponibles en AWS: sí, también hay letra pequeña

En RDS, las versiones disponibles van desde SQL Server 2012 hasta 2022 (según la región y el tipo de instancia). Pero no siempre están todas. Hay regiones donde 2022 aún no está disponible o donde ciertas ediciones se ofrecen solo en ciertas clases de instancias. Y no esperes instalar CUs al día siguiente de su publicación: AWS sigue su propio calendario de validación, lo cual está bien si valoramos la estabilidad… y menos bien si necesitamos esa CU concreta para resolver un bug que nos está friendo en producción.

En EC2, como tú te lo guisas, tú decides qué versión instalar. Pero no te olvides de los ciclos de soporte. Instalar SQL Server 2016 en 2025 es como llevar un Nokia 3310 a una reunión de arquitectura cloud: nostálgico, pero absurdo.

Y si hablamos de costes… prepara la cartera

Ni EC2 ni RDS son baratos si no se diseñan con cabeza. RDS tiene costes predecibles, pero no siempre bajos. EC2 puede salir caro si dejamos las instancias encendidas todo el mes sin monitorizar nada. Y el coste de las licencias es otra historia. SQL Server no es barato, y Amazon lo sabe.

En RDS pagamos licencia por hora. En EC2 podemos traer nuestras licencias con Software Assurance, lo cual puede ahorrar bastante en escenarios Enterprise. Pero si lo haces mal, puedes terminar pagando el doble por rendimiento inferior. La arquitectura importa, y mucho.

¿Y qué pasa con la alta disponibilidad en AWS?

En EC2, la alta disponibilidad te la montas tú: con Always On Availability Groups, con failover clustering, o con lo que prefieras… y se te ocurra mantener. En RDS, basta con activar la opción Multi-AZ y dejar que AWS haga el trabajo sucio. Pero no confundamos Multi-AZ con Always On: RDS usa su propio sistema de replicación bajo el capó, que no es transparente ni configurable.

Si necesitas un AG real con réplicas legibles, bienvenido a EC2. Y prepárate para montar la infraestructura necesaria: subredes, listeners, quórum, test de failover, etc. ¿Merece la pena? Depende de lo que estés dispuesto a sacrificar por la comodidad.

Te recomiendo ver la sesión de Francisco Amat sobre este tema para llevar tu alta disponibilidad al siguiente nivel.

Conclusión

No hay una única respuesta correcta a la pregunta “¿cómo desplegamos SQL Server en AWS?”. Hay decisiones técnicas, estratégicas y económicas que tomar. EC2 es más flexible, pero también más arriesgado. RDS es más cómodo, pero impone más restricciones.

La elección depende del tipo de carga, del nivel de control que necesitamos, de los costes que estamos dispuestos a asumir y, por supuesto, de cuántos fuegos queremos apagar a las tres de la madrugada.

Así que no, no es cuestión de levantar una base de datos “en la nube” y seguir con nuestra vida. Es cuestión de entender cada opción, sus límites y sus consecuencias. Porque en AWS, igual que en la vida, cada elección tiene su precio. Y a veces, ese precio se mide en IOPS… o en dignidad.

¿Quieres rendimiento extremo, fine-tuning y llorar en modo sysadmin? EC2. ¿Prefieres comodidad, escalabilidad rápida y vivir con algunas restricciones? RDS. Tú decides. Pero decide con conocimiento, no con fe ciega en el marketing cloud.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima! 

Publicado por Roberto Carrancio en Alta Disponibilidad, Cloud, SQL Server, 0 comentarios
