Rendimiento

¿Cómo usar QueryStore en SQL o Azure?

En este tercer Video Blog nos adentramos en QueryStore, una de las herramientas más potentes que Microsoft pone a nuestra disposición de manera nativa para monitorizar el rendimiento de nuestras bases de datos SQL ya sea en SQL Server o en Azure.

Como ya os prometí en el post de ayer donde vimos la teoría que rodea a esta herramienta, hoy vamos a aprovechar las ventajas del formato de Video Blog para ver todas las opciones de visualización de datos y configuración de la herramienta que necesitamos para convertirnos en verdaderos profesionales del rendimiento en SQL.

Vistas de QueryStore

QueryStore pone a nuestra disposición varias vistas con diferente información de lo más útil.

  • Regresed Queries: Nos va a permitir localizar las consultas que han sufrido una degradación de rendimiento.
  • Overall Resource Consumption: Muestra el consumo de los diferentes recursos a lo largo del tiempo en diferentes gráficos de barras.
  • Top Resource Consuming Queries: Nos va a mostrar las consultas que más recursos han consumido de un recurso que nosotros elijamos en un periodo a elegir entre 5 minutos y varios años.
  • Queries With Forced Plans: Aquí podremos encontrar las consultas a las que les hemos forzado un plan de ejecución en concreto.
  • Queries With High Variation: Esta vista nos mostrará las consultas con gran variación en su consumo de recursos, ya sea a mejor o peor.
  • Query Waits Statistics: Este informe es uno de los más importantes y por el que yo siempre empiezo a mirar. En el vamos a ver cuales son los recursos que causan cuellos de botella en el rendimiento de nuestras consultas.
  • Tracked Queries: En este último dashboard vamos a poder hacer seguimiento del rendimiento de una consulta en concreto que nosotros elijamos.

Objetivos de la optimización en QueryStore

El fin principal de esta herramienta no es otro que ayudarnos a mejorar el rendimiento de nuestras consultas. Es importante remarcar, que una buena optimización no solo mejorará los tiempos de nuestros procesos sino que, además, reducirá el consumo de recursos permitiéndonos un gran ahorro en infraestructura tanto si tenemos servidores locales como en la nube. En este último escenario, donde el pago por uso parece ya un estándar este ahorro de recursos puede marcar la diferencia entre que nuestro proyecto sea o no rentable.

Conclusión

QueryStore es una gran herramienta que nos va a permitir optimizar el rendimiento de las consultas y ahorrar costes tanto en SQL Server como en Azure SQL. A través de sus diferentes informes vamos a ser capaces de localizar y poner solución a los problemas de nuestro servidor. Espero que este artículo te haya proporcionado una visión profunda del almacén de consultas en SQL Server y Azure. Como siempre, estamos aquí para ayudarte. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 1 comentario

Query Store en SQL Server y Azure

Todos los que nos dedicamos al mundo de las bases de datos, ya sea como administradores o como usuarios, siempre deberíamos estar buscando formas de mejorar el rendimiento y la eficiencia de las consultas. Por eso, hoy vamos a explorar una herramienta muy poderosa que puede ayudarnos a hacer precisamente eso: el almacén de consultas o Query Store disponible de forma nativa tanto en SQL Server como en Azure.

¿Qué es el Query Store?

El almacén de consultas es una característica que permite rastrear y revisar el historial de ejecución de consultas en SQL Server y Azure. Es como la “caja negra” de los aviones pero para nuestras consultas SQL en SQL Server o Azure. Gracias a esta información de Query Store vamos a lograr una visión detallada de cómo se están ejecutando nuestras consultas a lo largo del tiempo y con ello, localizar problemas o puntos de mejora en el rendimiento.

Beneficios de Query Store

Query Store ofrece muchos beneficios, vamos a centrarnos en los principales. Lo principal para mi es que nos permite identificar consultas de alto consumo de recursos. Esto, por sí solo ya sería un motivo de peso para valorar configurarlo en nuestros sistemas pero, además, nos va a facilitar ver cómo cambia el rendimiento de las consultas con el tiempo y entender cómo las diferentes configuraciones afectan el rendimiento de las consultas.

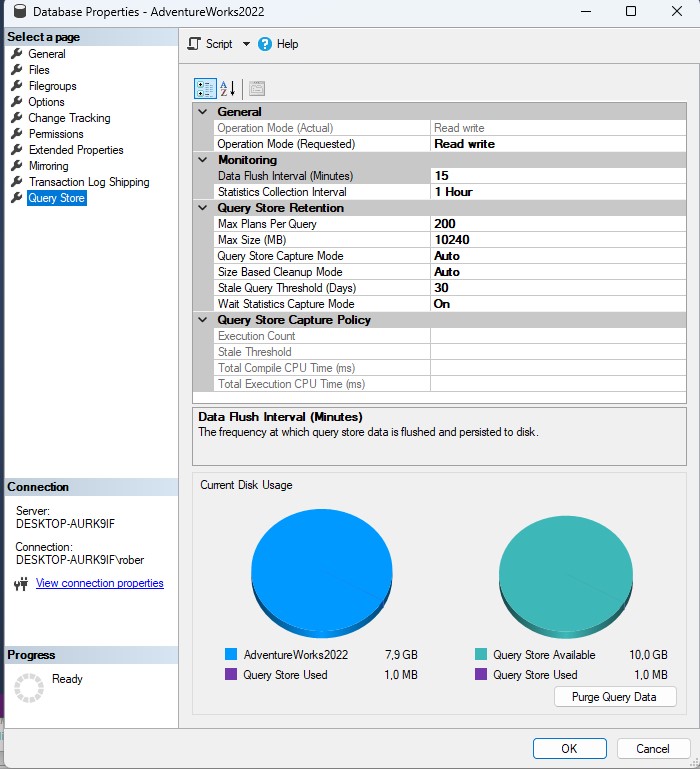
Configuración en SQL Server

En SQL Server, el almacén de consultas se puede habilitar a nivel de base de datos. Una vez habilitado, comenzará a recopilar datos sobre las consultas ejecutadas en la base de datos. Y ya está, desde ese preciso momento podemos usar esta información para identificar consultas problemáticas y tomar medidas para mejorar su rendimiento. Pero, no nos saltemos pasos, vamos a ver en detalle la ventana de configuración y repasar sus opciones.

QueryStore

Como podemos ver la configuración es bastante sencilla. Deberemos indicar algo más de media docena de parámetros y aplicar los cambios. Como es habitual, tenemos un cuadro de texto bajo las opciones donde se nos especifica que hace cada una de esas configuraciones. Profundizaremos en esta configuración en futuros post así que no vamos a complicar más esta explicación.

Configuración en Azure

En Azure es incluso más sencillo, Query Store es una característica incorporada y habilitada por defecto tanto en Azure SQL Database como en Azure SQL Managed Instance. Al igual que en SQL Server, nos proporciona información valiosa sobre el rendimiento de nuestras consultas. Además, como pudimos ver en la beta presentada este fin de semana en el evento Global Azure Spain, se integra con Azure Copilot para que podamos preguntar directamente a la IA de Microsoft cuáles son los problemas y obtener toda la información en lenguaje natural.

Uso de Query Store 

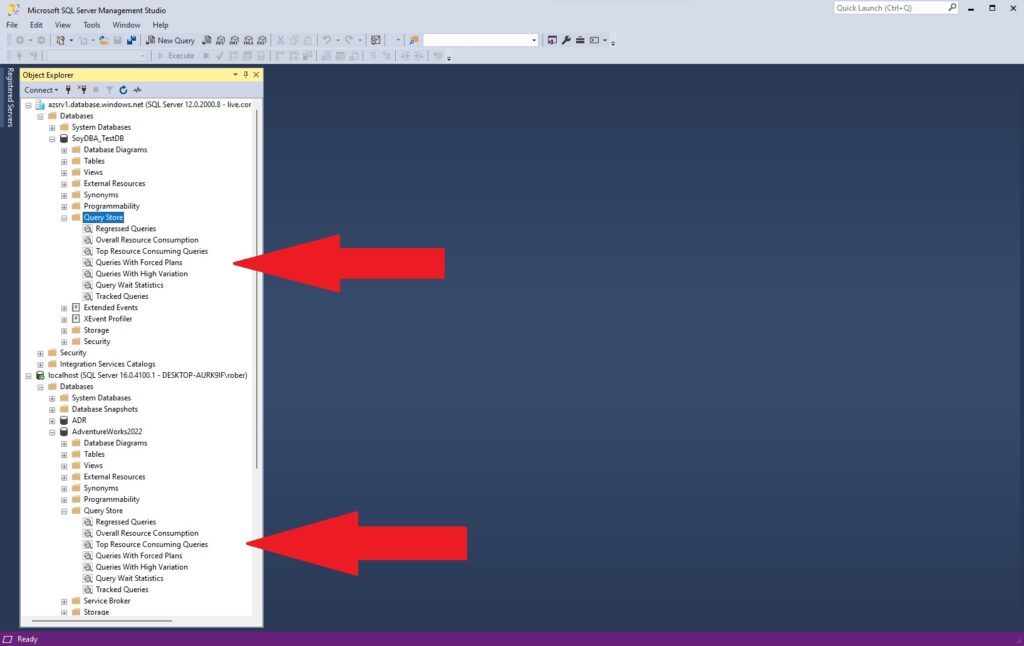
Una vez habilitado Query Store en SQL Server o de manera automática en las bases de datos de Azure ya dispondremos de los informes correspondientes dentro del apartado Query Store en la base de datos. 

QueryStore_2

Podéis apreciar en la imagen que, una vez en nuestro SSMS no hay diferencias entre la base de datos de Azure y la que está en mi instancia local. Los informes son los mismos y van a tener la misma información. Si queréis profundizar más sobre los distintos informes y su funcionamiento estad atentos al blog que mañana publicaremos un video donde os lo enseñaré en detalle.

Conclusión

El almacenamiento de consultas es una herramienta poderosa para la administración de bases de datos en SQL Server y Azure. Nos permite rastrear y analizar el rendimiento de nuestras consultas, lo que nos ayuda a optimizar nuestras bases de datos y mejorar la eficiencia. Si aún no estás utilizando el almacenamiento de consultas, te animamos a que lo explores y veas cómo puede beneficiar a tu entorno de base de datos.

Esperamos que este artículo te haya proporcionado una visión profunda del almacén de consultas en SQL Server y Azure. Como siempre, estamos aquí para ayudarte en tu viaje de administración de bases de datos. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 2 comentarios

Detectando fragmentación de índices en SQL Server y Azure

Volvemos a la carga con un artículo sobre índices de esos que tanto nos gustan. Esta vez vamos a hablar de un tema muy importante y es detectar qué índices están más fragmentados y cómo solucionarlo. A menudo vemos que una mala gestión de los planes de mantenimiento provocan una degradación del rendimiento de las consultas y eso, gran parte de las veces es debido a un problema de fragmentación de índices o falta de mantenimiento de las estadísticas. Hoy vamos a centrarnos en el primero de estos aspectos.

¿Cómo detectar fragmentación en los índices?

Para ver la fragmentación de un índice en concreto podemos hacerlo desde el entorno gráfico de nuestro SSMS, haciendo click derecho sobre el objeto y mirando sus propiedades. Sin embargo, esto no es práctico cuando tenemos cientos de índices en nuestra base de datos y queremos saber de un vistazo cuales son los más fragmentados y cuanto. Para ello, usaremos una consulta sobre la función de sistema sys.dm_db_index_physical_stats. 

Otra de las cosas que debemos tener en cuenta es el tamaño de nuestra tabla, con menos de 1000 páginas, el motor de base de datos directamente ignorará los índices nonclustered y, en el caso de los clustered, tampoco vamos a notar diferencia.

Con esto en mente vamos a preparar el script. 

Revisemos el script, por un lado podemos ver que a la función para ver las estadísticas de los índices le estamos pasando el id de la base de datos actual para que se ejecute en ese contexto. Esto es para evitar que se ejecute por todas las bases de datos y podamos tener un problema de rendimiento con esta consulta. Por otro lado vemos que solo afecta a tablas y vistas de usuario que tengan un índice clustered, el tipo de índice 0 está excluido de los filtros. Las tablas HEAP (sin índice clustered) necesitan otro tipo de tratamiento. Podemos ver también el filtro para solo mostrar índices con más de 1000 páginas y el de fragmentación superior al 5%, que suele considerarse el umbral de fragmentación aceptable.

Solucionar fragmentación de índices

Ahora que sabemos cuales son los índices más fragmentados debemos actuar y solucionar el problema. Sabemos que tenemos a nuestra disposición dos alternativas: reorganizar o reconstruir. Para elegir entre una opción u otra tenemos varios factores a tener en cuenta.

Por un lado tenemos el modo de operación de estas instrucciones, reorganizar siempre es una operación online lo que significa que solo generará sobre nuestro índice un intento de bloqueo compartido. El índice se podrá seguir leyendo durante la reordenación sin causar bloqueos. En cuanto a la reconstrucción, solo es online si se lo especificamos manualmente y eso solo es posible en ediciones Enterprise de SQL Server o en las bases de datos o instancias gestionadas de Azure. Si la reconstrucción es offline se generará un bloqueo exclusivo sobre el índice.

Por otro lado, la reconstrucción es más eficiente que la reorganización para porcentajes elevados de fragmentación y eso deberemos tenerlo también muy en cuenta.

¿Debería reorganizar o reconstruir mis índices con mucha fragmentación?

Esto no es una ciencia exacta y es un tema sobre el que hay muchas opiniones discordantes. Normalmente se habla de reorganizar los índices con una fragmentación superior al 5 o 10% y menor al 15 o 30%. Como veis es una horquilla muy amplia y para atinar tenemos que pensar en las las implicaciones de estas operaciones que ya hemos visto antes. Yo os voy a contar cómo lo hago yo pero esto es totalmente personal y deberás adaptarlo a cada caso.

Escenario 1: Mantenimiento programado

En este primer escenario estamos hablando de un mantenimiento programado dentro de una ventana de mantenimiento en la que no hay interferencia con otros procesos. Este caso es el más sencillo porque no tenemos que pensar en no entorpecer a nadie. En estos casos yo pongo el umbral para empezar a actuar en un 5%. Si estamos hablando de una edición Standard de SQL Server reorganizaré los índices con una fragmentación entre un 5 y un 20% y reconstruiré los de mayor fragmentación. Para ediciones Enterprise o Azure reduciré esa horquilla para reorganizar entre un 5 y un 15% y haré reorganizaciones online a partir del 15%.

Escenario 2: Problema puntual de rendimiento

En este escenario estamos hablando de un momento de carga de trabajo elevada en el que hemos recibido o detectado una incidencia por problemas de rendimiento. Tenemos que actuar rápido para solventar la situación pero entorpeciendo lo menos posible a los procesos de negocio que ya de partida tienen un rendimiento mermado. En estos casos pongo el umbral para empezar a actuar en fragmentaciones por encima del 10% en vez del 5. A partir de ahí, si tenemos la suerte de contar con una edición Enterprise, o estamos en Azure, no hay más problema, reconstruiremos con las mismas condiciones que en el escenario anterior, a partir del 15%. Para una edición Standard, donde si vamos a generar bloqueos si reconstruimos, intentaremos reorganizar hasta el 30% de fragmentación.

Solucionar estadísticas desactualizadas

Las estadísticas son clave para SQL Server. Como ya hemos comentado en este blog muchas veces, unas estadísticas desfasadas pueden tener el mismo impacto negativo o peor que un índice fragmentado. Por este motivo, es importante tenerlas en cuenta a la hora de realizar nuestros mantenimientos o enfrentar una incidencia por degradación de rendimiento. Una reconstrucción de índices siempre actualizará las estadísticas asociadas a ese índice pero en el caso de las reorganizaciones deberemos hacerlo manualmente. Tenemos que contar también con que una actualización de estadísticas es más ligera y rápida que un mantenimiento de índices por lo que, en caso de una degradación de rendimiento de una consulta puntual, yo siempre actualizo las estadísticas de las tablas involucradas como primera medida.

Conclusión

Ante un problema de rendimiento, tenemos que verificar el estado de nuestros índices y estadísticas. Además, consultar su nivel de fragmentación será clave a la hora de decidir si vamos a reorganizarlo o reconstruirlo y, todo esto, siempre sin dejar de lado las estadísticas. Tened en cuenta que por mucho que tengamos implementada una solución de mantenimiento de índices y estadísticas nunca vamos a estar 100% seguros de que no va a haber una variación tal de datos que nos va a generar fragmentación o a dejar desfasadas nuestras estadísticas. Es importante que mantengamos una monitorización y vigilancia continua para garantizar el mejor desempeño de nuestros SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 1 comentario

IDENTITY o Secuencias, ¿Cuál es mejor?

Cuando llevas ya un tiempo en el mundo de las bases de datos, especialmente en SQL Server, es normal encontrarnos repetidamente con una misma pregunta sobre dos conceptos clave, ¿Qué es mejor usar para mis IDs numéricos incrementales, un campo IDENTITY o secuencias?. Ambos son conceptos fundamentales para la generación de valores únicos y juegan un papel crucial en la gestión de datos. En este artículo, vamos a sumergirnos en estos dos conceptos, explorando sus ventajas, desventajas y cuándo es mejor usar uno u otro. Seguro que no acabamos con esta pregunta repetitiva pero, al menos, vamos a intentar reunir todas las herramientas que necesitamos para darle la mejor respuesta. 

IDENTITY en SQL Server

IDENTITY es una propiedad que se puede establecer en una columna de una tabla en SQL Server. Esta propiedad genera automáticamente valores numéricos secuenciales cada vez que se inserta una nueva fila en la tabla. Es muy útil cuando se necesita un identificador único, como una clave primaria. Aunque es muy común su uso para claves primarias, Identity por sí mismo no garantiza la unicidad. Cuando declaramos esta propiedad debemos acompañarla de dos números, el primero llamado seed indica el primer valor que va a tener nuestro campo IDENTITY y el segundo, increment, define el incremento. Es muy común el uso de IDENTITY (1,1) que especifica que empezando desde el número 1 el contador se incrementará en 1. 

Ventajas de IDENTITY

IDENTITY es fácil de implementar y no requiere ninguna gestión adicional. Además, es altamente eficiente en términos de rendimiento, ya que los valores se generan durante la inserción de datos.

Desventajas de IDENTITY

Con Identity, no se puede controlar la secuencia de los números generados. La secuencia siempre comienza en 1 (o cualquier valor inicial especificado) y se incrementa en 1 (o cualquier incremento especificado). No podremos modificar el contador si por ejemplo hemos borrado datos. Así mismo, los valores de Identity están vinculados a una tabla específica. No se pueden compartir entre tablas.

Tampoco es posible garantizar al 100% que los números vayan a ser consecutivos. Si estamos trabajando en un nivel de aislamiento distinto a SERIALIZABLE es posible que en ocasiones encontremos saltos. Otro error común en la numeración se da cuando nos encontramos saltos de 1000 números de golpe, esto se da cuando tenemos paradas inesperadas del servicio de SQL Server. Si durante la parada había una operación a medias SQL incrementará en 1000 el contador de IDENTITY para evitar duplicidades.

Columnas limitadas: Otra de las desventajas es que solo podremos definir la propiedad IDENTITY para una columna en cada tabla.

Inserciones manuales en campos IDENTITY

Cuando queremos insertar manualmente un dato nuevo en un campo IDENTITY deberemos primero habilitar la inserción de identidad. Esto nos permitirá insertar un valor en esa columna. Si el valor insertado es mayor al último que tenga almacenado se establecerá este nuevo como valor de identidad actual.

La sintaxis para habilitar la inserción e identidad es:

SET IDENTITY_INSERT [ [ database_name . ] schema_name . ] table_name { ON | OFF }  

Debemos tener en cuenta que esta opción se establece en tiempo de ejecución y no de análisis y que solo lo podemos tener activado para una tabla por sesión. Si se intenta establecer la opción sobre una tabla teniéndola activada sobre otra se desactivará la anterior para activar la actual

Secuencias en SQL Server

Las Secuencias en SQL Server son objetos de base de datos que generan una secuencia de números únicos. A diferencia de Identity, las secuencias no están atadas a una tabla específica y pueden ser utilizadas por múltiples tablas.

Ventajas de las Secuencias

Las secuencias ofrecen una mayor flexibilidad en términos de gestión de la secuencia de números. Se puede establecer el valor inicial, el incremento, el valor mínimo y máximo, y si la secuencia debe reiniciarse después de alcanzar el valor máximo. Además, las secuencias pueden ser utilizadas por varias tablas, lo que permite mantener una secuencia única a través de múltiples tablas y no tenemos la limitación de solo una por cada tabla. Por último, en cualquier momento podremos manualmente ajustar el contador de nuestras secuencias.

Desventajas de las Secuencias

Las secuencias pueden ser un poco más complejas de implementar y gestionar en comparación con IDENTITY. Aunque las secuencias son generalmente eficientes, pueden tener un impacto en el rendimiento si se utilizan en tablas con un volumen de datos muy alto.

Inserción del valor de la secuencia

Al contrario que con IDENTITY la secuencia no se inserta directamente a la hora de hacer una inserción en la tabla, aunque si podremos lograr este comportamiento definiendo el siguiente valor de la secuencia como valor por defecto de una columna. De esta manera siempre que no se declare manualmente ningún otro valor para la columna se insertará el valor de la secuencia. Esto nos permite inserciones manuales mucho más sencillas para los usuarios finales de la base de datos pero también conlleva un riesgo al no ir el valor de la secuencia ligado al contenido de la tabla.

¿Cuándo usar Identity y cuándo usar Secuencias?

La elección entre Identity y Secuencias depende en gran medida de las necesidades específicas del proyecto. Si se necesita una solución simple y eficiente para generar claves primarias en una sola tabla, IDENTITY puede ser la opción ideal. Sin embargo, si se necesita una mayor flexibilidad y la capacidad de compartir la secuencia de números entre varias tablas, las secuencias pueden ser la mejor opción.

Conclusión

Tanto la propiedad IDENTITY como las secuencias son herramientas poderosas en SQL Server para la generación de valores únicos. Cada una tiene sus propias ventajas y desventajas, y la elección entre una y otra depende de las necesidades específicas del proyecto. Al entender estas herramientas y cómo funcionan, podemos hacer un uso más efectivo de ellas y diseñar bases de datos más eficientes y flexibles. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 2 comentarios

Claves Foráneas (FK): Trucos, Ventajas e Inconvenientes

En las bases de datos, las claves foráneas (FK) son una herramienta esencial para mantener la integridad referencial entre las tablas. Sin embargo, su uso puede tener tanto ventajas como desventajas, especialmente en términos de rendimiento y consumo de CPU. Tanto es así que por ejemplo MySQL por defecto renuncia a la integridad referencial en pro de la velocidad. Otros SGBD relacionales como SQL Server, PostgreSQL u Oracle sí que tratan las FK como una restricción. Comprender este comportamiento es clave para entender el comportamiento de nuestras bases de datos. Pero, veámoslo con detenimiento.

¿Qué son y cómo funcionan las FK?

Como hemos adelantado en la introducción, las claves foráneas son una forma de garantizar la integridad referencial en nuestras bases de datos. Cuando definimos una FK, estamos creando una relación entre dos tablas, donde una tabla tiene una columna o un conjunto de columnas que hacen referencia a una clave primaria en otra tabla. De esta manera no podremos crear en nuestra tabla destino registros con un valor que no exista previamente en la tabla de referencia.

Pensad en un modelo normalizado donde tenemos una tabla de cabeceras de facturas y en otra tabla las líneas de esas facturas. Una FK entre las tablas nos permitirá no poder tener en la tabla de líneas ningún registro que pertenezca a una factura inexistente. Esto tiene más implicaciones, como por ejemplo que en la tabla de facturas no podamos editar o borrar un dato si tiene líneas asociadas que, de otra manera, quedarían huérfanas. 

Actualización y Borrado en Cascada

Las claves foráneas en SQL Server y otros sistemas permiten configurar acciones de actualización y borrado en cascada. Esto significa que cuando se actualiza o se elimina un registro en la tabla principal, SQL Server automáticamente actualizará o eliminará los registros correspondientes en las tablas relacionadas.

La principal ventaja de la actualización y borrado en cascada es que simplifica la gestión de las bases de datos. No necesitamos escribir código adicional para manejar estas operaciones, ya que SQL Server se encarga de ello por nosotros. Esto puede ahorrar tiempo y reducir la posibilidad de errores.Sin embargo, la actualización y borrado en cascada también tienen sus inconvenientes. Si no se utilizan correctamente, pueden llevar a la eliminación inadvertida de datos. Por lo tanto, es importante utilizar estas características con cuidado y entender completamente sus implicaciones antes de implementarlas.

En resumen, la actualización y borrado en cascada son herramientas poderosas que pueden simplificar la gestión de nuestras bases de datos. Sin embargo, como con cualquier herramienta, deben utilizarse con cuidado y con un entendimiento completo de sus ventajas e inconvenientes.

Ventajas de las FK

Las FK proporcionan varias ventajas. La más importante, como ya hemos visto, es la garantía de la integridad referencial. Esto significa que no podemos tener datos huérfanos en nuestra base de datos. Además, las FK pueden ayudar a mejorar la legibilidad y la organización de nuestra base de datos. Además tienen otra gran ventaja que a menudo pasamos por alto y no es otra que facilitarnos la comprensión del modelo de datos.

Mantenimiento de la Integridad referencial

Las FK garantizan que los datos en las tablas relacionadas siempre sean consistentes. Esto es crucial para evitar anomalías de datos y garantizar la precisión de los resultados de las consultas.

Comprensión del modelo de datos

Las FK simplifican el proceso de entender el modelo de datos, sobre todo cuando nos enfrentamos a él por primera vez y no hay documentación. Al proporcionar conexiones claras entre las tablas es sencillo entender esas relaciones para cualquiera que lo sepa leer.

Inconvenientes de las FK

A pesar de sus ventajas, las FK, como todo, también tienen sus inconvenientes. Como hemos mencionado, pueden afectar al rendimiento y al consumo de CPU y disco. Además, pueden complicar las operaciones de inserción, actualización y eliminación, ya que requieren comprobaciones adicionales.

Rendimiento

El uso de FK puede tener un impacto significativo en el rendimiento y el consumo de CPU y el disco duro de nuestra base de datos. Cuando se inserta, actualiza o elimina un registro en una tabla que tiene una FK, SQL Server debe realizar comprobaciones adicionales en todas las tablas referenciadas para mantener la integridad referencial. Esto puede aumentar el tiempo de ejecución de estas operaciones y, por lo tanto, el consumo de CPU y disco. Personalmente he llegado a operaciones tan simples como un DELETE por la PK de una tabla que, debido a las FK, obliga a SQL Server a leer más de 50 tablas. Tenemos que tener cuidado con esto sobre todo a medida que el modelo de datos crece y las relaciones entre las tablas se complican.

Además, las verificaciones de integridad referencial requieren un procesamiento adicional, lo que puede aumentar el consumo de CPU además del disco duro. En sistemas con una gran cantidad de transacciones, esto puede ser un problema. Recuerda mantener siempre una buena monitorización sobre el rendimiento de tu modelo de datos.

Complejidad de las operaciones de escritura

No solo nos vamos a encontrar con degradaciones en el rendimiento de SQL Server sino que, para nosotros como DBAs y para los administradores de los datos también se va a añadir una capa de complejidad a la hora de trabajar con los datos. Son escenarios muy comunes para un DBA el de restaurar solo los datos de una tabla de la copia de seguridad o el de copiar datos entre distintos entornos. En estos casos, por ejemplo, tendremos que tener muy claro el orden de las inserciones y deberemos hacerlo de manera secuencial para evitar errores. O eso o deshabilitamos temporalmente las FK pero en este caso deberemos validarlas otra vez al activarlas y en tablas grandes eso es inviable. 

Indexar para evitar los inconvenientes de las FK

Como hemos podido ver, el hecho de tener FKs en nuestra base de datos va a añadir una lógica adicional a las transacciones de escritura lo que va a provocar un mayor consumo de recursos y por tanto un peor rendimiento de nuestro SQL Server. En este sentido, el indexado de los campos de las claves foráneas es una práctica esencial que puede mejorar significativamente el rendimiento de nuestras bases de datos. Crear índices para esos campos referenciados por una clave foránea permitirá, que a la hora de actualizar o borrar un registro en la tabla principal, SQL Server pueda usarlos para verificar rápidamente la integridad referencial sin tener que leer completamente la tabla.

Conclusión

Las claves foráneas son una herramienta poderosa en SQL Server pero también es un arma de doble filo. Aunque pueden tener un impacto en el rendimiento y el consumo de CPU, los beneficios que aportan en términos de integridad referencial suelen superar estos costes. Como siempre, la clave está en entender cómo funcionan y usarlas de manera inteligente. Recuerda, cada base de datos es un mundo y lo que funciona en uno puede no funcionar en otro. Por lo tanto, siempre es recomendable probar y monitorizar el rendimiento antes de implementar cualquier cambio a gran escala.

Como siempre, te animo a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 1 comentario

Impacto en el rendimiento de índices FullText

Llevamos los dos últimos artículos hablando de los índices de texto completo (FullText) en SQL Server. Hemos aprendido lo qué son y cómo se administran, sin embargo hay un tema, quizá lo más importante, que habíamos dejado para el final. Y no es otro que su uso y el impacto en el rendimiento. ¿Realmente merece la pena este tipo de índices? Vamos a descubrirlo juntos.

Cláusulas específicas para buscar en índices FullText

Normalmente cuando tenemos que buscar texto dentro de una columna en SQL usamos la cláusula LIKE y nos apoyamos en el carácter % que hace de comodín. Sin embargo, cuando hemos añadido una columna a un índice FullText se nos habilitan otras opciones de búsqueda como son CONTAINS, FREETEXT, CONTAINSTABLE y FREETEXTTABLE. Aunque todas son cláusulas para filtrar por texto tienen algunas diferencias que debemos conocer.

CONTAINS: La Precisión

CONTAINS es una cláusula que permite realizar búsquedas de texto completo en columnas de tipo char, varchar o text dentro de SQL Server. Esta cláusula es especialmente poderosa por su capacidad de buscar palabras o frases específicas, e incluso formas de una palabra, dentro de un texto. Por ejemplo, si queremos encontrar todos los registros que contengan la palabra «optimización», CONTAINS nos facilitará esta tarea con gran precisión.

FREETEXT: La Relevancia 

Por otro lado, FREETEXT es menos estricta que CONTAINS y se utiliza para buscar términos que sean «similares» o relacionados con el texto de la consulta, sin necesidad de que sean exactos. Es decir, FREETEXT no solo nos va a devolver los campos que contengan esa palabra sino también los que contengan algún sinonimo.  Esto es ideal para cuando la intención es más importante que la coincidencia literal, permitiendo una búsqueda más «libre» y basada en la relevancia.

CONTAINSTABLE: Resultados Ordenados

CONTAINSTABLE es una función que extiende las capacidades de CONTAINS, devolviendo una tabla de resultados con las filas que coinciden con la búsqueda, junto con un rango de relevancia, conocido como «rank». Esto permite no solo encontrar las coincidencias, sino también ordenarlas por su relevancia, facilitando la identificación de los resultados más pertinentes.

FREETEXTTABLE: Mayor Flexibilidad en la Búsqueda

Similar a CONTAINSTABLE, FREETEXTTABLE aplica los principios de FREETEXT a una tabla de resultados clasificables. Esta función es crucial cuando buscamos entender el contexto general de los términos de una búsqueda dentro de un conjunto de datos, proporcionándonos una clasificación que nos ayuda a discernir la importancia relativa de cada registro encontrado.

Sintaxis y ejemplos de la búsqueda de texto

Ahora que ya sabemos las diferencias entre las distintas búsquedas vamos a ver como se usan en un caso práctico. Para esto vamos a usar la base de datos de ejemplo de Microsoft AdventureWorks. Como ya sabréis (o no, no importa) esta base de datos tiene datos de ejemplo de una tienda de bicicletas. Vamos a buscar, entonces, por la palabra rendimiento en la tabla de descripciones de los productos. Lamentablemente no tenemos una base de datos AdventureWorks con datos en español así que tendremos que buscar en inglés pero es solo por esto. Vosotros tendreis que buscar en el idioma que tengáis vuestros datos y, muy importante, tendréis que haber creado directamente el índice en ese idioma (si no sabéis como se hace os lo conté aquí). 

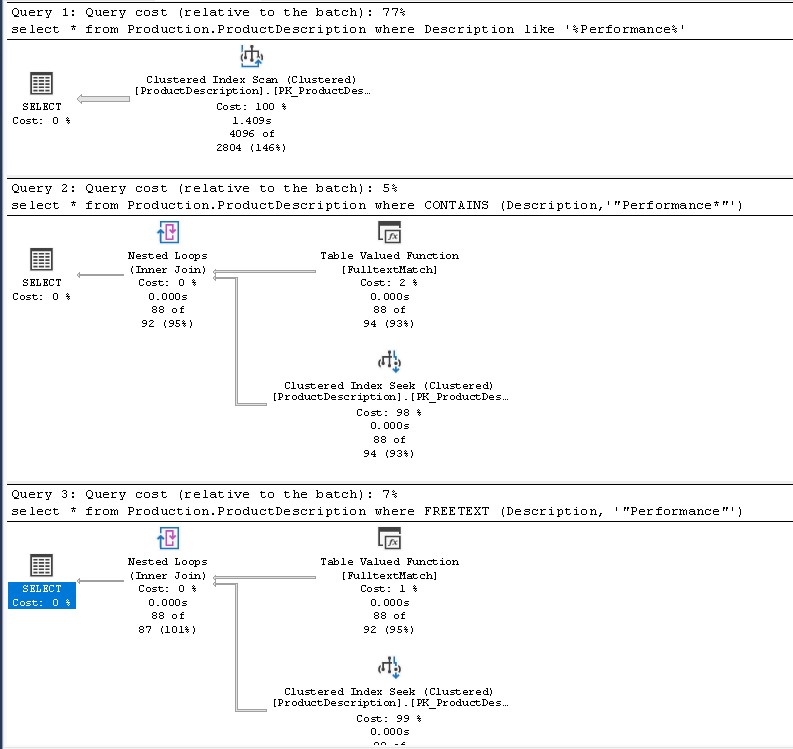
Vamos a hacer la misma búsqueda con todas las posibles opciones que hemos visto antes:

Podríamos entrar aquí y ahora en todas las opciones avanzadas de filtrado que incluyen cada una de estas opciones frente al tradicional y simple LIKE pero, convertiría este artículo en eterno y tampoco es el objetivo del post. Si queréis profundizar más tenéis la documentación oficial y si queréis que veamos aquí algunos ejemplos podeis pedirmelo y lo haremos. 

Rendimiento en las búsquedas de texto

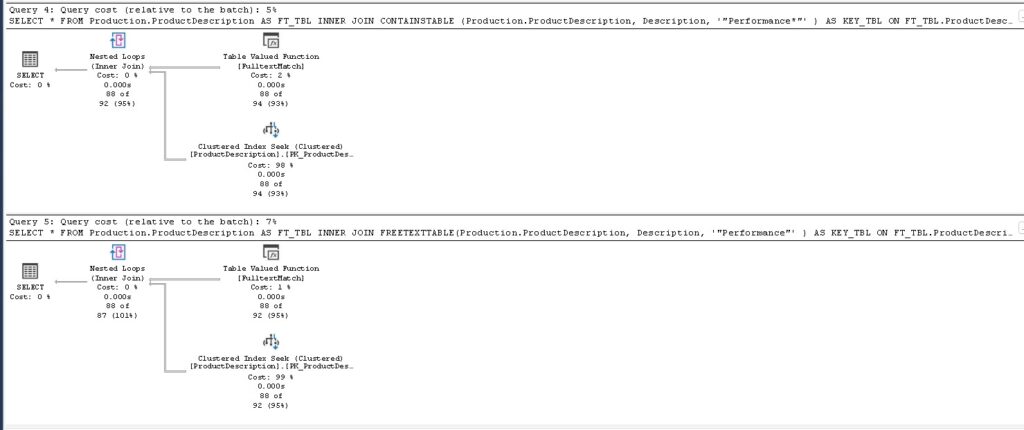
Vamos ahora a comparar el rendimiento de las consultas anteriores. Para que el ejemplo tenga más relevancia he creado aproximadamente unos 200.000 registros en la tabla en lugar de los menos de 800 que trae cuando restauramos la base de datos. No sufráis por eso que después de eso también he actualizado los índices y estadísticas de la tabla. Esto nos va a permitir verificar mejor las diferencias.

Estos han sido los resultados ejecutando las anteriores consultas:

CláusulaTiempo de CPULecturas lógicasPorcentaje del plan
LIKE781 milisegundos4365 páginas77%
CONTAINS< 1 milisegundo278 páginas5%
FREETEXT< 1 milisegundo278 páginas7%
CONTAINSTABLE< 1 milisegundo278 páginas5%
FREETEXTTABLE< 1 milisegundo278 páginas7%
FullText_Performance1
FullText_Performance2

Las conclusiones son obvias, el mayor consumo de recursos es con Like, cuando no se usa el índice FullText tardando 780 veces más en completar la consulta y leyendo 34 Mb de información (4365 páginas * 8Kb por página / 1024 = 34 Mb) frente a los solo 2 Mb de información que se leen las consultas que sí hacen uso del índice de texto completo. 

Rendimiento en escrituras

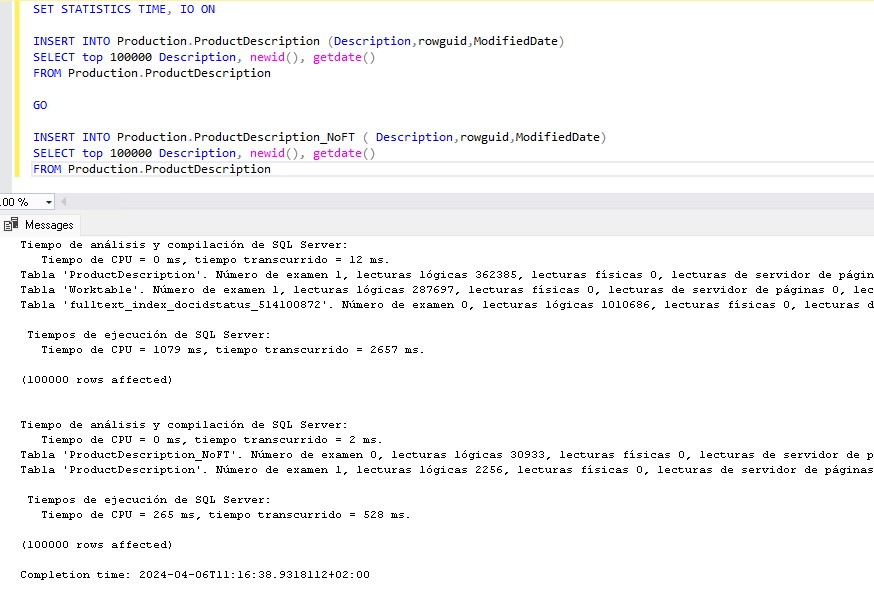
Ya hemos hablado en varias ocasiones de esto pero no está de más recordarlo, los índices en SQL “no son gratis” y por no son gratis me refiero a que hay un precio a pagar por toda esta mejora de rendimiento en las lecturas. En concreto el precio a pagar es un gran empeoramiento de las escrituras. Para verificar hasta dónde es negativo este impacto en las escrituras he creado una tabla en mi SQL Server con la misma estructura que con la que estamos haciendo la prueba y con los mismos datos pero sin el índice de texto completo. Si que tiene el resto de los índices que tiene la tabla original (PK + Nonclustered). A continuación he insertado en las dos tablas los mismos 100.000 registros para medir los tiempos. 

FullText_Performance3

Como podéis ver en la imagen, el resultado de la inserción en la tabla sín índice FullText ha tardado 225 milisegundos frente a 1079 milisegundos en la tabla que tiene índice de texto completo. En cuanto a la información que se ha necesitado leer para hacer la inserción encontramos que para insertar en la tabla con FullText hemos tenido que leer 12,6 Gb de información mientras que para la que no tiene ese índice solo hemos tenido que leer 259,2 Mb.

Conclusión

Los índices de texto completo o FullText pueden ser un gran aliado en las consultas de lecturas, no tanto en las escrituras, donde nos pueden llegar a dar verdaderos problemas de rendimiento. Además, al contrario que en los índices normales donde su creación es transparente, para aprovechar la mejora de un índice FullText tendremos que adaptar nuestro código y usar las cláusulas específicas que usarán el índice. 

Espero que esta serie de artículos te haya ayudado a comprender mejor los índices de texto completo y a poder analizar si son o no beneficiosos para tus escenarios de uso actuales y futuros. Como siempre, te animo a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios

Creando y manteniendo índices FullText

Continuamos con el tema de ayer sobre los índices de texto completo y hoy vamos a centrarnos en aspectos más prácticos. Si aún no has leído el artículo introductorio de ayer sobre los índices FullText te recomiendo que lo hagas antes de seguir con este para saber de lo que estamos hablando. Si ya leíste vamos a hacer un pequeño resumen para reforzar los conceptos clave. Los índices de texto completo o FullText son unos índices especiales que nos ayudarán en nuestras búsquedas sobre columnas con gran cantidad de texto. Además, tienen la particularidad de que se organizan en catálogos, aspecto clave para su creación y futuro mantenimiento.

Requisitos para crear un índice FullText

Para crear los índices FullText lo primero que necesitaremos será tener instalada la característica de SQL con la que trabajan, no tiene pérdida se llama FullText o Texto Completo dependiendo del idioma de nuestro instalador. Una vez instalada tenemos que asegurarnos de tener corriendo el servicio para la extracción de texto completo, tampoco tiene pérdida y lo localizaremos por su nombre rápidamente junto con el resto de servicios en el administrador de configuración de SQL Server. 

Una vez estemos seguros de que el servicio está instalado y en ejecución podremos proceder con la creación del catálogo que, recordad que es requisito imprescindible para este tipo de índices. Para crear el catálogo usaremos la sintaxis siguiente sintaxis: 

Para ver los catálogos existentes podemos hacerlo en SSMS, desplegando la carpeta almacenamiento dentro de la base de datos o con la siguiente consulta:

FullText_Catalog

Creación de índices FullText

Una vez que cumplamos con los requisitos anteriores estaremos ya preparados para crear nuestro índice FullText. Tenemos que saber que podemos crear índices de texto completo tanto en tablas como en vistas indexadas pero solo uno por tabla (o vista). El índice de cada tabla podrá contener hasta 1024 columnas. La sintaxis de creación es la siguiente:

No voy a entrar en todas las opciones de creación de un índice FullText, para eso podéis consultar la documentación oficial aquí. Nos vamos a centrar en las más importantes. Como veis es parecido a la sintaxis de creación de índices que todos conocemos. Especificaremos la tabla sobre la que crearlo y las columnas que incluirá. Como opción podemos definir el idioma del texto de esas columnas para las búsquedas, si no lo especificamos se usará el idioma por defecto de la instancia. Esto es importante si tenéis el servidor en inglés pero los datos en español, por ejemplo. Esta opción de language admite tanto el alias como el lcid de los idiomas de la vista del sistema sys.syslanguages.

Otro de los aspectos clave y que es obligatorio es definir un índice de referencia con la clave para nuestro nuevo índice FullText. Debe ser una clave única que no admita valores nulos. Para un mejor rendimiento se recomienda que sea un identificador único numérico. También debemos definir el catálogo sobre el que se creará el índice. Si no definimos el catálogo se usará el por defecto y si no hay uno por defecto veremos un bonito error, así que, aseguraos de definirlo bien.

Para terminar con esta sección de creación e índices FullText es importante destacar la opción de Change_Tracking que definirá la propagación de nuestro índice. Esto significa que define el comportamiento cuando hay una modificación de la tabla (Insert, Update o Delete). Por defecto está en modo AUTO y los cambios se propagan de la tabla al índice FullText en tiempo real pero podemos definirlo en modo manual y que solo se propaguen con una sentencia SQL que ejecutaremos a voluntad o programaremos en un job. La sentencia para propagar los cambios de la tabla al índice es:

Palabras irrelevantes

Como podéis imaginar, indexar todo un texto puede suponer unos requisitos de espacio tremendos, para evitar esto en la medida de lo posible SQL Server implementa lo que se llaman las palabras irrelevantes y las listas de palabras irrelevantes (stopword y stoplist). Si os habéis fijado antes, a la hora de crear un índice FullText podíamos definir una de estas stoplist.

Palabras irrelevantes

Una palabra irrelevante puede ser por ejemplo un código que guardamos pero que no se usa o palabras que sí tienen significado lingüístico pero que no son relevantes para las búsquedas como podrían ser preposiciones y otras. Por ejemplo en español no puede que no queramos indexar las palabras “un”, “y”, “el”, «de «, «hasta «, etc.

Listas de palabras irrelevantes

Para poder gestionar las palabras irrelevantes SQL Server usa unos objetos que se llaman lista de palabras irrelevantes o stoplists. Podemos encontrarlos desplegando la carpeta almacenamiento dentro de la base de datos (mirad en la imagen de antes). Para crear nuestras propias stoplists podemos hacerlo desde este apartado de SSMS o con la sintaxis CREATE FULLTEXT STOPLIST.

Mantenimiento de índices FullText 

Como ya adelantamos en el artículo de ayer, el mantenimiento de los índices FullText se realiza sobre los catálogos. Para ello podemos hacerlo desde el SSMS haciendo click derecho sobre el catálogo y dando a Rebuild o por T-SQL. Si lo hacemos por T-SQL tendremos la posibilidad de reorganizar los índices sin necesidad de reconstruirlos. Si optamos por un REBUILD se borrarán todos los índices del catálogo y se volverán a crear eliminando así la fragmentación. Puede ser que solo queramos hacer el mantenimiento a un índice, en este caso podemos borrarlo y crearlo de nuevo manualmente. La sintaxis para hacer el mantenimiento de un catálogo es:

Si os fijáis, con esta instrucción podríamos también definir este catálogo como el por defecto.

Conclusión

Hoy hemos aprendido cómo podremos lidiar con los FullText índices como DBAs, esto sumado a lo que vimos ayer y a lo que veremos en el próximo artículo sobre su uso es todo lo que necesitamos para controlar este tema. Si queréis profundizar más en detalle os recomiendo bucear por la documentación oficial que os he compartido y por todas las demás páginas de Microsoft sobre los índices de texto completo. A mi me parece un mundo apasionante y del que poca gente conoce todos los detalles. ¿Quién sabe? Igual algún día tener estos conocimientos puede marcar la diferencia para el trabajo de vuestros sueños.

Espero que este artículo te haya proporcionado una visión profunda de los índices FullText o de texto completo en SQL Server. Como siempre, te animo a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios