Rendimiento

Índices de texto completo (Full-Text Indexes)

Volvemos a la carga con un artículo sobre índices, uno de los temas más importantes para el rendimiento de nuestras bases de datos y por ello sobre lo que más contenido tenemos en el blog. Si no has visto los artículos anteriores los tienes todos aquí. A estas alturas no es una sorpresa para nadie que diga que los índices son nuestros mejores aliados para optimizar las consultas y mejorar el rendimiento. Hoy, vamos a sumergirnos en el fascinante mundo de los índices de texto completo o Full-Text index en SQL Server. Este tipo de índice especial y no tan conocido en SQL Server nos va a permitir buscar en grandes cadenas de texto que, sin estos índices siempre es peor que un dolor de muelas.

¿Qué son los Índices de Texto Completo?

Los índices de texto completo son un tipo especial de índice de SQL Server que nos proporciona una solución eficaz para buscar palabras y frases dentro de una gran cantidad de datos de texto en SQL Server. A diferencia de los índices tradicionales, que se basan en la comparación de valores, los índices de texto completo nos permiten realizar búsquedas complejas en textos largos y no estructurados.

Creación de Índices de Texto Completo

Crear un índice de texto completo en SQL Server es un proceso sencillo. Primero, necesitamos una columna con un tipo de datos de texto. Luego, antes de poder crear en índice necesitaremos un catálogo de texto completo. Una vez creado el catálogo podremos crear nuestros índices de texto completo en sí. 

La creación de catálogos es un aspecto fundamental para los índices de texto completo y de cómo los estructuremos ya que nos va a permitir organizarlos y va a afectar al rendimiento futuro de nuestras tareas de mantenimiento.

Uso de Índices de Texto Completo

Una vez creado el índice de texto completo, podemos utilizar la cláusula CONTAINS en nuestras consultas para buscar palabras o frases específicas. También podemos usar la cláusula FREETEXT para realizar búsquedas más generales.

Desventajas de los Índices de Texto Completo

Los índices de texto completo en SQL Server son una herramienta poderosa, pero como cualquier tecnología, tienen sus limitaciones y desventajas. Aquí vamos a nombrar algunas de las más importantes:

Espacio Adicional

Los índices de texto completo ocupan espacio adicional en el disco. Esto puede ser significativo en bases de datos con muchas tablas grandes y varios índices creados. Por lo tanto, es importante considerar el equilibrio entre el rendimiento de la consulta y el uso del espacio en disco.

Rellenado de Índices

El proceso para crear y mantener un índice de texto completo se denomina rellenado (o rastreo). Hay tres tipos de rellenado de índice de texto completo: rellenado completo, rellenado basado en el seguimiento de cambios, y rellenado incremental basado en una marca de tiempo. Este proceso puede ser costoso en términos de recursos y tiempo, especialmente para bases de datos grandes.

Mantenimiento de Índices de Texto Completo

Como cualquier otro índice, los índices de texto completo requieren un mantenimiento regular para garantizar su eficiencia. SQL Server proporciona varias herramientas y técnicas para ayudarnos en esta tarea. Al igual que en el resto de tipos de índices estas son REORGANIZE y REBUILD. Sin embargo, en el caso particular de estos índices las tareas de mantenimiento se realizan sobre el catálogo afectando a todos los índices incluidos y no se puede hacer sobre un único índice a petición. Siempre nos queda la opción de eliminar el índice y volverlo a crear pero no parece una opción aceptable. Por si esto fuera poco es un proceso que no está incluido en las principales soluciones de mantenimiento como OLA Hallengren.

Recomendaciones de rendimiento

Como acabamos de mencionar, optimizar el rendimiento de los índices de texto completo en SQL Server puede ser un desafío. Vamos a ver las mejores recomendaciones que pueden ayudarnos:

Arquitectura y Mantenimiento

Es una buena idea limitar la selección de columnas de clave de texto completo a una columna pequeña. Aunque se admite una columna de 900 bytes, se recomienda usar una columna de clave menor en un índice de texto completo, int y bigint ofrecen el mejor rendimiento.

Podremos reorganizar el catálogo de texto completo utilizando ALTER FULLTEXT CATALOG REORGANIZE. Esto debe hacerse antes de realizar pruebas de rendimiento, ya que la ejecución de esta instrucción produce una mezcla maestra de los índices de texto completo del catálogo.

Uso y consultas

Siempre es mejor combinar varios predicados CONTAINS en un predicado CONTAINS. En SQL Server puedes especificar una lista de columnas en la consulta CONTAINS.

Si solo necesitas información de clave de texto completo o de clasificación, usa CONTAINSTABLE o FREETEXTTABLE en lugar de CONTAINS o FREETEXT, respectivamente.

Para limitar los resultados y aumentar el rendimiento, usaremos el parámetro top_n_by_rank de las funciones CONTAINSTABLE y FREETEXTTABLE top_n_by_rank permite volver a recuperar solo las coincidencias más pertinentes.

Comprobar el Plan de Consultas

Y como siempre, deberemos comprobar constantemente el plan de consultas de texto completo para asegurarnos de que se selecciona el plan de combinaciones adecuado. Usaremos una sugerencia de consulta o forzaremos un plan de ejecución en Query Store si es necesario.

Conclusión

Los índices de texto completo son una herramienta potentísima en SQL Server que nos permite realizar búsquedas eficientes en grandes volúmenes de datos de texto. Aunque su creación y mantenimiento pueden requerir un poco de esfuerzo adicional, los beneficios que aportan en términos de rendimiento y flexibilidad de las consultas valen la pena.

Esperamos que este artículo te haya proporcionado una visión profunda de los índices de texto completo en SQL Server. Como siempre, te animamos a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 3 comentarios

VLF: Entendiendo el Log de SQL Server nivel pro

En nuestra constante búsqueda de optimización y eficiencia en el manejo de bases de datos, nos encontramos con una pieza clave en el rompecabezas de SQL Server: los Virtual Log Files (VLF). Estos componentes, aunque pequeños y a menudo pasados por alto, son fundamentales para el rendimiento y la gestión de nuestras bases de datos. Hoy, nos sumergimos en el mundo de los VLF para entender su función y cómo una gestión adecuada puede marcar la diferencia en nuestro trabajo diario como DBAs. Referenciando nuestro artículo anterior ¿Cómo funcionan los ficheros de Log de SQL Server?, podemos recordar que el log de transacciones juega un papel vital en la recuperación de datos y, los VLFs, como parte fundamental de los logs, tienen la misma importancia.

¿Qué son los VLF y por qué son importantes?

Los VLF son segmentos virtuales en los que se divide el archivo de log de transacciones de una base de datos en SQL Server. Es decir, SQL Server no trabaja con el fichero de log completo sino con pequeñas particiones del mismo. Cada vez que se crea o se expande un log, SQL Server lo divide en varios VLFs. La cantidad y el tamaño de estos VLF pueden tener un impacto significativo en el rendimiento de la base de datos, especialmente durante operaciones de recuperación y respaldo. En casos extremos, si tenemos el log muy particionado puede afectarnos también al rendimiento de nuestras transacciones. 

Gestión Efectiva de VLF

Para mantener un sistema saludable, es crucial gestionar adecuadamente los VLF. Un número excesivo de VLF pequeños puede causar lentitud en el proceso de recuperación de la base de datos, mientras que muy pocos VLF grandes pueden dificultar el proceso de respaldo. Por ello, encontrar el equilibrio correcto es esencial. Los VLF son los bloques de construcción de este log, y su gestión eficiente permite una recuperación más rápida y una mejor disponibilidad de la base de datos.

Una estrategia efectiva para la gestión de VLF implica monitorear su cantidad y tamaño regularmente. SQL Server proporciona herramientas que nos permiten visualizar y ajustar estos parámetros, como el deprecado comando DBCC LOGINFO o su nueva versión, la función sys.dm_db_log_info. Además, prácticas como el truncamiento regular del log y la expansión controlada del archivo de log ayudan a mantener un número óptimo de VLF.

Creación de VLFs

Hemos visto que el motor de SQL Server crea automáticamente los VLFs durante el crecimiento de los ficheros de logs, sin embargo, esto no significa que nosotros no podamos influir sobre ello. Simplemente tendremos que conocer qué reglas sigue SQL para crear VLFs para adaptarnos a ello. Antes de nada tenemos que especificar que las reglas de creación de VLFs han cambiado con SQL 2022 por lo que tanto para esta versión como para Azure tendremos que tenerlo en cuenta. Veamos cómo se crean los VLFs:

  • Cuando el crecimiento del archivo de log es menor a 64 Mb SQL creará 4 VLFs en versiones antiguas y solo 1 VLF en SQL 2022 y en Azure.
  • Si el crecimiento del archivo de log es igual o mayor a 64 Mb pero menor a 1 Gb se crearán 8 VLFs.
  • Si el crecimiento del archivo de log es igual o mayor a 1Gb se crearán 16 VLFs.

Cuantos VLFs tienen mis logs

Ya sabemos cómo se crean los VLFs y por qué podemos llegar a tener muchos en nuestros mecheros de logs pero, no os he dicho aún cómo comprobar en vuestras bases de datos cuantos VLFs teneis. Para ello usaremos el siguiente script. Y ahora la pregunta clave, ¿Cuántos VLF debería tener? La respuesta es depende, no hay una respuesta universal a esta pregunta. Personalmente creo que sobre 50 es una buena cifra pero dependerá en gran medida del tamaño del fichero de log. 

Hora de hacer números y corregir los VLF

Supongamos que nuestra base de datos tiene un log de 20Gb y hemos visto que por alguna mala práctica del pasado tenemos muchos VLF. Lo primero que tendremos que hacer es un shrink para reducir el log lo máximo posible. Una vez con el log en su tamaño mínimo vamos a volver a dimensionarlo a sus 20Gb originales pero siguiendo las buenas prácticas de VLF. Vamos a crear un número de VLF cercano a 50. Para ello no podemos dimensionar directamente en 20Gb porque solo nos crearía 16 VLF y serían muy grandes para ser administrados por SQL de manera óptima. Qué pasa si aumentamos 8 Gb iniciales, luego otros 8 y terminamos con un crecimiento de 4 Gb. Esto serían 3 crecimientos del fichero superiores a 1 Gb por lo que se nos crearían 16 VLF en cada “salto”, 16*3=48. Parece bastante razonable. Ahora, si el fichero puede necesitar crecer en un futuro, podría ser interesante hacer 3 crecimientos de 8 Gb lo que nos daría 24 Gb de log repartidos igualmente en 48 VLF (unos ficheros de 512 Mb cada uno, algo asumible).

Conclusión

La gestión de VLF no es solo una tarea de mantenimiento; es una oportunidad para maximizar el rendimiento de nuestras bases de datos. Al comprender la importancia de estos elementos y aplicar prácticas de gestión efectivas, podemos asegurar un sistema robusto y ágil. Los VLF son, sin duda, pequeños gigantes en el mundo de SQL Server, y su correcta administración está reservada a unos pocos DBAs expertos con gran pericia técnica, como vosotros ahora.

Espero que este artículo te haya sido útil. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios

Solución a problemas de Parameter Sniffing

Seguimos con el tema de ayer sobre el Parameter Sniffing en SQL Server y, como prometimos, vamos a ver cómo podemos hacer para controlarlo y beneficiarnos de ello minimizando sus inconvenientes. Es este, por tanto, una segunda parte del artículo de ayer que os recomiendo encarecidamente leer antes de continuar con este. Como ya sabemos, si la distribución de nuestros datos es relativamente equitativa, un reaprovechamiento del plan de ejecución de una consulta será muy beneficioso para el rendimiento. De lo contrario, si la distribución de datos tiene gran variación, reutilizar un plan hará que este no sea el óptimo para esa ocasión. 

¿Es malo el parameter sniffing?

Empecemos por el principio, la pregunta que todos os estáis haciendo ¿es malo el parameter sniffing para el rendimiento? Para mi la respuesta es no, aun con todos sus inconvenientes, conociendo su comportamiento podremos beneficiarnos en gran medida de ello. En la mayoría de escenarios OLTP, el comportamiento normal del parameter sniffing mejora el rendimiento de las consultas. Para los escenarios en los que nos encontramos con inconvenientes, normalmente será en algún procedimiento almacenado y no todos y, por suerte, tenemos varias alternativas para solventar el problema.

Identificando el problema del parameter sniffing

El primer paso cuando tenemos un problema es reconocerlo y en esta ocasión será sencillo. Si no tenemos habilitado la parametrización forzada bastará con ejecutar nuestra consulta fuera del procedimiento almacenado para comparar los planes. En otras ocasiones los usuarios nos darán pistas sin quererlo, como cuando unos clientes me decían que tras reiniciar el servidor el procedimiento volvía a funcionar. Reiniciar, por si solo no resuelve nada y si no somos capaces de saber que provocaba el problema antes del reinicio nos volveremos a encontrar en esa misma situación antes o después. Pero esta discusión es para otra ocasión, volvamos a mi anécdota. 

Lo que les pasaba a mis clientes es que si la primera ejecución del plan de la caché era con un parámetro con un volumen de datos muy inferior a la media, el plan cacheado iba a ir mal para todas las siguientes ejecuciones. Como la caché de SQL se vacía al reiniciar y ellos estaban esperando el reinicio para ejecutar el SP con los parámetros que antes daban problemas ya se almacenaba en caché el plan correcto y todo iba bien hasta que por presión de memoria ese plan se borraba y la siguiente ejecución era de un parámetro distinto.

Soluciones al problema del parameter sniffing

Bien, sabemos que el causante de nuestro problema de rendimiento es un problema de parameter sniffing. Ahora tenemos que solucionarlo. Para ello os voy a proponer distintas soluciones.

No cambiar nada

Sabemos lo que está pasando y que es el comportamiento natural de SQL Server, expliquemos todo esto a nuestros usuarios y que se conformen con el resultado. No va a funcionar, ¿verdad?. Habéis soltado una carcajada al leerlo que se ha oído en la luna, que os conozco. Los usuarios de SQL necesitan sus datos y los necesitan rápido y por mucho que nosotros les contemos no se van a conformar. Y están en su derecho así que descartemos este punto y vayamos a por los siguientes. 

Pasa el marrón a otro

La siguiente solución que tengo que poner, pero que, al igual que la anterior, tampoco os recomiendo es pasar la pelota al equipo que desarrolla el código del procedimiento. Podríais explicarles lo que está pasando y que creen un SP distinto para cada parámetro. Como os digo esto es una mala idea, malísima en realidad. Acaba completamente con todas las ventajas de un procedimiento almacenado y ni hablar de si problema si es causado por tener activada la parametrización forzada. Descartemos este punto también por favor.

Actualiza tu SQL

Ya comentamos ayer que el las últimas versiones de SQL Server (a partir de 2019) entran en juego los planes de ejecución con joins adaptativos lo que nos permitirá que pasadas unas ejecuciones se persistirá un plan dinámico en caché con varias alternativas en función de los parámetros. Esto es un avance, sin embargo, aún no lo veo una solución pues necesitas de varias ejecuciones lentas para que SQL se de cuenta de lo que pasa y en un entorno con gran cantidad de consultas donde los planes en caché no duran tanto como nos gustaría puede no ser una solución.

Recompilaciones del procedimiento

En este punto, ya hemos descartado no hacer nada y también crear varios procedimientos almacenados, veamos cómo podemos hacer para que nuestro procedimiento problemático rinda como debería. Una de estas soluciones es crear el procedimiento para que no haga uso de los planes en caché y recompile siempre el plan de ejecución. Esto lo haremos en la declaración del procedimiento con la sugerencia de procedimiento almacenado RECOMPILE. Por ejemplo: 

Con esa simple sugerencia conseguiremos que los planes de ejecución de todas las consultas del procedimiento almacenado se recopilen antes de la ejecución, lo que nos supondrá un mayor coste de CPU pero nos garantizará un plan óptimo. Si es uno o unos pocos procedimientos en los que tenemos problemas al final compensa.

Recompilaciones de las consultas

Si el problema lo estamos teniendo fuera de un procedimiento almacenado por tener habilitada la parametrización forzada o si queremos hilar más fino porque sabemos que solo una de las muchas consultas de un procedimiento es la que tiene problemas podemos hilar más fino y aplicar la sugerencia RECOMPILE a nivel de consulta. Por ejemplo 

En este ejemplo tenemos dos consultas, un select y un insert, sin embargo solo recopilaremos el plan de ejecución de la primera.

Optimizado para valor

Otra de las opciones que tenemos a nivel de consulta es utilizar una sugerencia que indique que calcule el plan de ejecución para un valor concreto y no para el que se pase como parámetro de nuestro SP. En algunas ocasiones puede ser una solución pero a mi no me gusta porque genera planes ultra dimensionados cuando no son necesarios y requiere mucho mantenimiento a medida que los datos cambian. Si recordáis el ejemplo del almacén que vimos ayer es como si desplegamos todos los recursos necesarios para mover maquinaria industrial pesada para al final realmente mover un clavo. Aun así os dejo un ejemplo de cómo sería:

Conclusión

Aunque siempre digo que no debemos influir sobre el comportamiento normal de SQL Server en estos casos siempre hago una excepción. Nosotros conocemos nuestros datos (o deberíamos) y cuando el parameter sniffing no termine de adaptarse a nuestras necesidades no debemos tener miedo de actuar. Usa todas las herramientas que SQL pone a nuestra disposición y anticipate a las llamadas de usuarios descontentos, Query Store tiene una vista de consultas recursivas que nos mostrará estos casos de una manera muy cómoda. Añade tus sugerencias de consulta o procedimientos y no dejes que nada frene tus consultas.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Otros, Rendimiento, SQL Server, 0 comentarios

Parameter Sniffing, ¿aliado o enemigo del rendimiento?

Vamos a pasar el mal trago de ayer con los índices de SQL Server que nos perjudicaban el rendimiento y vamos a ver un aspecto que sí podemos controlar nosotros directamente. Mucho hemos hablado de los índices ya en el blog, y también de que SQL Server hace uso de las estadísticas de las tablas para decidir el plan de ejecución más óptimo. Sin embargo no habíamos profundizado en cómo funciona esto y no, no es por arte de magia. SQL Server va a hacer lo que se conoce como parameter sniffing.

El motor de bases de datos de SQL Server utiliza el parameter sniffing para hacerse una idea del volumen de datos de cada una de las tablas que intervienen en nuestras consultas (con los filtros ya aplicados) y así tomar las mejores decisiones. Como habrás adivinado, el parameter sniffing, más allá del tecnicismo (que quedará muy bien si lo soltamos en mitad de una conversación técnica), es una de las claves para el rendimiento de las consultas en SQL Server.

Planes de ejecución de consulta

Lo primero que tenemos que entender es como SQL calcula los planes de ejecución y para ellos, vamos a intentar llevarlo a algo que todos podamos imaginar, así será fácil de entender. Imagina que trabajas de encargado de almacén y tienes que gestionar el trabajo de los mozos del almacén. Te han encargado la tarea de mover todo el stock de unos determinados productos a otro almacén de la compañía. Entre los distintos productos que tienes que mover hay desde tornillos hasta maquinaria industrial. Para poder asignar recursos a las distintas tareas, tendrás que saber cuántos artículos de cada cosa debes mover y cuáles son sus pesos, ¿verdad?. Pues en SQL Server pasa lo mismo, cuando nosotros le pedimos que nos de unos datos, necesita conocer cuántos registros van a ser y cuanto ocupan para poder hacer una asignación correcta de recursos.

Parameter Sniffing en acción

Como podéis imaginar, calcular el plan tiene un coste y es por esto que SQL cachea esos planes para poder reutilizarlos. Esto es realmente útil cuando las consultas se repiten siempre igual pero, ¿qué pasa si cambian? Almacenaremos gran cantidad de planes y muchos serán iguales. Para eso existen los procedimientos almacenados, fragmentos de código que SQL almacena como un objeto, donde las variables están parametrizadas para que nosotros podamos definirlas en cada ejecución. En estas situaciones el plan de ejecución es siempre el mismo porque la consulta es siempre la misma sea cual sea el valor que le pongamos en los filtros. Esto podemos forzarlo para las consultas ad hoc con la opinión parametrización forzada de SQL Server de la que ya hablamos en profundidad aquí. 

En estas situaciones SQL Server analizará el volumen de datos que coinciden con ese parámetro y lo usará para generar un plan de ejecución que se utilizará en todas las consultas siguientes. A este procedimiento interno de SQL Server se le conoce como Parameter Sniffing y reduce mucho los tiempos de ejecución cuando tenemos una distribución equitativa de los datos. Es decir, los registros pesan más o menos lo mismo sea cual sea el valor. 

Los problemas de Parameter Sniffing

Como hemos visto el parameter sniffing reduce mucha carga de compilación de los planes de ejecución en consultas con una distribución de datos similar pero, ¿Qué pasa si no es así? Volviendo a nuestro ejemplo anterior, ¿asignaremos los mismos recursos para mover un clavo que para mover una máquina de varias toneladas? Obviamente no, y esto es un problema (o lo era). SQL Server asignará los recursos a la consulta en función del plan de ejecución que tiene almacenado y este se habrá calculado en base a los resultados de la primera ejecución de la consulta. Al menos, históricamente siempre ha sido así. En Microsoft conocedores de este problema, implementaron en SQL 2019 una optimización en el procedimiento de parameter sniffing y en los planes de ejecución añadiendo los adaptative joins. 

Parameter Sniffing a partir de SQL 2019

En las últimas versiones de SQL Server (2019 y 2022), lo que se hace es compilar el plan de ejecución de varias ejecuciones de la consulta. Si el resultado de estas primeras compilaciones es siempre el mismo plan, se cacheará ese y el comportamiento será el de siempre, pero, si los planes cambian, se almacenará un plan con un join adaptativo que permitirá aplicar un plan u otro en función de los parámetros de la consulta.

Parameter Sniffing caso práctico

Vamos a ver esto en la práctica que con ejemplos es como mejor se quedan las cosas. Para ello vamos a usar la base de datos de demo AdventureWorks.

Si os fijáis, en esta primera imagen, la consulta es la misma y solo cambia el valor que le pasamos al filtro. Solo con eso, dada la cardinalidad de la consulta, vemos como el motor de base de datos calcula un plan de ejecución distinto para cada una de ellas.

Vamos a probar ahora a crear el siguiente procedimiento almacenado, como veis es la misma consulta de la imagen de antes pero hecha procedimiento almacenado.

Con el procedimiento creado mirad lo que pasa. Calcula el plan de ejecución en base al primero de los parámetros y ese es el plan de ejecución que se queda para siempre.

Conclusión

Hoy hemos podido aproximarnos más a cómo SQL usa las estadísticas de las tablas para calcular los planes de ejecución y cómo se comporta cuando usamos consultas parametrizadas. Hemos entendido las ventajas y los inconvenientes del parameter sniffing y lo hemos podido ver en un ejemplo práctico. Dejamos para mañana ver cómo, nosotros como DBAs, podemos influir sobre ello y sacarle todo el partido.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios
Un índice que no se usa perjudica el rendimiento de los select

Un índice que no se usa perjudica el rendimiento de los select

¿Alguna vez os han dicho que un índice que no se usa empeora el rendimiento de una consulta SELECT? Todos hemos oído que los índices penalizan la escritura y eso es cierto como que odio madrugar para trabajar pero, las lecturas no se ven afectadas, ¿verdad? ¿Estáis seguros? Recientemente recibí en mi bandeja de entrada el último boletín de la newsletter de SQLAuthority sobre un extraño comportamiento con los índices en SQL Server y me ha parecido tan interesante que he sentido la necesidad de compartirlo con vosotros. Aunque, como os digo, la idea detrás de este post no es mía y es plenamente de Pinal Dave me voy a tomar la libertad de traducirlo y compartirlo con vosotros.

Introducción

Este email que activó mi sentido arácnido:

Hi there,
Have you ever seen that Index which is not used for the query reduces the performance of the SELECT statement?
If yes, good, you can stop reading this email here.
If no, here is the video you MUST WATCH 
That’s it! Have a good day.
~ Pinal from SQL Authority

Cuando lo he leído no me lo podía creer, ¿cómo un índice que no se usa puede empeorar el rendimiento de una consulta de lectura? Sabemos que los índices empeoran los procesos de escritura pero, es justamente porque se usan y se escribe en ellos además de en la tabla. Pero en las lecturas no, eso no es lo que dicen los libros de SQL. Sin embargo, de Pinal me fio completamente (ha demostrado sobradamente saber mucho de esto) así que he ido al video y en efecto, en él demuestra empíricamente lo que dice en el correo.

Tan atónito estaba al terminar los doce minutos de demo de Pinal que he ido raudo a comprobarlo en mi propio servidor de pruebas. En el video, Pinal usa la base de datos AdventureWorks2014 y en las respuestas a los comentarios dice haberlo probado tanto con modo de compatibilidad 2017 como 2019. En mi laboratorio de pruebas yo tengo un 2022 así que perfecto vamos a ver que pasa.

Consulta sin índice

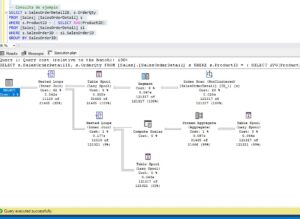
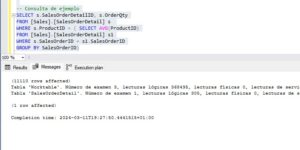
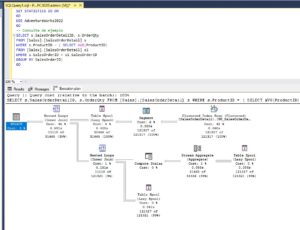
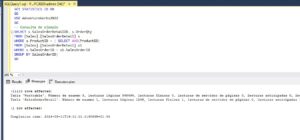
Ejecutamos la consulta sobre la tabla, sin haber creado ningún índice vemos que hace un escaneo de la PK que supone el 42% de la consulta. En cuanto a lecturas, si miramos los mensajes de las estadísticas de E/S vemos que se está leyendo 1238 páginas de disco de 8 Kb, lo que son aproximadamente 10 Mb de datos. Sin embargo para leer esos 10Mb de datos, necesita una tabla auxiliar de la que lee 368.495 páginas o lo que es lo mismo 2,8 Gb de información.

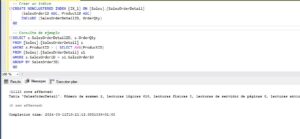
Creemos un índice

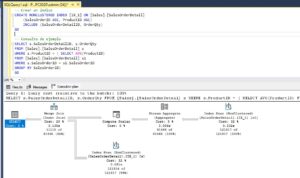
Obviamente este rendimiento no es el esperado, leer casi 3 Gb de información para devolver 10 Mb, no sé a vosotros, pero a mi no me parece correcto. Así que creemos un índice llamado IX_1 tal como aprendimos en este otro post y probemos. Vale, tenemos dos lecturas de la tabla y eso no es lo mejor, pero tampoco es un problema. Mirad las estadísticas, tenemos simplemente 610 páginas leídas o lo que es lo mismo, 5Mb de información. 

Creando otro índice

Un caso de uso normal sería ahora crear otro índice invirtiendo el orden de los campos clave para verificar si el rendimiento mejora o no. Sin embargo, al hacerlo, nos vamos a encontrar con la sorpresa que da título a este post. No solo la consulta sigue usando el primero de los índices sino que han vuelto los Table Spool y aunque las páginas leidas de la tabla han bajado a la mitad que antes, tenemos otra vez esos casi 3 Gb de lecturas de la tabla de trabajo. 

Otras pruebas

No os voy a aburrir con más capturas de pantalla, creo que ya lo habéis pillado. Deciros que lo he probado en todos los niveles de compatibilidad posibles de una base de datos desde SQL 2014 hasta 2022 y el resultado ha sido idéntico. 

También he probado con actualizaciones de las estadísticas de la tabla, borrando la caché de planes de ejecución entre las pruebas, con el hint de index para forzarle el uso del índice en las dos ejecuciones y con un hint de RECOMPILE. Todo con el mismo resultado. Para terminar he cambiado la consulta y he usado un join en vez de la subquery pero nada, en todos los casos aparecían esas lecturas al tener el segundo índice creado aunque en el plan de ejecución no aparezca en uso por ningún lado y al borrarlo volvía a los dos escaneos sin lecturas de tablas auxiliares. 

Os diré más, en este punto con ya el artículo escrito se me ha ocurrido una cosa, he borrado el índice 2, he ejecutado la consulta que se ha ejecutado con el plan correcto, he ido a Query Store y he forzado ese plan, luego he creado el índice y, ¿sabéis que? LO HA VUELTO A HACER MAL. Si amigos, incluso forzando en Query Store el plan correcto, SQL me ha sacado el dedo y ha hecho lo peor para él, como un hijo adolescente que no entiende que miras por su bien.

Conclusiones

¿Y ahora que digo yo? ¿Qué conclusión sacamos de esto? Que lo que pone en los libros no es correcto? Igual es que SQL Server hace cosas sin sentido o que visto esto debería pasarme a Oracle? Lo cierto es que no he conseguido encontrar una explicación a lo que está pasando pero ahí está. En su video, Pinal llega al mismo punto, no entiende lo que pasa y obviamente no tiene sentido. Parece un bug del motor de base de datos sin resolver desde hace un montón de tiempo. Por mi parte seguiré probando esto en cada nueva versión de SQL Server y si veo que se resuelve espero poder avisaros por aquí. De momento, no nos queda otra, revisemos los índices de nuestras bases de datos y borremos los que no estén en uso por si nos están penalizando.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
PD.: Si alguno queréis ir a la fuente original os dejo el vídeo por aquí.

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios

Escalado vertical y horizontal en SQL Server y Azure

¿Qué es el escalado en SQL Server y por qué es importante? En este artículo vamos a explicar los conceptos de escalado vertical y horizontal, las diferencias entre ellos y las ventajas y desventajas de cada uno. También veremos cómo aplicar estas técnicas en SQL Server, tanto en la versión On Premise como en la nube de Azure.

¿Qué es el escalado vertical y horizontal?

El escalado es la capacidad de aumentar o disminuir los recursos de un sistema para adaptarse a las necesidades de rendimiento y disponibilidad. Existen dos tipos de escalado: vertical y horizontal.

– El escalado vertical consiste en incrementar o reducir la potencia de un único servidor, ya sea añadiendo o quitando memoria, CPU, disco o cualquier otro componente. Por ejemplo, si tenemos un servidor con 8 GB de RAM y lo ampliamos a 16 GB, estamos haciendo un escalado vertical.

– El escalado horizontal consiste en agregar o eliminar servidores al sistema, de forma que se distribuya la carga entre ellos. Por ejemplo, si tenemos un servidor con 8 GB de RAM y le añadimos otro igual, estamos haciendo un escalado horizontal.

Ventajas y desventajas del escalado vertical y horizontal

Cada tipo de escalado tiene sus pros y sus contras, que debemos tener en cuenta a la hora de elegir la mejor opción para nuestro sistema.

Escalado vertical

– Ventajas: Es más sencillo de implementar, ya que no requiere cambios en la arquitectura ni en el código de la aplicación. Además, al tener un único servidor, se evitan problemas de sincronización, consistencia y latencia entre los nodos.

– Desventajas: Tiene un límite físico, ya que no podemos aumentar indefinidamente los recursos de un servidor. También implica un mayor coste, ya que los componentes más potentes suelen ser más caros. Además, al tener un único punto de fallo (SPOF), se reduce la disponibilidad del sistema.

Escalado horizontal

– Ventajas: Permite un mayor crecimiento, ya que podemos agregar tantos servidores como necesitemos. También implica un menor coste, ya que podemos aprovechar servidores más económicos y estándar. Además, al tener varios nodos, se aumenta la disponibilidad y la tolerancia a fallos del sistema.

– Desventajas: Es más complejo de implementar, ya que requiere cambios en la arquitectura y en el código de la aplicación. Además, al tener varios servidores, se generan problemas de sincronización, consistencia y latencia entre los nodos.

¿Cómo escalar SQL Server On Premise?

Para escalar SQL Server On Premise tenemos varias opciones, dependiendo del tipo de escalado que queramos realizar.

Escalado vertical On Premise

Para hacer un escalado vertical On Premise debemos modificar el hardware del servidor donde está instalado SQL Server. Esto, en algunos casos, implica detener el servicio, cambiar los componentes y reiniciar el servidor. Estos problemas desaparecen, en gran medida, cuando hablamos de servidores virtuales. Algunas recomendaciones para hacer un buen escalado vertical son:

  • Elegir componentes compatibles con el servidor y con SQL Server. 
  • Prestar atención al licenciamiento, algunas ediciones y modos de licenciamiento de SQL Server tienen limitaciones en cuanto a CPU y RAM y si los superamos deberemos adquirir otra licencia.
  • Ajustar los parámetros de configuración de SQL Server según los nuevos recursos.
  • Realizar pruebas de rendimiento antes y después del cambio para verificar la mejora.

Escalado horizontal On Premise

Para hacer un escalado horizontal On Premise debemos agregar más servidores al sistema y distribuir la carga entre ellos. Esto implica crear una arquitectura distribuida, como un clúster, una réplica o una partición. Algunas recomendaciones para hacer un buen escalado horizontal son:

  • Elegir servidores con características similares al existente.
  • Configurar correctamente la redirección del tráfico entre los nodos.
  • Mantener la sincronización y la consistencia de los datos entre los nodos.

Las réplicas de solo lectura de los grupos de disponibilidad Always On son un ejemplo de este tipo de escalado. Añadiendo una réplica de solo lectura a nuestro grupo de disponibilidad podremos redirigir a ella las operaciones de lectura descargando de trabajo el nodo principal.

¿Cómo escalar SQL Server en Azure?

Para escalar SQL Server en Azure tenemos varias opciones, dependiendo del tipo de servicio que estemos usando.

Escalado vertical en Azure

Para hacer un escalado vertical en Azure debemos modificar el tamaño del servicio donde está alojado SQL Server. Esto implica cambiar el nivel de servicio o el plan de tarifa, lo que puede implicar un cambio de precio. Algunas ventajas de hacer un escalado vertical en Azure son:

  • No requiere detener el servicio ni reiniciar el servidor.
  • Se puede hacer desde el portal de Azure o mediante scripts.
  • Se puede automatizar según las métricas de rendimiento.
  • Valorar el apagado de los servicios cuando no están en uso para un menor coste. Esto es especialmente útil cuando hablamos de entornos de desarrollo y pruebas.

Mención especial en este apartado para las bases de datos de Azure en modo de licenciamiento sin servidor donde podremos adaptar los recursos según la carga de trabajo. Aumentando en horas punta y disminuyendo la cantidad de recursos en momentos de menos carga.

Otra opción muy interesante que se nos plantea en Azure son los grupos de recursos, podremos asignar un extra de recursos a un grupo con varios servicios para que los usen en caso de ser necesario. Esto nos permite no tener que sobredimensionar todos y cada uno de los servicios por separado y reducir costes. Si, por ejemplo, nuestra base de datos transaccional tiene su pico de trabajo por el día y la informacional por la noche podrán compartir un grupo de recursos.

Escalado horizontal en Azure

Para hacer un escalado horizontal en Azure debemos agregar más instancias al servicio donde está alojado SQL Server. Esto implica crear un balanceador de carga o un grupo de escalado, lo que puede implicar un cambio de precio. Además, en Azure podemos aprovechar las bases de datos elásticas, que son un tipo de servicio que permite escalar horizontalmente una base de datos SQL sin tener que gestionar los servidores ni la distribución de los datos. Las bases de datos elásticas se componen de un grupo de bases de datos que comparten recursos y se balancean automáticamente según la demanda. d.

Conclusión

El escalado es una técnica fundamental para optimizar el rendimiento y la disponibilidad de SQL Server, tanto en la versión On Premise como en la nube de Azure. Dependiendo de las necesidades y los recursos disponibles, podemos optar por un escalado vertical o horizontal, cada uno con sus ventajas y desventajas. Tienes que tener en cuenta que estos modos no son excluyentes, nuestra aplicación puede hacer uso de una base de datos de Azure por cliente, escalando horizontalmente con cada nuevo cliente y, a la vez, escalar verticalmente una base de datos cuando el volumen de datos o transacciones de un cliente lo requiera. Lo importante es elegir la opción más adecuada para nuestro sistema y realizar las pruebas necesarias para verificar la mejora.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 2 comentarios

Consejos para un buen modelo de datos

¿Te gustaría mejorar el rendimiento, la seguridad y la calidad de tus bases de datos en SQL Server? ¿Quieres conocer las mejores prácticas para un buen modelo de datos? Entonces este artículo es para ti. Vamos a explicar, cómo diseñar y optimizar tus modelos de datos, siguiendo las recomendaciones de los expertos. ¡Sigue leyendo!

¿Qué es el modelado de datos?

El modelado de datos es el proceso de definir la estructura, las relaciones y las restricciones de los datos que se almacenan en una base de datos. El modelado de datos tiene como objetivo crear un diseño lógico y físico que sea coherente, eficiente y fácil de mantener.

¿Por qué es importante?

El modelado de datos influye directamente en el rendimiento, la seguridad y la calidad de los datos por lo que es muy importante para nosotros. Un buen modelo de datos nos va a permitir, por ejemplo, reducir el espacio ocupado por los datos y mejorar el tiempo de respuesta de las consultas. No solo eso, a menor espacio mayor velocidad en las copias de seguridad y en los planes de mantenimiento, aspecto de vital importancia en entornos grandes y con pocas ventanas de mantenimiento. Además nos evitará la redundancia, la inconsistencia y la corrupción de los datos y facilitará el acceso, la manipulación y el análisis. ¿Necesitas más motivos? Porque esto no es todo, cumplir estas buenas prácticas no solo garantiza integridad, confidencialidad y disponibilidad de los datos, también va a simplificar el desarrollo, la documentación y la evolución de la base de datos.

Tipos de definición de modelos de datos

Antes de entrar en los modelos de datos más comunes, tenemos que ver la forma en la que los definimos. Atendiendo a esto, existen diferentes tipos según el nivel de abstracción y el grado de detalle que presentan. Los más comunes son:

  • Conceptual: representa los conceptos y las entidades del dominio del problema, así como sus atributos y relaciones. Este modelo es independiente de nuestro sistema gestor de base de datos (SGBD) y se suele expresar mediante diagramas entidad-relación (ER).
  • Lógico: especifica las tablas, las columnas, las claves y las restricciones que se van a implementar en la base de datos. Es un modelo dependiente del SGBD y se suele expresar mediante diagramas relacionales o notación SQL.
  • Físico: describe los detalles técnicos de cómo se almacenan y organizan los datos en el disco. Incluye aspectos como el tamaño, el tipo de dato, el índice, la partición o el formato de almacenamiento. Es un modelo específico del SGBD y se suele expresar mediante scripts SQL o herramientas gráficas.

Tipos de modelos de datos

Como hemos comentado antes, existen varios tipos de modelos de datos según las necesidades de cada sistema y no todos están pensados para bases de datos relacionales de las que nos gustan a nosotros.

Modelo relacional

El modelo relacional es el más usado y se basa en el concepto de tabla con filas y columnas que todos conocemos. Cada fila representa un registro o una entidad, y cada columna representa un atributo o una propiedad. Las tablas se relacionan entre sí mediante claves primarias y foráneas, que son valores únicos que identifican a cada registro. El modelo relacional permite realizar consultas complejas y garantiza la integridad y la consistencia de los datos. Este modelo es el usado por las bases de datos relacionales y se aconseja mantener las tablas por lo menos en la tercera forma normal.

Modelo dimensional

Es un modelo alternativo al relacional, que se usa principalmente para fines analíticos y de inteligencia de negocios. El modelo dimensional se basa en el concepto de cubo, que es una estructura multidimensional que contiene medidas y dimensiones. Las medidas son los valores numéricos que se quieren analizar, como ventas, ingresos o costes. Las dimensiones son los atributos que describen las medidas, como tiempo, producto o cliente. El modelo dimensional permite realizar análisis rápidos y flexibles sobre grandes volúmenes de datos sin embargo no es lo ideal para transacciones que buscan el detalle de un registro. Igual que para el modelo relacional la recomendación es llegar, al menos, a 3FN en estos casos es común quedarse en la segunda forma normal. Este tipo de modelo está quedando en desuso en favor de los siguientes que vamos a ver.

Modelo estrella 

Es una evolución del modelo dimensional, que se caracteriza por tener una tabla central llamada tabla de hechos, que contiene las medidas, y varias tablas periféricas llamadas dimensiones, que contienen los atributos. El modelo estrella tiene una estructura simple y eficiente, que facilita el acceso y la navegación por los datos de manera rápida cuando se desea hacer agregaciones y operaciones de consulta masiva. Por lo general encontraremos este modelo en Datamarts y DataWarehouses donde los datos provenientes de otros orígenes ya han sido clasificados y tratados mediante ETLs y esperan a ser usados en reportes de BI.

Modelo copo de nieve 

Pueden existir ocasiones en las que un modelo estrella se nos quede corto. En estas ocasiones, necesitaremos juntar varios modelos de estrellas mediante relaciones más o menos normalizadas, es decir, dividimos el modelo de estrella en subtablas para evitar la redundancia de datos. Esto se llama modelo copo de nieve y tiene una estructura más compleja y detallada, que reduce el espacio ocupado por los datos pero aumenta el número de tablas y las consultas necesarias.

Pasos para realizar un buen modelado de datos en SQL Server?

Ahora que ya sabemos que tipos de modelo existen y cómo definirlos vamos a ver los pasos necesarios para diseñar un buen modelo de datos:

  1. Analizar los requisitos del negocio y del usuario, identificando las entidades, los atributos y las relaciones que se necesitan representar en la base de datos.
  2. Diseñar el modelo conceptual, utilizando diagramas ER o herramientas CASE (Computer-Aided Software Engineering).
  3. Normalizar el modelo conceptual, aplicando las reglas de normalización para eliminar las anomalías y las dependencias funcionales.
  4. Diseñar el modelo lógico, traduciendo las entidades y relaciones del modelo conceptual en tablas y columnas del modelo de datos. Definir las claves primarias, las claves foráneas y las restricciones de integridad referencial si las hubiera.
  5. Diseñar el modelo físico, ajustando el modelo lógico a las características de nuestro SGBD. Elegir los tipos de datos adecuados, crear los índices necesarios, definir las políticas de seguridad y establecer las estrategias de particionamiento, copia de seguridad y recuperación.
  6. Implementar el modelo físico, generando los scripts SQL o utilizando herramientas gráficas como SQL Server Management Studio (SSMS) o SQL Server Data Tools (SSDT).
  7. Validar y verificar el modelo físico, comprobando que cumple con los requisitos del negocio y del usuario, que no contiene errores ni inconsistencias y que ofrece un buen rendimiento.

Conclusión

El modelado de datos es una tarea fundamental para crear bases de datos eficientes, seguras y de calidad en SQL Server. Siguiendo las buenas prácticas que te hemos mostrado en este artículo, podrás diseñar e implementar modelos de datos que satisfagan las necesidades de tu negocio y tus usuarios. 

Esperamos que te haya gustado este artículo y que lo pongas en práctica.  Si tienes alguna duda o comentario, no dudes en dejarnos un mensaje en Twitter, por mail o dejarnos en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn al que te puedes unir. 

Publicado por Roberto Carrancio en Power BI, Rendimiento, SQL Server, 1 comentario