SQL Server

Aquí encontraras todos nuestros post relacionados con SQL Server desde cero hasta un nivel avanzado. Desde infraestructura hasta modelado de datos.

¿Cómo usar QueryStore en SQL o Azure?

En este tercer Video Blog nos adentramos en QueryStore, una de las herramientas más potentes que Microsoft pone a nuestra disposición de manera nativa para monitorizar el rendimiento de nuestras bases de datos SQL ya sea en SQL Server o en Azure.

Como ya os prometí en el post de ayer donde vimos la teoría que rodea a esta herramienta, hoy vamos a aprovechar las ventajas del formato de Video Blog para ver todas las opciones de visualización de datos y configuración de la herramienta que necesitamos para convertirnos en verdaderos profesionales del rendimiento en SQL.

Vistas de QueryStore

QueryStore pone a nuestra disposición varias vistas con diferente información de lo más útil.

  • Regresed Queries: Nos va a permitir localizar las consultas que han sufrido una degradación de rendimiento.
  • Overall Resource Consumption: Muestra el consumo de los diferentes recursos a lo largo del tiempo en diferentes gráficos de barras.
  • Top Resource Consuming Queries: Nos va a mostrar las consultas que más recursos han consumido de un recurso que nosotros elijamos en un periodo a elegir entre 5 minutos y varios años.
  • Queries With Forced Plans: Aquí podremos encontrar las consultas a las que les hemos forzado un plan de ejecución en concreto.
  • Queries With High Variation: Esta vista nos mostrará las consultas con gran variación en su consumo de recursos, ya sea a mejor o peor.
  • Query Waits Statistics: Este informe es uno de los más importantes y por el que yo siempre empiezo a mirar. En el vamos a ver cuales son los recursos que causan cuellos de botella en el rendimiento de nuestras consultas.
  • Tracked Queries: En este último dashboard vamos a poder hacer seguimiento del rendimiento de una consulta en concreto que nosotros elijamos.

Objetivos de la optimización en QueryStore

El fin principal de esta herramienta no es otro que ayudarnos a mejorar el rendimiento de nuestras consultas. Es importante remarcar, que una buena optimización no solo mejorará los tiempos de nuestros procesos sino que, además, reducirá el consumo de recursos permitiéndonos un gran ahorro en infraestructura tanto si tenemos servidores locales como en la nube. En este último escenario, donde el pago por uso parece ya un estándar este ahorro de recursos puede marcar la diferencia entre que nuestro proyecto sea o no rentable.

Conclusión

QueryStore es una gran herramienta que nos va a permitir optimizar el rendimiento de las consultas y ahorrar costes tanto en SQL Server como en Azure SQL. A través de sus diferentes informes vamos a ser capaces de localizar y poner solución a los problemas de nuestro servidor. Espero que este artículo te haya proporcionado una visión profunda del almacén de consultas en SQL Server y Azure. Como siempre, estamos aquí para ayudarte. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, Videos, 1 comentario

Query Store en SQL Server y Azure

Todos los que nos dedicamos al mundo de las bases de datos, ya sea como administradores o como usuarios, siempre deberíamos estar buscando formas de mejorar el rendimiento y la eficiencia de las consultas. Por eso, hoy vamos a explorar una herramienta muy poderosa que puede ayudarnos a hacer precisamente eso: el almacén de consultas o Query Store disponible de forma nativa tanto en SQL Server como en Azure.

¿Qué es el Query Store?

El almacén de consultas es una característica que permite rastrear y revisar el historial de ejecución de consultas en SQL Server y Azure. Es como la “caja negra” de los aviones pero para nuestras consultas SQL en SQL Server o Azure. Gracias a esta información de Query Store vamos a lograr una visión detallada de cómo se están ejecutando nuestras consultas a lo largo del tiempo y con ello, localizar problemas o puntos de mejora en el rendimiento.

Beneficios de Query Store

Query Store ofrece muchos beneficios, vamos a centrarnos en los principales. Lo principal para mi es que nos permite identificar consultas de alto consumo de recursos. Esto, por sí solo ya sería un motivo de peso para valorar configurarlo en nuestros sistemas pero, además, nos va a facilitar ver cómo cambia el rendimiento de las consultas con el tiempo y entender cómo las diferentes configuraciones afectan el rendimiento de las consultas.

Configuración en SQL Server

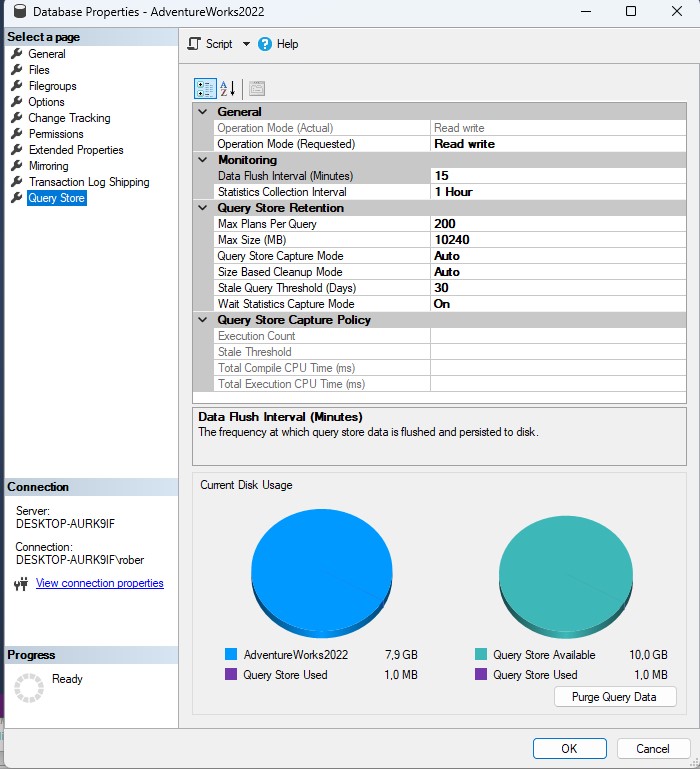
En SQL Server, el almacén de consultas se puede habilitar a nivel de base de datos. Una vez habilitado, comenzará a recopilar datos sobre las consultas ejecutadas en la base de datos. Y ya está, desde ese preciso momento podemos usar esta información para identificar consultas problemáticas y tomar medidas para mejorar su rendimiento. Pero, no nos saltemos pasos, vamos a ver en detalle la ventana de configuración y repasar sus opciones.

QueryStore

Como podemos ver la configuración es bastante sencilla. Deberemos indicar algo más de media docena de parámetros y aplicar los cambios. Como es habitual, tenemos un cuadro de texto bajo las opciones donde se nos especifica que hace cada una de esas configuraciones. Profundizaremos en esta configuración en futuros post así que no vamos a complicar más esta explicación.

Configuración en Azure

En Azure es incluso más sencillo, Query Store es una característica incorporada y habilitada por defecto tanto en Azure SQL Database como en Azure SQL Managed Instance. Al igual que en SQL Server, nos proporciona información valiosa sobre el rendimiento de nuestras consultas. Además, como pudimos ver en la beta presentada este fin de semana en el evento Global Azure Spain, se integra con Azure Copilot para que podamos preguntar directamente a la IA de Microsoft cuáles son los problemas y obtener toda la información en lenguaje natural.

Uso de Query Store 

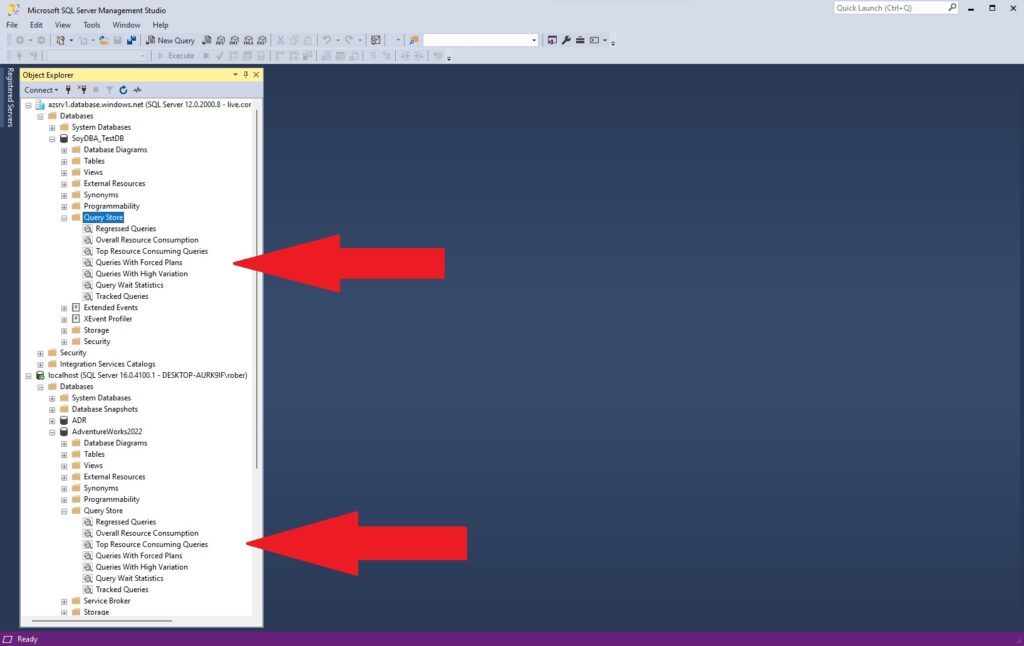
Una vez habilitado Query Store en SQL Server o de manera automática en las bases de datos de Azure ya dispondremos de los informes correspondientes dentro del apartado Query Store en la base de datos. 

QueryStore_2

Podéis apreciar en la imagen que, una vez en nuestro SSMS no hay diferencias entre la base de datos de Azure y la que está en mi instancia local. Los informes son los mismos y van a tener la misma información. Si queréis profundizar más sobre los distintos informes y su funcionamiento estad atentos al blog que mañana publicaremos un video donde os lo enseñaré en detalle.

Conclusión

El almacenamiento de consultas es una herramienta poderosa para la administración de bases de datos en SQL Server y Azure. Nos permite rastrear y analizar el rendimiento de nuestras consultas, lo que nos ayuda a optimizar nuestras bases de datos y mejorar la eficiencia. Si aún no estás utilizando el almacenamiento de consultas, te animamos a que lo explores y veas cómo puede beneficiar a tu entorno de base de datos.

Esperamos que este artículo te haya proporcionado una visión profunda del almacén de consultas en SQL Server y Azure. Como siempre, estamos aquí para ayudarte en tu viaje de administración de bases de datos. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de Telegram y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Rendimiento, SQL Server, 2 comentarios

Detectando fragmentación de índices en SQL Server y Azure

Volvemos a la carga con un artículo sobre índices de esos que tanto nos gustan. Esta vez vamos a hablar de un tema muy importante y es detectar qué índices están más fragmentados y cómo solucionarlo. A menudo vemos que una mala gestión de los planes de mantenimiento provocan una degradación del rendimiento de las consultas y eso, gran parte de las veces es debido a un problema de fragmentación de índices o falta de mantenimiento de las estadísticas. Hoy vamos a centrarnos en el primero de estos aspectos.

¿Cómo detectar fragmentación en los índices?

Para ver la fragmentación de un índice en concreto podemos hacerlo desde el entorno gráfico de nuestro SSMS, haciendo click derecho sobre el objeto y mirando sus propiedades. Sin embargo, esto no es práctico cuando tenemos cientos de índices en nuestra base de datos y queremos saber de un vistazo cuales son los más fragmentados y cuanto. Para ello, usaremos una consulta sobre la función de sistema sys.dm_db_index_physical_stats. 

Otra de las cosas que debemos tener en cuenta es el tamaño de nuestra tabla, con menos de 1000 páginas, el motor de base de datos directamente ignorará los índices nonclustered y, en el caso de los clustered, tampoco vamos a notar diferencia.

Con esto en mente vamos a preparar el script. 

Revisemos el script, por un lado podemos ver que a la función para ver las estadísticas de los índices le estamos pasando el id de la base de datos actual para que se ejecute en ese contexto. Esto es para evitar que se ejecute por todas las bases de datos y podamos tener un problema de rendimiento con esta consulta. Por otro lado vemos que solo afecta a tablas y vistas de usuario que tengan un índice clustered, el tipo de índice 0 está excluido de los filtros. Las tablas HEAP (sin índice clustered) necesitan otro tipo de tratamiento. Podemos ver también el filtro para solo mostrar índices con más de 1000 páginas y el de fragmentación superior al 5%, que suele considerarse el umbral de fragmentación aceptable.

Solucionar fragmentación de índices

Ahora que sabemos cuales son los índices más fragmentados debemos actuar y solucionar el problema. Sabemos que tenemos a nuestra disposición dos alternativas: reorganizar o reconstruir. Para elegir entre una opción u otra tenemos varios factores a tener en cuenta.

Por un lado tenemos el modo de operación de estas instrucciones, reorganizar siempre es una operación online lo que significa que solo generará sobre nuestro índice un intento de bloqueo compartido. El índice se podrá seguir leyendo durante la reordenación sin causar bloqueos. En cuanto a la reconstrucción, solo es online si se lo especificamos manualmente y eso solo es posible en ediciones Enterprise de SQL Server o en las bases de datos o instancias gestionadas de Azure. Si la reconstrucción es offline se generará un bloqueo exclusivo sobre el índice.

Por otro lado, la reconstrucción es más eficiente que la reorganización para porcentajes elevados de fragmentación y eso deberemos tenerlo también muy en cuenta.

¿Debería reorganizar o reconstruir mis índices con mucha fragmentación?

Esto no es una ciencia exacta y es un tema sobre el que hay muchas opiniones discordantes. Normalmente se habla de reorganizar los índices con una fragmentación superior al 5 o 10% y menor al 15 o 30%. Como veis es una horquilla muy amplia y para atinar tenemos que pensar en las las implicaciones de estas operaciones que ya hemos visto antes. Yo os voy a contar cómo lo hago yo pero esto es totalmente personal y deberás adaptarlo a cada caso.

Escenario 1: Mantenimiento programado

En este primer escenario estamos hablando de un mantenimiento programado dentro de una ventana de mantenimiento en la que no hay interferencia con otros procesos. Este caso es el más sencillo porque no tenemos que pensar en no entorpecer a nadie. En estos casos yo pongo el umbral para empezar a actuar en un 5%. Si estamos hablando de una edición Standard de SQL Server reorganizaré los índices con una fragmentación entre un 5 y un 20% y reconstruiré los de mayor fragmentación. Para ediciones Enterprise o Azure reduciré esa horquilla para reorganizar entre un 5 y un 15% y haré reorganizaciones online a partir del 15%.

Escenario 2: Problema puntual de rendimiento

En este escenario estamos hablando de un momento de carga de trabajo elevada en el que hemos recibido o detectado una incidencia por problemas de rendimiento. Tenemos que actuar rápido para solventar la situación pero entorpeciendo lo menos posible a los procesos de negocio que ya de partida tienen un rendimiento mermado. En estos casos pongo el umbral para empezar a actuar en fragmentaciones por encima del 10% en vez del 5. A partir de ahí, si tenemos la suerte de contar con una edición Enterprise, o estamos en Azure, no hay más problema, reconstruiremos con las mismas condiciones que en el escenario anterior, a partir del 15%. Para una edición Standard, donde si vamos a generar bloqueos si reconstruimos, intentaremos reorganizar hasta el 30% de fragmentación.

Solucionar estadísticas desactualizadas

Las estadísticas son clave para SQL Server. Como ya hemos comentado en este blog muchas veces, unas estadísticas desfasadas pueden tener el mismo impacto negativo o peor que un índice fragmentado. Por este motivo, es importante tenerlas en cuenta a la hora de realizar nuestros mantenimientos o enfrentar una incidencia por degradación de rendimiento. Una reconstrucción de índices siempre actualizará las estadísticas asociadas a ese índice pero en el caso de las reorganizaciones deberemos hacerlo manualmente. Tenemos que contar también con que una actualización de estadísticas es más ligera y rápida que un mantenimiento de índices por lo que, en caso de una degradación de rendimiento de una consulta puntual, yo siempre actualizo las estadísticas de las tablas involucradas como primera medida.

Conclusión

Ante un problema de rendimiento, tenemos que verificar el estado de nuestros índices y estadísticas. Además, consultar su nivel de fragmentación será clave a la hora de decidir si vamos a reorganizarlo o reconstruirlo y, todo esto, siempre sin dejar de lado las estadísticas. Tened en cuenta que por mucho que tengamos implementada una solución de mantenimiento de índices y estadísticas nunca vamos a estar 100% seguros de que no va a haber una variación tal de datos que nos va a generar fragmentación o a dejar desfasadas nuestras estadísticas. Es importante que mantengamos una monitorización y vigilancia continua para garantizar el mejor desempeño de nuestros SQL Server.

Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Cloud, Índices, Rendimiento, SQL Server, 1 comentario

Configurar planes de mantenimiento en SQL Server y Azure

Hola a todos y bienvenidos a este nuevo formato de Video Blog que espero que os guste y que podamos ver por aquí más a menudo. Hoy vamos a ver un caso práctico sobre como configurar planes de mantenimiento en nuestro SQL Server o instancia administrada en Azure gracias a los script de Ola Hallengren. En todo este tiempo como DBA (más de 10 años) os aseguro que más del 90% de las incidencias por supuestos problemas de rendimiento a las que me he enfrentado eran siempre por lo mismo, una falta de mantenimiento correcto. Por esto es importante programar tareas de reconstrucción de índices y mantenimiento de estadísticas. Y ya de paso, aprovechamos y configuramos las copias de seguridad y comprobaciones de integridad que también nos ofrece esta solución gratuita. Pocas veces vas a encontrar más por menos.

Guía de capítulos

  • 00:00 Introducción
  • 00:39 Descarga
  • 01:20 Instalación
  • 05:42 Backups
  • 10:15 Integrity Check
  • 11:42 Index Optimize
  • 13:13 Limpieza
  • 13:54 Log de procesos

Configurar planes de mantenimiento

Como podemos ver en el vídeo para descargar los scripts de mantenimiento solo deberemos acudir a la web de Ola Hallengren y descargar el script que se llama «MaintenanceSolution.sql». Con el script ya abierto en nuestro SSMS podremos configurar la base de datos donde se van a crear los scripts y una serie de configuraciones importantes para los jobs.

Una vez instalada la solución de planes de mantenimiento vamos a poder configurar en los distintos jobs las tareas de copias de seguridad, supervisión de la integridad y reconstrucción y actualización de índices y estadísticas para las bases de datos de sistema y de usuario. También es importante que configuremos los trabajos que incluyen las tareas de mantenimiento para no encontrarnos con incidencias de espacio en disco en un futuro.

Esta solución, además, tiene la ventaja de dejar un log bastante completo en una tabla llamada CommandLog que estará en la misma base de datos que hayamos creado los procedimientos almacenados de mantenimiento. En esta tabla podremos encontrar todo el historia de ejecuciones de todos los comandos con su detalle, horas de inicio y de fin y, por supuesto, si ha dado un error veremos el por qué.

Publicado por Roberto Carrancio en Cloud, SQL Server, Videos, 0 comentarios

SQL o Azure ¿Qué solución es mejor para mi?

Si estás pensando desplegar un nuevo servidor, quizá por un proceso de migración, uno de los aspectos clave es elegir qué edición de SQL Server se adapta mejor a tus necesidades. Hoy en día, Microsoft ofrece una gran variedad de soluciones que, si bien están pensadas para satisfacer las necesidades de todas las empresas, puede ser un poco lioso para usuarios o administradores no iniciados en el tema del licenciamiento de SQL Server. Hoy, vamos a explorar las diferencias entre las ediciones de SQL Server 2022 (Express, Standard y Enterprise), las Bases de Datos de Azure y las Instancias Gestionadas de Azure.

Nube o local

Lo primero que tenemos que tener claro es si necesitamos desplegar un servidor en la nube o en local. En ocasiones, por regulación o por necesidades del proyecto ya podemos descartar varias de las opciones y, por tanto, lo tendremos bastante más fácil.
Un servidor local puede ser la elección correcta si tu empresa tiene requisitos de seguridad o cumplimiento muy específicos que requieren un control total sobre los datos. También puede ser beneficioso si ya tienes una infraestructura de sistemas robusta y el personal con experiencia en la gestión de servidores locales. En este caso no lo dudes y amortiza tu infraestructura local, ya habrá tiempo de replantearse la solución. 

Por otro lado, una solución en la nube es ideal si necesitas flexibilidad, escalabilidad y ahorro de coste en el despliegue. Las soluciones en la nube, como Azure, pueden ofrecer, además, alta disponibilidad y copias de seguridad y actualizaciones de seguridad automáticas, liberando de carga de trabajo a los equipos de IT. Esta solución es también recomendable en escenarios descentralizados donde, de otra manera, tendríamos que tener en nuestra infraestructura local (y gestionar) servidores expuestos en internet. Sin embargo, a largo plazo el modelo de pago por uso puede derivar en grandes costes, sobre todo si no tienes personal con la formación adecuada para dimensionar y optimizar tanto la propia infraestructura en la nube como las aplicaciones que hacen uso de ella.

Soluciones locales

Microsoft nos ofrece varios “sabores” de SQL Server 2022, en concreto tenemos a nuestra disposición las ediciones Express, Standard, Enterprise y Development. Cada una de ellas con un coste y unas características. En este artículo nos vamos a centrar solo en las tres primeras pues son las destinadas a entornos de producción, de la edición Development solo comentaré que tiene todas las características de la  edición Enterprise pero de manera gratuita a cambio de no poder usarse en entornos de producción. 

SQL Server 2022 Express

La edición Express es una versión gratuita de SQL Server, diseñada para aplicaciones de pequeña escala. Aunque es gratuita y ofrece toda la robustez del sistema de gestión de bases de datos de Microsoft, tiene muchas limitaciones en términos de tamaño de las bases de datos y capacidades de procesamiento.

Es una solución ideal para pequeñas empresas que están iniciando un proyecto que necesita una base de datos. Sin embargo, pronto se puede quedar corta debido a sus limitaciones de tamaño de máximo 10 Gb por base de datos (incluyendo datos y log de transacciones), 1 Gb de memoria RAM y solo un procesador (físico o virtual) del que además solo se aprovecharán 4 núcleos (físicos o virtuales). A estas limitaciones hay que sumarle que no dispone de agente de SQL Server por lo que no podremos utilizar esas funcionalidades. En cuanto a funcionalidades también encontraremos limitaciones como la imposibilidad de comprimir los backups o de reconstruir índices online.

SQL Server 2022 Standard

La edición Standard es una solución de gestión de datos y BI (Business Intelligence) completa que ofrece más capacidades que la edición Express. Es ideal para las medianas empresas que necesitan características avanzadas, pero no todas las capacidades de alto rendimiento de la edición Enterprise. Por ejemplo, solo dispone de una solución Always On simple para una sola base de datos y con únicamente un nodo secundario. Tampoco nos ofrece por ejemplo la posibilidad de reconstruir índices online. Esto hace que no sea una solución adecuada para entornos críticos donde necesitemos una disponibilidad 24×7. 

SQL Server 2022 Enterprise

La edición Enterprise es la más completa y potente que ofrece Microsoft hasta la fecha. Ofrece todas las capacidades de SQL Server para las empresas que necesitan el más alto nivel de escalabilidad, disponibilidad y seguridad eso sí, a un coste muy elevado (unas 5x veces la licencia Standard). Si optamos por asumir el alto coste por licencia de una edición Enterprise a cambio nos llevaremos ventajas como la posibilidad de usar todas las funciones de Always On, la reconstrucción de índices online, mayores opciones en la replicación o la posibilidad de usar Resource Governor, por ejemplo.

Soluciones en la nube

Desde hace ya más de una década (madre mía cómo pasa el tiempo) Microsoft dispone de Azure, su nube con soluciones SQL Server entre otras. Centrándonos en SQL Server tenemos a nuestra disposición también varias opciones y para todos los gustos, tanto SaaS como IaaS. SaaS hace referencia al software como servicio (Software As A Service) mientras que IaaS es la infraestructura en la nube (Infraestructure As A Service). Esto quiere decir que en las soluciones SaaS solo dispondremos de una base de datos o una instancia de SQL como un servicio en la nube mientras que en las soluciones IaaS dispondremos de un servidor completo en la nube donde instalar cualquier aplicación como hacemos en los servidores locales.

Bases de Datos de Azure SQL

Las Bases de Datos de Azure son soluciones SaaS de bases de datos completamente administradas. Como características principales podemos destacar que nos proporcionan una buena protección de los datos y gran escalabilidad sin la necesidad de administrar la infraestructura subyacente ni la instancia SQL Server. Esto es también su mayor limitación dado que no dispondremos de todas las características propias de una instancia como el Agente de SQL Server. También hay que mencionar que, aunque dispone de características de alta disponibilidad estas no son tan completas como las de las instancias gestionadas. En cuanto a costes son muy variables ya que usan el método de pago por uso y podremos definir un escalado bajo demanda para reducir el presupuesto. Os recomiendo utilizar la calculadora de costes de Azure Database si estáis pensando en implementar esta solución.

Instancias SQL Gestionadas de Azure

Las Instancias Gestionadas de Azure son una opción para cuando necesitemos la flexibilidad y el control total de una instancia de SQL Server, pero con la comodidad de un servicio gestionado. Ofrecen casi el 100% de compatibilidad con SQL Server Enterprise sin renunciar a las ventajas propias de la nube como actualizaciones automáticas. Es reseñable para esta solución el 99,99% de disponibilidad que anuncia Microsoft para cada base de datos individual alojada en una instancia gestionada pero, si eso os parece poco, aún dispone de opciones de alta disponibilidad para acercar esa cifra aún más al 100%. También dispone de su propia calculadora de precios que os recomiendo consultar antes de cualquier implementación.

Otras soluciones SQL Server en la nube

Además de las soluciones propias de Microsoft podemos encontrar las instancias gestionadas de Amazon AWS llamadas RDS. Aunque no es una solución tan completa como la de Microsoft, puede ser una opción a tener en cuenta si vuestra infraestructura cloud está en esta plataforma. 

Para finalizar con este resumen de soluciones en la nube, encontramos la posibilidad de desplegar un servidor IaaS sobre cualquier nube comercial (Azure, AWS, GCP, etc…) e instalar sobre él un SQL Server licenciado de igual manera que con las soluciones locales. De esta manera, tenemos ciertas ventajas de la nube sin renunciar a las características propias de una solución local.

Conclusión

Microsoft ofrece una variedad de soluciones de bases de datos para satisfacer las necesidades de las empresas de todos los tamaños. Desde la edición Express de SQL Server 2022 para las necesidades de pequeñas aplicaciones, hasta las Instancias Gestionadas de Azure para las empresas que buscan la máxima flexibilidad y control, hay una solución para cada situación. Además no son excluyentes y en la mayoría de los casos nos encontraremos con escenarios híbridos que combinan varias de estas soluciones tanto locales como en la nube.

La elección depende de las necesidades específicas de tu empresa y espero que, tras leer este artículo, estés más preparado para tomar la decisión. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Cloud, SQL Server, 1 comentario

Backups Inmutables. A prueba de ransomware

Ya hemos hablado en este blog de la importancia que tienen las copias de seguridad y cómo estas pueden salvarnos de una pérdida de datos en caso de desastre. Hoy vamos a ir un paso más allá y vamos a explicar cómo prepararnos para un posible escenario de ransomware que cifra completamente todos los archivos en todos los equipos de la red. No sería la primera vez que una empresa pierde sus datos y las copias de seguridad por un ataque de este tipo y se queda sin nada. Antiguamente, podríamos pensar las cintas como solución pero hoy en día su uso está cada vez menos extendido. Por suerte para nosotros existen soluciones a prueba de ransomware y una de ellas son los backups inmutables que garantizarán la continuidad de nuestro negocio ante estas situaciones.

¿Qué es el ransomware?

El ransomware es un tipo de software malicioso, o malware, que cifra los archivos del usuario, bloqueando el acceso a ellos hasta que se pague un rescate. Este tipo de ataque puede ser devastador para las empresas y los usuarios, ya que los atacantes suelen exigir el pago en criptomonedas, que son difíciles de rastrear. 

El ransomware se propaga a través de varios métodos, incluyendo archivos adjuntos de correo electrónico maliciosos, descargas de sitios web comprometidos, o incluso a través de vulnerabilidades de seguridad en el software del sistema Una vez que el ransomware ha cifrado los archivos de un usuario, el atacante proporcionará instrucciones sobre cómo pagar el rescate para obtener la clave de descifrado. Sin embargo, pagar el rescate no garantiza que los usuarios recuperen el acceso a sus archivos.

Además, este tipo de ataques suele propagarse rápidamente por la web cifrando todos los archivos en todos los ordenadores y servidores que encuentra a su paso. Esto es de una gravedad extrema pues además de los datos de nuestro SQL server puede afectar también a nuestras copias de seguridad en ubicaciones externas pero accesibles por la red. 

¿Cómo protegerse de un ataque de ransomware?

En este aspecto, es crucial una buena educación en ciberseguridad por parte de los usuarios y una buena política de restricción de permisos a nivel directorio activo. Esto sin duda nos ayudará a prevenir un ataque de ransomware. Sin embargo, tenemos que estar preparados para lo peor, en ocasiones, ni con todas las medidas que podamos imaginar podemos estar a salvo.Es por esto que debemos conocer las herramientas que tenemos a nuestro alcance para evitar, por lo menos, el cifrado de nuestras copias de seguridad y es aquí donde cobra especial relevancia la inmutabilidad de los archivos.

¿Qué son los archivos inmutables?

La inmutabilidad es un concepto fundamental en la programación funcional, pero también se aplica a otras áreas de la informática, como los sistemas de archivos. En términos generales, un objeto o dato es considerado inmutable si su estado no puede ser modificado después de su creación. Una vez que se crea un objeto inmutable, no puede ser cambiado. Esto significa que cada vez que necesitas modificar un objeto inmutable, en realidad debes crear una nueva instancia de ese objeto con el nuevo valor.

La inmutabilidad tiene varias ventajas. Por ejemplo, mejora la seguridad del código y facilita el razonamiento sobre el comportamiento del programa, ya que no tienes que preocuparte por los cambios inesperados en los objetos. Además, los objetos inmutables son naturalmente seguros para el uso en entornos multihilo, ya que no pueden ser modificados una vez creados, eliminando así la necesidad de sincronización.

¿Por qué deberías hacer tus backups inmutables?

En el contexto de las bases de datos y los backups, la inmutabilidad puede ayudar a proteger los datos contra la corrupción y facilitar la auditoría y el seguimiento de los cambios. Por ejemplo, si los backups son inmutables, puedes estar seguro de que siempre podrás recuperar tus datos a un estado conocido, sin preocuparte de que los backups puedan haber sido alterados o dañados después de su creación.

La inmutabilidad en los backups ofrece varios beneficios. En primer lugar, mejora la seguridad de los datos. Al hacer los backups inmutables, nos protegemos contra la modificación o eliminación accidental o malintencionada de las copias de seguridad. Además, la inmutabilidad facilita la auditoría de los backups, ya que podemos rastrear fácilmente todas las operaciones realizadas en las copias de seguridad (no se van a modificar una vez creadas).

Implementar Backups inmutables

Implementar la inmutabilidad en los backups de SQL Server puede sonar algo difícil, pero es factible. Existen en el mercado herramientas que harán este trabajo por nosotros. En estas herramientas, normalmente, definiremos una carpeta sobre la que aplicaremos la inmutabilidad y dos periodos de tiempo. El primero es cuanto tiempo desde su creación se podrá modificar el archivo y el segundo es cuánto tiempo permanecerá inmutable. Tenemos que dejar suficiente tiempo para que los backups puedan completarse completamente antes de que el archivo se vuelva inmutable y configurar bien el tiempo de retención para poder borrarlos periódicamente en base a nuestra política de retención sin llegar a llenar el disco.

Podríamos pensar que una solución sería volver inmutables archivos o directorios de sistemas Linux con el comando chattr. Estos archivos o directorios no pueden ser modificados una vez que se crean. Sin embargo, deshacer la inmutabilidad es tan sencillo como volver a ejecutar el comando chattr, aunque para ello hace falta permisos de root. 

Para estar más seguros, existen varias herramientas que nos pueden ayudar a implementar la inmutabilidad en nuestros backups de SQL Server. Por ejemplo, Veritas Netbackup ofrece soluciones de protección de datos que incluyen características de inmutabilidad. También tenemos una solución de inmutabilidad nativa en las carpetas de los NAS de la marca Synology que nos ofrecen opciones de almacenamiento seguro e inmutable para nuestros backups.

Implementar carpetas inmutables en NAS Synology

Desde la versión DSM 7.2 (el OS de Synology) se puede crear carpetas protegidas con “WriteOnce” que básicamente hace inmutables los archivos que contengan. A la hora de configurar WriteOnce podemos definir si usaremos un modo Enterprise o Compliance, en el primer de los casos un administrador si podría modificar los ficheros por lo que lo que nosotros necesitamos es el modo Compliance. En cuanto al bloqueo automático podremos definir un tiempo de cortesía antes de bloquear los ficheros o seleccionar que se bloqueen automáticamente. Para la retención, podremos definir un tiempo de retención o que se bloqueen para siempre (a veces es necesario para cumplir ciertas regulaciones). Por último tendremos la opción de definir los ficheros para que no admiten ningún tipo de cambio o para que solo admiten anexiones aunque esto, para los backups de SQL Server, no nos será de utilidad.

Conclusión

Los backups inmutables son una poderosa herramienta que llevará nuestros niveles de seguridad a un nivel superior. Espero que con este artículo le hayáis perdido un poco el miedo a su implementación y os animéis a ponerlo en marcha. Una vez implementado dormiremos más tranquilos, os lo aseguro.  Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en SQL Server, 1 comentario

Ciclo de Vida y Niveles de Soporte de SQL Server

En el mundo de la tecnología si hay algo cierto es la constante evolución. Esto es una realidad ineludible como que si un usuario tiene permisos elevados terminará metiéndonos en un lío. Como buenos DBAs profesionales, nos enfrentamos a la tarea de mantenernos al día con las últimas versiones de SQL Server. Ya hablamos aquí de las actualizaciones de SQL Server pero, ¿qué sucede con las versiones antiguas? ¿Cómo gestionamos su ciclo de vida y los niveles de soporte?

Ciclo de Vida de SQL Server

El ciclo de vida de un producto de software se refiere a las diferentes etapas por las que pasa desde su lanzamiento hasta que deja de recibir soporte. En el caso de SQL Server, el ciclo de vida, se divide en dos fases principales: el soporte principal y el soporte extendido.

Soporte Principal

Durante la fase de soporte principal (mainstream), Microsoft ofrece actualizaciones de seguridad, correcciones de errores y nuevas características. Esta fase dura normalmente 5 años desde la fecha de lanzamiento de la versión.

Soporte Extendido

Una vez concluida la fase de soporte principal, entramos en la fase de soporte extendido. Durante este periodo, que también suele durar 5 años, Microsoft sigue ofreciendo actualizaciones de seguridad, pero ya no se añaden nuevas características ni se realizan correcciones de errores no relacionados con la seguridad. Veremos esto más en profundidad ahora con los niveles de soporte.

Niveles de Soporte para las Versiones de SQL Server

Además del ciclo de vida, es importante entender los niveles de soporte que Microsoft ofrece para las diferentes versiones de SQL Server. Los niveles de soporte se refieren al tipo y alcance del soporte técnico que se proporciona durante las diferentes fases del ciclo de vida de un producto de software. En el caso de SQL Server tenemos tres fases principales: soporte total, limitado y fin de soporte.

Soporte Total

Durante la fase de soporte principal, una versión de SQL Server tiene soporte total. Esto significa que se pueden solicitar todas las formas de soporte, incluyendo la resolución de problemas, la corrección de errores y las actualizaciones de seguridad.

Soporte Limitado (extendido)

En la fase de soporte extendido, el nivel de soporte se reduce a soporte limitado. En este nivel, Microsoft solo proporciona actualizaciones de seguridad y ya no se resuelven problemas ni se corrigen errores que no estén relacionados con incidentes de seguridad.

Fin de Soporte

Finalmente, cuando una versión de SQL Server alcanza el fin de su soporte, ya no se proporcionan actualizaciones de seguridad ni soporte técnico. Aunque es cierto que en casos muy extremos y con incidentes de seguridad de máxima gravedad Microsoft puede hacer excepciones, es crucial planificar la migración a una versión soportada antes de llegar a esta fase. Por ejemplo, me viene a la mente la famosa actualización GDR crítica del 14 de febrero de 2023 que salió para todas las versiones de SQL desde 2008 hasta 2022 aunque las versiones de 2008, 2008 R2 y 2012 estaban fuera de ciclo de vida, en fase de fin de soporte. Como digo, son casos muy excepcionales y la recomendación es no mantener servidores cuando estos han alcanzado el fin de soporte.

Actualizaciones de SQL Server

Como ya vimos en un anterior artículo, las actualizaciones de SQL Server pueden ser Service Packs (SP), Cumulative Updates (CU) o General Distribution Releases (GDR). Estas actualizaciones esenciales que Microsoft lanza para las versiones de SQL Server, aunque no alteran el ciclo de vida general de una versión de SQL Server, tienen su propio ciclo de vida y pueden extender el soporte de una versión específica. Veamos caso a caso como influyen.

Service Packs

Un Service Pack (SP) puede extender el ciclo de vida de una versión de SQL Server. Cuando se lanza un SP, este tiene su propio ciclo de vida, que se extiende más allá del ciclo de vida original de la versión principal. Por ejemplo, aunque SQL Server 2014 ha finalizado su ciclo de vida de soporte principal, el soporte extendido para SQL Server 2014 SP3 sigue activo hasta el 9 de julio de 2024. Esto significa que Microsoft continuará proporcionando actualizaciones de seguridad y soporte técnico para SQL Server 2014 SP3 incluso después de que la versión principal haya alcanzado su fin de soporte hace varios años. Aunque Microsoft dejó de publicar SPs a partir de la versión de SQL Server 2016, como sé que sois mentes intrépidas y con sed de datos, os contaré que estas actualizaciones solo se lanzaban para productos en la fase principal del ciclo de vida de un producto.

Cumulative Updates

Las Cumulative Updates (CU), por otro lado, son actualizaciones más frecuentes que incluyen correcciones de errores y mejoras de rendimiento. Microsoft cambió el modelo de SPs por el CUs, más frecuentes y con menos cambios cada una. Digamos que hasta SQL 2016, Microsoft esperaba a tener una gran actualización para liberar un nuevo SP y, ahora, lo que hace es ir liberando pequeñas actualizaciones pero de manera más frecuente. Todo muy agile, ¿verdad? Esto tiene una implicación directa para nosotros y es que, aunque una CU tiene un ciclo de soporte propio de 1 año a partir de su fecha de lanzamiento, no extiende el ciclo de vida de la versión principal de SQL Server como sí hacían los SPs. Al igual que pasaba con los SPs, las CUs solo se liberan durante la fase principal del ciclo de vida de una versión SQL.

General Distribution Releases

Las General Distribution Releases (GDR) son actualizaciones que se centran principalmente en las correcciones de seguridad. A diferencia de los SP y las CU, las GDR no añaden nuevas características ni mejoras de rendimiento. Sin embargo, son críticas para mantener la seguridad de nuestras bases de datos y, al igual que los SP y las CU, tienen su propio ciclo de vida. Con todo lo que ya hemos visto, habréis podido adivinar que las GDR se lanzan durante todo el periodo de ciclo de vida, tanto principal como extendido siendo las únicas actualizaciones de las que dispondremos fuera del ciclo de vida principal de una versión de SQL Server.

Conclusión

Como profesionales de bases de datos, es esencial que comprendamos el ciclo de vida y los niveles de soporte de las versiones de SQL Server. Esto nos permitirá planificar eficazmente las actualizaciones y garantizar que nuestras bases de datos sigan siendo seguras y eficientes. Recuerda, mantenerse al día no es solo una cuestión de aprovechar las nuevas características, sino también de garantizar la seguridad y la estabilidad de nuestros sistemas. Las actualizaciones, tanto SPs, CUs y GDRs juegan un papel crucial en la gestión del ciclo de vida de SQL Server. Es importante tener en cuenta estos detalles al planificar las actualizaciones y el mantenimiento de nuestras bases de datos. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en SQL Server, 0 comentarios