Rendimiento

Impacto en el rendimiento de índices FullText

Llevamos los dos últimos artículos hablando de los índices de texto completo (FullText) en SQL Server. Hemos aprendido lo qué son y cómo se administran, sin embargo hay un tema, quizá lo más importante, que habíamos dejado para el final. Y no es otro que su uso y el impacto en el rendimiento. ¿Realmente merece la pena este tipo de índices? Vamos a descubrirlo juntos.

Cláusulas específicas para buscar en índices FullText

Normalmente cuando tenemos que buscar texto dentro de una columna en SQL usamos la cláusula LIKE y nos apoyamos en el carácter % que hace de comodín. Sin embargo, cuando hemos añadido una columna a un índice FullText se nos habilitan otras opciones de búsqueda como son CONTAINS, FREETEXT, CONTAINSTABLE y FREETEXTTABLE. Aunque todas son cláusulas para filtrar por texto tienen algunas diferencias que debemos conocer.

CONTAINS: La Precisión

CONTAINS es una cláusula que permite realizar búsquedas de texto completo en columnas de tipo char, varchar o text dentro de SQL Server. Esta cláusula es especialmente poderosa por su capacidad de buscar palabras o frases específicas, e incluso formas de una palabra, dentro de un texto. Por ejemplo, si queremos encontrar todos los registros que contengan la palabra «optimización», CONTAINS nos facilitará esta tarea con gran precisión.

FREETEXT: La Relevancia 

Por otro lado, FREETEXT es menos estricta que CONTAINS y se utiliza para buscar términos que sean «similares» o relacionados con el texto de la consulta, sin necesidad de que sean exactos. Es decir, FREETEXT no solo nos va a devolver los campos que contengan esa palabra sino también los que contengan algún sinonimo.  Esto es ideal para cuando la intención es más importante que la coincidencia literal, permitiendo una búsqueda más «libre» y basada en la relevancia.

CONTAINSTABLE: Resultados Ordenados

CONTAINSTABLE es una función que extiende las capacidades de CONTAINS, devolviendo una tabla de resultados con las filas que coinciden con la búsqueda, junto con un rango de relevancia, conocido como «rank». Esto permite no solo encontrar las coincidencias, sino también ordenarlas por su relevancia, facilitando la identificación de los resultados más pertinentes.

FREETEXTTABLE: Mayor Flexibilidad en la Búsqueda

Similar a CONTAINSTABLE, FREETEXTTABLE aplica los principios de FREETEXT a una tabla de resultados clasificables. Esta función es crucial cuando buscamos entender el contexto general de los términos de una búsqueda dentro de un conjunto de datos, proporcionándonos una clasificación que nos ayuda a discernir la importancia relativa de cada registro encontrado.

Sintaxis y ejemplos de la búsqueda de texto

Ahora que ya sabemos las diferencias entre las distintas búsquedas vamos a ver como se usan en un caso práctico. Para esto vamos a usar la base de datos de ejemplo de Microsoft AdventureWorks. Como ya sabréis (o no, no importa) esta base de datos tiene datos de ejemplo de una tienda de bicicletas. Vamos a buscar, entonces, por la palabra rendimiento en la tabla de descripciones de los productos. Lamentablemente no tenemos una base de datos AdventureWorks con datos en español así que tendremos que buscar en inglés pero es solo por esto. Vosotros tendreis que buscar en el idioma que tengáis vuestros datos y, muy importante, tendréis que haber creado directamente el índice en ese idioma (si no sabéis como se hace os lo conté aquí). 

Vamos a hacer la misma búsqueda con todas las posibles opciones que hemos visto antes:

Podríamos entrar aquí y ahora en todas las opciones avanzadas de filtrado que incluyen cada una de estas opciones frente al tradicional y simple LIKE pero, convertiría este artículo en eterno y tampoco es el objetivo del post. Si queréis profundizar más tenéis la documentación oficial y si queréis que veamos aquí algunos ejemplos podeis pedirmelo y lo haremos. 

Rendimiento en las búsquedas de texto

Vamos ahora a comparar el rendimiento de las consultas anteriores. Para que el ejemplo tenga más relevancia he creado aproximadamente unos 200.000 registros en la tabla en lugar de los menos de 800 que trae cuando restauramos la base de datos. No sufráis por eso que después de eso también he actualizado los índices y estadísticas de la tabla. Esto nos va a permitir verificar mejor las diferencias.

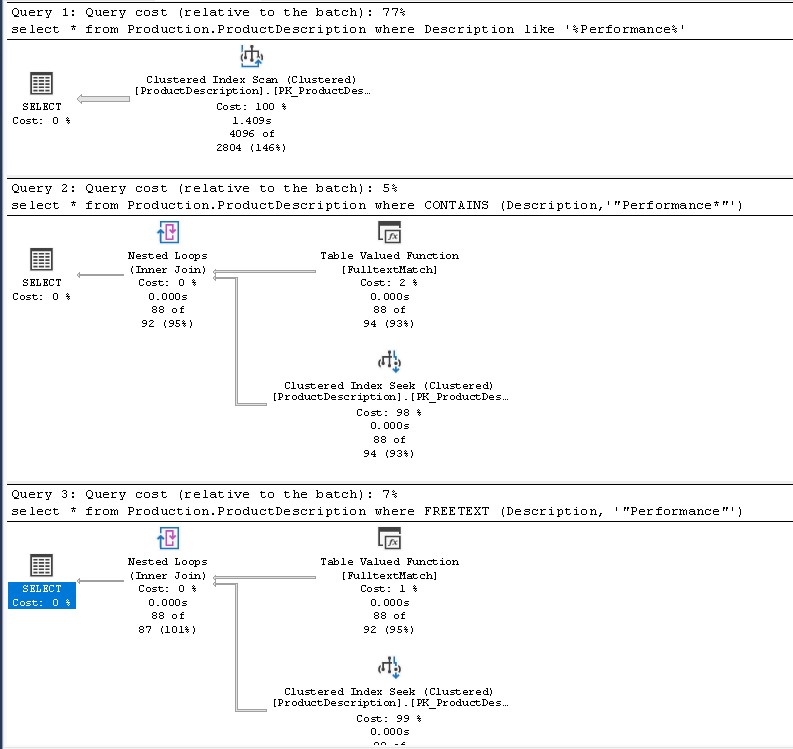
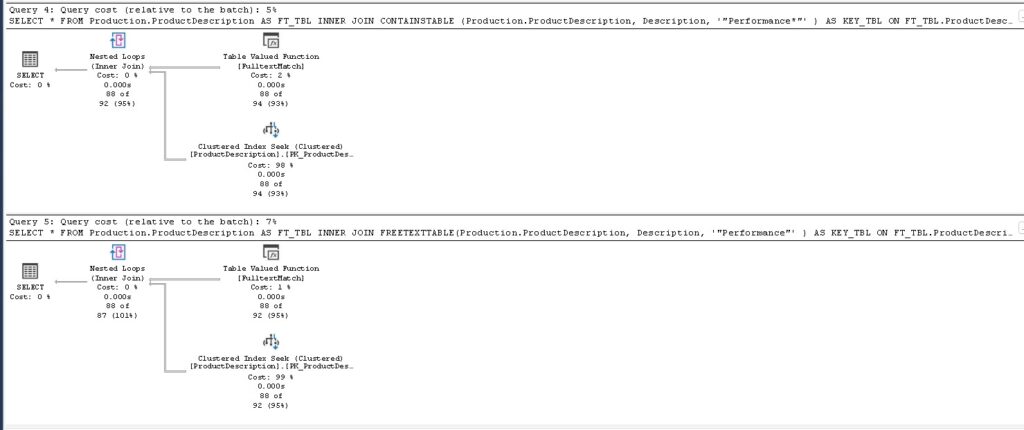
Estos han sido los resultados ejecutando las anteriores consultas:

CláusulaTiempo de CPULecturas lógicasPorcentaje del plan
LIKE781 milisegundos4365 páginas77%
CONTAINS< 1 milisegundo278 páginas5%
FREETEXT< 1 milisegundo278 páginas7%
CONTAINSTABLE< 1 milisegundo278 páginas5%
FREETEXTTABLE< 1 milisegundo278 páginas7%
FullText_Performance1
FullText_Performance2

Las conclusiones son obvias, el mayor consumo de recursos es con Like, cuando no se usa el índice FullText tardando 780 veces más en completar la consulta y leyendo 34 Mb de información (4365 páginas * 8Kb por página / 1024 = 34 Mb) frente a los solo 2 Mb de información que se leen las consultas que sí hacen uso del índice de texto completo. 

Rendimiento en escrituras

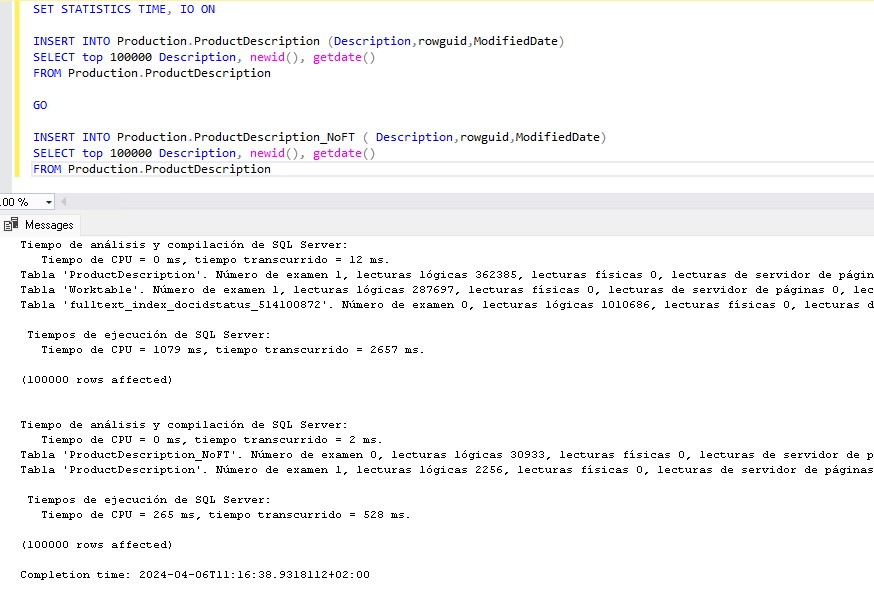
Ya hemos hablado en varias ocasiones de esto pero no está de más recordarlo, los índices en SQL “no son gratis” y por no son gratis me refiero a que hay un precio a pagar por toda esta mejora de rendimiento en las lecturas. En concreto el precio a pagar es un gran empeoramiento de las escrituras. Para verificar hasta dónde es negativo este impacto en las escrituras he creado una tabla en mi SQL Server con la misma estructura que con la que estamos haciendo la prueba y con los mismos datos pero sin el índice de texto completo. Si que tiene el resto de los índices que tiene la tabla original (PK + Nonclustered). A continuación he insertado en las dos tablas los mismos 100.000 registros para medir los tiempos. 
FullText_Performance3

Como podéis ver en la imagen, el resultado de la inserción en la tabla sín índice FullText ha tardado 225 milisegundos frente a 1079 milisegundos en la tabla que tiene índice de texto completo. En cuanto a la información que se ha necesitado leer para hacer la inserción encontramos que para insertar en la tabla con FullText hemos tenido que leer 12,6 Gb de información mientras que para la que no tiene ese índice solo hemos tenido que leer 259,2 Mb.

Conclusión

Los índices de texto completo o FullText pueden ser un gran aliado en las consultas de lecturas, no tanto en las escrituras, donde nos pueden llegar a dar verdaderos problemas de rendimiento. Además, al contrario que en los índices normales donde su creación es transparente, para aprovechar la mejora de un índice FullText tendremos que adaptar nuestro código y usar las cláusulas específicas que usarán el índice. 

Espero que esta serie de artículos te haya ayudado a comprender mejor los índices de texto completo y a poder analizar si son o no beneficiosos para tus escenarios de uso actuales y futuros. Como siempre, te animo a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios

Creando y manteniendo índices FullText

Continuamos con el tema de ayer sobre los índices de texto completo y hoy vamos a centrarnos en aspectos más prácticos. Si aún no has leído el artículo introductorio de ayer sobre los índices FullText te recomiendo que lo hagas antes de seguir con este para saber de lo que estamos hablando. Si ya leíste vamos a hacer un pequeño resumen para reforzar los conceptos clave. Los índices de texto completo o FullText son unos índices especiales que nos ayudarán en nuestras búsquedas sobre columnas con gran cantidad de texto. Además, tienen la particularidad de que se organizan en catálogos, aspecto clave para su creación y futuro mantenimiento.

Requisitos para crear un índice FullText

Para crear los índices FullText lo primero que necesitaremos será tener instalada la característica de SQL con la que trabajan, no tiene pérdida se llama FullText o Texto Completo dependiendo del idioma de nuestro instalador. Una vez instalada tenemos que asegurarnos de tener corriendo el servicio para la extracción de texto completo, tampoco tiene pérdida y lo localizaremos por su nombre rápidamente junto con el resto de servicios en el administrador de configuración de SQL Server. 

Una vez estemos seguros de que el servicio está instalado y en ejecución podremos proceder con la creación del catálogo que, recordad que es requisito imprescindible para este tipo de índices. Para crear el catálogo usaremos la sintaxis siguiente sintaxis: 

Para ver los catálogos existentes podemos hacerlo en SSMS, desplegando la carpeta almacenamiento dentro de la base de datos o con la siguiente consulta:

FullText_Catalog

Creación de índices FullText

Una vez que cumplamos con los requisitos anteriores estaremos ya preparados para crear nuestro índice FullText. Tenemos que saber que podemos crear índices de texto completo tanto en tablas como en vistas indexadas pero solo uno por tabla (o vista). El índice de cada tabla podrá contener hasta 1024 columnas. La sintaxis de creación es la siguiente:

No voy a entrar en todas las opciones de creación de un índice FullText, para eso podéis consultar la documentación oficial aquí. Nos vamos a centrar en las más importantes. Como veis es parecido a la sintaxis de creación de índices que todos conocemos. Especificaremos la tabla sobre la que crearlo y las columnas que incluirá. Como opción podemos definir el idioma del texto de esas columnas para las búsquedas, si no lo especificamos se usará el idioma por defecto de la instancia. Esto es importante si tenéis el servidor en inglés pero los datos en español, por ejemplo. Esta opción de language admite tanto el alias como el lcid de los idiomas de la vista del sistema sys.syslanguages.

Otro de los aspectos clave y que es obligatorio es definir un índice de referencia con la clave para nuestro nuevo índice FullText. Debe ser una clave única que no admita valores nulos. Para un mejor rendimiento se recomienda que sea un identificador único numérico. También debemos definir el catálogo sobre el que se creará el índice. Si no definimos el catálogo se usará el por defecto y si no hay uno por defecto veremos un bonito error, así que, aseguraos de definirlo bien.

Para terminar con esta sección de creación e índices FullText es importante destacar la opción de Change_Tracking que definirá la propagación de nuestro índice. Esto significa que define el comportamiento cuando hay una modificación de la tabla (Insert, Update o Delete). Por defecto está en modo AUTO y los cambios se propagan de la tabla al índice FullText en tiempo real pero podemos definirlo en modo manual y que solo se propaguen con una sentencia SQL que ejecutaremos a voluntad o programaremos en un job. La sentencia para propagar los cambios de la tabla al índice es:

Palabras irrelevantes

Como podéis imaginar, indexar todo un texto puede suponer unos requisitos de espacio tremendos, para evitar esto en la medida de lo posible SQL Server implementa lo que se llaman las palabras irrelevantes y las listas de palabras irrelevantes (stopword y stoplist). Si os habéis fijado antes, a la hora de crear un índice FullText podíamos definir una de estas stoplist.

Palabras irrelevantes

Una palabra irrelevante puede ser por ejemplo un código que guardamos pero que no se usa o palabras que sí tienen significado lingüístico pero que no son relevantes para las búsquedas como podrían ser preposiciones y otras. Por ejemplo en español no puede que no queramos indexar las palabras “un”, “y”, “el”, «de «, «hasta «, etc.

Listas de palabras irrelevantes

Para poder gestionar las palabras irrelevantes SQL Server usa unos objetos que se llaman lista de palabras irrelevantes o stoplists. Podemos encontrarlos desplegando la carpeta almacenamiento dentro de la base de datos (mirad en la imagen de antes). Para crear nuestras propias stoplists podemos hacerlo desde este apartado de SSMS o con la sintaxis CREATE FULLTEXT STOPLIST.

Mantenimiento de índices FullText 

Como ya adelantamos en el artículo de ayer, el mantenimiento de los índices FullText se realiza sobre los catálogos. Para ello podemos hacerlo desde el SSMS haciendo click derecho sobre el catálogo y dando a Rebuild o por T-SQL. Si lo hacemos por T-SQL tendremos la posibilidad de reorganizar los índices sin necesidad de reconstruirlos. Si optamos por un REBUILD se borrarán todos los índices del catálogo y se volverán a crear eliminando así la fragmentación. Puede ser que solo queramos hacer el mantenimiento a un índice, en este caso podemos borrarlo y crearlo de nuevo manualmente. La sintaxis para hacer el mantenimiento de un catálogo es:

Si os fijáis, con esta instrucción podríamos también definir este catálogo como el por defecto.

Conclusión

Hoy hemos aprendido cómo podremos lidiar con los FullText índices como DBAs, esto sumado a lo que vimos ayer y a lo que veremos en el próximo artículo sobre su uso es todo lo que necesitamos para controlar este tema. Si queréis profundizar más en detalle os recomiendo bucear por la documentación oficial que os he compartido y por todas las demás páginas de Microsoft sobre los índices de texto completo. A mi me parece un mundo apasionante y del que poca gente conoce todos los detalles. ¿Quién sabe? Igual algún día tener estos conocimientos puede marcar la diferencia para el trabajo de vuestros sueños.

Espero que este artículo te haya proporcionado una visión profunda de los índices FullText o de texto completo en SQL Server. Como siempre, te animo a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios

Índices de texto completo (Full-Text Indexes)

Volvemos a la carga con un artículo sobre índices, uno de los temas más importantes para el rendimiento de nuestras bases de datos y por ello sobre lo que más contenido tenemos en el blog. Si no has visto los artículos anteriores los tienes todos aquí. A estas alturas no es una sorpresa para nadie que diga que los índices son nuestros mejores aliados para optimizar las consultas y mejorar el rendimiento. Hoy, vamos a sumergirnos en el fascinante mundo de los índices de texto completo o Full-Text index en SQL Server. Este tipo de índice especial y no tan conocido en SQL Server nos va a permitir buscar en grandes cadenas de texto que, sin estos índices siempre es peor que un dolor de muelas.

¿Qué son los Índices de Texto Completo?

Los índices de texto completo son un tipo especial de índice de SQL Server que nos proporciona una solución eficaz para buscar palabras y frases dentro de una gran cantidad de datos de texto en SQL Server. A diferencia de los índices tradicionales, que se basan en la comparación de valores, los índices de texto completo nos permiten realizar búsquedas complejas en textos largos y no estructurados.

Creación de Índices de Texto Completo

Crear un índice de texto completo en SQL Server es un proceso sencillo. Primero, necesitamos una columna con un tipo de datos de texto. Luego, antes de poder crear en índice necesitaremos un catálogo de texto completo. Una vez creado el catálogo podremos crear nuestros índices de texto completo en sí. 

La creación de catálogos es un aspecto fundamental para los índices de texto completo y de cómo los estructuremos ya que nos va a permitir organizarlos y va a afectar al rendimiento futuro de nuestras tareas de mantenimiento.

Uso de Índices de Texto Completo

Una vez creado el índice de texto completo, podemos utilizar la cláusula CONTAINS en nuestras consultas para buscar palabras o frases específicas. También podemos usar la cláusula FREETEXT para realizar búsquedas más generales.

Desventajas de los Índices de Texto Completo

Los índices de texto completo en SQL Server son una herramienta poderosa, pero como cualquier tecnología, tienen sus limitaciones y desventajas. Aquí vamos a nombrar algunas de las más importantes:

Espacio Adicional

Los índices de texto completo ocupan espacio adicional en el disco. Esto puede ser significativo en bases de datos con muchas tablas grandes y varios índices creados. Por lo tanto, es importante considerar el equilibrio entre el rendimiento de la consulta y el uso del espacio en disco.

Rellenado de Índices

El proceso para crear y mantener un índice de texto completo se denomina rellenado (o rastreo). Hay tres tipos de rellenado de índice de texto completo: rellenado completo, rellenado basado en el seguimiento de cambios, y rellenado incremental basado en una marca de tiempo. Este proceso puede ser costoso en términos de recursos y tiempo, especialmente para bases de datos grandes.

Mantenimiento de Índices de Texto Completo

Como cualquier otro índice, los índices de texto completo requieren un mantenimiento regular para garantizar su eficiencia. SQL Server proporciona varias herramientas y técnicas para ayudarnos en esta tarea. Al igual que en el resto de tipos de índices estas son REORGANIZE y REBUILD. Sin embargo, en el caso particular de estos índices las tareas de mantenimiento se realizan sobre el catálogo afectando a todos los índices incluidos y no se puede hacer sobre un único índice a petición. Siempre nos queda la opción de eliminar el índice y volverlo a crear pero no parece una opción aceptable. Por si esto fuera poco es un proceso que no está incluido en las principales soluciones de mantenimiento como OLA Hallengren.

Recomendaciones de rendimiento

Como acabamos de mencionar, optimizar el rendimiento de los índices de texto completo en SQL Server puede ser un desafío. Vamos a ver las mejores recomendaciones que pueden ayudarnos:

Arquitectura y Mantenimiento

Es una buena idea limitar la selección de columnas de clave de texto completo a una columna pequeña. Aunque se admite una columna de 900 bytes, se recomienda usar una columna de clave menor en un índice de texto completo, int y bigint ofrecen el mejor rendimiento.

Podremos reorganizar el catálogo de texto completo utilizando ALTER FULLTEXT CATALOG REORGANIZE. Esto debe hacerse antes de realizar pruebas de rendimiento, ya que la ejecución de esta instrucción produce una mezcla maestra de los índices de texto completo del catálogo.

Uso y consultas

Siempre es mejor combinar varios predicados CONTAINS en un predicado CONTAINS. En SQL Server puedes especificar una lista de columnas en la consulta CONTAINS.

Si solo necesitas información de clave de texto completo o de clasificación, usa CONTAINSTABLE o FREETEXTTABLE en lugar de CONTAINS o FREETEXT, respectivamente.

Para limitar los resultados y aumentar el rendimiento, usaremos el parámetro top_n_by_rank de las funciones CONTAINSTABLE y FREETEXTTABLE top_n_by_rank permite volver a recuperar solo las coincidencias más pertinentes.

Comprobar el Plan de Consultas

Y como siempre, deberemos comprobar constantemente el plan de consultas de texto completo para asegurarnos de que se selecciona el plan de combinaciones adecuado. Usaremos una sugerencia de consulta o forzaremos un plan de ejecución en Query Store si es necesario.

Conclusión

Los índices de texto completo son una herramienta potentísima en SQL Server que nos permite realizar búsquedas eficientes en grandes volúmenes de datos de texto. Aunque su creación y mantenimiento pueden requerir un poco de esfuerzo adicional, los beneficios que aportan en términos de rendimiento y flexibilidad de las consultas valen la pena.

Esperamos que este artículo te haya proporcionado una visión profunda de los índices de texto completo en SQL Server. Como siempre, te animamos a experimentar con estas técnicas y a explorar todas las posibilidades que ofrecen. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 3 comentarios

Dimensionamiento correcto de un servidor

En nuestro trabajo como administradores de bases de datos, una de las tareas más cruciales y desafiantes a las que nos vamos a enfrentar es calcular el dimensionamiento de un servidor SQL Server. Este proceso implica determinar la cantidad de recursos necesarios para que el servidor funcione de manera óptima, teniendo en cuenta factores como el número de usuarios, la cantidad de datos y las operaciones de la base de datos.

Consideraciones Iniciales

El dimensionamiento adecuado de un servidor SQL Server no es una tarea sencilla. Requiere un conocimiento profundo de las características y capacidades del servidor, así como de las necesidades y demandas de la base de datos y las aplicaciones que se ejecutan en él. Antes de sumergirnos en cálculos y métricas, es esencial entender la carga de trabajo que manejará nuestro nuevo servidor. Esto implica analizar el volumen de transacciones, la concurrencia de usuarios, y los patrones de acceso a los datos. Solo con un conocimiento profundo de estas variables podemos comenzar a esbozar los requisitos de nuestro servidor. 

Si el nuevo servidor se va a usar para sustituir uno ya existente lo vamos a tener mucho más fácil, podremos basarnos en el estado actual y analizar sus puntos flacos para tratar de mejorarlos. Hablamos de migraciones en este otro artículo.

El verdadero reto lo tendremos cuando nos enfrentemos a un escenario nuevo, desde 0. En este caso, será crucial la colaboración de los equipos responsables de los datos o de las aplicaciones, en especial de un buen project manager, además de otros departamentos de negocio que nos puedan indicar previamente las expectativas de carga de trabajo y necesidades de almacenamiento.  En un mundo ideal, todas estas necesidades estarían especificadas en la documentación del proyecto y no tendríamos que hacer más preguntas. Pero, como eso no es lo que nos solemos encontrar (y menos mal, porque así tengo algo de lo que escribiros), vamos a analizar en profundidad que debemos tener en cuenta.

Aspectos a evitar

A lo largo de mis años de experiencia me he enfrentado a las suficientes migraciones y nuevos despliegues como para haber elaborado una lista con los aspectos que si o si debo evitar si quiero llevar el proyecto a buen puerto. Os comparto un pequeño resumen:

  • Subestimar el crecimiento: Y no solo me refiero a los datos, eso es quizá lo de menos. Debemos tener una idea clara de las necesidades de recursos del servidor para que un futuro aumento de la carga de trabajo no nos degrade el rendimiento o, directamente, tumbe el servicio.
  • Falta de monitorización: Es imprescindible monitorizar completamente el servidor tanto antes de la migración si es el caso, como tras la implementación, SIEMPRE. Si disponemos de un servidor antiguo que tenemos que migrar, no monitorizarlo y conocer su comportamiento completamente nos llevará a problemas en un futuro. No hagamos conjeturas, y apoyémonos en datos. 
  • No conocer los objetivos comerciales: Este punto está muy ligado al primero pero tiene su razón de ser como punto independiente. Puede que el equipo de desarrollo haya desplegado una aplicación para los 500 clientes actuales y esos sean los datos que tenemos nosotros pero, si desde la dirección se han marcado el objetivo de doblar esa cifra cada ejercicio, pronto nuestro servidor no dará más de sí.
  • Sobreaprovisionamiento: Puede parecer una buena opción visto lo visto pero nada más lejos de la realidad. Aprovisionar más recursos de los que necesitamos o vamos a necesitar a corto plazo será un malgasto de recursos y no nos dejará en buen lugar como profesionales.

Cómo calcular un dimensionamiento correcto

Ahora que ya sabemos los puntos clave que debemos evitar vamos a ver uno a uno como debemos hacerlo.

Carga de trabajo

Como ya hemos dicho, comprender la carga de trabajo que afrontará nuestro servidor es el aspecto fundamental para un correcto dimensionamiento. Si hablamos de un servidor completamente nuevo nos tendremos que basar en las necesidades que nos indiquen los responsables del proyecto y cobrarán más sentido el resto de apartados. Si por el contrario estamos sustituyendo un servidor existente este punto es de vital importancia. Usaremos todos los recursos que tengamos a nuestra disposición y en ocasiones un trabajo de monitorización previo nos facilitará el trabajo.

En este sentido, a mi me gusta tener siempre en mis servidores un proceso que controle el crecimiento de los ficheros de base de datos (usando la vista sys.master_files por ejemplo) y que lo persista en una tabla de configuración. De esta manera a la hora de calcular el dimensionamiento podremos hacernos una idea clara del histórico de crecimiento de nuestras bases de datos. 

Para calcular las necesidades de otros recursos echaremos mano de las DMV que SQL Server pone a nuestra disposición, de Query Store o del monitor de rendimiento de Windows. Prestaremos especial atención a los tiempos de espera de nuestras consultas para, en la medida de lo posible, acabar con esos cuellos de botella.

Estrategia proactiva

Las bases de datos no son objetos estáticos, están continuamente cambiando y como tal, nosotros tendremos que monitorizar y verificar que las previsiones iniciales que hicimos son correctas. No solo hablo de las pruebas antes del “go live” sino de todo el ciclo de vida del servidor. Una buena monitorización nos permitirá pronosticar una futura necesidad de recursos y anticiparnos a ese dimensionamiento antes de que exista degradación en el rendimiento del servidor. 

El mercado está repleto de soluciones integrales de monitorización de rendimiento de SQL Server pero, cuando el presupuesto no lo permite, tendremos que ser creativos con las soluciones nativas sin dejar de lado esta tarea. Nuevamente las DMV de SQL Server, Query Store y el monitor de rendimiento de Windows serán nuestros aliados. Además, si persistimos estos datos, seremos capaces de analizar tendencias y predecir comportamientos en un futuro (de esto sabe mucho la gente de BI).

Objetivos Comerciales y dimensionamiento

No trabajamos solos, en la mayoría de los casos nuestras bases de datos son una pieza clave para el desempeño de la actividad de negocio. Sería de necios pensar que podemos hacer nuestro trabajo sin alinearnos con el resto de departamentos e ignorando los objetivos comerciales de nuestra organización. En este sentido, cuanto mayor sea nuestro conocimiento del sector, de la empresa en particular y de sus objetivos mejores previsiones podremos hacer.

Igualmente, esto va en los dos sentidos, es nuestra responsabilidad hacernos valer y que los jefes que toman las decisiones sepan que tienen que contar con nosotros. He trabajado en sitios donde no era así, se tomaban decisiones de negocio sin comunicar los objetivos comerciales al departamento de IT y sin trasladar las necesidades de crecimiento. ¿De verdad piensas que tus sistemas están preparados para asumir de la noche a la mañana una fusión que duplique la cantidad de clientes? 

Podríamos resumir este apartado en tres aspectos fundamentales, conoce los objetivos comerciales, involucra a todas las partes interesadas en la planificación y pronostica de manera adecuada la capacidad de los sistemas antes de que sea tarde. 

Escalabilidad, prepárate para un ajuste en el dimensionamiento

Como último punto a tener en cuenta pero no por ello menos importante tenemos que ser capaces de diseñar un sistema capaz de crecer. Ya hemos dicho que nuestras bases están vivas y cambian con el tiempo, normalmente, si todo va bien, crecerán. También hemos visto que sobredimensionar de primeras un sistema puede ser un malgasto de recursos. Aquí es donde entra en juego la escalabilidad. No voy a profundizar más en el concepto porque ya le hemos dedicado un artículo completo al tema que puedes leer aquí.

Es importante que conozcas y que trabajes conjuntamente con el equipo de infraestructura para brindar a tus servidores de esta capacidad. Y no solo con sistemas, confirma con los equipos de desarrollo si sus aplicativos están preparados para un escalado horizontal. Si es así, considera planificar nuevas máquinas, licencias y todo lo necesario para asumir el crecimiento futuro, aunque solo sea una planificación y no se implante a corto plazo es importante tenerlo documentado. 

Sin embargo, este escenario no es lo más común. Normalmente priorizaremos un escalado vertical, aumentando los recursos de nuestro servidor siempre que sea posible. Aquí entra en juego ese trabajo conjunto con los compañeros de sistemas del que estábamos hablando antes. No es lo mismo un escalado vertical en una máquina física que en una virtual o en la nube. Asegúrate de que tienes el presupuesto y la capacidad para crecer y hacer frente a las futuras capacidades del servicio.

Conclusión

El dimensionamiento adecuado de un servidor SQL Server es esencial para garantizar su rendimiento y eficiencia. Al tener en cuenta factores como la carga de trabajo, el rendimiento, la capacidad de almacenamiento y la concurrencia, y al utilizar las herramientas y técnicas adecuadas, podemos hacer una estimación precisa de los recursos necesarios para nuestro servidor. Aun así, el trabajo no termina ahí, las bases de datos están en constante crecimiento y tenemos que ser capaces de adelantarnos a las necesidades de recurso y redimensionar el servidor correctamente. 

Espero que este artículo te haya sido útil y que te ayude a dimensionar correctamente tus SQL Server.  Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Otros, 1 comentario

Solución a problemas de Parameter Sniffing

Seguimos con el tema de ayer sobre el Parameter Sniffing en SQL Server y, como prometimos, vamos a ver cómo podemos hacer para controlarlo y beneficiarnos de ello minimizando sus inconvenientes. Es este, por tanto, una segunda parte del artículo de ayer que os recomiendo encarecidamente leer antes de continuar con este. Como ya sabemos, si la distribución de nuestros datos es relativamente equitativa, un reaprovechamiento del plan de ejecución de una consulta será muy beneficioso para el rendimiento. De lo contrario, si la distribución de datos tiene gran variación, reutilizar un plan hará que este no sea el óptimo para esa ocasión. 

¿Es malo el parameter sniffing?

Empecemos por el principio, la pregunta que todos os estáis haciendo ¿es malo el parameter sniffing para el rendimiento? Para mi la respuesta es no, aun con todos sus inconvenientes, conociendo su comportamiento podremos beneficiarnos en gran medida de ello. En la mayoría de escenarios OLTP, el comportamiento normal del parameter sniffing mejora el rendimiento de las consultas. Para los escenarios en los que nos encontramos con inconvenientes, normalmente será en algún procedimiento almacenado y no todos y, por suerte, tenemos varias alternativas para solventar el problema.

Identificando el problema del parameter sniffing

El primer paso cuando tenemos un problema es reconocerlo y en esta ocasión será sencillo. Si no tenemos habilitado la parametrización forzada bastará con ejecutar nuestra consulta fuera del procedimiento almacenado para comparar los planes. En otras ocasiones los usuarios nos darán pistas sin quererlo, como cuando unos clientes me decían que tras reiniciar el servidor el procedimiento volvía a funcionar. Reiniciar, por si solo no resuelve nada y si no somos capaces de saber que provocaba el problema antes del reinicio nos volveremos a encontrar en esa misma situación antes o después. Pero esta discusión es para otra ocasión, volvamos a mi anécdota. 

Lo que les pasaba a mis clientes es que si la primera ejecución del plan de la caché era con un parámetro con un volumen de datos muy inferior a la media, el plan cacheado iba a ir mal para todas las siguientes ejecuciones. Como la caché de SQL se vacía al reiniciar y ellos estaban esperando el reinicio para ejecutar el SP con los parámetros que antes daban problemas ya se almacenaba en caché el plan correcto y todo iba bien hasta que por presión de memoria ese plan se borraba y la siguiente ejecución era de un parámetro distinto.

Soluciones al problema del parameter sniffing

Bien, sabemos que el causante de nuestro problema de rendimiento es un problema de parameter sniffing. Ahora tenemos que solucionarlo. Para ello os voy a proponer distintas soluciones.

No cambiar nada

Sabemos lo que está pasando y que es el comportamiento natural de SQL Server, expliquemos todo esto a nuestros usuarios y que se conformen con el resultado. No va a funcionar, ¿verdad?. Habéis soltado una carcajada al leerlo que se ha oído en la luna, que os conozco. Los usuarios de SQL necesitan sus datos y los necesitan rápido y por mucho que nosotros les contemos no se van a conformar. Y están en su derecho así que descartemos este punto y vayamos a por los siguientes. 

Pasa el marrón a otro

La siguiente solución que tengo que poner, pero que, al igual que la anterior, tampoco os recomiendo es pasar la pelota al equipo que desarrolla el código del procedimiento. Podríais explicarles lo que está pasando y que creen un SP distinto para cada parámetro. Como os digo esto es una mala idea, malísima en realidad. Acaba completamente con todas las ventajas de un procedimiento almacenado y ni hablar de si problema si es causado por tener activada la parametrización forzada. Descartemos este punto también por favor.

Actualiza tu SQL

Ya comentamos ayer que el las últimas versiones de SQL Server (a partir de 2019) entran en juego los planes de ejecución con joins adaptativos lo que nos permitirá que pasadas unas ejecuciones se persistirá un plan dinámico en caché con varias alternativas en función de los parámetros. Esto es un avance, sin embargo, aún no lo veo una solución pues necesitas de varias ejecuciones lentas para que SQL se de cuenta de lo que pasa y en un entorno con gran cantidad de consultas donde los planes en caché no duran tanto como nos gustaría puede no ser una solución.

Recompilaciones del procedimiento

En este punto, ya hemos descartado no hacer nada y también crear varios procedimientos almacenados, veamos cómo podemos hacer para que nuestro procedimiento problemático rinda como debería. Una de estas soluciones es crear el procedimiento para que no haga uso de los planes en caché y recompile siempre el plan de ejecución. Esto lo haremos en la declaración del procedimiento con la sugerencia de procedimiento almacenado RECOMPILE. Por ejemplo: 

Con esa simple sugerencia conseguiremos que los planes de ejecución de todas las consultas del procedimiento almacenado se recopilen antes de la ejecución, lo que nos supondrá un mayor coste de CPU pero nos garantizará un plan óptimo. Si es uno o unos pocos procedimientos en los que tenemos problemas al final compensa.

Recompilaciones de las consultas

Si el problema lo estamos teniendo fuera de un procedimiento almacenado por tener habilitada la parametrización forzada o si queremos hilar más fino porque sabemos que solo una de las muchas consultas de un procedimiento es la que tiene problemas podemos hilar más fino y aplicar la sugerencia RECOMPILE a nivel de consulta. Por ejemplo 

En este ejemplo tenemos dos consultas, un select y un insert, sin embargo solo recopilaremos el plan de ejecución de la primera.

Optimizado para valor

Otra de las opciones que tenemos a nivel de consulta es utilizar una sugerencia que indique que calcule el plan de ejecución para un valor concreto y no para el que se pase como parámetro de nuestro SP. En algunas ocasiones puede ser una solución pero a mi no me gusta porque genera planes ultra dimensionados cuando no son necesarios y requiere mucho mantenimiento a medida que los datos cambian. Si recordáis el ejemplo del almacén que vimos ayer es como si desplegamos todos los recursos necesarios para mover maquinaria industrial pesada para al final realmente mover un clavo. Aun así os dejo un ejemplo de cómo sería:

Conclusión

Aunque siempre digo que no debemos influir sobre el comportamiento normal de SQL Server en estos casos siempre hago una excepción. Nosotros conocemos nuestros datos (o deberíamos) y cuando el parameter sniffing no termine de adaptarse a nuestras necesidades no debemos tener miedo de actuar. Usa todas las herramientas que SQL pone a nuestra disposición y anticipate a las llamadas de usuarios descontentos, Query Store tiene una vista de consultas recursivas que nos mostrará estos casos de una manera muy cómoda. Añade tus sugerencias de consulta o procedimientos y no dejes que nada frene tus consultas.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Otros, Rendimiento, SQL Server, 0 comentarios

Parameter Sniffing, ¿aliado o enemigo del rendimiento?

Vamos a pasar el mal trago de ayer con los índices de SQL Server que nos perjudicaban el rendimiento y vamos a ver un aspecto que sí podemos controlar nosotros directamente. Mucho hemos hablado de los índices ya en el blog, y también de que SQL Server hace uso de las estadísticas de las tablas para decidir el plan de ejecución más óptimo. Sin embargo no habíamos profundizado en cómo funciona esto y no, no es por arte de magia. SQL Server va a hacer lo que se conoce como parameter sniffing.

El motor de bases de datos de SQL Server utiliza el parameter sniffing para hacerse una idea del volumen de datos de cada una de las tablas que intervienen en nuestras consultas (con los filtros ya aplicados) y así tomar las mejores decisiones. Como habrás adivinado, el parameter sniffing, más allá del tecnicismo (que quedará muy bien si lo soltamos en mitad de una conversación técnica), es una de las claves para el rendimiento de las consultas en SQL Server.

Planes de ejecución de consulta

Lo primero que tenemos que entender es como SQL calcula los planes de ejecución y para ellos, vamos a intentar llevarlo a algo que todos podamos imaginar, así será fácil de entender. Imagina que trabajas de encargado de almacén y tienes que gestionar el trabajo de los mozos del almacén. Te han encargado la tarea de mover todo el stock de unos determinados productos a otro almacén de la compañía. Entre los distintos productos que tienes que mover hay desde tornillos hasta maquinaria industrial. Para poder asignar recursos a las distintas tareas, tendrás que saber cuántos artículos de cada cosa debes mover y cuáles son sus pesos, ¿verdad?. Pues en SQL Server pasa lo mismo, cuando nosotros le pedimos que nos de unos datos, necesita conocer cuántos registros van a ser y cuanto ocupan para poder hacer una asignación correcta de recursos.

Parameter Sniffing en acción

Como podéis imaginar, calcular el plan tiene un coste y es por esto que SQL cachea esos planes para poder reutilizarlos. Esto es realmente útil cuando las consultas se repiten siempre igual pero, ¿qué pasa si cambian? Almacenaremos gran cantidad de planes y muchos serán iguales. Para eso existen los procedimientos almacenados, fragmentos de código que SQL almacena como un objeto, donde las variables están parametrizadas para que nosotros podamos definirlas en cada ejecución. En estas situaciones el plan de ejecución es siempre el mismo porque la consulta es siempre la misma sea cual sea el valor que le pongamos en los filtros. Esto podemos forzarlo para las consultas ad hoc con la opinión parametrización forzada de SQL Server de la que ya hablamos en profundidad aquí. 

En estas situaciones SQL Server analizará el volumen de datos que coinciden con ese parámetro y lo usará para generar un plan de ejecución que se utilizará en todas las consultas siguientes. A este procedimiento interno de SQL Server se le conoce como Parameter Sniffing y reduce mucho los tiempos de ejecución cuando tenemos una distribución equitativa de los datos. Es decir, los registros pesan más o menos lo mismo sea cual sea el valor. 

Los problemas de Parameter Sniffing

Como hemos visto el parameter sniffing reduce mucha carga de compilación de los planes de ejecución en consultas con una distribución de datos similar pero, ¿Qué pasa si no es así? Volviendo a nuestro ejemplo anterior, ¿asignaremos los mismos recursos para mover un clavo que para mover una máquina de varias toneladas? Obviamente no, y esto es un problema (o lo era). SQL Server asignará los recursos a la consulta en función del plan de ejecución que tiene almacenado y este se habrá calculado en base a los resultados de la primera ejecución de la consulta. Al menos, históricamente siempre ha sido así. En Microsoft conocedores de este problema, implementaron en SQL 2019 una optimización en el procedimiento de parameter sniffing y en los planes de ejecución añadiendo los adaptative joins. 

Parameter Sniffing a partir de SQL 2019

En las últimas versiones de SQL Server (2019 y 2022), lo que se hace es compilar el plan de ejecución de varias ejecuciones de la consulta. Si el resultado de estas primeras compilaciones es siempre el mismo plan, se cacheará ese y el comportamiento será el de siempre, pero, si los planes cambian, se almacenará un plan con un join adaptativo que permitirá aplicar un plan u otro en función de los parámetros de la consulta.

Parameter Sniffing caso práctico

Vamos a ver esto en la práctica que con ejemplos es como mejor se quedan las cosas. Para ello vamos a usar la base de datos de demo AdventureWorks.

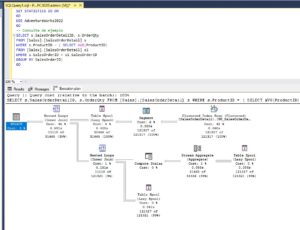
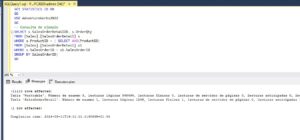
Si os fijáis, en esta primera imagen, la consulta es la misma y solo cambia el valor que le pasamos al filtro. Solo con eso, dada la cardinalidad de la consulta, vemos como el motor de base de datos calcula un plan de ejecución distinto para cada una de ellas.

Vamos a probar ahora a crear el siguiente procedimiento almacenado, como veis es la misma consulta de la imagen de antes pero hecha procedimiento almacenado.

Con el procedimiento creado mirad lo que pasa. Calcula el plan de ejecución en base al primero de los parámetros y ese es el plan de ejecución que se queda para siempre.

Conclusión

Hoy hemos podido aproximarnos más a cómo SQL usa las estadísticas de las tablas para calcular los planes de ejecución y cómo se comporta cuando usamos consultas parametrizadas. Hemos entendido las ventajas y los inconvenientes del parameter sniffing y lo hemos podido ver en un ejemplo práctico. Dejamos para mañana ver cómo, nosotros como DBAs, podemos influir sobre ello y sacarle todo el partido.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
Publicado por Roberto Carrancio en Rendimiento, SQL Server, 0 comentarios
Un índice que no se usa perjudica el rendimiento de los select

Un índice que no se usa perjudica el rendimiento de los select

¿Alguna vez os han dicho que un índice que no se usa empeora el rendimiento de una consulta SELECT? Todos hemos oído que los índices penalizan la escritura y eso es cierto como que odio madrugar para trabajar pero, las lecturas no se ven afectadas, ¿verdad? ¿Estáis seguros? Recientemente recibí en mi bandeja de entrada el último boletín de la newsletter de SQLAuthority sobre un extraño comportamiento con los índices en SQL Server y me ha parecido tan interesante que he sentido la necesidad de compartirlo con vosotros. Aunque, como os digo, la idea detrás de este post no es mía y es plenamente de Pinal Dave me voy a tomar la libertad de traducirlo y compartirlo con vosotros.

Introducción

Este email que activó mi sentido arácnido:

Hi there,
Have you ever seen that Index which is not used for the query reduces the performance of the SELECT statement?
If yes, good, you can stop reading this email here.
If no, here is the video you MUST WATCH 
That’s it! Have a good day.
~ Pinal from SQL Authority

Cuando lo he leído no me lo podía creer, ¿cómo un índice que no se usa puede empeorar el rendimiento de una consulta de lectura? Sabemos que los índices empeoran los procesos de escritura pero, es justamente porque se usan y se escribe en ellos además de en la tabla. Pero en las lecturas no, eso no es lo que dicen los libros de SQL. Sin embargo, de Pinal me fio completamente (ha demostrado sobradamente saber mucho de esto) así que he ido al video y en efecto, en él demuestra empíricamente lo que dice en el correo.

Tan atónito estaba al terminar los doce minutos de demo de Pinal que he ido raudo a comprobarlo en mi propio servidor de pruebas. En el video, Pinal usa la base de datos AdventureWorks2014 y en las respuestas a los comentarios dice haberlo probado tanto con modo de compatibilidad 2017 como 2019. En mi laboratorio de pruebas yo tengo un 2022 así que perfecto vamos a ver que pasa.

Consulta sin índice

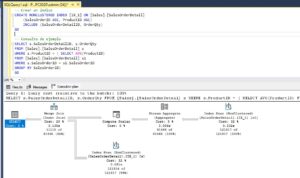
Ejecutamos la consulta sobre la tabla, sin haber creado ningún índice vemos que hace un escaneo de la PK que supone el 42% de la consulta. En cuanto a lecturas, si miramos los mensajes de las estadísticas de E/S vemos que se está leyendo 1238 páginas de disco de 8 Kb, lo que son aproximadamente 10 Mb de datos. Sin embargo para leer esos 10Mb de datos, necesita una tabla auxiliar de la que lee 368.495 páginas o lo que es lo mismo 2,8 Gb de información.

Creemos un índice

Obviamente este rendimiento no es el esperado, leer casi 3 Gb de información para devolver 10 Mb, no sé a vosotros, pero a mi no me parece correcto. Así que creemos un índice llamado IX_1 tal como aprendimos en este otro post y probemos. Vale, tenemos dos lecturas de la tabla y eso no es lo mejor, pero tampoco es un problema. Mirad las estadísticas, tenemos simplemente 610 páginas leídas o lo que es lo mismo, 5Mb de información. 

Creando otro índice

Un caso de uso normal sería ahora crear otro índice invirtiendo el orden de los campos clave para verificar si el rendimiento mejora o no. Sin embargo, al hacerlo, nos vamos a encontrar con la sorpresa que da título a este post. No solo la consulta sigue usando el primero de los índices sino que han vuelto los Table Spool y aunque las páginas leidas de la tabla han bajado a la mitad que antes, tenemos otra vez esos casi 3 Gb de lecturas de la tabla de trabajo. 

Otras pruebas

No os voy a aburrir con más capturas de pantalla, creo que ya lo habéis pillado. Deciros que lo he probado en todos los niveles de compatibilidad posibles de una base de datos desde SQL 2014 hasta 2022 y el resultado ha sido idéntico. 

También he probado con actualizaciones de las estadísticas de la tabla, borrando la caché de planes de ejecución entre las pruebas, con el hint de index para forzarle el uso del índice en las dos ejecuciones y con un hint de RECOMPILE. Todo con el mismo resultado. Para terminar he cambiado la consulta y he usado un join en vez de la subquery pero nada, en todos los casos aparecían esas lecturas al tener el segundo índice creado aunque en el plan de ejecución no aparezca en uso por ningún lado y al borrarlo volvía a los dos escaneos sin lecturas de tablas auxiliares. 

Os diré más, en este punto con ya el artículo escrito se me ha ocurrido una cosa, he borrado el índice 2, he ejecutado la consulta que se ha ejecutado con el plan correcto, he ido a Query Store y he forzado ese plan, luego he creado el índice y, ¿sabéis que? LO HA VUELTO A HACER MAL. Si amigos, incluso forzando en Query Store el plan correcto, SQL me ha sacado el dedo y ha hecho lo peor para él, como un hijo adolescente que no entiende que miras por su bien.

Conclusiones

¿Y ahora que digo yo? ¿Qué conclusión sacamos de esto? Que lo que pone en los libros no es correcto? Igual es que SQL Server hace cosas sin sentido o que visto esto debería pasarme a Oracle? Lo cierto es que no he conseguido encontrar una explicación a lo que está pasando pero ahí está. En su video, Pinal llega al mismo punto, no entiende lo que pasa y obviamente no tiene sentido. Parece un bug del motor de base de datos sin resolver desde hace un montón de tiempo. Por mi parte seguiré probando esto en cada nueva versión de SQL Server y si veo que se resuelve espero poder avisaros por aquí. De momento, no nos queda otra, revisemos los índices de nuestras bases de datos y borremos los que no estén en uso por si nos están penalizando.

Espero que este artículo te haya sido útil y que te ayude a optimizar el rendimiento de tus consultas en SQL Server. Si tenéis alguna duda o sugerencia, podéis dejarla en Twitter, por mail o dejarnos un mensaje en los comentarios. Y recuerda que también tenemos un grupo de LinkedIn y un canal de YouTube a los que te puede unir. ¡Hasta la próxima!
PD.: Si alguno queréis ir a la fuente original os dejo el vídeo por aquí.

Publicado por Roberto Carrancio en Índices, Rendimiento, SQL Server, 0 comentarios